- Koherentnost keša osigurava da sve kopije istih podataka u različitim keš memorijama i RAM-u ostanu konzistentne na višejezgrenim sistemima.
- Hijerarhija keša sa zajedničkim posljednjim nivoom pojednostavljuje kontrolu konzistentnosti i smanjuje direktne pristupe glavnoj memoriji.
- Protokoli koherencije koriste strategije poništavanja ili ažuriranja kopija, podržane stanjima i kontrolnim bitovima po liniji keša.
- Kompajler i operativni sistem mogu dopuniti konzistentnost hardvera umetanjem instrukcija i konfigurisanjem memorije za kritične periode.
Kada pogledate dijagram bilo kojeg modernog višejezgrenog procesora, uvijek se pojavljuje isti obrazac: više jezgara, svaka sa svojim obližnjim keš memorijama, i zajednička keš memorija posljednjeg nivoa koja djeluje kao zajednička tačka prije nego što dođe do RAM memorije. Ovaj raspored nije slučajan ili hir dizajnera, već direktan odgovor na kritični problem u paralelnim sistemima: koherentnost keš memorije.
Bez robusnog mehanizma konzistentnosti, svaka jezgra bi mogla raditi s drugačijom i zastarjelom verzijom istih podataka u memoriji , što se u stvarnom programu prevodi u suptilne greške, nepredvidive kvarove, pa čak i padove sistema. Stoga je razumijevanje kako se ova konzistentnost održava - i na hardverskom i na softverskom nivou - ključno za razumijevanje performansi i stabilnosti modernih višejezgrenih CPU-a.
Šta je koherentnost keša: metafora terminala

Zamislite nekoliko ljudi koji sjede ispred različitih terminala i svi uređuju isti dokument pohranjen na centralnom serveru . Svaki ekran prikazuje kopiju datoteke, a očekuje se da će se sve promjene koje jedna osoba napravi odmah odraziti na ekranima svih ostalih.
Da bi ovo funkcionisalo, potreban je mehanizam sinhronizacije koji prenosi promjene dokumenta na sve terminale, tako da svi uvijek vide istu verziju. Sve dok ovaj sistem radi, sve je u redu: ko god modificira tekst zna da će svi ostali gotovo trenutno vidjeti novu verziju.
Sada zamislite da sistem sinhronizacije iznenada otkaže. Svaka osoba nastavlja s uređivanjem, uvjerena da radi na dijeljenom dokumentu, ali u stvarnosti, svaki terminal ostaje sa svojom vlastitom nepovezanom lokalnom kopijom . Od tog trenutka, promjene koje napravi jedna osoba ne dopiru do ostalih, a dokument počinje nekontrolirano divergirati.
U području računarstva, upravo bi se to dogodilo kada bi CPU-u nedostajao pouzdan protokol za konzistentnost: jedna jezgra modificira podatke u memoriji, ali ostale jezgre nastavljaju čitati stariju verziju iz svojih privatnih keš memorija . Ovo stvara plodno tlo za ozbiljne logičke greške, oštećene podatke i ponašanje prilikom otkrivanja grešaka.
Koherentnost keša je stoga skup mehanizama koji osiguravaju da, u višejezgrenom sistemu, sve kopije istih podataka distribuiranih po različitim keš memorijama i RAM-u održavaju konzistentno stanje . Čak i ako postoji više kopija, sistem se mora ponašati "kao da" postoji samo jedna.
Keš memorije i hijerarhija memorije u višejezgrenom CPU-u
Keš memorije procesora su male, vrlo brze memorije koje sadrže kopije često korištenih dijelova RAM-a . Kada procesor izvršava kod, umjesto kontinuiranog pristupa (relativno sporom) RAM-u, pokušava čitati iz keša i pisati u njega, drastično smanjujući latenciju.
Trik je, naravno, u tome što keš memorije ne pohranjuju "zvaničnu verziju" podataka, već samo privremenu repliku . Slijedeći metaforu terminala, RAM bi bio dokument na serveru, dok bi keš memorije bili lokalni ekrani koji prikazuju kopije određenih dijelova datoteke.
Kod višejezgrenih CPU-a, dizajn postaje složeniji jer svaka jezgra obično ima vlastite privatne keš memorije nivoa 1 (L1) i čak nivoa 2 (L2) . Iznad njih se dodaje zajednička keš memorija nivoa 3 (na primjer), koja se nalazi između jezgara i memorijskog kontrolera koji omogućava pristup RAM-u.
Ova dijeljena keš memorija je uvedena jer bi omogućavanje svim jezgrama da direktno i intenzivno pristupaju RAM-u uzrokovalo konflikte pristupa, sukobe na memorijskoj magistrali i značajan pad performansi . Keš memorija posljednjeg nivoa djeluje kao zajednički "bafer" koji smanjuje pristup RAM-u i centralizuje veliki dio podatkovnog prometa.
Nadalje, mnoge arhitekture organiziraju keš memorije inkluzivno: linije pohranjene na nivoima blizu procesora prisutne su i na višim nivoima hijerarhije . To jest, linija koja se pojavljuje u L1 nalazi se i u L2, a time i u L3. Ovo ima vrlo korisnu posljedicu za konzistentnost: jednostavno ažuriranje keš memorije najnižeg nivoa dovoljno je za kontrolu stanja ostalih nivoa bez potrebe za stalnim pristupom RAM-u.
Zašto je dijeljeno keširanje posljednjeg nivoa ključno za konzistentnost
Bez ove globalne keš memorije posljednjeg nivoa, svaka jezgra bi morala direktno provjeravati konzistentnost u odnosu na glavnu memoriju . Svaki put kada bi se memorijska linija u privatnoj keš memoriji modificirala, bilo bi potrebno provjeriti da li druge jezgre održavaju kopiju iste linije i, ako je tako, ažurirati je ili poništiti svugdje.
U sistemu s mnogo jezgara, ovo opterećenje provjerama bi rezultiralo ogromnim brojem transakcija u RAM-u , negirajući veliki dio prednosti brzih keš memorija. Postavljanjem dijeljene keš memorije između jezgara i memorije, CPU može koncentrirati kontrolu koherencije na jednoj međulokaciji.
U mnogim implementacijama, keš memorije na višim nivoima (dalje od procesora) sadrže kopije linija prisutnih na nivoima bližim jezgru . S ovom organizacijom, protokol koherencije treba samo osigurati da je posljednji nivo sinhronizovan s glavnom memorijom i da su privatni nivoi svake jezgre sinhronizovani s nivoom neposredno iznad njega.
Ovo se može vizualizirati kao neka vrsta ruske lutke za gniježđenje: keš trećeg nivoa uključuje sadržaj drugog i prvog nivoa , drugi nivo uključuje svoj vlastiti sadržaj i sadržaj prvog nivoa, a prvi nivo poznaje samo svoje redove. Dakle, kontrolisanjem "velike lutke" (posljednjeg nivoa), sistem može efikasnije koordinirati ostatak.
Rezultat je da održavanje konzistentnosti postaje ekonomičnije u smislu dizajna i memorijskog prometa . Umjesto prisiljavanja svake jezgre da stalno radi s RAM-om, protokol radi na dijeljenoj keš memoriji i odatle upravlja time koje linije treba ažurirati ili poništiti u privatnim keš memorijama.
Metode ažuriranja: poništavanje i ažuriranje kopija
Kritičan problem nastaje kada dva ili više jezgara žele pristupiti, gotovo istovremeno, istoj liniji podataka koja se replicira u više keš memorija . U tom kontekstu, sistemi za konzistentnost obično koriste dvije osnovne strategije prilikom rukovanja pisanjem.
Prva metoda se zasniva na poništavanju vrijednosti. Kada kernel treba da piše u određenu liniju keša, protokol poništava sve kopije te iste linije koje mogu postojati u drugim keš memorijama . Samo kernel koji će pisati održava liniju u stanju omogućenom za čitanje i pisanje; ostali, ako žele ponovo koristiti te podatke, morat će ponovo učitati liniju sa višeg nivoa (ili iz memorije) sa ažuriranom verzijom.
Druga strategija uključuje ažuriranje. U ovom slučaju, kada kernel modificira liniju, sistem pokušava automatski proširiti novi sadržaj na postojeće kopije u drugim keš memorijama . Na ovaj način, sve keš memorije koje su pohranile tu liniju primaju ažuriranu verziju bez potrebe za njenim poništavanjem i ponovnim učitavanjem kasnije.
Svaki pristup ima svoje prednosti i nedostatke. Poništavanje je obično efikasnije kada su pisanja česta jer izbjegava zasićenje memorijskog sistema ažuriranjima koja drugim jezgrama možda neće odmah biti potrebna. Suprotno tome, ažuriranje može biti prednost kada mnoga jezgra često čitaju iste podatke koji se relativno rijetko modificiraju , jer smanjuje latenciju time što ne mora ponovo učitati liniju nakon svakog poništavanja.
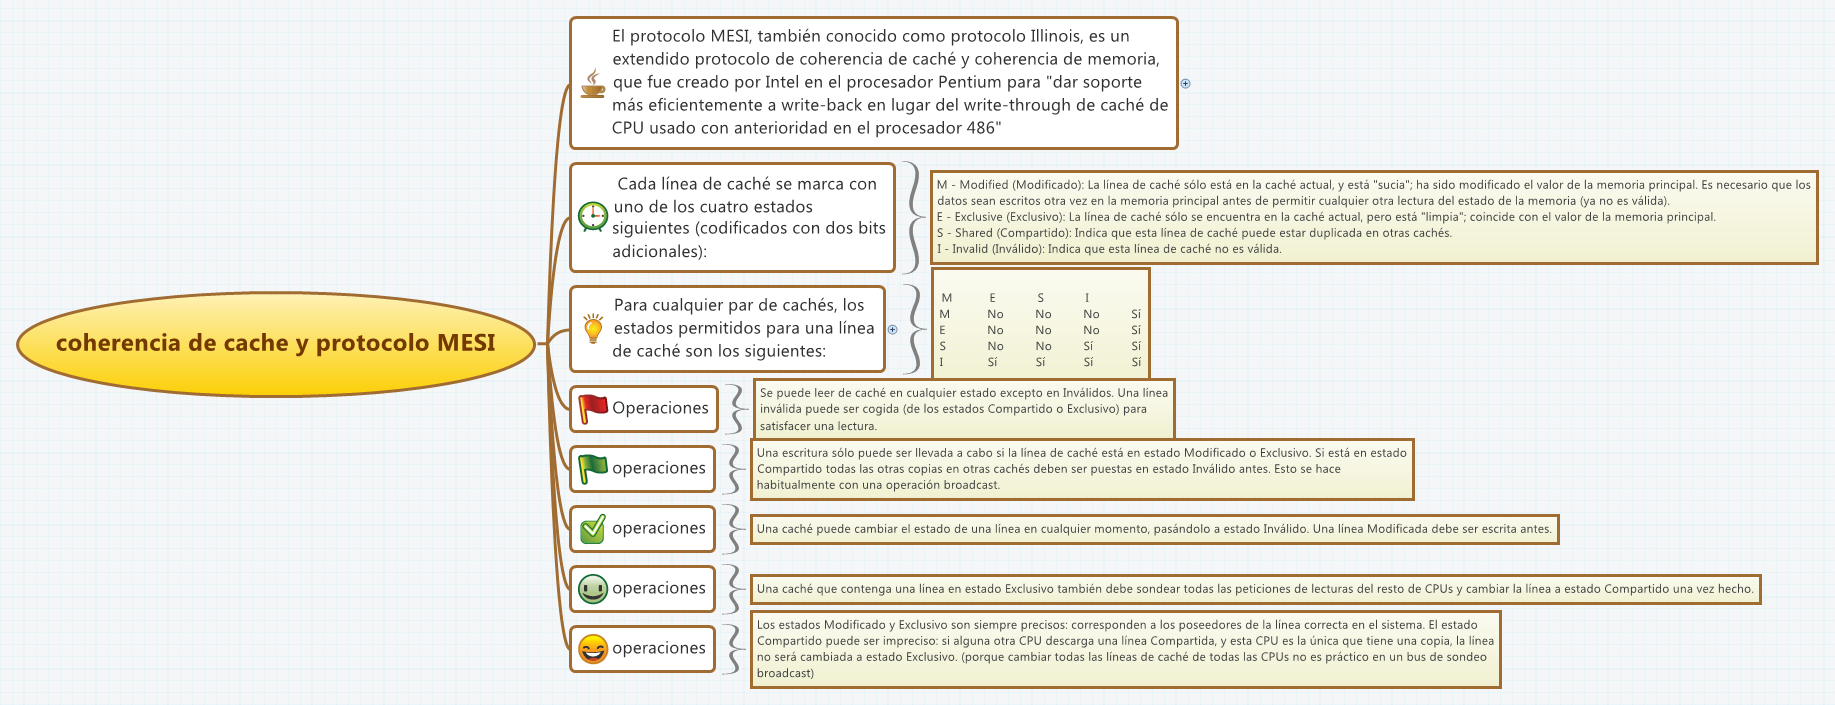
U oba slučaja, obje metode koriste dodatna stanja i kontrolne bitove u linijama keša. Svaka linija obično uključuje informacije o tome da li se njen sadržaj podudara sa sadržajem u RAM-u , te da li je dijeljena, modificirana, ekskluzivna, rezervirana itd., ovisno o specifičnom protokolu (MESI, MOESI, MSI, itd.). Ovo omogućava hardveru da brzo donosi odluke o tome šta učiniti kada se operacija čitanja ili pisanja dogodi na već repliciranoj liniji.
Provjera konzistentnosti između keš memorije i memorije
Direktna provjera konzistentnosti između svih nivoa keš memorije CPU-a ili GPU-a i glavne memorije bio bi ogroman zadatak, kako u smislu složenosti dizajna, tako i u smislu troškova performansi. Stoga, moderni sistemi organiziraju ovu provjeru hijerarhijski.
Keš memorije najbliže procesoru (L1, L2) obično nisu direktno povezane s RAM-om, već sa sljedećim nivoom keša. To znači da se konzistentnost ne provjerava u odnosu na glavnu memoriju na svakom nivou, već u odnosu na neposredno viši nivo . Ovo smanjuje broj pristupa RAM-u i pojednostavljuje logiku potrebnu na nižim nivoima.
Konačno, poređenje sadržaja keš memorije i sadržaja RAM memorije vrši se između keš memorije posljednjeg nivoa i glavne memorije . Ako ovaj posljednji nivo održava ispravno i konzistentno stanje, a svaki niži nivo održava konzistentnost sa onim iznad njega, cijela hijerarhija ostaje konzistentna bez potrebe za ponovljenom provjerom svake linije u odnosu na RAM.
Kada kernel upisuje u liniju keša i mijenja njene podatke, stanje te linije se označava tako da ukazuje na to da se više ne podudara u potpunosti sa kopijom pohranjenom u memoriji . Odatle, protokol koordinira ažuriranje: označava odgovarajuće kopije u drugim kešovima kao rezervirane ili nevažeće i, kada je to prikladno, upisuje novi sadržaj u pridruženu liniju glavne memorije.
Ova kaskadna organizacija omogućava promjenama da se progresivno šire od kernela, koji ažurira podatke, do glavne memorije, prolazeći kroz svaki nivo keša na kontroliran način. Na taj način, održavanje konzistentnosti ne postaje nepremostivo usko grlo za procesor.
Koherentnost hardvera naspram koherentnosti softvera
Do sada smo razmatrali mehanizme konzistentnosti koji su uglavnom implementirani u hardveru: protokoli, statusni bitovi, dijeljene keš memorije itd. Međutim, postoji i drugi pristup koji nastoji prenijeti dio te složenosti na softver , tačnije na kompajler i operativni sistem.
Softverski zasnovane sheme konzistentnosti pokušavaju smanjiti potrebu za dodatnom logikom na čipu analiziranjem koda i donošenjem odluka u vrijeme kompajliranja . Ideja je da ako kompajler može zaključiti kada i kako se pristupa određenim dijeljenim podacima, u mnogim slučajevima bi mogao spriječiti keširanje tih podataka ili eksplicitno upravljati njihovom vidljivošću.
Ovaj pristup ima jasnu prednost: dio radnog opterećenja prebacuje se sa rješavanja tokom izvođenja na rješavanje tokom kompajliranja . Umjesto da hardver detektuje i obrađuje sve konflikte u hodu, kompajler pokušava da ih predvidi i generiše kod koji izbjegava opasne situacije.
Nedostatak je što je statička analiza koda ograničena, te stoga kompajleri imaju tendenciju da budu konzervativni . To znači da, kako bi izbjegli narušavanje konzistentnosti, često donose odluke koje smanjuju efikasnost keš memorije. Ako posumnjaju da bi neki podaci mogli biti problematični, često sprečavaju njeno keširanje ili forsiraju sinhronizacije češće nego što je to strogo potrebno.
Stoga, iako su ove softverske sheme atraktivne u teoriji, posebno zbog pojednostavljenja dizajna hardvera, u praksi one ne zamjenjuju podršku koherencije integriranu u sam CPU , već je dopunjuju u nekim specifičnim scenarijima.
Uloga kompajlera u konzistentnosti keša
Ključni element pristupa konzistentnosti zasnovanih na softveru je uloga kompajlera. Kompajler može izvršiti dubinsku analizu koda i utvrditi koje dijeljene strukture podataka mogu biti nesigurne za keširanje . Na osnovu toga, on označava te elemente na poseban način ili prilagođava generiranje koda.
Najjednostavniji, a ujedno i najkonzervativniji, pristup je sprječavanje keširanja varijabli dijeljenih podataka . To jest, svaki pristup ovim varijablama prisiljava pristup glavnoj memoriji ili području koje se ne može keširati. Ovo garantuje konzistentnost, ali propušta mnoge prilike za poboljšanje performansi, jer se dijeljena struktura, zapravo, može koristiti privatno tokom određenih perioda, ili samo za čitanje u drugim.
U stvarnosti, problem konzistentnosti nastaje samo tokom intervala kada barem jedan proces može pisati u varijablu, a drugi proces je može čitati . Izvan ovih kritičnih perioda, varijabla se može tretirati kao da je za isključivu upotrebu jedne niti ili čak kao efektivna konstanta na neko vrijeme, što omogućava njeno keširanje bez problema.
Najnaprednije strategije kompajliranja pokušavaju identificirati one "sigurne" periode tokom kojih se dijeljena varijabla može smatrati nekonfliktnom . Da bi to učinio, kompajler analizira putanje izvršavanja, potencijalne istovremene pristupe i obrasce sinhronizacije (zaključavanja, kritične sekcije itd.). Na osnovu ove analize, dijeli životni vijek varijable na faze: neke su pogodne za keširanje, a druge zahtijevaju posebno rukovanje.
Tokom kritičnih perioda, kada se otkrije istovremeni pristup sa pisanjem, kompajler ubacuje dodatne instrukcije u generirani kod kako bi se osigurala konzistentnost keša . Ove instrukcije mogu prisiliti ispiranje keša, ponovno učitavanje memorije, memorijske barijere ili pristup regijama označenim kao nekaširane, ovisno o programskom modelu i osnovnoj arhitekturi.
Veza između kompajlera, operativnog sistema i hardvera
Fraza "kompajler ubacuje instrukcije u generirani kod kako bi osigurao konzistentnost keša" mogla bi navesti nekoga na pomisao da operativni sistem čita ove instrukcije kao da su to nagovještaji visokog nivoa i, na osnovu toga, odlučuje kako izvršiti program. U stvarnosti, mehanizam je donekle drugačiji.
Kada kompajler doda ove tipove instrukcija, ono što uvodi u binarni fajl su specifične operacije koje podržava arhitektura ili okruženje za izvršavanje . Na primjer, može umetnuti instrukcije za ispiranje keša, memorijske barijere, posebne instrukcije za označavanje regija kao nekaširanih ili pozive servisima operativnog sistema koji konfigurišu atribute memorije.
Operativni sistem ne interpretira ove instrukcije kao "komentare" ili "nagovještaje" visokog nivoa koje je napisao kompajler; on jednostavno izvršava mašinski kod kao i bilo koji drugi . Međutim, neke od ovih instrukcija su dizajnirane za interakciju sa memorijskim podsistemom i upravljanjem keš memorijom, mijenjajući tako način na koji CPU pristupa određenim podacima.
Drugim riječima, kompajler vrši preliminarnu analizu i generira kod koji, kada se izvrši, proizvodi željeno ponašanje keša . Operativni sistem sarađuje uspostavljanjem atributa memorije (područja koja se mogu ili ne mogu keširati, politike pisanja itd.) i pružanjem primitiva za sinhronizaciju, ali ne "čita" posebne instrukcije u smislu da ih semantički interpretira kao što bi to učinio kompajler.
Također se može dogoditi da hardver, nakon što vidi određene instrukcije, aktivira specifične mehanizme koherencije ili sinhronizacije . Na primjer, instrukcije tipa fence ili barrier garantuju redoslijed pristupa memoriji i nameću određene efekte vidljivosti u cijeloj hijerarhiji keša. U ovom slučaju postoji trostrana saradnja: kompajler odlučuje gdje će smjestiti ove instrukcije, operativni sistem konfiguriše okruženje za izvršavanje, a hardver implementira stvarno ponašanje na nivou keša i memorijske magistrale.
Zajedno, svi ovi elementi osiguravaju da, čak i sa više kopija istih podataka raspoređenih po različitim keš memorijama i glavnoj memoriji, paralelni programi rade sa konzistentnim modelom memorije . Koherentnost keš memorije, daleko od toga da bude jednostavan interni detalj CPU-a, postaje centralna komponenta za pouzdan i efikasan rad višejezgrenih sistema.
Razumijevanje načina na koji se hijerarhija keš memorije, protokoli za koherentnost hardvera i tehnike softverske podrške kombiniraju jasnije je zašto moderni dizajni CPU-a dijele tako sličnu strukturu i zašto mali kvar u bilo kojem od tih mehanizama može izazvati haotično ponašanje u istovremenim aplikacijama koje u potpunosti ovise o tome da sve jezgre vide iste podatke u pravo vrijeme.