- Els sistemes RAID milloren rendiment i disponibilitat, però no substitueixen les còpies de seguretat ni són immunes a errors físics, lògics o humans.
- Sorolls estranys, estat degradat, lentitud anòmala i errors de paritat o lectura/escriptura són senyals clars de problemes imminents al RAID.
- Forçar reconstruccions, reordenar discos sense documentació o fer servir eines genèriques de reparació pot convertir una fallada manejable en una pèrdua total de dades.
- L?actuació prudent i primerenca, juntament amb el suport d?especialistes en recuperació RAID, incrementa enormement les possibilitats de salvar la informació.
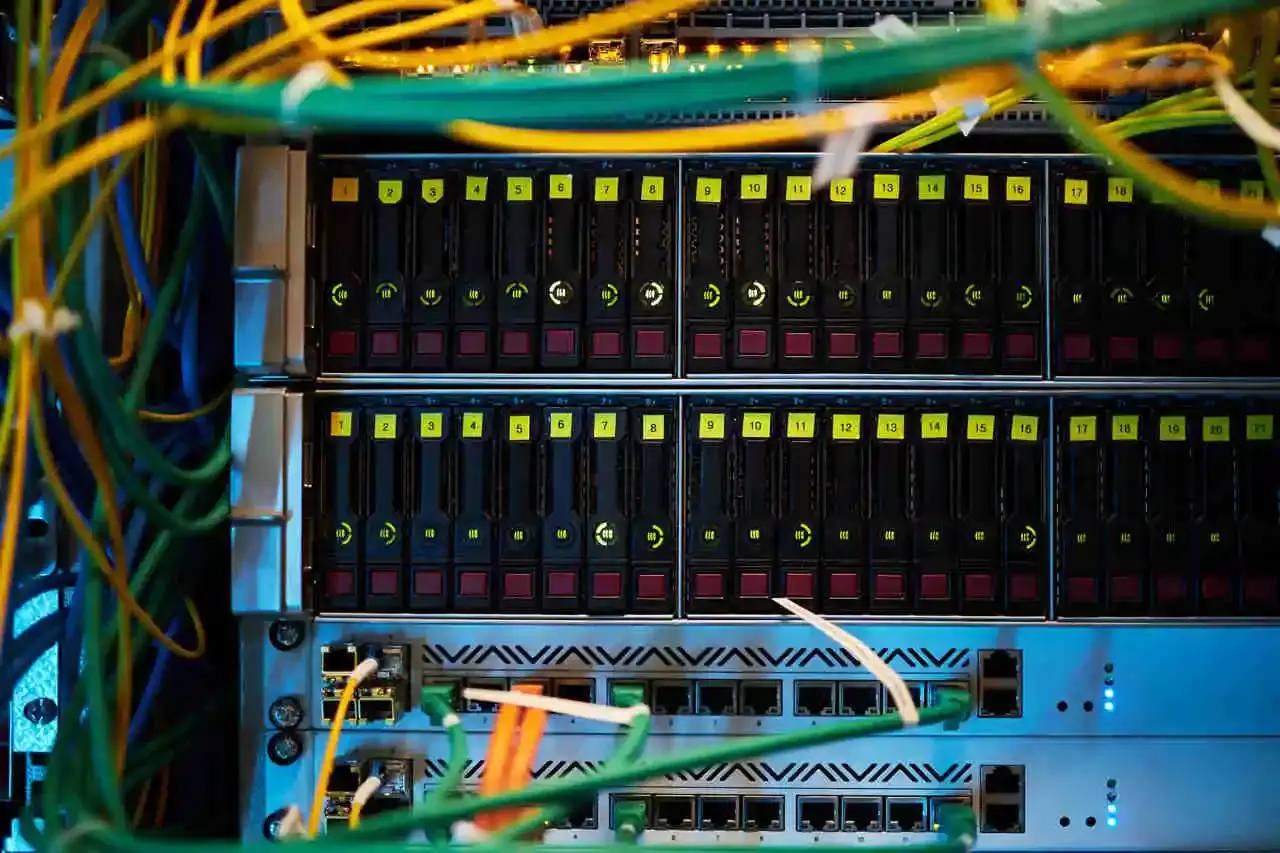
Els sistemes RAID s'han convertit en el pa de cada dia en servidors, NAS i cabines d'emmagatzematge perquè prometen més rendiment i tolerància a errors . Però, tot i donar molta tranquil·litat, no són cap escut màgic: una avaria mal gestionada pot acabar en desastre i deixar-te sense dades en qüestió de minuts.
Quan un RAID comença a donar símptomes rars, la clau no és ser el més ràpid a tocar coses, sinó el més prudent. Detectar els senyals de fallada i saber què NO fer marca la diferència entre un simple canvi de disc i una pèrdua total i irrecuperable de la informació, fins i tot per a un laboratori professional.
Què és una fallada en RAID i per què no és el mateix que un backup
Un RAID (Redundant Array of Independent Disks) agrupa diversos discos per oferir més disponibilitat, rendiment i/o redundància segons el nivell que s'utilitzi. Des del clàssic RAID 1 en mirall fins a configuracions més complexes com ara RAID 5, RAID 6 o RAID 10, la idea és que el sistema segueixi funcionant encara que falli un (o més) discos físics.
El problema és que molta gent assumeix que “tinc RAID, així que en tinc còpia de seguretat”, i això és un error de base. RAID no substitueix les còpies de seguretat : protegeix davant la caiguda d'un o diversos discos (segons el nivell), però no evita la corrupció lògica, els errors humans, el ransomware, les esborrades accidentals, ni les fallades del controlador o del servidor complet.
A més, la manera com el controlador —inclòs el microprogramari del controlador— reparteix les dades (ordre de discos, mida de banda, algorismes de paritat, metadades, etc.) fa que qualsevol manipulació incorrecta de l'array pugui trencar l'estructura i tornar enormement complicada la recuperació, fins i tot quan els discos “semblen” estar bé.
Principals nivells RAID i el seu impacte en la recuperació
Cada nivell RAID té un comportament diferent davant de les fallades i això condiciona molt les opcions de recuperació de dades. Entendre aquestes diferències ajuda a no prendre decisions perilloses quan alguna cosa es trenca.
En un RAID 0 les dades es “ratllen” (stripe) entre diversos discos sense cap paritat ni mirall. No hi ha redundància de cap mena : si un sol disc es mor o es degrada prou, la pèrdua lògica és total, perquè falta una part imprescindible de cada fitxer. Aquí parlar de “reconstrucció” té poc sentit; la prioritat és intentar extreure el que es pugui dels discos físicament danyats.
En un RAID 1 els discs són miralls: cada unitat conté una còpia completa de les dades . És una configuració que sol ser força agraïda a l'hora de recuperar, sempre que no es cometin errors de manipulació (per exemple, inicialitzar un dels discos en un sistema diferent o barrejar-los en controladores incompatibles).
Amb RAID 5 es reparteix la data en diverses unitats i es calcula una paritat distribuïda, cosa que permet suportar la fallada d'un disc . El problema ve quan un segon disc comença a donar problemes durant la reconstrucció: la càrrega de treball es dispara, apareixen errors de lectura i l'array es pot ensorrar sense previ avís.
RAID 6 funciona de forma semblant a RAID 5 però afegeix una segona paritat, permetent tolerar la caiguda de fins a dos discos . A canvi, l'estructura és més complexa, les reconstruccions són més llargues i qualsevol error lògic o de configuració complica encara més les feines de recuperació.
A RAID 10 es combinen miralls i strips: es “ratllen” parelles de discos que estan en mirall. A nivell de recuperació, l'ordre dels discos i la relació entre miralls i strips és crític; barrejar posicions o reconstruir a cegues pot desbaratar el conjunt fins i tot encara que tots els discos estiguin físicament sans.
Senyals clars que el teu RAID està començant a fallar
Abans que el sistema caigui del tot, sol deixar una sèrie de pistes. Aprendre a reconèixer-les et permet parar a temps i evitar que el mal vagi a més.
Una de les més evidents són els sorolls estranys als discos: clics repetitius, cruixits, brunzits intermitents o sons metàl·lics que abans no hi eren. Aquests sorolls solen indicar errors mecànics als capçals o als plats , o problemes al motor. Si els ignores i continues forçant lectures, el més normal és que l'estat de la unitat empitjori molt ràpid.
Un altre senyal típic són els avisos de “Degraded”, “Failed” o “Critical” a la consola d'administració del NAS o del controlador RAID. Aquest missatge significa que un o més discos han estat marcats com a problemàtics i que l'array està funcionant sense la redundància prevista. En aquest punt, sobretot en RAID 5, una segona fallada pot ser la punta.
També cal parar atenció als símptomes menys sorollosos però igual de perillosos, com ara un descens brusc i inexplicable del rendiment . Si els temps de lectura i escriptura es disparen, especialment en accedir a certs volums o carpetes, pot ser que el controlador s'estigui barallant amb sectors difícils de llegir o reintents continus que saturen el sistema.
Als logs del sistema o del mateix controlador solen aparèixer errors d'I/O, missatges de paritat incorrecta, Unrecoverable Read Error, Parity Check Failed o Bad Stripe Detected. Un augment sostingut d'errors de lectura/escriptura , fins i tot si el sistema encara funciona, és una llum vermella que no cal ignorar.
Una altra pista perillosa és que el volum aparegui com a degradat encara que aparentment cap disc hagi caigut del tot . Això sol indicar corrupció lògica a les metadades RAID o als blocs distribuïts, i si es força una reconstrucció automàtica en aquest estat es pot propagar la corrupció a tot l'array.
Símptomes de corrupció lògica i problemes silenciosos a RAID
No totes les fallades de RAID impliquen un disc “mort” a l'instant. Moltes vegades el problema és una corrupció progressiva de dades que es va colant de manera silenciosa fins que la situació ja és molt complicada de revertir.
Un cas típic són els fitxers que aparentment hi són, pesen el que deuen i tenen el nom correcte, però no s'obren, donen errors de format o apareixen truncats . Bases de dades que no munten, màquines virtuals que no arrenquen o imatges que el visor rebutja solen ser indicador d'inconsistències als blocs repartits entre discos.
També és habitual que el sistema operatiu o les aplicacions mostrin una lentitud molt localitzada en certs volums RAID mentre que la CPU i la RAM no semblen especialment carregades. Si la penalització es concentra en operacions de lectura/escriptura sobre el mateix volum, tens moltes paperetes d'estar davant de corrupció o sectors inestables.
Un altre símptoma perillós són les reconstruccions que s'inicien després de canviar un disc i es paren sempre al mateix punt , llancen errors estranys o directament marquen el procés com a fallit. Això sol indicar que els blocs d'origen ja estan corruptes i el controlador és incapaç de generar una còpia coherent al nou disc.
De vegades només un dels discos mostra alertes SMART (sectors reassignats, temps d'accés elevats, etc.), però el comportament rar es nota a tot el conjunt RAID. En aquests casos, un sol disc amb sectors problemàtics pot comprometre la consistència de la matriu completa, sobretot quan comença una verificació de paritat o una reconstrucció.
Ignorar aquests senyals i continuar operant amb normalitat, o pitjor encara, forçar tasques intensives com a verificacions, còpies massives o reconstruccions automàtiques, pot propagar la corrupció i anar sobreescrivint blocs vàlids amb dades danyades . A partir d'aquest punt, ni tan sols les eines professionals no podran garantir una recuperació completa.
Falles típiques en controladors, servidors i plaques base
No tot es redueix als discs. El controlador RAID, la placa base o fins i tot el servidor complet poden convertir-se en la baula feble de la cadena i provocar errors a la matriu encara que els discos estiguin sans.
El controlador RAID, ja sigui maquinari dedicat o integrat en placa, és l'encarregat de decidir on s'escriu cada bloc, com es calcula la paritat i com s'acoblen els volums . Una avaria, un firmware corrupte o un pic de tensió poden deixar-lo fora de joc i provocar que l'array desaparegui o es mostri com a “Foreign”, “Offline” o similar.
En el cas de controladores maquinari dedicades, hi ha un problema afegit: la manca gairebé total de compatibilitat entre models i fabricants . Si es trenca una controladora Supermicro concreta, per exemple, no n'hi ha prou amb posar “una altra semblant”: moltes vegades cal exactament el mateix model, amb una versió de microprogramari similar, perquè llegeixi bé les metadades del RAID.
Amb les solucions integrades en placa (els anomenats “fake RAID”), com alguns RAID per programari de chipset AMD o Intel, el risc és que una substitució de placa base, un reset de BIOS o la pèrdua de configuració CMOS deixi la matriu als llimbs. En molts equips de sobretaula i estacions de treball, una fallada de placa o de la bateria de CMOS pot endur-se la configuració RAID i deixar els discos com a unitats soltes.
A més, el propi servidor ( font d'alimentació , memòria, placa, backplane, etc.) pot fallar per problemes elèctrics, sobreescalfaments o defectes de maquinari. En bona part d'aquests casos, el resultat pràctic és que el RAID es queda inaccessible , encara que els discos, connectats a un altre sistema amb l'estratègia adequada, podrien recuperar les seves dades.
Per si no n'hi hagués prou, en cada reinici o arrencada el sistema ha de “reassemblar” l'array RAID. Si durant aquest procés hi ha talls d'energia, pics de tensió o errors als fitxers de configuració (com mdadm.conf a Linux), el sistema pot muntar malament el conjunt, deixar-lo a mitges o directament no reconèixer-lo, quedant el volum fora de servei.
Causes freqüents de pèrdua de dades en matrius RAID
Si ajuntem tot això, es veu que les matrius RAID, encara que molt útils, segueixen estant exposades a força riscos. Les principals causes reals de pèrdua de dades en aquests entorns solen ser una barreja de factors físics, lògics i humans.
La més evident és la decisió d'un o diversos discos per desgast, defectes de fàbrica, vibracions, temperatura o cops. Tot i que RAID està pensat per suportar algunes d'aquestes situacions, no sempre ho aconsegueix sense danys col·laterals : un disc que comença a tornar sectors corruptes pot arrossegar el seu veí, sobretot durant processos de verificació o reconstrucció.
Un altre focus clàssic de problemes és l' error d'assemblatge o reconstrucció . Si el sistema munta l'array amb paràmetres incorrectes, discs en ordre erroni, nivells RAID diferents dels originals o després d'una migració fallida, és fàcil que la informació quedi desalineada. A nivell pràctic, el volum pot aparèixer com a RAW, demanar formateig o mostrar estructures de fitxers incoherents.
Les fallades del servidor (placa base, microprogramari, backplane, controladora SAS/SATA, etc.) també tenen molt de pes. En un percentatge molt alt d'incidents, quan el servidor mor de forma brusca, la matriu RAID queda inaccessible i les dades no són visibles per al sistema, encara que segueixin existint físicament als discs.
A tot això cal sumar-hi els factors humans: canvis de configuració sense documentació, reordenar discos “per provar”, actualitzacions de BIOS sense còpia prèvia de la configuració, esborrar volums per error, reinstal·lar el sistema operatiu sobre discos que formaven part de l'array, o restaurar còpies de seguretat corruptes o incompletes al mateix RAID danyat.
Finalment, hi ha amenaces externes com el ransomware, que pot xifrar tant les dades com les pròpies estructures dels volums allotjats a arrays RAID. En aquests escenaris, el treball de recuperació es complica doblement: primer cal bregar amb el xifratge i després amb la possible corrupció interna del mateix RAID.
El que NO has de fer quan el teu RAID comença a fallar
Quan un servidor cau en cap de setmana i tothom està nerviós, el més habitual és que algú intenti arreglar-ho “sobre la marxa”. És comprensible, però moltes d'aquestes reaccions ben intencionades són justament el que acaba de rematar les dades.
La temptació més perillosa és forçar una reconstrucció automàtica (rebuild) sense haver analitzat abans l'estat real dels discos . Si un dels membres té dades corruptes o sectors il·legibles, la reconstrucció anirà copiant i barrejant escombraries amb bona informació, fins que l'estructura del volum quedi completament destruïda.
Un altre clàssic és substituir discos al tuntún, sense tenir clar quin és el disc realment malmès ni documentar la posició original de cada unitat . Moure discos de badia, barrejar-los entre controladores diferents o canviar-ne diversos alhora sense pla pot confondre el controlador i fer que el RAID ja no sàpiga com estava muntat.
Executar eines com CHKDSK a Windows o fsck a Linux directament sobre un volum RAID que mostra símptomes de corrupció és també molt arriscat. Aquestes utilitats intenten “arreglar” l'estructura de fitxers basant-se en taules que poden estar danyades i les seves correccions solen significar esborrar entrades, reubicar blocs i reescriure metadades. En un entorn ja tocat, això pot suposar la pèrdua lògica definitiva de milers de fitxers.
Igual de mala idea és confiar en programari genèric de recuperació RAID que promet “muntar qualsevol RAID en automàtic” . Moltes d'aquestes eines treballen de manera superficial, assumint patrons estàndard de stripe, òfsets i paritat que no sempre es compleixen. Un mal ús pot sobreescriure sectors clau o deixar els discos en un estat pitjor que linicial.
Finalment, reiniciar el servidor una vegada i una altra, apagar i encendre el NAS o seguir treballant amb normalitat sobre un RAID degradat o amb errors de paritat només serveix perquè els discos pateixin més, es reassignin més sectors i la corrupció s'estengui . Com més escriptures es facin després del primer problema seriós, menys marge de maniobra quedarà als especialistes.
Passos prudents quan detectes una possible fallada al RAID
Davant de qualsevol símptoma seriós (sorolls, estat degradat, errors de paritat, lentitud extrema, reconstruccions que fallen, etc.), el més sensat és baixar revolucions i actuar amb mètode . El que no escriguis ni canviïs ara, potser es pot salvar després.
El primer és aturar immediatament qualsevol operació d'escriptura sobre l'array : res de copiar dades a sobre, res de noves màquines virtuals, res d'actualitzacions massives. Si el volum encara és accessible, és millor muntar-lo en només lectura si el sistema ho permet.
A continuació convé documentar amb tot el detall possible l'estat actual: captures de pantalla de la BIOS o de la interfície del NAS, llistat de discos amb la posició física, número de sèrie, ports als quals estan connectats, missatges exactes d'error que apareixen en logs, etc. Aquesta informació és or per a qualsevol laboratori de recuperació en reconstruir lescenari original.
En casos on el RAID no es munta o el servidor no arrenca, una opció tècnica és extreure els discos i connectar-los a un altre equip per fer còpies forenses sector a sector de cada unitat . Aquestes còpies, realitzades en mode lectura, permeten treballar després sobre clons sense continuar castigant els discos originals.
Si es disposa de coneixements avançats, eines específiques i un entorn controlat, es pot intentar una reconstrucció lògica de l'array a partir d'aquests clons, deduint ordre de discos, mida de stripe, patrons de paritat, òfsets i metadades . Tot i això, és un treball d'enginyeria inversa delicat: qualsevol prova “a ull” canviant paràmetres a l'atzar pot provocar que s'interpretin malament les dades.
Per a la majoria d'empreses i entorns crítics, el més segur és contactar com més aviat millor amb un servei professional de recuperació especialitzat en RAID i seguir les seves instruccions inicials. La taxa dèxit sol estar molt lligada al nombre dexperiments fallits que shan fet abans darribar al laboratori.
Com treballen els laboratoris professionals de recuperació RAID
Els serveis professionals de recuperació de dades que dominen entorns RAID combinen coneixement profund de maquinari i sistemes de fitxers amb eines pròpies i procediments estrictes. Això és el que solen fer, a grans trets, quan reben un cas de RAID avariat.
El primer pas és fer un diagnòstic individual de cada disc : es comprova l'estat mecànic, electrònic i lògic de les unitats, s'identifiquen sectors defectuosos, es revisen les taules SMART i s'avalua el risc que fallin a curt termini. Si hi ha discos amb danys físics, se'n prioritza el tractament en càmera neta.
Després es creen clons forenses de tots els discos implicats . En lloc de treballar sobre els originals, se'n fa una còpia sector a sector, amb eines que permeten saltar sectors molt danyats o reintentar amb patrons segurs. L'objectiu és preservar l'estat original per si cal tornar enrere al procés.
Amb els clons llestos, es realitza una reconstrucció lògica manual del RAID : s'identifica el nivell (0, 1, 5, 6, 10, etc.), l'ordre dels discos, la mida de banda (stripe size), els òfsets, els algorismes de paritat i qualsevol particularitat del controlador original. Molts cops s'aconsegueix reconstruir el volum fins i tot sense disposar del mateix controlador o NAS que el va crear.
Quan el volum virtual reconstruït sembla coherent, es passa a la reparació del sistema de fitxers si cal: NTFS, ReFS, ext4, XFS, Btrfs, ZFS, VMFS i altres. Aquí la feina és semblant a un cirurgià: es corregeixen estructures, es reconstrueixen taules d'inodes, MFT, superblocks o journals, intentant sempre alterar el mínim imprescindible.
Finalment, se n'extreuen les dades i es validen de forma sistemàtica. Es revisa la consistència de les principals bases de dades, màquines virtuals o carpetes crítiques, es comprova que els fitxers obren correctament i es lliuren les dades en un suport nou i aïllat , com ara discos externs o un nou NAS, perquè el client pugui revisar la recuperació abans de donar-la per bona.
En escenaris especialment complexos, com ara RAIDs afectats per ransomware, reconstruccions prèvies fallides o volums virtuals dins d'arrays ja danyats, es combinen tècniques de desxifrat, anàlisi forense i reconstrucció de RAID, però sempre sota la mateixa regla: no tocar els originals més del que és estrictament necessari.
Al final, els sistemes RAID són una eina potentíssima per millorar la disponibilitat de les dades, però continuen sent vulnerables a errors físics, lògics i humans. Conèixer els seus punts febles, identificar a temps els símptomes que alguna cosa va malament i, sobretot, evitar decisions impulsives quan apareix un error és el que realment marca la diferència entre un ensurt controlat i una catàstrofe de dades.

Índex
- 1 Què és una fallada en RAID i per què no és el mateix que un backup
- 2 Principals nivells RAID i el seu impacte en la recuperació
- 3 Senyals clars que el teu RAID està començant a fallar
- 4 Símptomes de corrupció lògica i problemes silenciosos a RAID
- 5 Falles típiques en controladors, servidors i plaques base
- 6 Causes freqüents de pèrdua de dades en matrius RAID
- 7 El que NO has de fer quan el teu RAID comença a fallar
- 8 Passos prudents quan detectes una possible fallada al RAID
- 9 Com treballen els laboratoris professionals de recuperació RAID