- Kanály v Linuxu umožňují řetězení procesů propojením stdout a stdin s podporou jádra a nástroji jako tee, xargs a cpio pro komplexní toky.
- Efektivní CI/CD pipeline v Linuxu se spoléhá na dobrý návrh prostředí, intenzivní využití mezipamětí, neměnné artefakty a paralelní testování.
- Optimalizace Linuxového serveru (CPU, RAM, I/O, Docker) a exekutorů Jenkins, GitHub Actions nebo GitLab Runner je klíčem ke zkrácení časů.
- Integrace zabezpečení, sledovatelnosti a kontroly nákladů do celého procesu zajišťuje spolehlivé, sledovatelné a udržitelné nasazení v produkčním prostředí.
Optimalizace pipeline v Linuxu Nejde jen o řetězení příkazů se symbolem |Za tím vším se skrývá celý svět optimalizace výkonuNávrh pracovního postupu, CI/CD, zabezpečení a ladění operačního systému tvoří zásadní rozdíl mezi pomalým a nestabilním integračním procesem a procesem, který funguje, je spolehlivý a jehož údržba je levná. Pokud pracujete s linuxovými servery, ať už automatizujete úlohy v terminálu nebo spouštíte kontinuální integrační procesy, pochopení těchto detailů vám ušetří spoustu času a bolestí hlavy.
V tomto článku spojíme dva vzájemně se doplňující pohledy: na jedné straně Klasické použití pipes v příkazovém řádku Linuxu (kanálky, přesměrování, příkazy jako tee, xargs o cpio); na druhé straně, Optimalizace CI/CD pipeline na Linuxových serverechTo zahrnuje ukládání do mezipaměti, paralelizaci testů, ladění Dockeru, zabezpečení dodavatelského řetězce a pokročilé metriky pracovních postupů. Vše vysvětleno ve španělštině (ze Španělska) s jasnými příklady a velmi praktickým přístupem.
Co je to pipeline a jak se pipes hodí do Linuxu?
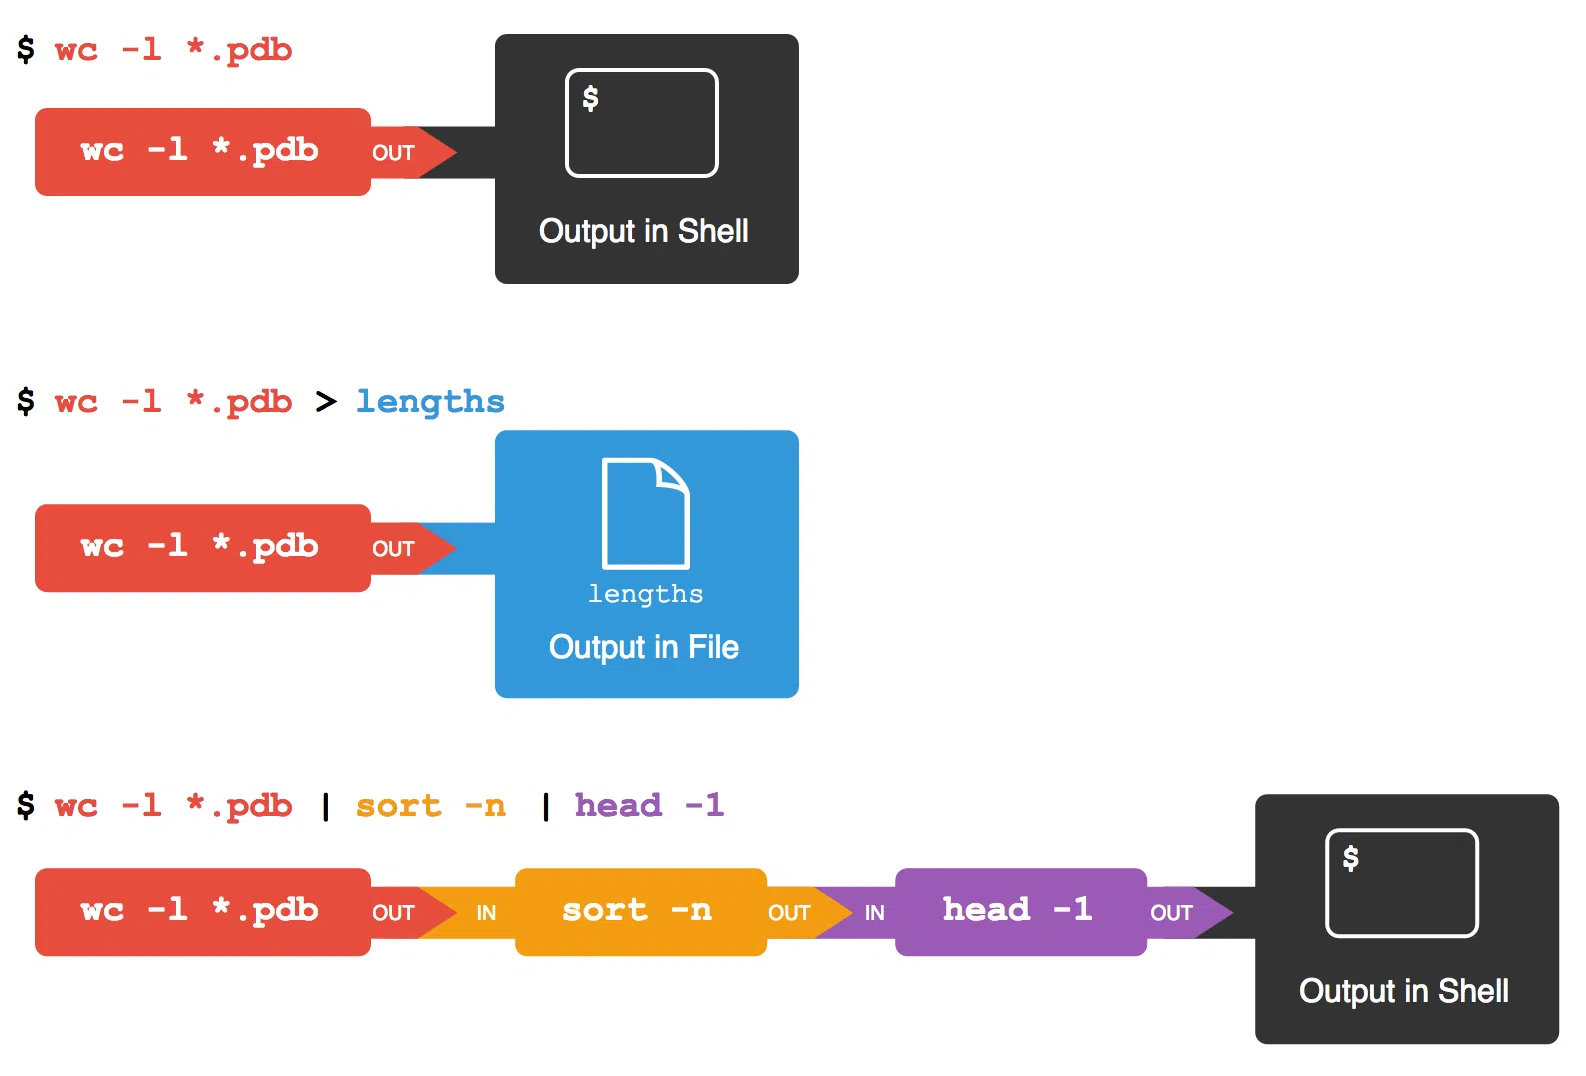
Termín pipeline (pipeline) pochází z myšlenky pipe : toku dat, který se pohybuje z jednoho bodu do druhého. V informatice, a konkrétně v Linuxu, je pipe mechanismus, který umožňuje, aby se standardní výstup jednoho procesu stal standardním vstupem jiného. Jinými slovy, výstup jednoho příkazu je automaticky předáván do dalšího, aniž by procházel mezilehlými soubory.
V unixových systémech existují dva hlavní typy rour . Na jedné straně existují anonymní neboli nepojmenované roury , které lze použít pouze mezi blízce souvisejícími procesy (například rodič a dítě). Na druhé straně existují pojmenované roury , známé také jako FIFO (First In – First Out), které umožňují komunikaci mezi procesy, které spolu přímo nesouvisejí a mohou se dokonce nacházet na různých počítačích připojených k síti.
Anonymní kanály obvykle poskytují jednosměrnou komunikaci : jeden proces zapisuje a druhý čte. Naproti tomu pojmenované kanály umožňují obousměrnou komunikaci , pokud jsou takto navrženy, například otevřením FIFO v režimu čtení/zápis z obou konců. Jsou široce používány ke koordinaci démonových procesů, skriptů nebo služeb, které si potřebují navzájem předávat data bez blokování.
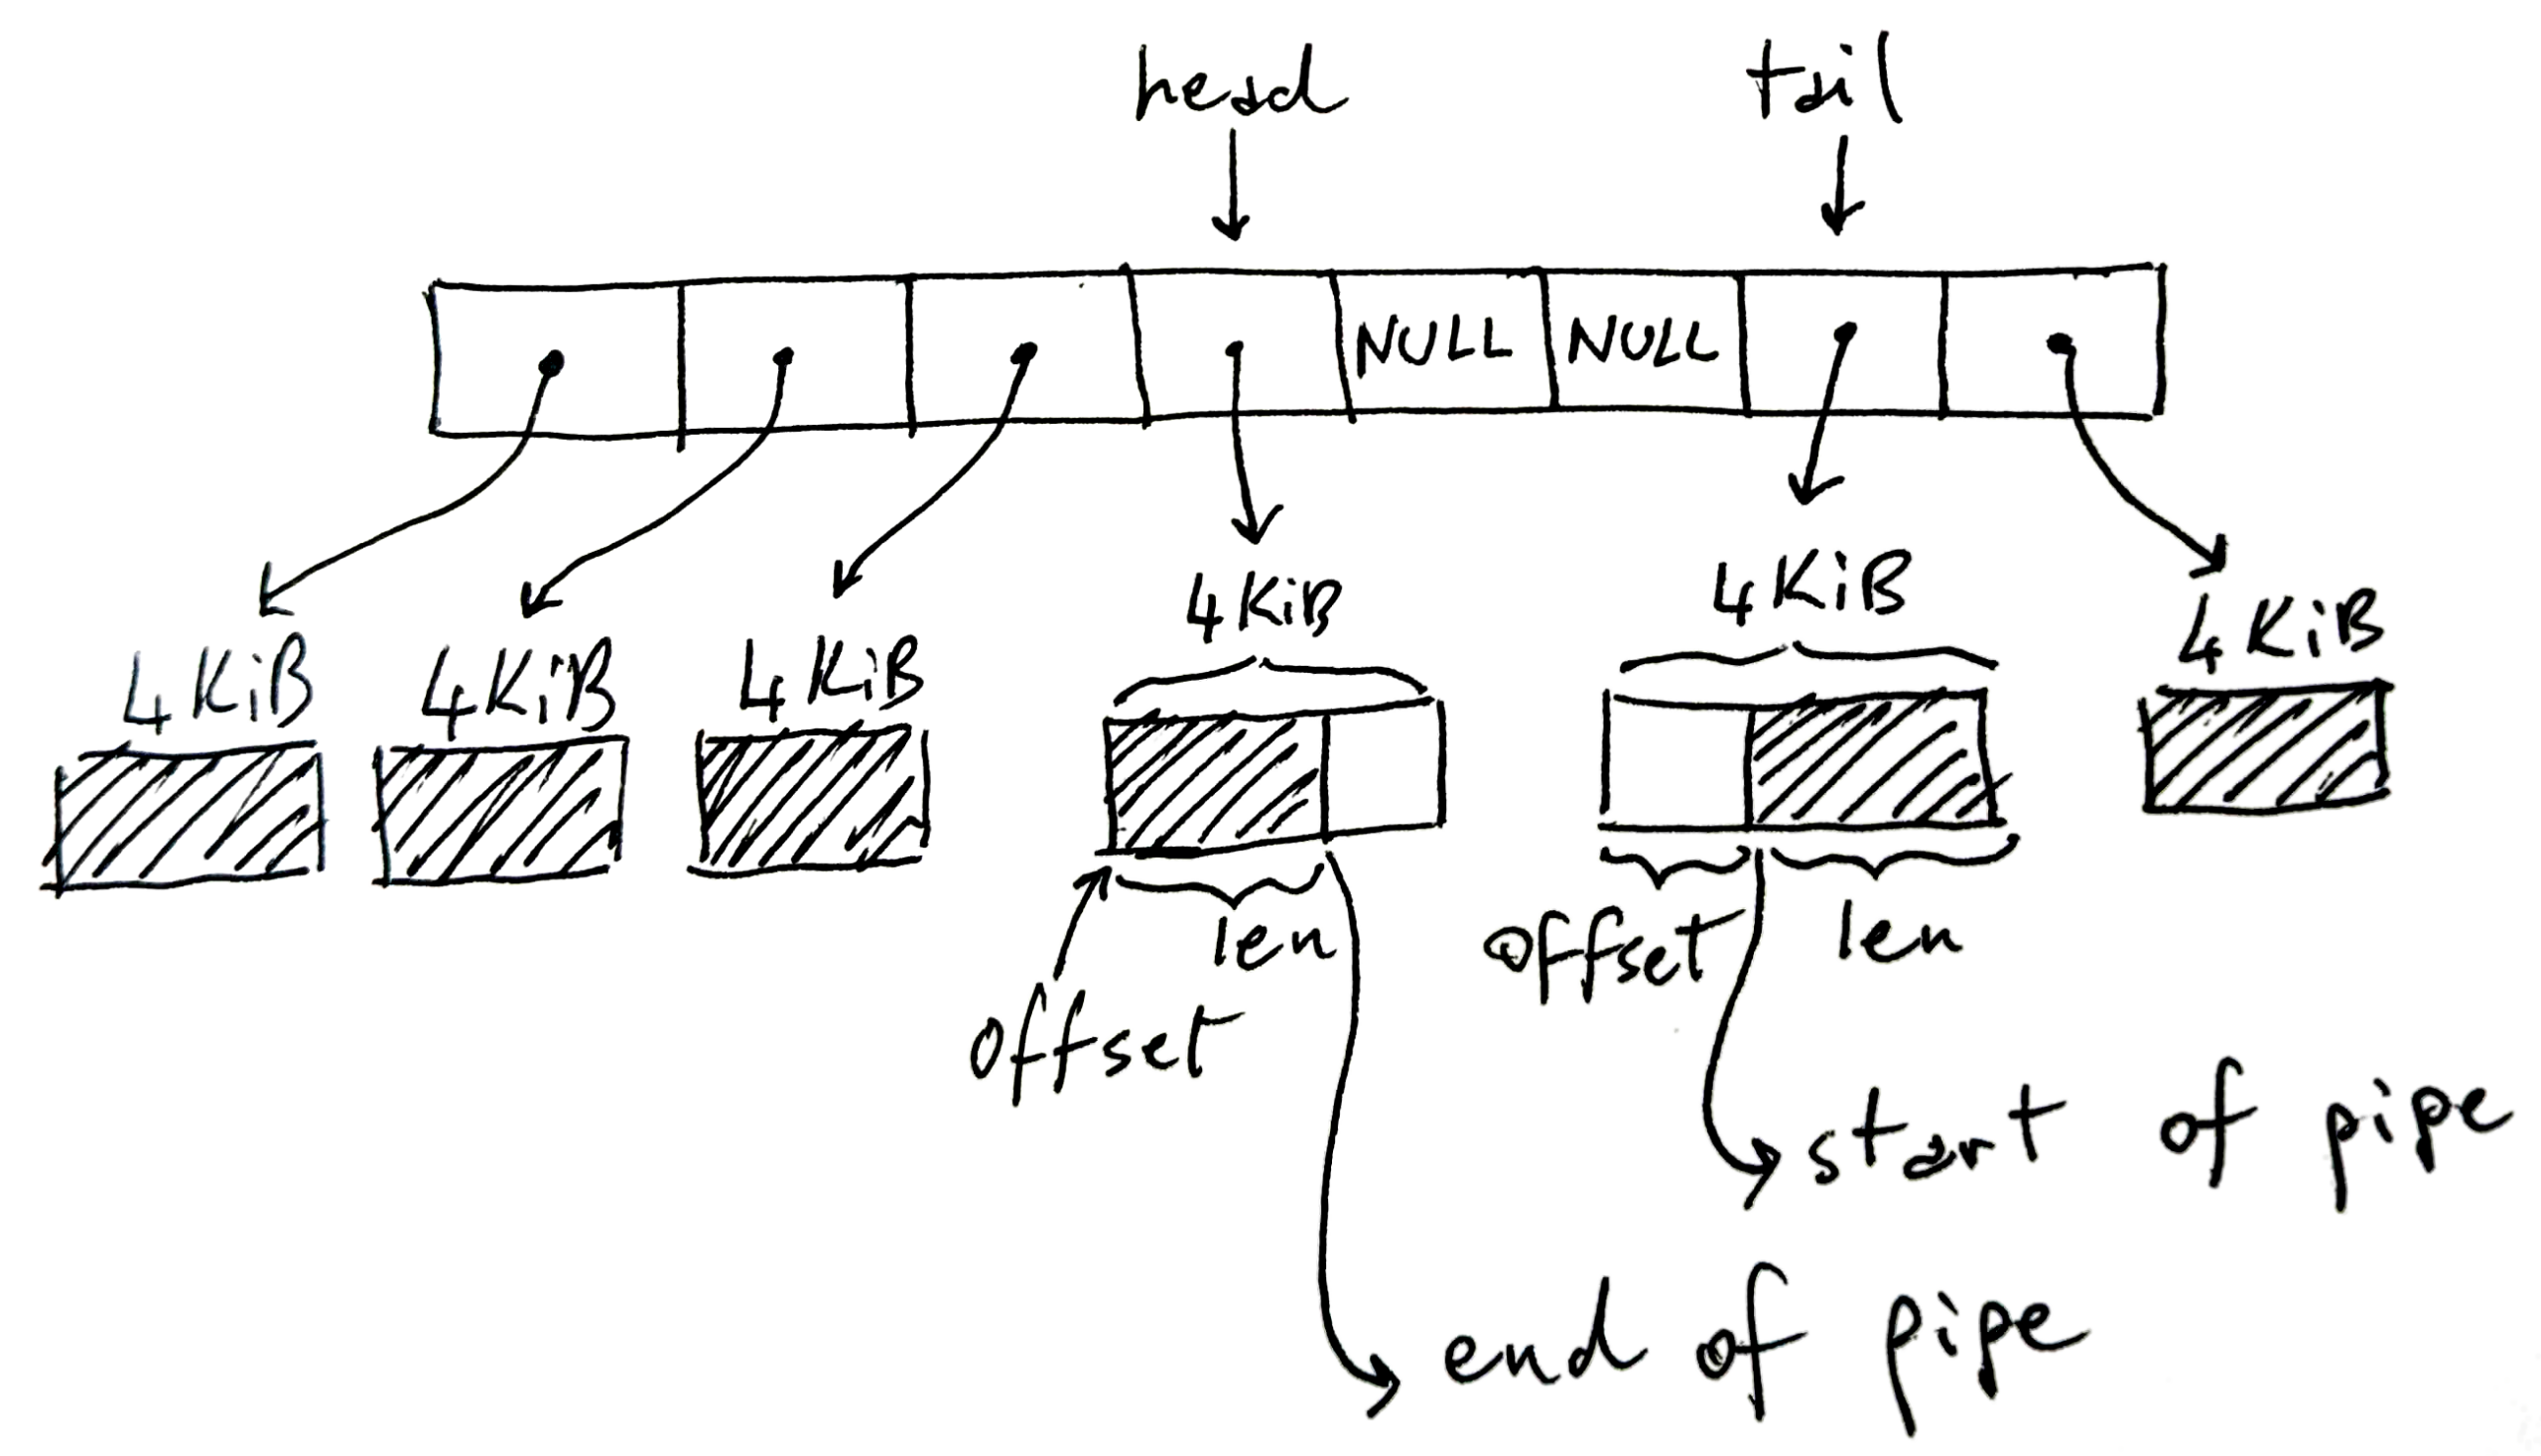
Na úrovni implementace je podpora pro kanály v linuxové jádrone v shellu. Interpret příkazů (bash, zsh atd.) jednoduše vytvoří kanál pomocí systémových volání, jako je pipe() y fork()přesměrovat deskriptory souborů a poté spustit každý program. Skutečné kouzlo blokování procesů, správy vyrovnávací paměti a šíření dat mezi producentem a spotřebitelem zajišťuje systémové jádro.
Pochopení stdin, stout a toku dat
Pro efektivní práci s pipeline je zásadní pochopit, co jsou stdin, stdout a stderr . Nejedná se o abstraktní pojmy: každý proces v Linuxu začíná třemi otevřenými deskriptory souborů, které ukazují na specifické zdroje spravované jádrem.
stdin (deskriptor 0) a stdout (deskriptor 1) lze považovat za bajtové proudy připojené k něčemu: může to být terminál, soubor, síťový socket nebo roura. Nejsou to jen buffery; jsou to odkazy na objekty jádra ( struktury typu soubor ), které jsou zase spojeny s inody, sockety nebo interními strukturami rour.
Každý proces má své vlastní deskriptory, takže každý příkaz v kanálu Zobrazuje si stdin a stdout nezávisle. Na řádku typu ls | grep txt | wc -lse ls psát do potrubí, grep Čte z jedné roury a zapisuje do druhé a wc Čte se z posledního. Uživateli se jeví jako jeden řetězec, ale interně jsou více zřetězených vyrovnávacích pamětí jádrapřičemž každý proces se blokuje a obnovuje v závislosti na dostupném místě nebo datech.
Když první proces vytváří data rychleji, než je druhý spotřebovává, vyrovnávací paměť kanálu se zaplní. V tomto okamžiku se následné zápisy vrátí a blokují odesílající proces, dokud je spotřebovávající proces... přečíst si dostatek informací a uvolňuje místo. Tím se zabrání tomu, aby se paměť vymkla kontrole; data se nehromadí donekonečna, pokud nepoužíváte neblokující I/O nebo speciální signály. Například v případě, jako je dd if=/dev/sda | gzip -9a gzip komprese se pomaleji, dd je nucen čekat.
Díky tomuto mechanismu zpětného tlaku jsou potrubí poměrně stabilní, i když mezi jednotlivými fázemi dochází k nerovnováze výkonu, což se pak odráží i v návrhu potrubí CI/CD , kde se pomalé fáze stávají úzkým hrdlem, které je třeba měřit a optimalizovat.
Praktické využití pipes v terminálu Linuxu
V každodenním používání se roury používají k řetězení příkazů na jednom řádku a k postupné transformaci dat. Místo spuštění příkazu, prohlížení výstupu, jeho kopírování a vkládání do jiného příkazu můžete vytvářet malé, vysoce flexibilní „datové továrny“ v prostém textu.
Typickým příkladem v prostředí Unixu je kombinace příkazu fortune, který zobrazuje náhodné citace, s cowsaykterý vytiskne „mluvící“ krávu. Použitím svislé čáry, Fortuneův odchod se stává Cowsayovým poselstvímvše v jednom příkazu. Je to hravý příklad, ale dokonale ilustruje myšlenku propojení jednoduchých nástrojů pro složitější úkoly.
Další klasikou je odeslat výsledek ls a wc počítat řádky, slova a znaky. Něco jako ls | wc Umožňuje vám rychle zjistit, kolik položek je v seznamu. Krása spočívá v tom, že na všechno nepotřebujete jeden program, ale spíše... Vytváříte řešení s malými, dobře navrženými nástroji..
Je také velmi běžné řetězit dohromady cat, sort y more (nebo jiný stránkovač) pro řazení textového souboru a následné procházení stránky po stránce. Pomocí roury se obsah přenáší z jednoho příkazu do druhého, aniž by byl ukládán do explicitních dočasných souborů, což výrazně zjednodušuje skriptování a administrativní úkoly.
V praktických případech, jako je zpracování seznamů studentů a známek v samostatných souborech, můžete použít paste sloučit sloupce, cut pro výběr pouze polí, která vás zajímají, a zřetězené roury pro filtrování, třídění nebo transformaci všeho v jednom řádku skriptu shellu. Tento vzorec rozdělit velký problém na jednoduché příkazy kombinované s pipes To je podstata filozofie Unixu.
Pokročilé příkazy pro maximální využití rour: tee, xargs a cpio
Když v Linuxu začnete věci skutečně automatizovat, stanou se pipes ještě výkonnějšími díky některým klíčovým nástrojům. Mezi ně patří: tee, xargs y cpiokteré velmi dobře doplňují standardní tok dat.
Příkaz tee Chová se jako „T“ ve vodovodním potrubí: čte ze stdin, zapisuje na stdout a také kopíruje stejný výstup do jednoho nebo více souborů. Je ideální, když chcete zobrazit výstup na obrazovce a zároveň jej uložit zkontrolovat to později nebo zpracovat v jiné fázi. S možností -a Přidává data na konec souboru, místo aby je přepisoval.
Seznam můžete například seřadit pomocí sortvýsledek poslat na tee uložit jej do protokolu a zároveň jej předat more stránkovat ho. Tímto způsobem v jednom kanálu máte k dispozici řazení, ukládání na disk a pohodlné prohlížení bez opakování procesu řazení.
Příkaz xargs Je to další zásadní prvek, pokud jde o roury. Jeho funkcí je přijmout to, co přichází přes stdin (obvykle seznam prvků), a převést to na argumenty pro jiný příkaz. Je to obzvláště užitečné, když program havaruje, protože přijme příliš mnoho parametrů najednou, nebo když chcete rozdělit práci do dávek s opcí -n, což omezuje počet argumentů předávaných při jednom spuštění.
Například pomocí ls | xargs -n 4 Seznam souborů rozdělíte do skupin po čtyřech a provedete příkaz target (ve výchozím nastavení echo(nebo ten, který zadáte) několikrát. Tímto způsobem můžete vytvářet kanály typu „náhled toho, co smažu“, kombinací ls, xargs y echo rm před spuštěním samotného vymazání.
Buďte opatrní se složitými vstupy: cesty s mezerami nebo speciálními znaky může narušit výchozí chování xargsV těchto případech se obvykle používá v kombinaci s find a možnost -print0, který odděluje prvky znakem null, spolu s xargs -0 takže oba konce používají stejný robustní oddělovač.
Konečně, cpio Je to méně známý příkaz než tarJe ale neuvěřitelně flexibilní pro práci se souborovými proudy přes kanály. Na rozdíl od taru je od základu navržen tak, aby fungoval s... přesměrování a kanály: přijímá seznam souborů přes stdin (obvykle generovaný pomocí find) a vytváří nebo spotřebovává soubory typu „balíček“ bez vlastní komprese, které pak můžete komprimovat pomocí gzip nebo podobné.
Hlavní režimy cpio povolit vytváření souborů (-o), kopírování adresářových stromů (-p) nebo extrahovat obsah (-i(často označováno jako „kopírování“). Možnosti, jako například -u přepsat, -m zachovat časová razítka nebo -d znovuvytvoření adresářové struktury umožňuje podrobně kontrolovat, co a jak se kopíruje, obzvláště užitečné ve složitých skriptech, kde tar nedosahuje.
Návrh a optimalizace CI/CD pipelines na Linuxových serverech
Kromě tradičního příkazového řádku se koncept pipeline stal základem ve světě kontinuální integrace a kontinuálního doručování (CI/CD) . Na linuxovém serveru je pipeline CI/CD automatizovaná posloupnost kroků: načtení kódu, instalace závislostí, kompilace, spuštění testů, balení artefaktů a nasazení.
Linux je pro to obzvláště vhodný, protože vyniká svou rychlostí, stabilitou a ekosystémem automatizačních nástrojů . Platformy jako Jenkins, GitHub Actions a GitLab CI se spoléhají na linuxové exekutory (fyzické počítače, virtuální počítače nebo kontejnery), aby konzistentně spouštěly pipelines.
Optimalizace těchto pipeline neznamená jen jejich „funkčnost“, ale jejich fungování s co nejmenším možným třením. To znamená zkrácení doby kontroly, minimalizaci opakovaných instalací závislostí, optimalizaci obrazů Dockeru , aby se zabránilo zbytečným přestavbám, opětovné použití již vygenerovaných artefaktů a udržení bezpečného a sledovatelného prostředí.
Základním osvědčeným postupem je strukturovat pipeline do dobře definovaných fází: sestavení, testování a nasazení . V ideálním případě byste měli kompilovat pouze jednou, vygenerovat artefakt (binární soubor, balíček, obraz Dockeru), který je paralelně testován v různých variantách (například v různých jazykových verzích), a poté nasadit stejný artefakt do testovacího a produkčního prostředí bez nutnosti opětovné kompilace.
Práce s neměnnými artefakty uloženými v repozitářích (S3, Nexus, Artifactory, registry kontejnerů nebo balíčky vložené do GitLabu/GitHubu) zjednodušuje auditování, umožňuje rychlé vrácení verzí a snižuje pravděpodobnost situace „na mém počítači to funguje, ale v produkčním prostředí ne“.
Předpoklady: distribuce, ochrana uživatelů CI a posílení serveru
Než se začnete trápit milisekundovou optimalizací, je důležité vytvořit stabilní základ na linuxovém serveru , který bude fungovat jako exekutor CI/CD. To začíná výběrem distribuce a minimální konfigurace zabezpečení.
Nejrozumnějším přístupem je obvykle standardizace na distribuci LTS nebo stabilní verzi , se kterou je tým obeznámen: Ubuntu LTS, Debian Stable nebo podnikové alternativy jako AlmaLinux nebo Rocky Linux. Používání všech běžců na stejné verzi zabraňuje neočekávanému chování způsobenému různými knihovnami nebo jádry mezi jednotlivými úlohami.
Dalším doporučením je nakonfigurovat vyhrazený uživatel pro CI, bez root oprávnění, s příkazem sudo velmi omezeným pouze na základní příkazy (například systemctl o docker (pokud je to opravdu nutné). Tento uživatel se musí ověřit pomocí SSH klíčů, a to jak pro přístup k serveru, tak pro interakci s repozitáři Git nebo jinými vzdálenými počítači.
Na systémové úrovni je vhodné udržovat server aktualizované a minimálně zesílenéTo zahrnuje instalaci bezpečnostních aktualizací, konfiguraci omezujícího firewallu (například s UFW: zakázání veškerého příchozího provozu kromě nezbytného a povolení odchozího provozu) a povolení nástrojů, jako je fail2ban zastavit útoky hrubou silou na SSH a upravit některé parametry sítě a jádra pomocí sysctl pro zlepšení spolehlivosti a výkonu.
Například je běžné zvýšit limit inotifikovat aby se zabránilo vyčerpání zdrojů v systémech sestavujících mnoho souborů a upravit parametr vm.swappiness aby bylo jádro konzervativnější při použití swapu, což je obzvláště důležité, když úlohy CI spotřebovávají najednou velké množství paměti.
Cache, Docker a paralelizace: výkonnostní páky v CI/CD
Pokud se podíváte na to, kam ve skutečnosti směřuje čas v průměrném pipeline, uvidíte, že velká část se ztrácí instalací závislostí a obnovou imagí Dockeru . Řešení tohoto problému je obvykle efektivnější než optimalizace testovacího kódu o několik milisekund.
Prvním nástrojem je ukládání závislostí do mezipaměti . Téměř všichni správci závislostí (moduly pip, npm, Maven, Gradle, Go atd.) používají lokální adresáře mezipaměti. Na persistentním linuxovém serveru můžete tyto adresáře sdílet mezi úlohami nebo je připojit k persistentnímu svazku. Tímto způsobem nemusí každé spuštění znovu stahovat polovinu internetu.
Pro Docker povolte BuildKit a dobře strukturovat Dockerfile Toto představuje zlomový bod. Umístění instalace závislostí hned za kopírování souboru s požadavky a před zbytek kódu zajišťuje, že vrstvy budou znovu použity, pokud verze těchto závislostí zůstanou nezměněny. Kromě toho lze v samotném sestavení nastavit specifické mezipaměti pro pip, npm atd.
Druhou hlavní pákou je paralelní provádění testůMnoho frameworků nativně podporuje souběžnost: pytest s -n autoNástroje Java jako Surefire, Jest v JavaScriptu s --maxWorkersRozdělení sady podle modulů, složek nebo dokonce podle odhadovaného času a její vyvážení mezi několik pracovníků umožňuje zkrátit dobu testovací fáze 2 až 5krát, aniž by se změnila jediná obchodní činnost.
A konečně je tu problém s artefakty a nasazením . Místo opětovné kompilace stejného obrazu pro staging, předprodukci a produkci je efektivním přístupem sestavení jednou, uložení výsledku do repozitáře a označení podle prostředí nasazení. To snižuje využití CPU, zabraňuje nekonzistencím a výrazně zrychluje dlouhé pipeline.
Optimalizace Jenkinse, akcí GitHubu a GitLab Runneru v Linuxu
Každý systém CI má svá specifika, ale všechny těží ze stejných základních principů při běhu na Linuxu. Klíčem je obvykle použití dočasných a čistých exekutorů , udržování dostatečně velké perzistentní mezipaměti a řízení souběžnosti.
V Jenkinsu je běžnou praxí používat lehké, dočasné agenty (jako jsou kontejnery Docker nebo pody v Kubernetes nebo jiná řešení pro orchestraci kontejnerů ) ke spouštění úloh, přičemž hlavní uzel je co nejjednodušší. Tyto agenty lze nakonfigurovat jako služby systemd na linuxových serverech, registrovat se u řadiče a automaticky se spouštět při spuštění počítače.
Pro akce GitHubu s vlastními běhači se doporučuje nasadit je v Virtuální počítače s Linuxem s rychlými SSD diskyChcete-li vytvořit velký adresář mezipaměti vyhrazený pro akce (jazykové závislosti, mezipaměti sestavení atd.), omezte počet souběžných úloh, abyste zabránili přetížení CPU a disku. Využijte oficiální akce ukládání do mezipaměti s cestami, jako je ~/.cache/pip, ~/.npm o ~/.m2 Dělá to obrovský rozdíl v čase.
V GitLab Runneru závisí výběr mezi shellovým exekutorem a Dockerem na požadované rovnováze mezi výkonem a izolací. Shellový exekutor je rychlejší, protože běží přímo na hostiteli, ale Dockerův exekutor nabízí čisté a replikovatelné prostředí. Můžete také nakonfigurovat sdílenou mezipaměť (lokální nebo na S3) a upravit maximální počet souběžných úloh, abyste mohli co nejlépe využít hardware bez jeho přetížení.
Ve všech těchto případech je klíčové mít sdílené svazky pro ukládání závislostí do mezipaměti a zároveň zabránit zahlcení pracovních prostorů mezi sestaveními. Prchavé počítače nebo kontejnery, které se vytvářejí a ničí s každým pipelinem nebo skupinou pipeline, výrazně snižují problémy typu „včera to fungovalo, ale dnes už ne“ způsobené zbytky předchozích sestavení.
Výkon Linuxového serveru: CPU, paměť, I/O a Docker
Bez ohledu na to, jak optimalizované jsou vaše skripty, pokud linuxový server, na kterém běží proces, nemá správnou velikost, setkáte se s nekonečnými frontami a pomalu se pohybujícími úlohami. Typická a rozumná konfigurace pro středně velký stroj je 4–8 vCPU a 8–16 GB RAM , s SSD úložištěm (ideálně NVMe) a určitým odkládacím prostorem (2–4 GB) pro zvládání špičkového zatížení bez agresivního zabíjení procesů.
Souborový systém je také důležitý. Použití ext4 nebo XFS s volbou noatime Na svazcích, kde kompilujete nebo zapisujete protokoly, omezte zbytečné I/O operace. Kromě toho připojení tmpfs pro dočasné soubory nebo krátkodobé artefakty (například /mnt/ci-tmp) zrychluje náročné operace a zabraňuje zaplňování disku zbytkovými soubory mezi jednotlivými úlohami.
Pokud jde o Docker, hygiena démonů je klíčová. Bezpečné a pravidelné odstraňování nepoužívaných obrazů a svazků při zachování aktivních základních obrazů pomáhá ovládání místa na disku a doby spouštěníPříkazy jako docker system prune S vhodnými časovými filtry umožňují čištění bez přetížení nedávno použitých zdrojů.
Pokud vaše CI využívá velké množství kontejnerů, můžete také použít zrcadlené registry , abyste se vyhnuli neustálému stahování z internetu, použít BuildKit pro souběžnost a ukládání do mezipaměti vrstev a dokonce nakonfigurovat afinity CPU (sady CPU) nebo vyhrazené uzly pro nejnáročnější exekutory, čímž zabráníte interferenci mezi sousedními úlohami. Pochopení mikroarchitektury CPU vám navíc pomůže lépe dimenzovat zdroje pro náročné úlohy CI.
Zabezpečení v rámci vývoje (DevSecOps) a nasazení v Linuxu
Rychlý, ale nezabezpečený pipeline je časovaná bomba. Integrace zabezpečení do samotného pipeline a zabezpečení kontejnerů Docker je nyní standardem v každé DevSecOps strategii a Linux pro tento účel nabízí mnoho nástrojů.
První věcí, kterou je třeba udělat, je zacházet s tajnými údaji a přihlašovacími údaji s maximální opatrností . Nikdy by se neměly nacházet v kódu ani ve verzovaných konfiguračních souborech. Místo toho jsou uloženy ve správcích tajných údajů (maskované proměnné GitLab, šifrované tajné údaje GitHub, HashiCorp Vault atd.) a vkládány pouze během provádění úlohy, která je potřebuje, a to pokud možno s využitím krátkodobých tokenů.
Další důležitou vrstvou je generování SBOM (softwarových seznamů materiálů) a podepisování artefaktů. Nástroje jako Syft nebo CycloneDX umožňují vypsat všechny komponenty, které tvoří obraz nebo binární soubor, zatímco Cosign nebo jiná ověřitelná řešení pro podepisování zajišťují, že jsou nasazeny pouze artefakty, které prošly daným procesem a byly ověřeny.
Pokud jde o síť a přístup, je vhodné segmentovat sítě CI a produkční sítě , implementovat přísné firewally, auditovat protokoly provádění a pravidelně rotovat přihlašovací údaje. V případech použití SSH je lepší používat certifikáty nebo klíče s daty platnosti než statická hesla.
Při nasazení v Linuxu strategie jako Blue/Green, rolling a canary výrazně snižují dopad chyb při nasazení. Spuštění aplikace jako služby Systemd, umístění Nginx nebo HAProxy před ni a řízení provozu mezi verzemi pomocí kontrol stavu vám umožní dosáhnout prakticky nulových prostojů během aktualizací.
Například při opětovném načítání Nginxu a restartu služeb pomocí systemd s použitím signálů soft stop (jako například SIGTERMDíky rozumným čekacím dobám můžete vyprázdnit aktivní připojení před zastavením procesu a zachovat tak uživatelský komfort při přepínání verzí na pozadí.
Pozorovatelnost, metriky a náklady v Linuxových pipelinech
Jakmile jsou vaše procesy spuštěny a funkční, dalším krokem je jejich měření a pochopení toho, kam směřují čas a zdroje . Nestačí vědět, zda je pracovní postup úspěšný nebo neúspěšný; je třeba sledovat trvání každé fáze, dobu čekání ve frontě, míru úspěšnosti, frekvenci nasazení, míru zásahů do mezipaměti atd.
Je běžné exportovat systémové metriky pomocí node_exporterCentralizujte protokoly pomocí řešení jako ELK nebo Loki a vizualizujte vše v dashboardech Grafana. Tímto způsobem můžete například zjistit, zda se doba trvání testovací fáze za poslední týden prodloužila o 30 %, nebo zda úlohy tráví příliš mnoho času čekáním na dostupného vykonavatele. monitorování síťového provozu Nástroje s otevřeným zdrojovým kódem tuto viditelnost doplňují.
Je také možné instrumentovat samotný pipeline, například v GitHub Actions nebo GitLab CI, aby programově měřit, kolik spuštění bylo úspěšných, jak dlouho každé spuštění trvalo a jaký je celkový stavSkript, který volá API poskytovatele, vypočítá celkový počet spuštění, počet úspěšných spuštění, počet neúspěšných spuštění, míru úspěšnosti a průměrnou dobu trvání a vše uloží do souboru JSON (například pipeline-metrics.json) umožňuje integrovat tyto metriky do reportů nebo dashboardů.
S těmito informacemi se můžete rozhodnout o velikosti a počtu běžců : někdy je lepší mít více malých běžců než několik velmi velkých, aby se zkrátily čekací doby. Automatická škálovatelnost – například automatické škálování v cloudu nebo dynamické fondy uzlů Kubernetes – pomáhá absorbovat špičkovou aktivitu během dne a minimalizovat nevyužité zdroje v noci.
Tyto postupy nejen zlepšují zkušenosti týmu, ale také pomáhají upravovat náklady na infrastrukturu řízením spotřeby CPU, paměti a zejména úložiště, která má tendenci prudce stoupat u obrazů a mezipamětí, pokud se pravidelně a plánovaně nečistí.
Zvládnutí klasických příkazových řádků a moderních CI/CD pipelines v Linuxu nabízí výkonnou kombinaci: můžete automatizovat vše od jednoduchých úloh filtrování textu až po složité, snadno udržovatelné, bezpečné a rychlé pipeliny sestavení, testování a nasazení. Pochopení toho, jak informace proudí mezi procesy, jak se ukládají závislosti do mezipaměti, jak se ladí servery a jak se integrují metriky a zabezpečení, vám umožní vytvářet pracovní postupy, které se škálují s vaším týmem a projekty, aniž by se staly neustálým úzkým hrdlem.
