- En god Linux-diagnose er baseret på at indsamle data, analysere logfiler og anvende ændringer på en ordnet og reversibel måde.
- Systemværktøjer (journalctl, dmesg, smartctl, lm-sensors, fsck, ethtool, htop osv.) giver dig mulighed for at finde software- og hardwarefejl.
- Forståelse af fejltyper (kerne, filsystem, netværk, applikationer og hardware) hjælper med at vælge de passende tests i hvert enkelt tilfælde.
- Sikkerhedskopier, regelmæssige opdateringer og korrekt dokumentation reducerer risici og gør det nemmere at løse fremtidige problemer hurtigere.
Hvis du bruger Linux dagligt, vil du før eller siden støde på nogle mærkelige problemer: et system, der ikke vil starte, en tjeneste, der går ned uden nogen åbenlys grund, Wi-Fi, der bliver ved med at afbryde forbindelsen, eller en harddisk, der begynder at lave bekymrende lyde. Disse problemer er langt fra at være en tragedie, men en fantastisk mulighed for at lære, hvordan dit system fungerer internt, og udvikle en solid metode til at diagnosticere Linux-problemer.
I modsætning til den mere automatiserede tilgang i andre systemer (såsom Windows-fejlfindingsværktøjer eller kommandoer som DISM/SFC) tilbyder Linux et kraftfuldt økosystem af diagnosticeringsværktøjer, detaljerede logfiler og overvågningsværktøjer . Nøglen er ikke blot at huske kommandoer, men at forstå processen: hvordan man indsamler information, hvordan man fortolker den, og hvordan man handler uden at forværre situationen.
Generel tilgang til diagnosticering af problemer i Linux
Fejlfinding i Linux bør ikke være en "lad os se, hvad der sker, hvis jeg rører ved det her"-ting, men snarere en ordnet og gentagelig proces baseret på logik og observation . Jo mere systematisk du er, jo hurtigere kommer du til roden, og jo mindre sandsynligt er det, at du ødelægger noget undervejs.
Et grundlæggende første princip er at indsamle så mange oplysninger som muligt om fejlen, før du rører ved noget. Det betyder at notere den nøjagtige fejlmeddelelse, hvornår den vises, og hvad du lavede lige før . Detaljer som "det startede efter en opdatering", "det sker kun med dette program" eller "det sker, når jeg tilslutter denne USB-enhed" er uvurderlige for diagnose.
Det er også værd at bemærke, om problemet er konsekvent reproducerbart, eller om det opstår periodisk. Ved at vide, om du bevidst kan udløse fejlen, kan du teste løsninger på en kontrolleret måde og bekræfte, om de rent faktisk virkede.
Når du indsamler data, er det vigtigt at aktivere din mest observante side: meddelelser på skærmen, diagnosticeringslamper på bundkortet, usædvanlige mekaniske lyde fra diske eller blæsere, brændende lugte, områder, der er for varme at røre ved ... Dine sanser (syn, hørelse, lugt og berøring) er også en del af diagnosesættet , især når du har mistanke om et fysisk hardwareproblem.
Med de indledende oplysninger i hånden er det næste logiske skridt at indsnævre kilden til fejlen : er den softwarerelateret (kerne, filsystem, tjenester, applikationer), konfigurationsrelateret (netværk, tilladelser, drivere) eller hardwarerelateret (RAM, disk, temperatur, strømforsyning, NIC, GPU osv.)? Denne klassificering vil guide dig til de relevante værktøjer i hvert tilfælde.
Nøgleprincipper for problemløsning i Linux
En god diagnose afhænger af et par essentielle principper, der bør internaliseres så hurtigt som muligt. Det første er at indsamle data metodisk : det er ikke nok at sige "mit Wi-Fi virker ikke"; du skal vide, om der er strømafbrydelser, om problemet kun er med dit udstyr, om det påvirker en bestemt tjeneste eller al forbindelse, hvad systemloggen siger, om der er driverfejl osv.
Det næste trin er at analysere de indsamlede oplysninger ved hjælp af de relevante værktøjer. Linux leverer meget detaljerede systemlogfiler, kommandoer til ressourceovervågning og specifikke netværks- og hardwareværktøjer . Det er almindelig praksis at kombinere flere kilder: for eksempel at bruge journalctl og dmesg til at gennemgå kerne- og servicemeddelelser, top eller htop til at kontrollere systembelastningen og netværksværktøjer som ping, ss eller tcpdump til at se, hvad der sker med forbindelserne.
Når du har en rimelig hypotese, er det tid til at teste løsningerne grundigt. Det betyder at implementere én ændring ad gangen, kontrollere resultatet og fortryde den, hvis det ikke virker . Du bør aldrig lave en "cocktail" af samtidige ændringer, for hvis problemet forsvinder, ved du ikke, hvilken der løste det, og hvis det forværres, ved du ikke, hvad der ødelagde det.
En anden grundlæggende søjle, ofte overset, er dokumentation. Ved at føre en fortegnelse over de kommandoer, du udfører, de filer, du ændrer, og de resultater, du opnår, kan du replikere en vellykket løsning, dele den med andre og undgå at spilde tid på at undersøge det samme uger senere . Derudover bidrager du til Linux-fællesskabet ved at dele dine noter på fora eller wikier.
Husk endelig reglen om enkelhed. Jo mere komplekst et system er, med tjenester, dæmoner og abstraktionslag overalt, desto større er chancen for, at noget går galt. Hold dit system så enkelt og rent som muligt , når det er muligt: færre unødvendige tjenester, mindre redundant software, færre eksotiske lag. Dette reducerer overfladen, hvor problemer kan opstå, og gør diagnosen meget nemmere.
Forbered systemet, før du rører ved noget: sikkerhedskopier og opdateringer
Før du begynder at ændre konfigurationer, reparere filsystemer eller opdatere kerner, bør du sørge for, at du kan gendanne dine data, hvis noget går galt. Sikkerhedskopier i Linux er dit sikkerhedsnet , især når du skal arbejde med kritiske partitioner, diske eller tjenester.
En meget fleksibel mulighed er at bruge rsync til trinvise sikkerhedskopier. Det kombineres typisk med indstillinger som -a (filtilstand, bevarer tilladelser, ejer og datoer), -v (lodret output) og en statusparameter til at spore sikkerhedskopieringens status. Det vigtige er at have en tilgængelig destinationsmappe med tilstrækkelig plads, helst på et eksternt drev eller en partition separat fra systemet.
Hvis du foretrækker at pakke alt ind i en enkelt fil, kan du bruge tar med parametre som -c til at oprette arkivet, -z til at komprimere med gzip, -v til at se status og -f til at angive navnet på den resulterende fil. Bagefter anbefales det at verificere sikkerhedskopiens integritet ved at liste dens indhold med tar, så du sikrer dig, at sikkerhedskopien ikke er beskadiget.
Hvad angår destinationen, er nøglen, at sikkerhedskopien ikke skal være på den samme disk som det system, du vil beskytte. Et eksternt USB-drev, cloud-lagring via værktøjer som rclone eller en separat partition er alle fornuftige valg. Ideen er, at hvis din primære disk svigter, eller systemet bliver ubrugeligt, har du noget at gendanne fra.
Et andet stærkt anbefalet indledende trin er at opdatere systemet . Mange problemer forsvinder blot ved at installere korrigerede versioner af pakker og kerner. I Debian/Ubuntu er den sædvanlige praksis at køre pakkelisteopdateringssekvensen efterfulgt af at opdatere installerede pakker og kontrollere outputtet for fejl. I Fedora og dets derivater tjener pakkeopdateringskommandoer en lignende funktion, og det samme gælder for ` pacman -Syu` i Arch Linux, hvor det er særligt vigtigt at holde systemet opdateret på grund af dets rullende udgivelsesformat.
Grundlæggende hardwaretjek: CPU, RAM, diske og sensorer
Når et system er meget langsomt, fryser tilfældigt eller genstarter uden nogen åbenlys grund, skal du ikke straks antage, at det er softwarens skyld. Ofte ligger roden til problemet i forringet hardware, for høje temperaturer eller defekte hukommelsesmoduler.
For at få et overblik over din hardware kan du bruge kommandoer som `lshw` (detaljerede enhedsoplysninger), `lsblk` (liste over diske og partitioner) eller specifikke værktøjer som `dmidecode` , der udtrækker data fra BIOS/UEFI. For eksempel vil ` dmidecode -t memory` give dig oplysninger om de installerede RAM-moduler (DDR-type, kapacitet osv.), mens ` dmidecode -t 16` viser dig den maksimale hukommelseskapacitet, der understøttes af bundkortet . For mere dybdegående information om hukommelsesstyring, se Hukommelsesstyring i Linux.
Hvis du ønsker et hurtigt overblik over hukommelseskomponenterne, giver `lshw -short -C memory` en kortfattet opsummering, og `dmidecode --type memory | grep -E "Speed|Configured Clock Speed"` lader dig sammenligne modulernes nominelle hastighed med den hastighed, der er konfigureret af chipsættet. Dette er en god måde at opdage, for eksempel, at et modul, der understøtter 3200 MT/s, kører med 2400 MT/s, fordi det deler en kanal med et langsommere modul.
Temperaturovervågning er et andet vigtigt aspekt. Med lm-sensors- pakken kan du få temperatur- og spændingsaflæsninger fra CPU'en og andre bundkortsensorer. Efter installationen anbefales det at køre `sudo sensors-detect` for at detektere og aktivere alle tilgængelige sensorer og derefter bruge kommandoer som `watch -n 2 sensors` til at overvåge i realtid, om CPU'en eller RAM'en overopheder.
For harddiske (SATA HDD'er eller SSD'er) giver værktøjer som hddtemp dig mulighed for at aflæse enhedens temperatur, mens psensor- pakken eller grafiske værktøjer som xsensors giver historiske og grafiske visninger af temperaturer. Hvis en SSD konstant arbejder på grænsen af sit termiske område, er det for eksempel en klar indikation af, at der er noget galt med kølingen eller belastningen.
Diagnose af disk- og filsystemstatus
Diskfejl og filsystemfejl er ansvarlige for utallige problemer, fra beskadigede filer til systemer, der ikke vil starte. Linux tilbyder adskillige værktøjer til at kontrollere diskens fysiske tilstand og filsystemets logiske integritet.
Til at begynde med kan du liste tilsluttede lagerenheder ved hjælp af kommandoer som `lsblk -fm` eller `fdisk -l` og filtrere loopback virtuelle drev fra, hvis det ønskes. Dette giver dig mulighed for at kontrollere, hvilke diske og partitioner systemet genkender, deres filsystemer og monteringspunkter.
Smartmontools- pakken (med smartctl-kommandoen) er essentiel for at udnytte den SMART-teknologi, der er indbygget i moderne harddiske. Først skal du sikre dig, at SMART er aktiveret på drevet med en korrekt aktiveringskommando. Derfra kan du tjekke attributter som Power_On_Hours for at se, hvor mange timer drevet har kørt, eller køre smartctl -H for en hurtig vurdering af enhedens tilstand.
Ud over øjeblikkelige kontroller giver smartctl dig mulighed for at køre automatiske diagnosticeringstests : en kort test til en hurtig kontrol og en lang eller udvidet test til en langt mere grundig gennemgang. Bagefter kan du gennemgå resultaterne og detaljerede attributter med en kommando, der viser alle diskoplysninger. Hvis du registrerer omfordelte sektorer, stigende fejl eller en "pre-fail"-tilstand, er det tid til at begynde at tænke på at udskifte den disk.
Et andet vigtigt værktøj er fsck , som kontrollerer og reparerer logiske fejl i filsystemer. Det er risikabelt at køre fsck på en partition, hvis den indeholder vigtige data, så en sikkerhedskopi er afgørende . Du kan kombinere det med badblocks for at finde og markere dårlige sektorer, så systemet undgår at bruge dem i fremtiden. Men hvis der begynder at dukke mange dårlige blokke op, anbefales det at udskifte disken.
For at diagnosticere pladsproblemer viser `df -h` partitionsforbruget i gigabyte, mens `df -i` viser procentdelen af forbrugte inoder. Det er fuldt ud muligt at have gigabyte frie, men 100% af inoderne optaget, hvilket vil forårsage fejl ved oprettelse af nye filer på trods af tilgængelig plads . Dette er en typisk situation på servere, der håndterer millioner af små filer.
Hukommelsesanalyse: ECC-fejl, test og stabilitet
Defekt RAM kan forårsage en bred vifte af symptomer, lige fra simple tilfældige nedbrud til lydløs datakorruption. Hvis dit system bruger ECC-hukommelse, kan hardwaren selv rette visse fejl, men det betyder ikke, at du kan glemme problemet: rettede fejl er et tegn på, at et modul begynder at fejle.
Linux-systemer kan eksponere disse oplysninger via EDAC- undersystemet . Hvis du installerer de tilsvarende moduler, vil du se meddelelser i systemloggene, der skelner mellem korrigerede fejl (CE) og ukorrigerbare fejl (UE). Førstnævnte angiver, at hardwaren har været i stand til at reparere den beskadigede bit, mens sidstnævnte normalt resulterer i en øjeblikkelig kernelpanik for at forhindre, at beskadigede data skrives til disken.
En simpel måde at kontrollere, om kernen har logget EDAC-fejl, er at gennemgå outputtet fra `dmesg | grep EDAC` . Hvis du finder gentagne EDAC-fejl i det samme modul, fortæller dette dig tydeligt, hvilken hukommelsesbank du skal udskifte, før disse fejl bliver urettelige. For avancerede teknikker og værktøjer, se denne vejledning om hukommelsesfejlfinding i Linux.
For mere grundig testning er det almindeligt at bruge eksterne værktøjer som memtest86 , der køres fra et eksternt drev (USB eller lignende). Disse værktøjer udsætter RAM'en for intensive læse-/skrivemønstre for at opdage fejl, der kan gå ubemærket hen i flere måneder under normal brug . Det er tilrådeligt at lade testen gennemføre flere kørsler for at være rimelig sikker.
Du kan også udsætte systemet for generel stress ved hjælp af værktøjer som stresstests , der belaster CPU'en, I/O og hukommelse i et bestemt tidsrum og observerer, om der opstår nedbrud, kernel-oops eller panik. Hvis systemet fejler reproducerbart under belastning, har du sandsynligvis et hardwareproblem (temperaturer, strømforsyning, RAM) eller en vis ustabilitet i kernen eller driverne.
Systemovervågning: CPU, processer, I/O og GPU
For at forstå, hvad der sker på din maskine på et givet tidspunkt, har du brug for gode overvågningsværktøjer. Linux tilbyder adskillige konsolværktøjer, der giver dig mulighed for at se med et hurtigt blik, hvilke processer der bruger mest CPU, hukommelse, disk I/O eller GPU.
Klassiske kommandoer som `top` eller den mere brugervenlige version `htop` viser dig aktive processer, CPU-forbrug, hukommelsesforbrug og gennemsnitlig belastning. Til specifik overvågning af diskaktivitet pr. proces er `iotop` meget nyttig, mens `nmon` giver et omfattende overblik over flere undersystemer (CPU, hukommelse, netværk, disk) i en meget komplet tekstgrænseflade.
Inden for grafik kan GPU-brug blive en flaskehals i systemer, der kører grafikintensive applikationer eller accelererede computeropgaver. For Intel-kort indeholder pakken intel-gpu-tools kommandoer som intel_gpu_top , der viser GPU-belastning, udførelseskøer og hukommelsesforbrug i realtid.
Hvis du arbejder med NVIDIA-grafikkort, kan du bruge Python-værktøjer som gpustat eller generelle skærme som Glances (med GPU-understøttelse aktiveret), der viser videohukommelsesforbrug, GPU-forbrug og de processer, der bruger det. For AMD Radeon GPU'er tilbyder værktøjer som radeontop noget lignende med brugsbjælker for chippens forskellige interne enheder.
Hvis du har mistanke om, at grafikdriveren er en del af problemet (fejl ved indtastning af et grafisk miljø, nedbrud ved brug af compositors osv.), anbefales det at kontrollere din installerede videohardware med kommandoer som `lspci -vnn | grep VGA -A 12` , `lshw -C display` eller `inxi -G` , og verificere, om du bruger open source, proprietære eller forældede drivere. I distributioner som Ubuntu kan du aktivere specifikke grafikdriverlagre (f.eks. til Radeon) og opdatere til nyere versioner, der er optimeret til din GPU.
Netværksdiagnostik: NIC, pakketab og konfiguration
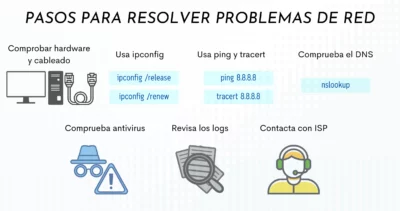
Netværksproblemer kan variere fra "Jeg har ingen forbindelse" til "alt er langsomt undtagen denne tjeneste". For at undgå at blive overvældet er det første skridt at afgøre, om problemet ligger hos din maskine, det lokale netværk eller internettet. Linux tilbyder flere lag af værktøjer til at teste forbindelse, se NIC-statistikker og detektere pakketab , og denne IP- og DNS-netværksdiagnostikguide dykker ned i kontrollerne og løsningerne.
Grundlæggende kommandoer som ping lader dig kontrollere, om du kan nå en bestemt vært (f.eks. din router eller et eksternt domæne), mens traceroute viser dig den vej, pakkerne tager til deres destination, hvilket er nyttigt til at se, på hvilket hop de går tabt. For at se, hvilke porte der er åbne, og hvilke processer der bruger dem, er ss den moderne erstatning for netstat med muligheder for at liste aktive TCP/UDP-forbindelser.
Når du har mistanke om, at problemet ligger i selve netværkskortet, bliver værktøjer som ethtool uvurderlige. Med kommandoer, der viser detaljeret statistik, kan du overvåge RX/TX-fejl, tabte pakker, bufferproblemer eller FIFO-overløb i realtid ved at bruge kombinationer med `watch` til konstant at opdatere outputtet og registrere pakketabsmønstre.
En anden meget illustrativ foranstaltning er at kontrollere grænsefladefejltællerne med `netstat -ni` (eller tilsvarende mere moderne værktøjer). Der vil du se kolonner med pakker, der er modtaget og sendt korrekt, sammen med de tabte pakker. Hvis procentdelen af mistede pakker (RX-DRP/RX-OK eller TX-DRP/TX-OK ganget med 100) overstiger små tal som 0,2%, kan effekten på forbindelsens ydeevne være drastisk og reducere den effektive hastighed med det halve eller værre.
Det er ikke ualmindeligt at finde nyindkøbte netværkskort, der på grund af fabrikationsfejl eller designfejl udviser uacceptable fejlrater. At skifte til en anden model og gentage testene er normalt den endelige bekræftelse på, at flaskehalsen var netværkskortkortet. Derfor er det så vigtigt at have objektive data om signaltab og fejl, før man bebrejder internetudbyderen eller routeren.
Det er også en god idé at tjekke status for radioenheder som Wi-Fi eller Bluetooth med kommandoer som `rfkill` , som angiver, om de er blokeret af software eller hardware. For producent, model og muligheder for netværksgrænseflader giver `lshw -C network` eller `inxi -Nx` meget detaljerede oplysninger, mens `ethtool interface_name | grep -i speed` fortæller dig kortets forbindelseshastighed (10/100/1000 Mbps osv.).
Systemlogfiler og alvorlighedsniveauer i Linux
Systemlogfiler er din historiebog: alt, hvad der er sket (eller næsten alt), registreres der. At forstå, hvordan de fungerer, og hvordan man filtrerer dem, sparer dig en masse tid. På moderne systemer baseret på systemd er journalctl det centrale værktøj til at forespørge den binære journal, mens du på mere traditionelle systemer stadig finder tekstfiler i /var/log.
Blandt de mest almindelige logfiler er /var/log/syslog og /var/log/messages , som indsamler generelle systemhændelser, og /var/log/auth.log til godkendelsesrelaterede spørgsmål. Du kan bruge værktøjer som less og grep til at filtrere dem efter nøgleord (fejl, fejl, timeout osv.). Når du arbejder med systemd-loggen, kan du se meddelelser fra den sidste opstart ved hjælp af specifikke indstillinger, gennemgå logfiler fra en bestemt tjeneste eller filtrere efter tidsintervaller (f.eks. fra de sidste to timer).
Kommandoen `dmesg` viser kernelmeddelelsesbufferen, hvilket er meget nyttigt til at detektere hardwareproblemer, såsom aflæsning af drivere, PCI-busfejl, hukommelsesadvarsler og mere. Parameteren `-T` giver læsbare tidsstempler, og filtrering efter alvorlighedsniveau giver dig mulighed for at fokusere på de mest kritiske problemer. Derudover lader ` dmesg -w` dig se meddelelser genereres i realtid, hvilket er meget praktisk, når du tilslutter/frakobler enheder, eller når du har mistanke om en fejl, der går forud for en kernelpanik.
Meddelelser er kategoriseret efter alvorlighedsniveauer, hvilket hjælper dig med at prioritere. Niveauerne spænder fra 0 (nødsituation) , der angiver en ekstremt alvorlig situation, der kan forårsage nedbrud eller alvorlig ustabilitet, via 1 (advarsel) , 2 (kritisk) og 3 (ikke-kritisk fejl) , til advarsler (niveau 4), mærkbare advarsler (niveau 5), informationsmeddelelser (niveau 6) og fejlfindingsmeddelelser (niveau 7). Forståelse af disse niveauer giver dig mulighed for at filtrere støjen fra og fokusere på, hvad der virkelig er vigtigt, når logfiler er meget detaljerede.
Brug af grep til at udtrække linjer giver dig mulighed for kun at udtrække linjer fra et bestemt niveau i almindelige tekstlogfiler, mens systemd-værktøjer tilbyder specifikke parametre til filtrering efter prioritet i journalen. At mestre disse filtre er forskellen mellem at fare vild i tusindvis af linjer og at finde den besked, der giver dig det spor, du har brug for, på få sekunder.
Fejltyper i Linux: kerne, filsystem, netværk, applikationer og hardware
For at kunne stille en præcis diagnose er det vigtigt at vide, hvilken type fejl du ser. Linux-problemer kan bredt grupperes i kerne-, filsystem-, netværks-, program- og hardwarefejl , selvom de ofte er indbyrdes forbundne.
Kernelfejl spænder fra simple advarsler til kritiske situationer som kernel-oops og kernelpanik. En kernel-oop er en alvorlig fejl, hvor kernen afbryder den proces, der forårsagede overtrædelsen, men forsøger at fortsætte med at køre. Det kan være et symptom på utilstrækkelig hukommelse, defekte drivere, inkompatibiliteter, datakorruption eller fejl. Hvis problemet påvirker et kritisk undersystem, kan denne oop eskalere til en kernelpanik , hvilket er Linux-ækvivalenten til den klassiske blå skærm, der ses i andre systemer.
En kernelpanik er en "hård panik": systemet fryser næsten fuldstændigt, en fejlmeddelelse (ofte kryptisk) vises på skærmen, og afhængigt af konfigurationen kan det fremtvinge en automatisk genstart. Det skyldes normalt ugyldig hukommelsesadgang, fejl i vigtige drivere, en utilgængelig rodpartition, alvorlige RAM-problemer, init-procesfejl, fejl i initramfs, forkert installerede eller ikke-understøttede kerner eller ustabile programrettelser. Kernen selv kan udføre en hukommelsesdump (Kernel Crash Dump) til senere analyse.
Filsystemfejl manifesterer sig som manglende evne til at montere partitioner, fejlmeddelelser, ulæselige filer eller datatab. Pludselige nedlukninger, strømafbrydelser, dårlige sektorer eller fejl i filsystemdriveren kan være årsagen. Det er her, fsck, smartctl og eventuelle sikkerhedskopier, du har lavet, før du foretog ændringer, kommer i spil.
Inden for netværk kan symptomerne variere fra sporadiske afbrydelser, langsomme overførselshastigheder, høj latenstid eller en fuldstændig manglende evne til at oprette forbindelse. Årsagerne omfatter forkerte konfigurationer (IP, routing, DNS, firewall), defekte NIC-drivere, Wi-Fi-interferens, fysiske kabelfejl eller netværksbelastning på et tidspunkt undervejs. De netværksdiagnosticeringsværktøjer, vi har diskuteret, hjælper med at isolere det lag, hvor fejlen opstår.
Programfejl spænder fra programmer, der lukker uventet, ikke starter, viser manglende biblioteksmeddelelser eller ikke reagerer. De er ofte forårsaget af ødelagte afhængigheder, inkompatible biblioteksversioner, kodefejl, dårligt skrevne scripts eller race conditions. Værktøjer som strace (til sporing af systemkald) eller lsof (til visning af en process åbne filer og netværksforbindelser) kan give værdifuld information.
Endelig spænder hardwarefejl fra løse stik, beskadigede kabler, ødelagte porte eller ophobet snavs til elektroniske fejl forårsaget af overophedning, fugtighed eller ældning. Dette inkluderer også konflikter mellem komponenter (IRQ, DMA osv.) og strøm- eller ydeevneproblemer (temperaturregulering, utilstrækkelig RAM, CPU med lav ydeevne). Igen vil brugen af dine sanser sammen med overvågningsværktøjer og stresstest hjælpe dig med at identificere, hvilken fysisk komponent der fejler.
Praktiske trin til en ordnet diagnostisk proces
Selvom ethvert problem er unikt, kan du følge en slags "skelet" af trin, der kan tilpasses næsten enhver situation. Det første, som allerede er nævnt, er at definere problemet præcist : hvad fejler, siden hvornår, under hvilke forhold, og hvad der ændrede sig lige før (softwareinstallation, opdatering, hardwareændring osv.). Hvis du pålideligt kan reproducere fejlen, er det desto bedre.
Det andet trin er at gennemgå systemstatus og logfiler: brug journalctl og dmesg til at søge efter relevante meddelelser (især på fejl-, kritisk- eller alarmniveauer), tjek belastningen med top/htop , frigør hukommelse med kommandoer for hukommelsesforbrug, diskforbrug med df og de logfiler, der er specifikke for den berørte tjeneste eller applikation. Søgning efter nøgleord som error, fail, panic eller timeout giver dig normalt hurtige ledetråde.
For det tredje er det tilrådeligt at undersøge eksterne kilder. En velformuleret søgning efter fejlmeddelelsen ("Ubuntu 20.04 wifi disconnects" for eksempel) vil ofte føre dig til forumtråde, wikier til din distribution eller fejlrapporter, hvor andre brugere allerede har oplevet det samme problem. Glem ikke at konsultere man-siderne (man), den officielle dokumentation, vejledninger og wikier ; den berømte "RTFM" er stadig et af de bedste råd.
Når du har flere hypoteser, går du videre til testfasen: genstart af en specifik tjeneste, midlertidig ændring af en konfigurationsfil (med en sikkerhedskopi), deaktivering af et kernemodul, opstart med en anden kerne tilgængelig i boot manager, test af en anden fysisk enhed osv. Nøglen her er at foretage reversible og kontrollerede ændringer, en efter en , og kontrollere efter hvert trin, om problemet fortsætter.
Når du endelig finder den løsning, der eliminerer fejlen, er der et sidste trin, som ofte er det mest undervurderede: at verificere dens stabilitet over tid og dokumentere, hvad du har gjort . Ideelt set bør du genstarte din computer (hvis problemet påvirkede opstarten) eller lade systemet være belastet i et stykke tid, kontrollere, at der ikke dukker fejl op igen i loggene, og registrere løsningen i din egen tekniske logbog. Denne erfaring vil hjælpe dig med at forhindre problemet i at gentage sig eller løse det på få minutter næste gang.
Med hele dette sæt af ideer, værktøjer og metoder ophører Linux med at være en mystisk sort boks og bliver et miljø, hvor man kan diagnosticere alt fra en simpel logmeddelelse til kernelpanik eller RAM-fejl med betydelig nøjagtighed . Det handler ikke om at huske tusind kommandoer, men om at internalisere en systematisk tilgang, stole på dokumentation og fællesskabet og ikke være bange for at kigge "under motorhjelmen", når noget går galt.