- Η μικροαρχιτεκτονική ορίζει τον τρόπο με τον οποίο μια CPU υλοποιεί ένα ISA και καθορίζει το IPC, τον εσωτερικό παραλληλισμό και την πραγματική της απόδοση, πέρα από τη συχνότητα ή το μέγεθος της προσωρινής μνήμης.
- Σχεδιασμοί όπως οι AMD Zen και Zen 2 συνδυάζουν βελτιστοποιημένες προσωρινές μνήμες, εκτέλεση εκτός σειράς, SMT και μεγάλες διανυσματικές μονάδες για την ενίσχυση της απόδοσης ανά κύκλο και ανά watt.
- Η στρατηγική chiplet και Infinity Fabric επιτρέπει την κλιμάκωση του αριθμού των πυρήνων στα EPYC και Ryzen, διατηρώντας παράλληλα ελεγχόμενο κόστος και εξαιρετικά ανταγωνιστική απόδοση.
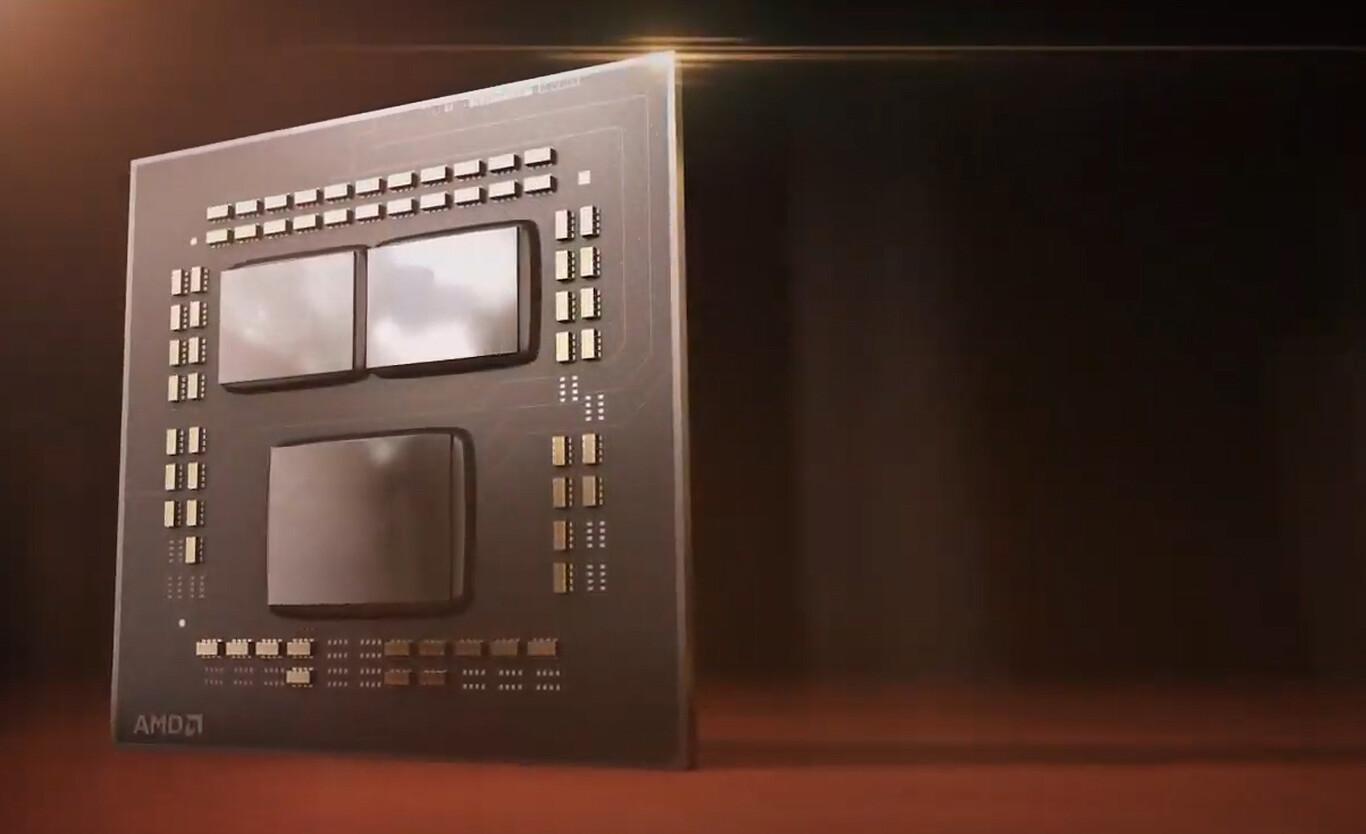
Η μικροαρχιτεκτονική μιας CPU συχνά υποβαθμίζεται σε σχέση με πιο εντυπωσιακά στοιχεία όπως τα GHz ή τα MB προσωρινής μνήμης, αλλά ακριβώς εκεί, στον εσωτερικό σχεδιασμό του επεξεργαστή, αποφασίζεται το μεγαλύτερο μέρος της πραγματικής του απόδοσης, της αποδοτικότητάς του, ακόμη και του τύπου λογισμικού που μπορεί να την αξιοποιήσει καλύτερα.
Όταν διαβάζετε τεχνικές προδιαγραφές που αναφέρουν πυρήνες, νήματα, L3 cache ή AVX2 , βλέπετε στην πραγματικότητα τις συγκεκριμένες συνέπειες μιας συγκεκριμένης μικροαρχιτεκτονικής. Η κατανόηση του τρόπου με τον οποίο οργανώνονται εσωτερικά αυτά τα στοιχεία, τι κάνει ένα Zen 3 διαφορετικό από ένα Zen 2 ή μια υβριδική Intel διαφορετική από έναν κλασικό Ryzen, είναι το κλειδί για να επιλέξετε την επόμενη CPU σας με σύνεση και να μάθετε γιατί μερικές υπερέχουν στα παιχνίδια, άλλες στην απόδοση και άλλες στις εργασίες διακομιστή.
ISA, μακροαρχιτεκτονική και μικροαρχιτεκτονική: τακτοποίηση των εννοιών
Πριν εμβαθύνουμε στις πολυπλοκότητες των αγωγών και των προγνωστικών, είναι χρήσιμο να διακρίνουμε τρία συχνά συγχέοντα επίπεδα: τη μακροαρχιτεκτονική συστήματος, το ISA και τη μικροαρχιτεκτονική . Κάθε ένα περιγράφει ένα διαφορετικό επίπεδο του υπολογιστή.
Από τη μία πλευρά, υπάρχει η μακροαρχιτεκτονική ή ο συνολικός σχεδιασμός του συστήματος , ο οποίος περιλαμβάνει όλα όσα βλέπετε στη μητρική πλακέτα: CPU, ελεγκτές μνήμης, διαύλους, κύρια μνήμη, τσιπ εισόδου/εξόδου, ελεγκτές αποθήκευσης, τυχόν εξωτερικούς επιταχυντές και λογική DMA. Είναι μια εικόνα υψηλού επιπέδου για το πώς συνδέονται τα μεγάλα εξαρτήματα υλικού και πώς ρέουν τα δεδομένα μεταξύ τους.
Πάνω από αυτό βρίσκεται η ISA (Instruction Set Architecture) , η οποία είναι το σύνολο εντολών που κατανοεί ο επεξεργαστής: οι τύποι δεδομένων που χειρίζεται, το μέγεθος λέξης, ο αριθμός και ο τύπος των καταχωρητών, οι τρόποι διευθυνσιοδότησης, οι μορφές εντολών κ.λπ. Όταν προγραμματίζετε σε assembly χρησιμοποιώντας μνημονικά όπως ADD, SUB, MUL ή καλείτε επεκτάσεις όπως SSE, AVX ή NEON, επικοινωνείτε απευθείας με το ISA.
Τέλος, έχουμε τον μικροκώδικα, ή μISA , ο οποίος ορίζει τις εσωτερικές μικρολειτουργίες που χρησιμοποιούν ορισμένες πολύπλοκες αρχιτεκτονικές (όπως η x86) για την υλοποίηση των εντολών CISC. Αυτός ο μικροκώδικας μπορεί να ενημερωθεί μέσω υλικολογισμικού για τη διόρθωση σφαλμάτων ή την προσθήκη υποστήριξης για νέες εντολές.
Τι ακριβώς είναι η μικροαρχιτεκτονική μιας CPU;
Η μικροαρχιτεκτονική της CPU είναι ουσιαστικά το εσωτερικό σχέδιο που καθορίζει τον τρόπο εκτέλεσης των εντολών ISA και τον τρόπο μετακίνησης των δεδομένων μέσα στο τσιπ. Δύο επεξεργαστές μπορούν να μοιράζονται τον ίδιο ISA (για παράδειγμα, AMD64 στην Intel και AMD) και όμως να έχουν ριζικά διαφορετική συμπεριφορά και απόδοση λόγω —ή ίσως λόγω— της μικροαρχιτεκτονικής τους.
Αυτός ο σχεδιασμός περιλαμβάνει στοιχεία όπως ο τύπος της μονάδας ελέγχου , το εάν χρησιμοποιείται προγραμματιζόμενος μικροκώδικας ή ενσύρματη λογική, η ιεραρχία μνήμης, το βάθος της αγωγιμότητας, ο αριθμός των λειτουργικών μονάδων που λειτουργούν παράλληλα και το εάν ο επεξεργαστής είναι ικανός να εκτελεί εντολές εκτός σειράς και με εικασίες.
Επιπλέον, ο σχεδιαστής πρέπει να επιλέξει το βάθος της αγωγιμότητας : από απλές CPU χωρίς αγωγιμότητα, όπου κάθε εντολή υποβάλλεται σε επεξεργασία από την αρχή μέχρι το τέλος πριν ξεκινήσει η επόμενη, έως μοντέρνα σχέδια με πολλά στάδια (ανάκτηση, αποκωδικοποίηση, μετονομασία, αποστολή, εκτέλεση, επανεγγραφή, απόσυρση...) που επιτρέπουν την ταυτόχρονη εκτέλεση δεκάδων εντολών.
Σχετικό με αυτό είναι ο αριθμός και ο τύπος των μονάδων εκτέλεσης : ALU για ακέραιους αριθμούς, μονάδες πολλαπλασιασμού, διαιρέτες, FPU για βαθμωτούς και διανυσματικούς αριθμούς κινητής υποδιαστολής, AGU (Μονάδες Δημιουργίας Διευθύνσεων) για τον υπολογισμό διευθύνσεων μνήμης, μονάδες άλματος, κ.λπ. Εάν υπάρχουν αρκετές μονάδες του ίδιου τύπου, μιλάμε για υπερβαθμωτούς επεξεργαστές, ικανούς να αποστέλλουν αρκετές εντολές ανά κύκλο.
Αυτή είναι η βάση για προηγμένες τεχνικές όπως η κερδοσκοπική εκτέλεση , όπου η CPU προβλέπει την επίλυση ενός κλάδου και εκτελεί εντολές από έναν από τους κλάδους εκ των προτέρων. Εάν η πρόβλεψη είναι σωστή, εξοικονομείται χρόνος. Εάν αποτύχει, η εργασία που έχει γίνει απορρίπτεται και ο αγωγός αδειάζει, με την αντίστοιχη ποινή.
Οι περισσότερες σύγχρονες CPU υψηλής απόδοσης χρησιμοποιούν επίσης εκτέλεση εκτός σειράς (OoO) . Αντί να τηρεί αυστηρά τη σειρά του προγράμματος, ο επεξεργαστής αναδιατάσσει εσωτερικά τις εντολές και εκτελεί πρώτα εκείνες των οποίων τα δεδομένα είναι έτοιμα, αποφεύγοντας τους κύκλους αδράνειας, ενώ άλλες περιμένουν τη μνήμη ή το αποτέλεσμα προηγούμενων λειτουργιών.
Για να λειτουργήσουν όλα αυτά χωρίς να παραβιαστεί η σημασιολογία του προγράμματος, χρησιμοποιείται η μετονομασία καταχωρητών . Ο μεταγλωττιστής βλέπει ένα περιορισμένο σύνολο λογικών καταχωρητών, αλλά η μικροαρχιτεκτονική τους μεταφράζει σε μια μεγαλύτερη τράπεζα φυσικών καταχωρητών, αναθέτοντας δυναμικά νέους προορισμούς για να σπάσει τις ψευδείς εξαρτήσεις και να επιτρέψει μεγαλύτερο παραλληλισμό.
Τέλος, ο σχεδιασμός μπορεί να επικεντρωθεί στην προσθήκη παραλληλισμού σε επίπεδο πυρήνα και νήματος . Αυτό περιλαμβάνει τα πάντα, από μονοπύρηνες CPU έως τσιπ με δεκάδες ή εκατοντάδες πυρήνες (πολυπύρηνα), συστήματα πολλαπλών επεξεργαστών με πολλαπλές υποδοχές διασυνδεδεμένες μέσω δικτύων mesh υψηλής ταχύτητας (Infinity Fabric, Intel Mesh, NVLink, κ.λπ.) και υποστήριξη ταυτόχρονης πολυνηματοποίησης (SMT), έτσι ώστε κάθε φυσικός πυρήνας να μπορεί να χειριστεί δύο ή περισσότερα λογικά νήματα.
Συμβατότητα, ISA και οικογένειες μικροαρχιτεκτονικής
Δεδομένου ότι μια μικροαρχιτεκτονική είναι απλώς μία συγκεκριμένη υλοποίηση ενός ISA , ένα μεμονωμένο ISA μπορεί να έχει δεκάδες διαφορετικές μικροαρχιτεκτονικές με την πάροδο των ετών και από διαφορετικούς κατασκευαστές. Αυτό ακριβώς συμβαίνει με τα x86-64/AMD64 ή ARM.
Εξετάζοντας αποκλειστικά την AMD εντός του AMD64 ISA, βρίσκουμε οικογένειες τόσο διαφορετικές όσο οι K8/Hammer, K10, Bulldozer και ολόκληρη η σειρά Zen (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Όλες εκτελούν το ίδιο βασικό σύνολο εντολών, αλλά η εσωτερική τους οργάνωση, οι κρυφές μνήμες, οι αγωγοί και οι παράλληλες προσεγγίσεις εκτέλεσης είναι εντελώς διαφορετικές.
Όταν αλλάζουμε ISA, το άλμα στη συμβατότητα είναι απόλυτο. Ένας επεξεργαστής που βασίζεται σε ARM A64 (όπως η Apple Silicon) δεν μπορεί να εκτελέσει δυαδικά αρχεία που έχουν μεταγλωττιστεί για x86-64 και αντίστροφα, εκτός εάν χρησιμοποιηθεί ένα επίπεδο μετάφρασης ή εξομοίωσης όπως Rosetta 2, QEMU ή παρόμοιο, με το αντίστοιχο κόστος απόδοσης.
Ακόμα και μεταξύ των επεξεργαστών που μοιράζονται ένα ISA, δεν υπάρχει εγγύηση ότι όλοι υποστηρίζουν το ίδιο σύνολο εντολών ή επεκτάσεις. Ένα παλαιότερο τσιπ μπορεί να μην διαθέτει AVX2 ή AVX-512 ή ένα ARM SoC μπορεί να υλοποιεί μόνο ένα υποσύνολο προαιρετικών επεκτάσεων. Επομένως, ένα δυαδικό αρχείο που χρησιμοποιεί σε μεγάλο βαθμό το AVX-512 ενδέχεται να μην εκκινήσει σε μια CPU που προσφέρει μόνο SSE4.
Κατά τη μεταγλώττιση λογισμικού, είναι συνήθης πρακτική η δημιουργία γενικών δυαδικών αρχείων για ένα συγκεκριμένο ISA (για παράδειγμα, x86-64 με τουλάχιστον SSE2) χωρίς να αξιοποιείται πλήρως κάποια συγκεκριμένη μικροαρχιτεκτονική, έτσι ώστε το εκτελέσιμο αρχείο να εκτελείται σε όσο το δυνατόν περισσότερες CPU. Ωστόσο, εάν μεταγλωττίσετε με σημαίες ρύθμισης για μια συγκεκριμένη μικροαρχιτεκτονική (-march=znver3, -mtune=skylake, κ.λπ.), μπορείτε να βελτιώσετε σημαντικά την απόδοση σε αυτήν τη συγκεκριμένη οικογένεια, με κόστος την απώλεια συμβατότητας με άλλες.
Άδειες ISA και πνευματική ιδιοκτησία του σχεδίου
Δεν προστατεύεται μόνο ο κώδικας προγράμματος από άδειες χρήσης: τα ISA και οι μικροαρχιτεκτονικές αποτελούν επίσης πνευματική ιδιοκτησία. Κανείς δεν μπορεί νόμιμα να κλωνοποιήσει ένα ISA x86 ή AMD64 χωρίς άδεια χρήσης, όπως ακριβώς δεν μπορεί να αντιγραφεί ένα ιδιόκτητο σχέδιο CPU χωρίς άδεια.
Στον τομέα των ISA, υπάρχουν τρεις κύριες προσεγγίσεις. Από τη μία πλευρά, υπάρχουν τα κλειστά ISA , όπου ο κάτοχος ελέγχει αυστηρά ποιος μπορεί να εφαρμόσει συμβατούς πυρήνες. Το κλασικό παράδειγμα είναι το IA-32 (x86-32), που ιστορικά ανήκε στην Intel, η οποία χορήγησε άδειες χρήσης στην AMD, την VIA και άλλους, όχι χωρίς νομικές μάχες.
Παρόμοια κατάσταση επικρατεί και με την AMD64/x86-64 , η οποία σχεδιάστηκε αρχικά από την AMD και αργότερα παραχωρήθηκε με άδεια στην Intel (η οποία την ονόμασε EM64T) μέσω συμφωνιών διασταυρούμενης αδειοδότησης. Άλλοι παίκτες, όπως η Hygon στην Κίνα, έχουν επίσης λάβει άδειες για συγκεκριμένες εκδόσεις (για παράδειγμα, η Zen 1 για την κινεζική αγορά).
Έπειτα, έχουμε ISA με ευέλικτη αδειοδότηση , όπου ο κάτοχος προσφέρει τόσο άδειες ISA όσο και πυρήνες IP έτοιμους προς ενσωμάτωση. Εδώ ταιριάζουν οι ARM, SPARC ή OpenPOWER: μπορείτε να πληρώσετε για να χρησιμοποιήσετε το Cortex A/M/R ή το Neoverse ως έχουν ή για μια άδεια χρήσης που σας επιτρέπει να σχεδιάσετε τις δικές σας μικροαρχιτεκτονικές πάνω στο ISA, όπως κάνει η Apple με τα M1/M2/M3 ή η Qualcomm με το Kryo.
Τέλος, υπάρχουν τα ISA ανοιχτού κώδικα , όπου ο καθένας μπορεί να δημιουργήσει συμβατές μικροαρχιτεκτονικές χωρίς να πληρώνει δικαιώματα για το ISA (αν και μπορεί να κατοχυρώσει με δίπλωμα ευρεσιτεχνίας ή να κλείσει τη δική του υλοποίηση). Το RISC-V είναι το καλύτερο παράδειγμα: το ISA βρίσκεται υπό μια επιτρεπτική άδεια BSD και υπάρχουν επιλογές που κυμαίνονται από πλήρως ανοιχτούς πυρήνες σε Verilog ή Chisel έως κλειστά εμπορικά σχέδια.
Εκτός από το ISA, κάθε συγκεκριμένη μικροαρχιτεκτονική (ένας πυρήνας Zen 4, ένας Cortex X4, ένα σχέδιο GPU, κ.λπ.) αποτελεί ένα μπλοκ κατοχυρωμένης με δίπλωμα ευρεσιτεχνίας ή καταχωρημένης πνευματικής ιδιοκτησίας. Υπάρχουν επίσης ανοιχτά σχέδια εδώ, που δημοσιεύονται ως μαλακοί πυρήνες σε HDL για σύνθεση σε FPGA ή ενσωμάτωση σε προσαρμοσμένα SoCs.
Εμβαθύνοντας στις σύγχρονες μικροαρχιτεκτονικές: η περίπτωση Zen της AMD
Για να δούμε πώς όλα αυτά μεταφράζονται σε απόδοση στον πραγματικό κόσμο, δεν υπάρχει τίποτα καλύτερο από την ανάλυση μιας συγκεκριμένης οικογένειας προϊόντων. Η AMD έχει μεταμορφώσει δραματικά την επιχείρησή της χάρη στο Zen και τις διαδοχικές εκδόσεις του , μεταβαίνοντας από τη δύσκολη εποχή του Bulldozer και τους παλιούς επεξεργαστές FX σε ανταγωνιστικούς (και μερικές φορές ακόμη και ξεπερνώντας) τους Intel στις αγορές επιτραπέζιων υπολογιστών, διακομιστών και φορητών υπολογιστών.
Μετά την αποτυχία της στρατηγικής AMD Fusion , η εταιρεία αναδιαρθρώθηκε και επέλεξε ένα σχέδιο υψηλής απόδοσης με επικεφαλής, μεταξύ άλλων, τον Jim Keller. Το σχέδιο Zen στόχευε στην επιθετική αύξηση του IPC (εντολές ανά κύκλο) σε σύγκριση με το Bulldozer, στη βελτίωση της απόδοσης ανά watt και στην ανάκτηση του εδάφους στην απόδοση ενός πυρήνα, όπου η Intel κατείχε το προβάδισμα για χρόνια.
Μία από τις βασικές αλλαγές ήταν η ενίσχυση του front-end , του τμήματος που είναι υπεύθυνο για την ανάκτηση και την προετοιμασία εντολών. Η Zen εισήγαγε μια προσωρινή μνήμη μικρολειτουργιών που αποθηκεύει ήδη αποκωδικοποιημένες μικρολειτουργίες, παρόμοια με αυτήν που έκαναν ορισμένες μικροαρχιτεκτονικές της Intel, όπως η Conroe. Η Bulldozer δεν είχε αυτό το χαρακτηριστικό και βασιζόταν περισσότερο στην κλασική ιεραρχία της προσωρινής μνήμης εντολών, γεγονός που επηρέασε αρνητικά την απόδοσή της.
Ο αποκωδικοποιητής του Zen μπορεί να μεταφράσει έως και τέσσερις εντολές CISC x86-64 ανά κύκλο σε μικρο-λειτουργίες τύπου RISC. Αυτές οι μικρο-λειτουργίες τοποθετούνται στη συνέχεια σε μια ουρά που τροφοδοτείται από το buffer μικρο-λειτουργιών, το οποίο με τη σειρά του μπορεί να αποστείλει έως και έξι μικρο-λειτουργίες ανά κύκλο στους χρονοπρογραμματιστές back-end. Εδώ ξεκινά η εκτέλεση εκτός σειράς.
Η AMD διαχώρισε με σαφήνεια τις διαδρομές ακεραίων και κινητής υποδιαστολής . Από την πλευρά των ακεραίων, οι ALU, οι AGU και η λογική φόρτωσης/αποθήκευσης τροφοδοτούνται από την ουρά μικρο-λειτουργιών. Αυτή η λογική είναι ικανή να εκτελέσει δύο φορτώσεις 16 byte και μία αποθήκευση 16 byte ανά κύκλο από μια L1D 8 κατευθύνσεων 32 KB, με πολιτική αντιγραφής.
Η πλευρά κινητής υποδιαστολής και διανύσματος τροφοδοτεί μονάδες FMAC και AVX. Με δύο θύρες πολλαπλασιασμού και δύο θύρες πρόσθεσης, το Zen μπορεί να εκτελέσει ταυτόχρονα δύο λειτουργίες FMA 128-bit ή μία λειτουργία AVX 256-bit ανά κύκλο ρολογιού. Αυτός ο παραλληλισμός σε επίπεδο εντολών είναι ένα από τα κλειδιά για την ισχυρή του απόδοση σε υπολογιστικά απαιτητικά φόρτα εργασίας.
Ιεραρχία προσωρινής μνήμης, TLB και οργάνωση μνήμης στο Zen
Η ιεραρχία μνήμης στο Zen είναι οργανωμένη σε τρία επίπεδα προσωρινής μνήμης: ξεχωριστή L1 για οδηγίες και δεδομένα, ιδιωτική L2 ανά πυρήνα και κοινόχρηστη L3 . Παρόλο που κληρονομεί τη βασική δομή προηγούμενων μικροαρχιτεκτονικών, τα μεγέθη, η συσχετιστικότητα και οι πολιτικές έχουν βελτιωθεί.
Η L1I (cache εντολών) προσφέρει 64 KB ανά πυρήνα, με 4 συσχετιστικές διαδρομές, διπλασιάζοντας τον αριθμό των διαδρομών ανά ενότητα σε σύγκριση με το Bulldozer και μειώνοντας τις διενέξεις. Η L1D (cache δεδομένων) αυξάνεται σε 32 KB, 8 διαδρομές και πολιτική επανεγγραφής, σε σύγκριση με τα 16 KB, 4 διαδρομές και εγγραφή μέσω του Bulldozer, βελτιώνοντας σημαντικά τόσο το ποσοστό επιτυχίας όσο και την αποδοτικότητα εγγραφής.
Η L2 cache υλοποιείται ως 512 KB ανά πυρήνα και 8-way, αντί για τα 2 MB 16-way που ήταν κοινόχρηστα ανά module της προηγούμενης γενιάς. Η L3 cache, εν τω μεταξύ, προσφέρει αρκετά MB ανά πυρήνα με 16-way associativity, λειτουργώντας ως το τελευταίο κοινόχρηστο επίπεδο πριν από τη μετάβαση στη DRAM.
Παράλληλα, το Zen διαχωρίζει τα TLB σε ITLB (για εντολές) και DTLB (για δεδομένα) , καθένα με πολλά επίπεδα και εκατοντάδες καταχωρήσεις, όλα με προστασία ισοτιμίας. Αυτό μειώνει σημαντικά την καθυστέρηση μετάφρασης διευθύνσεων από εικονική σε φυσική, η οποία καθίσταται ολοένα και πιο κρίσιμη καθώς αυξάνονται τα μεγέθη μνήμης.
Όταν μιλάμε για μια cache που είναι αμφίδρομη, τετραπλή ή οκταπλή , περιγράφουμε τη συσχετιστικότητά της, η οποία σχετίζεται στενά με την ιδέα της παρεμβολής στη μνήμη. Περισσότερη συσχετιστικότητα σημαίνει περισσότερους διαφορετικούς τρόπους αποθήκευσης ενός μπλοκ μνήμης σε αυτήν την cache, μειώνοντας τις διενέξεις, αλλά με κόστος μια ελαφρώς πιο σύνθετη λογική και μια μικρή αύξηση στην καθυστέρηση.
Είναι επίσης σημαντικό να κατανοήσετε τη διαφορά μεταξύ εγγραφής μέσω και εγγραφής πίσω . Στην εγγραφή μέσω, κάθε εγγραφή ενημερώνει ταυτόχρονα τόσο την προσωρινή μνήμη όσο και την κύρια μνήμη, απλοποιώντας τη συνέπεια αλλά αυξάνοντας την κίνηση. Στην εγγραφή πίσω, εγγράφεται μόνο η προσωρινή μνήμη και η γραμμή σημειώνεται με ένα μη καθαρό bit. Η DRAM ενημερώνεται μόνο όταν αυτή η γραμμή αφαιρεθεί, εξοικονομώντας εύρος ζώνης και βελτιώνοντας την απόδοση με κόστος μια ελαφρώς πιο σύνθετη λογική.
Zen και Zen+: ένα άλμα στον ΔΤΚ και την αποδοτικότητα
Το Zen αντιπροσώπευε ένα πολύ σημαντικό άλμα IPC για την AMD σε σύγκριση με το Bulldozer , χάρη στον συνδυασμό ενός καλύτερου front-end, ενός καλύτερου predictor κλάδων, περισσότερων μονάδων εκτέλεσης, SMT αντί για CMT (κάθε πλήρης πυρήνας χειρίζεται δύο νήματα, αντί να μοιράζεται μέρος της FPU μεταξύ δύο λογικών πυρήνων) και μιας πολύ πιο λογικής ιεραρχίας cache.
Εκτός από τον σχεδιασμό, η AMD επωφελήθηκε από πιο προηγμένες διαδικασίες κατασκευής με FinFET και μικρότερους κόμβους , οι οποίες επιτρέπουν αυξημένη πυκνότητα τρανζίστορ, μειωμένη κατανάλωση ενέργειας με την ίδια απόδοση και υψηλότερες συχνότητες, διατηρώντας παράλληλα λογικά TDP ( καμπύλη τάσης-συχνότητας ). Αυτή η ισορροπία απόδοσης ανά watt ήταν κρίσιμη για την ανάκτηση της ανταγωνιστικότητας σε φορητούς υπολογιστές και διακομιστές.
Η μετάβαση από το Bulldozer στο Zen έφερε επίσης μεγαλύτερες ουρές απόσυρσης, μεγαλύτερους χρονοπρογραμματιστές εντολών, μεγαλύτερο εσωτερικό εύρος ζώνης, πρόβλεψη διακλάδωσης με τεχνικές που βασίζονται ακόμη και σε απλά νευρωνικά δίκτυα και ένα SMT ικανό να συμπιέσει καλύτερα τις διαθέσιμες μονάδες εκτέλεσης.
Σε αυτό το πλαίσιο, αναδύεται το Zen+ , το οποίο θα μπορούσαμε να δούμε ως το ισοδύναμο ενός "τικ" στην παλιά στρατηγική Tick-Tock της Intel: ο ίδιος βασικός σχεδιασμός με το Zen, αλλά κατασκευασμένος σε έναν πιο εκλεπτυσμένο κόμβο, με βελτιώσεις συχνότητας, μικρές μειώσεις καθυστέρησης και εσωτερικές προσαρμογές χρονισμού. Δεν πρόκειται για μια αρχιτεκτονική επανάσταση, αλλά μάλλον για μια βελτίωση που μεταφράζεται σε μερικά επιπλέον σημεία απόδοσης.
Zen 2: τσιπλέτες, πλήρες AVX2 και βαθιά βελτίωση
Με το Zen 2 , η AMD δεν απλώς βελτιώνει τη διαδικασία: εισάγει ουσιαστικές αλλαγές στη μικροαρχιτεκτονική και λανσάρει μαζικά τη στρατηγική της για τα chiplet . Αντί για ένα μεγάλο μονολιθικό die, χωρίζει το σχέδιο σε πολλά μικρότερα compute dies (CCDs) 7nm και ένα ξεχωριστό die I/O 12nm που χειρίζεται μνήμη, PCIe και διασυνδέσεις.
Αυτή η προσέγγιση chiplet βελτιώνει την απόδοση ανά πλακέτα (είναι ευκολότερη η κατασκευή μικρών, χωρίς ελαττώματα καλουπιών), μειώνει το κόστος και διευκολύνει την κλιμάκωση του αριθμού των πυρήνων: απλώς προσθέστε περισσότερους CCD για να φτάσετε τους 16, 32 ή περισσότερους πυρήνες σε EPYC και Threadripper. Το αντάλλαγμα είναι η ελαφρώς πιο περίπλοκη εσωτερική επικοινωνία, που εξαρτάται από τη διασύνδεση Infinity Fabric, την οποία η AMD βελτιώνει γενιά με τη γενιά.
Όσον αφορά την ακατέργαστη απόδοση, η AMD κάνει λόγο για περίπου +15% IPC για το Zen 2 σε σύγκριση με το Zen+ στην ίδια συχνότητα και μια συνολική βελτίωση απόδοσης ανά watt που μπορεί να είναι περίπου +75% σε σύγκριση με το πρώτο Zen όταν συνδυάζονται οι βελτιώσεις στο σχεδιασμό και τη διαδικασία.
Στο διανυσματικό back-end, το Zen 2 αναλαμβάνει το κομμάτι που έλειπε: προσφέρει πλήρη υποστήριξη AVX2 256-bit σε μία μόνο μικρο-λειτουργία , χωρίς να χωρίζει τις εντολές σε δύο λειτουργίες 128-bit όπως συνέβαινε στο Zen/Zen+. Αυτό σημαίνει ότι οι μονάδες διανυσματικής εκτέλεσης είναι πλέον πραγματικά 256-bit και μπορούν να επεξεργάζονται φόρτους εργασίας AVX2 σε πλήρη ταχύτητα με πολύ μικρότερη ποινή συχνότητας από ό,τι σε άλλα σχέδια.
Η προσωρινή μνήμη micro-ops ενισχύεται επίσης, αυξάνοντας τις καταχωρήσεις σε 4K (διπλάσιο μέγεθος), εκμεταλλευόμενη μέρος της περιοχής που απελευθερώνεται με τη μείωση στο μισό της προσωρινής μνήμης L1I, αλλά διπλασιάζοντας τη συσχετιστικότητά της από 4 σε 8 τρόπους. Εσωτερικές προσομοιώσεις οδήγησαν την AMD στο συμπέρασμα ότι, για τα περισσότερα φόρτα εργασίας πραγματικού κόσμου, μια μεγαλύτερη προσωρινή μνήμη uop είναι πιο πλεονεκτική από μια μεγαλύτερη προσωρινή μνήμη L1I.
Η χωρητικότητα της προσωρινής μνήμης L3 ανά μπλοκ πυρήνα διπλασιάζεται , γεγονός που βοηθά στη μείωση των σφαλμάτων τελευταίου επιπέδου, αν και η καθυστέρηση πρόσβασης αυξάνεται από περίπου 35 σε 40 κύκλους. Για να μετριαστεί αυτό το φαινόμενο, το Zen 2 βελτιώνει το εύρος ζώνης φόρτωσης και αποθήκευσης και βελτιώνει την πολιτική προανάκτησης.
Μια άλλη σημαντική πτυχή είναι ο προγνωστικός μηχανισμός διακλάδωσης. Το Zen 2 χρησιμοποιεί έναν προγνωστικό μηχανισμό TAGE (TAgged GEometric) με πάνω από 7 καταχωρήσεις, ικανό να αξιοποιήσει ιστορικά μεταβλητού μήκους και καταχωρήσεις με ετικέτες. Αυτό μειώνει την ψευδωνυμοποίηση μεταξύ διαφορετικών διακλαδώσεων και, σύμφωνα με την AMD, μειώνει τον αριθμό των λανθασμένων προβλέψεων κατά περίπου 30% σε σύγκριση με το προηγούμενο σχήμα, γεγονός που μεταφράζεται άμεσα σε λιγότερες εκκαθαρίσεις αγωγών και υψηλότερο IPC.
Zen 2 Back-end: AGU, buffers και προσαρμοσμένες καθυστερήσεις
Σε ολόκληρο το back-end, το Zen 2 συνεχίζει να αποστέλλει έως και έξι μικρο-λειτουργίες ανά κύκλο από το buffer αναδιάταξης, το οποίο επεκτείνεται σε περίπου 224 καταχωρήσεις (σε σύγκριση με τις 192 του Zen). Οι μονάδες προγραμματισμού χωρίζονται σε τέσσερις ουρές για ALU των 16 καταχωρήσεων η καθεμία και μία ουρά για AGU των 28 καταχωρήσεων.
Ο αριθμός των Μονάδων Δημιουργίας Διευθύνσεων (AGU) αυξάνεται από δύο σε τρεις, αν και δεν είναι όλες ίδιες: δύο από αυτές μπορούν να χειριστούν τόσο φορτώσεις όσο και εγγραφές, ενώ η τρίτη ειδικεύεται σε λειτουργίες αποθήκευσης. Αυτή η κατανομή έχει σχεδιαστεί για τυπικά προφίλ λογισμικού, όπου οι φορτώσεις είναι συνήθως πιο συχνές και κρίσιμες από τις λειτουργίες αποθήκευσης.
Στο επίπεδο κινητής υποδιαστολής, το back-end μπορεί να δεχτεί τέσσερις μικρο-λειτουργίες ανά κύκλο στις διανυσματικές μονάδες FMA 256-bit, υποστηριζόμενες από ένα φυσικό αρχείο καταχωρητή 160 καταχωρήσεων. Οι διαδρομές φόρτωσης/αποθήκευσης 256-bit έχουν βελτιωθεί για να τροφοδοτούν αυτές τις μονάδες με σταθερό ρυθμό υπό βαριά διανυσματικά φόρτα εργασίας.
Το Zen 2 προσαρμόζει επίσης τις καθυστερήσεις ορισμένων λειτουργιών : για παράδειγμα, ο πολλαπλασιασμός κινητής υποδιαστολής μειώνει την καθυστέρηση από 4 σε 3 κύκλους, κάτι που βοηθάει σε πολύ στενούς βρόχους αριθμητικών υπολογισμών. Και, γενικά, υπάρχει ένα σύνολο μικρών βελτιστοποιήσεων που είναι διασκορπισμένες σε όλο το αγωγό και προστίθενται σε αυτό το επιπλέον IPC που παρατηρείται σε συνθετικά benchmarks και εφαρμογές πραγματικού κόσμου.
Όσον αφορά την εσωτερική ιεραρχία ανά ομάδες πυρήνων, η AMD χρησιμοποιεί την έννοια CCX (Core Complex) : ένα μπλοκ 4 πυρήνων που μοιράζονται την ίδια προσωρινή μνήμη L3 (16 MB στο Zen 2). Αυτό το επιπλέον μέγεθος συνεπάγεται ελαφρώς υψηλότερη καθυστέρηση, αλλά σε αντάλλαγμα μειώνει το ποσοστό αστοχίας, ειδικά σε εφαρμογές με μεγάλα σύνολα εργασίας.
Για αναφορά, μπορούμε να θυμηθούμε κατά προσέγγιση αριθμούς εσωτερικής καθυστέρησης: περίπου 4 κύκλοι για το L1 , περίπου 12 για το L2 και περίπου 40 κύκλοι για το L3. Το κλειδί είναι να διατηρηθούν όσο το δυνατόν περισσότερα δεδομένα στο L1/L2 και να μειωθεί η κίνηση στο L3 και την DRAM , κάτι για το οποίο συνεργάζονται η μικροαρχιτεκτονική και οι μεταγλωττιστές.
Infinity Fabric: η κόλλα που χρησιμοποιείται στα τσιπλέτα και η επίδρασή της στην απόδοση
Ένα στοιχείο που δεν σχετίζεται πάντα με τη μικροαρχιτεκτονική, αλλά είναι ζωτικής σημασίας στο Zen 2 και σε νεότερες εκδόσεις, είναι το Infinity Fabric . Αυτός ο ιδιόκτητος δίαυλος λειτουργεί ως «λεωφόρος» επικοινωνίας μεταξύ των CCX, των CCD, της μήτρας I/O, της μνήμης και, γενικά, μεταξύ όλων των μπλοκ του SoC.
Το Infinity Fabric αποτελεί εξέλιξη του HyperTransport , του διαύλου υψηλής ταχύτητας που πρωτοστάτησε η AMD πριν από χρόνια και το οποίο χρησιμοποιήθηκε επίσης από τρίτους όπως η NVIDIA, η Cisco, η Sun και άλλα μέλη της κοινοπραξίας. Το IF κληρονομεί τη φιλοσοφία των κλιμακούμενων συνδέσεων από σημείο σε σημείο, αλλά είναι προσαρμοσμένο στις ανάγκες των σύγχρονων SoC και της διασύνδεσης CPU-GPU.
Στο Zen 2, η AMD εισάγει το IF2 , με υποστήριξη για PCIe 4.0 και εσωτερικό δίαυλο 512-bit μεταξύ των CCX, διπλάσιο από αυτό της πρώτης έκδοσης. Αυτό μεταφράζεται σε πιο αποτελεσματικό εύρος ζώνης και βελτίωση της απόδοσης που η AMD εκτιμά σε περίπου 27% σε σύγκριση με το IF1, συμβάλλοντας στον μετριασμό της επιβάρυνσης απόδοσης από την εναλλαγή μεταξύ chiplets.
Επιπλέον, το ρολόι Infinity Fabric είναι μερικώς αποσυνδεδεμένο από το ρολόι DRAM , επιτρέποντας στην κύρια μνήμη να κλιμακώνεται σε υψηλότερες συχνότητες σε ορισμένα σενάρια χωρίς απαραίτητα να αναγκάζει την IF να συμβαδίζει, γεγονός που προσφέρει περισσότερο χώρο για βελτιστοποίηση στους ενθουσιώδεις και τους σχεδιαστές συστημάτων.
Σε επεξεργαστές διακομιστών όπως ο EPYC , με τέσσερα ή περισσότερα υπολογιστικά chiplets, το Infinity Fabric είναι αυτό που καθιστά δυνατή τη σύνδεση όλων των ζαριών μεταξύ τους με σχεδόν πλήρεις τοπολογίες (περιστροφές 180º, απευθείας συνδέσεις κ.λπ.), επιτυγχάνοντας εύρος ζώνης die-to-die που μπορεί εύκολα να ξεπεράσει τα 150 GB/s αμφίδρομης σύνδεσης, ανάλογα με την ταχύτητα της χρησιμοποιούμενης DDR.
Ο συνδυασμός μιας ισχυρής μικροαρχιτεκτονικής σε κάθε πυρήνα , ενός κλιμακωτού σχεδιασμού που χρησιμοποιεί chiplets και επαρκώς γρήγορων διασυνδέσεων επιτρέπει στην AMD να συναρμολογεί CPU με 32, 64 ή περισσότερους πυρήνες με εξαιρετική απόδοση σε εξαιρετικά παράλληλα φόρτα εργασίας, διατηρώντας παράλληλα ανταγωνιστικό IPC ανά νήμα.
Τελικά, όταν συγκρίνετε επεξεργαστές σε benchmarks παιχνιδιών, τρισδιάστατη απόδοση, μαζική μεταγλώττιση ή επιστημονική προσομοίωση, τα στοιχεία για τα GHz και τον αριθμό πυρήνων λένε μόνο ένα μέρος της ιστορίας. Αυτό που πραγματικά κάνει τη διαφορά είναι ο τρόπος με τον οποίο η μικροαρχιτεκτονική ενορχηστρώνει την εσωτερική εκτέλεση , πώς χρησιμοποιεί ή σπαταλά κάθε κύκλο ρολογιού και ποιες αντισταθμίσεις έχει κάνει ο κατασκευαστής μεταξύ καθυστέρησης, εύρους ζώνης, κατανάλωσης ενέργειας και πολυπλοκότητας.

Δείκτης
- 1 ISA, μακροαρχιτεκτονική και μικροαρχιτεκτονική: τακτοποίηση των εννοιών
- 2 Τι ακριβώς είναι η μικροαρχιτεκτονική μιας CPU;
- 3 Συμβατότητα, ISA και οικογένειες μικροαρχιτεκτονικής
- 4 Άδειες ISA και πνευματική ιδιοκτησία του σχεδίου
- 5 Εμβαθύνοντας στις σύγχρονες μικροαρχιτεκτονικές: η περίπτωση Zen της AMD
- 6 Ιεραρχία προσωρινής μνήμης, TLB και οργάνωση μνήμης στο Zen
- 7 Zen και Zen+: ένα άλμα στον ΔΤΚ και την αποδοτικότητα
- 8 Zen 2: τσιπλέτες, πλήρες AVX2 και βαθιά βελτίωση
- 9 Zen 2 Back-end: AGU, buffers και προσαρμοσμένες καθυστερήσεις
- 10 Infinity Fabric: η κόλλα που χρησιμοποιείται στα τσιπλέτα και η επίδρασή της στην απόδοση