- Mikroarkkitehtuuri määrittelee, miten CPU toteuttaa ISA:n ja määrittää sen IPC:n, sisäisen rinnakkaisuuden ja todellisen tehokkuuden taajuuden tai välimuistin koon lisäksi.
- AMD Zenin ja Zen 2:n kaltaiset mallit yhdistävät optimoidut välimuistit, epäjärjestyksessä olevan suorituksen, SMT:n ja suuret vektoriyksiköt parantaakseen suorituskykyä sykliä ja wattia kohden.
- Siru- ja Infinity Fabric -strategia mahdollistaa ydinten määrän skaalaamisen EPYC:ssä ja Ryzenissä samalla, kun kustannukset pysyvät hallinnassa ja suorituskyky erittäin kilpailukykyisenä.
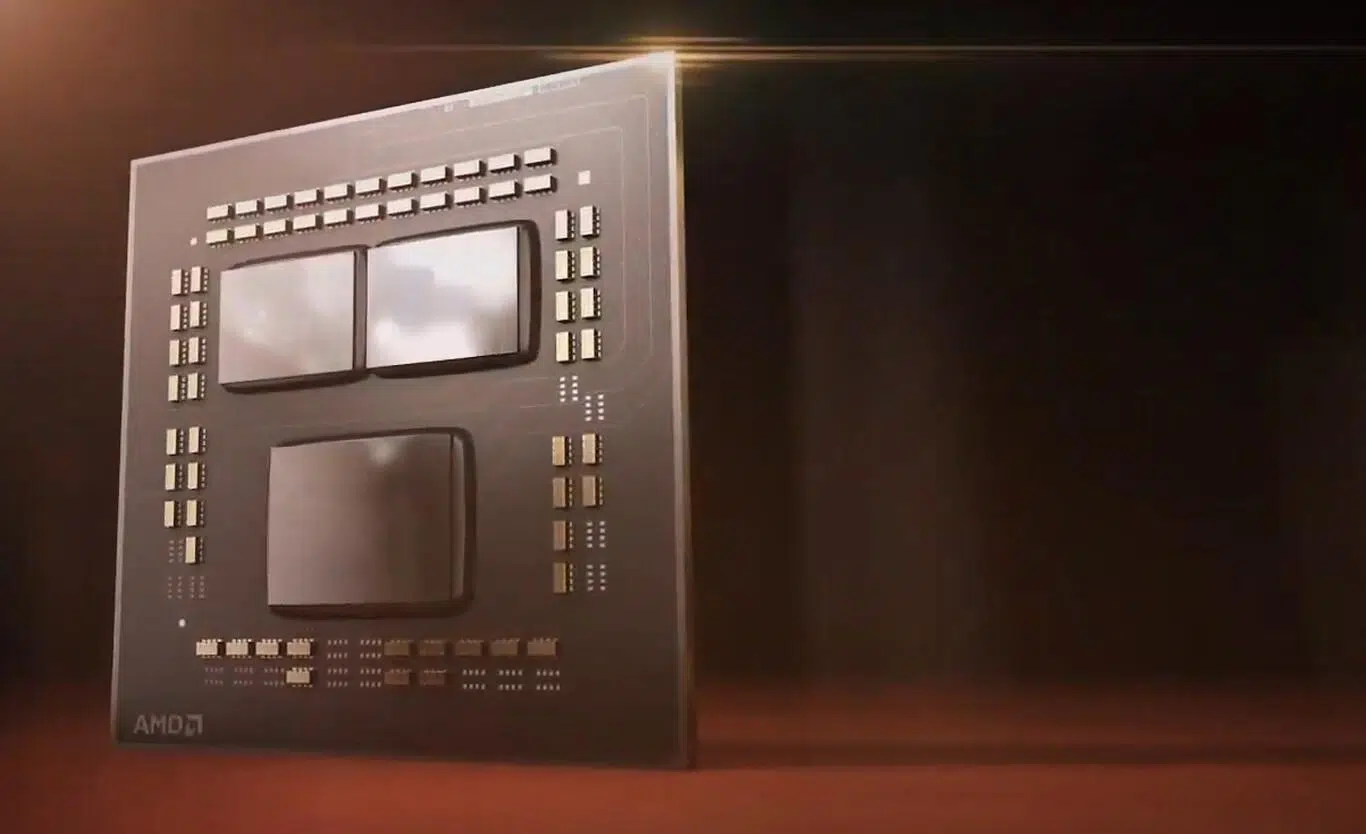
Suorittimen mikroarkkitehtuuri jää usein taka-alalle huomiota herättävämpien lukujen, kuten GHz:ien tai välimuistin megatavujen, rinnalle, mutta juuri siellä, suorittimen sisäisessä suunnittelussa, päätetään suurin osa sen todellisesta suorituskyvystä, tehokkuudesta ja jopa siitä, minkä tyyppinen ohjelmisto voi parhaiten hyödyntää sitä.
Kun luet teknisiä tietoja, joissa mainitaan ytimet, säikeet, L3-välimuisti tai AVX2 , näet itse asiassa tietyn mikroarkkitehtuurin konkreettiset seuraukset. Ymmärrys siitä, miten nämä komponentit on järjestetty sisäisesti, mikä erottaa Zen 3:n Zen 2:sta tai hybridi-Intelin klassisesta Ryzenistä, on avainasemassa seuraavan suorittimen viisaassa valinnassa ja sen ymmärtämisessä, miksi jotkut loistavat pelaamisessa, toiset renderöinnissä ja vielä toiset palvelintehtävissä.
ISA, makroarkkitehtuuri ja mikroarkkitehtuuri: käsitteiden järjestys
Ennen kuin syvennymme prosessien ja ennustajien monimutkaisuuteen, on hyödyllistä erottaa toisistaan kolme usein sekoitettavaa tasoa: järjestelmän makroarkkitehtuuri, ISA ja mikroarkkitehtuuri . Kukin kuvaa tietokoneen eri tasoa.
Toisaalta on makroarkkitehtuuri eli kokonaisvaltainen järjestelmäsuunnittelu , joka kattaa kaiken, mitä emolevyllä näkyy: suorittimen, muistiohjaimet, väylät, keskusmuistin, tulo-/lähtöpiirit, tallennusohjaimet, mahdolliset ulkoiset kiihdyttimet ja DMA-logiikan. Se on yleiskuva siitä, miten suuret laitteistokomponentit yhdistyvät ja miten data virtaa niiden välillä.
Sen yläpuolella on ISA (Instruction Set Architecture) , joka on prosessorin ymmärtämä käskykanta: käsittelemänsä datatyypit, sanakoko, rekistereiden lukumäärä ja tyyppi, osoitustilat, käskymuodot jne. Kun ohjelmoit assembly-kielellä käyttämällä muistisääntöä, kuten ADD, SUB, MUL , tai kutsumalla laajennuksia, kuten SSE, AVX tai NEON, kommunikoit suoraan ISA:n kanssa.
Lopuksi meillä on mikrokoodi eli μISA , joka määrittelee sisäiset mikro-operaatiot, joita jotkut monimutkaiset arkkitehtuurit (kuten x86) käyttävät CISC-käskyjensä toteuttamiseen. Tätä mikrokoodia voidaan päivittää laiteohjelmiston kautta virheiden korjaamiseksi tai uusien käskyjen tuen lisäämiseksi.
Mikä tarkalleen ottaen on suorittimen mikroarkkitehtuuri?
Suorittimen (CPU) mikroarkkitehtuuri on pohjimmiltaan sisäinen suunnitelma, joka määrittää, miten ISA-käskyt suoritetaan ja miten data liikkuu sirun sisällä. Kaksi prosessoria voi jakaa saman ISA:n (esimerkiksi Intelin AMD64 ja AMD) ja silti niiden käyttäytyminen ja suorituskyky voivat olla täysin erilaisia mikroarkkitehtuurinsa vuoksi – tai kenties juuri siksi.
Tämä suunnittelu sisältää elementtejä, kuten ohjausyksikön tyypin , käytetäänkö ohjelmoitavaa mikrokoodia vai kiinteästi kytkettyä logiikkaa; muistihierarkian; putken syvyyden; kuinka monta toiminnallista yksikköä toimii rinnakkain; ja pystyykö prosessori suorittamaan käskyjä epäjärjestyksessä ja spekulatiivisesti.
Lisäksi suunnittelijan on valittava prosessin kulku : yksinkertaisista suorittimista ilman faasimuutoksia, joissa jokainen käsky käsitellään alusta loppuun ennen seuraavan aloittamista, moderneihin malleihin, joissa on useita vaiheita (nouto, dekoodaus, nimeäminen uudelleen, lähettäminen, suoritus, takaisinkirjoitus, poistaminen käytöstä...), jotka mahdollistavat kymmenien käskyjen samanaikaisen suorittamisen.
Tähän liittyy suoritusyksiköiden lukumäärä ja tyyppi : ALUt kokonaisluvuille, kertolaskuyksiköt, jakajat, FPUt skalaari- ja vektoriliukulukuille, AGUt (osoitteenmuodostusyksiköt) muistiosoitteiden laskemiseen, hyppyyksiköt jne. Jos saman tyyppisiä yksiköitä on useita, puhumme superskalaarisuorittimista, jotka pystyvät suorittamaan useita käskyjä sykliä kohden.
Tämä on perusta edistyneille tekniikoille, kuten spekulatiiviselle suoritukselle , jossa suoritin ennakoi haaran ratkaisun ja suorittaa yhden haaran käskyjä etukäteen. Jos ennuste on oikea, aikaa säästyy; jos se epäonnistuu, tehty työ hylätään ja liukuhihna tyhjennetään vastaavalla rangaistuksella.
Useimmat nykyaikaiset tehokkaat suorittimet käyttävät myös epäjärjestyksessä (OoO) suoritusta . Sen sijaan, että suoritin noudattaisi tarkasti ohjelmajärjestystä, se järjestää käskyt sisäisesti uudelleen ja suorittaa ensin ne, joiden tiedot ovat valmiita, välttäen siten joutojaksoja, kun taas muut odottavat muistia tai aiempien toimintojen tuloksia.
Jotta kaikki tämä toimisi rikkomatta ohjelman semantiikkaa, käytetään rekistereiden uudelleennimeämistä . Kääntäjä näkee rajoitetun joukon loogisia rekistereitä, mutta mikroarkkitehtuuri muuntaa ne suuremmaksi fyysisten rekisterien pankiksi ja määrittää niille dynaamisesti uusia kohteita väärien riippuvuuksien murtamiseksi ja suuremman rinnakkaisuuden mahdollistamiseksi.
Lopuksi suunnittelussa voidaan keskittyä rinnakkaisuuden lisäämiseen ydin- ja säietasolla . Tämä sisältää kaiken yksiytimisistä suorittimista kymmenien tai satojen ytimien siruihin (moniytiminen), useita prosessoreita sisältäviin järjestelmiin , joissa on useita nopeilla verkkoverkoilla (Infinity Fabric, Intel Mesh, NVLink jne.) yhdistettyjä pistorasioita, sekä samanaikaisen monisäikeisyyden (SMT) tuen, jotta jokainen fyysinen ydin voi käsitellä kahta tai useampaa loogista säiettä.
Yhteensopivuus, ISA ja mikroarkkitehtuuriperheet
Koska mikroarkkitehtuuri on vain yksi ISA:n tietty toteutus , yhdellä ISA:lla voi olla kymmeniä erilaisia mikroarkkitehtuureja vuosien varrella ja eri valmistajilla. Juuri näin tapahtuu x86-64/AMD64:n tai ARM:n kanssa.
Tarkasteltaessa pelkästään AMD:tä AMD64 ISA:n sisällä, löydämme niin erilaisia perheitä kuin K8/Hammer, K10, Bulldozer ja koko Zen-sarja (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Ne kaikki suorittavat saman peruskäskykannan, mutta niiden sisäinen organisaatio, välimuistit, putket ja rinnakkaissuoritustavat ovat täysin erilaisia.
Kun vaihdamme ISA-levyjä, yhteensopivuuden paraneminen on ehdoton. ARM A64 -pohjainen prosessori (kuten Apple Silicon) ei voi suorittaa x86-64-järjestelmille käännettyjä binääritiedostoja ja päinvastoin, ellei käytetä käännös- tai emulointikerrosta, kuten Rosetta 2:ta, QEMU:ta tai vastaavaa, vastaavine suorituskykykustannuksineen.
Vaikka prosessorit jakaisivat saman ISA:n, ei ole takeita siitä, että ne kaikki tukevat samaa käskykantaa tai laajennuksia. Vanhemmasta sirusta saattaa puuttua AVX2 tai AVX-512, tai ARM SoC saattaa toteuttaa vain osan valinnaisista laajennuksista. Siksi binääritiedosto, joka käyttää paljon AVX-512:ta, ei välttämättä käynnisty suorittimella, joka tarjoaa vain SSE4:ää.
Ohjelmistoa käännettäessä on yleistä käytäntöä luoda yleisiä binääritiedostoja tietylle ISA-arkkitehtuuriperheelle (esimerkiksi x86-64, jossa on vähintään SSE2) hyödyntämättä täysin mitään tiettyä mikroarkkitehtuuria, jotta suoritettava tiedosto toimii mahdollisimman monella suorittimella. Jos kuitenkin käännät ohjelmiston käyttämällä tietyn mikroarkkitehtuurin virityslippuja (-march=znver3, -mtune=skylake jne.), voit parantaa suorituskykyä merkittävästi kyseisellä perheellä, mutta samalla menettää yhteensopivuuden muiden kanssa.
ISA-lisenssit ja suunnittelun immateriaalioikeudet
Ohjelmakoodia ei suojaa ainoastaan lisenssit: myös ISA:t ja mikroarkkitehtuurit ovat immateriaalioikeuksia. Kukaan ei voi laillisesti kloonata x86- tai AMD64-ISA:ta ilman lisenssiä, aivan kuten ei voida kopioida ilman lupaa patentoitua suorittimen suunnittelua.
ISA-verkkojen alueella on kolme pääasiallista lähestymistapaa. Toisaalta on olemassa suljetut ISA-verkot , joissa omistaja kontrolloi tiukasti sitä, kuka voi toteuttaa yhteensopivia ytimiä. Klassinen esimerkki on IA-32 (x86-32), jonka on aiemmin omistanut Intel, joka myönsi lisenssejä AMD:lle, VIA:lle ja muille, ei ilman oikeustaisteluja.
Samankaltainen tilanne on AMD64/x86-64:n kanssa , jonka AMD alun perin suunnitteli ja myöhemmin lisensoi Intelille (joka nimesi sen EM64T:ksi) ristiinlisenssisopimusten kautta. Myös muut toimijat, kuten Hygon Kiinassa, ovat hankkineet lisenssejä tiettyihin versioihin (esimerkiksi Zen 1 Kiinan markkinoille).
Sitten meillä on joustavalla lisensoinnilla varustettuja ISA-levyjä , joissa omistaja tarjoaa sekä ISA-lisenssejä että integroitavia IP-ytimiä. ARM, SPARC tai OpenPOWER sopivat tähän tarkoitukseen: voit maksaa Cortex A/M/R:n tai Neoversen käytöstä sellaisenaan tai lisenssistä, jonka avulla voit suunnitella omia mikroarkkitehtuureja ISA:n päälle, kuten Apple tekee M1/M2/M3:llaan tai Qualcomm Kryollaan.
Lopuksi on olemassa avoimen lähdekoodin ISA-ympäristöjä , joissa kuka tahansa voi luoda yhteensopivia mikroarkkitehtuureja maksamatta rojalteja ISA-ympäristöstä (vaikka he voivat patentoida tai sulkea oman toteutuksensa). RISC-V on paras esimerkki: ISA on sallittu BSD-lisenssillä, ja vaihtoehtoja on täysin avoimista Verilog- tai Chisel-ytimistä suljettuihin kaupallisiin malleihin.
ISA:n lisäksi jokainen tietty mikroarkkitehtuuri (Zen 4 -ydin, Cortex X4, GPU-suunnittelu jne.) on patentoidun tai rekisteröidyn immateriaalioikeuden lohko. Tässä on myös avoimia malleja, jotka on julkaistu HDL:llä pehmeinä ytiminä syntetisoitaviksi FPGA-piireissä tai integroitaviksi räätälöityihin järjestelmäpiireihin.
Syvempi syventyminen nykyaikaisiin mikroarkkitehtuureihin: AMD Zen -kotelo
Jotta näkisi, miten kaikki tämä heijastuu todelliseen suorituskykyyn, ei ole mitään parempaa kuin tarkastella tiettyä tuoteperhettä. AMD on mullistanut liiketoimintansa dramaattisesti Zenin ja sen peräkkäisten versioiden ansiosta siirtyen vaikeasta Bulldozer-aikakaudesta ja vanhoista FX-prosessoreista kilpailevaan (ja joskus jopa ohittavaan) Inteliin pöytätietokoneiden, palvelimien ja kannettavien markkinoilla.
AMD Fusion -strategian epäonnistumisen jälkeen yritys teki uudelleenjärjestelyn ja valitsi suorituskykyisen suunnittelun, jota johti muun muassa Jim Keller. Zen-suunnitelman tavoitteena oli lisätä merkittävästi IPC:tä (käskyjä sykliä kohden) Bulldozeriin verrattuna, parantaa suorituskykyä wattia kohden ja palauttaa jalansijaa yhden ytimen suorituskyvyssä, jossa Intel oli pitänyt johtoasemaa vuosia.
Yksi keskeisistä muutoksista oli käyttöliittymän , ohjeiden noutamisesta ja valmistelusta vastaavan osan, vahvistaminen. Zen esitteli mikro-operaatiovälimuistin , joka tallentaa jo dekoodatut mikro-operaatiot, samalla tavalla kuin jotkut Intelin mikroarkkitehtuurit, kuten Conroe, tekivät. Bulldozerista tämä puuttui, ja se luotti enemmän klassiseen käskyvälimuistihierarkiaan, mikä vaikutti negatiivisesti sen läpimenoon.
Zenin dekooderi pystyy kääntämään jopa neljä CISC x86-64 -käskyä sykliä kohden RISC-tyyppisiksi mikro-operaatioiksi. Nämä mikro-operaatiot sijoitetaan sitten jonoon, jota mikro-operaatiopuskuri syöttää. Puskuri puolestaan voi lähettää jopa kuusi mikro-operaatiota sykliä kohden taustajärjestelmän ajoittajille. Tästä alkaa epäjärjestyksessä oleva suoritus.
AMD erotti selkeästi kokonaisluku- ja liukulukupolut . Kokonaislukupuolella ALUt, AGUt ja lataus-/tallennuslogiikka syötetään mikro-operaatiojonosta. Tämä logiikka pystyy suorittamaan kaksi 16-tavuista latausta ja yhden 16-tavuisen tallennuksen sykliä kohden 32 kt:n, 8-tietyltä L1D-piiriltä, ja siinä on takaisinkirjoituskäytäntö.
Liukuluku- ja vektoripuoli syöttävät tietoja FMAC- ja AVX-yksiköille. Kahden kertolasku- ja kahden yhteenlaskuportin ansiosta Zen voi suorittaa samanaikaisesti kaksi 128-bittistä FMA-operaatiota tai yhden 256-bittisen AVX-operaation kellojaksoa kohden. Tämä käskytason rinnakkaisuus on yksi sen vahvan suorituskyvyn avaimista laskennallisesti intensiivisissä työkuormissa.
Välimuistihierarkia, TLB ja muistin organisointi Zenissä
Zenin muistihierarkia on järjestetty kolmeen välimuistitasoon: erillinen L1 käskyille ja datalle, yksityinen L2 ydintä kohden ja jaettu L3 . Vaikka se perii aiempien mikroarkkitehtuurien perusrakenteen, kokoja, assosiatiivisuutta ja käytäntöjä on hienosäädetty.
L1I (käskyvälimuisti) tarjoaa 64 kt ydintä kohden ja neljä assosiatiivista polkua, mikä kaksinkertaistaa polkujen määrän moduulia kohden Bulldozeriin verrattuna ja vähentää konflikteja. L1D ( datavälimuisti) on kasvatettu 32 kt:iin, kahdeksaan polkuun ja takaisinkirjoituskäytäntöön verrattuna Bulldozerin 16 kt:iin, neljään polkuun ja läpikirjoituskäytäntöön, mikä parantaa merkittävästi sekä osumaprosenttia että kirjoitustehokkuutta.
L2 - välimuisti on 512 kt ydintä kohden ja 8-tieinen, kun edellisen sukupolven moduulikohtainen 16-tieinen 2 Mt:n välimuisti. L3 -välimuisti puolestaan tarjoaa useita megatavuja ydintä kohden 16-tietyllä assosiatiivisuudella, toimien viimeisenä jaettuna tasona ennen DRAM-muistiin siirtymistä.
Samanaikaisesti Zen erottelee TLB:t ITLB:iksi (käskyjä varten) ja DTLB:iksi (dataa varten) , joissa molemmissa on useita tasoja ja satoja merkintöjä, ja kaikki on pariteettisuojattu. Tämä vähentää merkittävästi virtuaalisesta fyysiseen osoitteenmuunnoksen latenssia, josta tulee yhä kriittisempi muistin koon kasvaessa.
Kun puhumme välimuistista 2-, 4- tai 8-tieisenä , kuvailemme sen assosiatiivisuutta, joka liittyy läheisesti muistin lomitukseen. Enemmän assosiatiivisuutta tarkoittaa useampia erilaisia tapoja tallentaa muistilohko välimuistiin, mikä vähentää konflikteja, mutta hieman monimutkaisemman logiikan ja latenssin pienen kasvun hinnalla.
On myös tärkeää ymmärtää ero write-throughin ja write-backin välillä . Write-throughissa jokainen kirjoitus päivittää sekä välimuistin että päämuistin samanaikaisesti, mikä yksinkertaistaa yhdenmukaisuutta mutta lisää liikennettä. Write-backissa vain välimuistiin kirjoitetaan, ja rivi merkitään likaisella bitillä; DRAM päivitetään vasta, kun kyseinen rivi poistetaan käytöstä, mikä säästää kaistanleveyttä ja parantaa suorituskykyä hieman monimutkaisemman logiikan kustannuksella.
Zen ja Zen+: harppaus kuluttajahintaindeksissä ja tehokkuudessa
Zen edusti AMD:lle erittäin merkittävää IPC-harppausta Bulldozeriin verrattuna paremman käyttöliittymän, paremman haarautumisen ennustajan, useampien suoritusyksiköiden, CMT:n sijaan käytettävän SMT:n (jokainen täysi ydin käsittelee kahta säiettä sen sijaan, että osa FPU:sta jaettaisiin kahden loogisen ytimen kesken) ja paljon järkevämmän välimuistihierarkian yhdistelmän ansiosta.
Suunnittelun lisäksi AMD hyötyi kehittyneemmistä valmistusprosesseista FinFETin ja pienempien solmujen avulla , jotka mahdollistivat suuremman transistoritiheyden, pienemmän virrankulutuksen samalla suorituskyvyllä ja korkeammat taajuudet säilyttäen samalla kohtuulliset TDP:t ( jännite-taajuuskäyrä ). Tämä suorituskyvyn ja watin välinen tasapaino oli ratkaisevan tärkeä kannettavien tietokoneiden ja palvelimien kilpailukyvyn palauttamiseksi.
Siirtyminen Bulldozerista Zeniin toi mukanaan myös pidemmät poistumisjonot, suuremmat käskyjen ajoittajat, suuremman sisäisen kaistanleveyden, haarautumisen ennustamisen jopa yksinkertaisiin neuroverkkoihin perustuvilla tekniikoilla sekä SMT:n, joka pystyy paremmin puristamaan käytettävissä olevia suoritusyksiköitä.
Tässä yhteydessä esiin nousee Zen+ , jonka voisimme nähdä Intelin vanhan Tik-Tock-strategian "tikkinä": sama perusrakenne kuin Zenissä, mutta valmistettu hienostuneemmalla solmulla, jossa on parannuksia taajuudessa, pieniä viiveen lyhennyksiä ja sisäisiä ajoituksen säätöjä. Se ei ole arkkitehtoninen vallankumous, vaan pikemminkin hienosäätö, joka tarkoittaa muutamia lisäsuorituskykypisteitä.
Zen 2: siruprosessori, täysi AVX2 ja syvällinen hienosäätö
Zen 2:n myötä AMD ei enää vain hio prosessia: se tekee merkittäviä mikroarkkitehtuurimuutoksia ja lanseeraa massiivisesti sirustrategiansa . Yhden suuren monoliittisen sirun sijaan se jakaa suunnittelun useisiin pienempiin 7 nm:n laskentasiruihin (CCD) ja erilliseen 12 nm:n I/O-siruun, joka käsittelee muistia, PCIe:tä ja liitäntöjä.
Tämä sirutekniikka parantaa kiekkokohtaista saantoa (pienten, virheettömien sirujen valmistus on helpompaa), alentaa kustannuksia ja helpottaa ytimien määrän skaalaamista: lisäämällä vain lisää CCD-elementtejä pääset 16, 32 tai useampaan ytimeen EPYC:ssä ja Threadripperissä. Kompromissina on hieman monimutkaisempi sisäinen kommunikaatio, joka on riippuvainen Infinity Fabric -yhteenliitännästä, jota AMD on hionut sukupolvi toisensa jälkeen.
Raa'an suorituskyvyn osalta AMD puhuu noin +15 %:n IPC:stä Zen 2:lle verrattuna Zen+:aan samalla taajuudella ja kokonaissuorituskyvyn parantumisesta wattia kohden, joka voi olla noin +75 % ensimmäiseen Zeniin verrattuna, kun suunnittelu- ja prosessiparannukset yhdistetään.
Vektorisuunnittelussa Zen 2 ottaa puuttuvan palasen: se tarjoaa täyden 256-bittisen AVX2-tuen yhdessä mikro-optiossa jakamatta ohjeita kahteen 128-bittiseen operaatioon, kuten Zenissä/Zen+:ssa tehtiin. Tämä tarkoittaa, että vektorisuoritusyksiköt ovat nyt aidosti 256-bittisiä ja pystyvät käsittelemään AVX2-työkuormia täydellä nopeudella paljon pienemmällä taajuusrangaistuksella kuin muissa malleissa.
Myös mikro-ops-välimuistia vahvistetaan lisäämällä se 4 kt:een merkintää (kaksinkertaistaa sen koon) hyödyntämällä osaa L1I-välimuistin puolittamisesta vapautuneesta tilasta, mutta kaksinkertaistamalla sen assosiatiivisuuden 4:stä 8:aan. Sisäiset simulaatiot johtivat AMD:n päätelmään, että useimmissa todellisissa työkuormissa suurempi UOP-välimuisti on edullisempi kuin suurempi L1I-välimuisti.
Ydinlohkon L3-välimuistin kapasiteetti on kaksinkertaistunut , mikä auttaa vähentämään viimeisen tason vikoja, vaikkakin käyttöviive kasvaa noin 35 syklistä 40 sykliin. Tämän vaikutuksen lieventämiseksi Zen 2 parantaa lataus- ja tallennuskaistanleveyksiä sekä tarkentaa esilatauskäytäntöä.
Toinen tärkeä näkökohta on haarautumisennuste. Zen 2 käyttää TAGE (TAgged GEometric) -ennustetta, jossa on yli 7 000 merkintää ja joka pystyy hyödyntämään vaihtelevan pituisia historioita ja merkittyjä merkintöjä. Tämä vähentää eri haarojen välistä aliasointia ja AMD:n mukaan vähentää virheellisten ennusteiden määrää noin 30 % edelliseen järjestelmään verrattuna, mikä tarkoittaa suoraan vähemmän liukuhihnan huuhteluita ja korkeampaa IPC:tä.
Zen 2 -taustajärjestelmä: AGU:t, puskurit ja säädettävät latenssit
Koko taustajärjestelmässä Zen 2 jatkaa jopa kuuden mikro-operaation lähettämistä sykliä kohden uudelleenjärjestelypuskurista, jota on laajennettu noin 224 merkintään (verrattuna Zenin 192 merkintään). Aikataulutusyksiköt on jaettu neljään jonoon ALU-yksiköille, joissa kussakin on 16 merkintää, ja yhteen jonoon AGU-yksiköille, joissa on 28 merkintää.
Osoitteiden luontiyksiköiden (AGU) määrä kasvaa kahdesta kolmeen, vaikka ne eivät kaikki ole identtisiä: kaksi niistä pystyy käsittelemään sekä latauksia että kirjoituksia, kun taas kolmas on erikoistunut tallennustoimintoihin. Tämä jakelu on suunniteltu tyypillisille ohjelmistoprofiileille, joissa lataukset ovat yleensä useammin esiintyviä ja kriittisempiä kuin tallennustoiminnot.
Liukulukutasossa taustajärjestelmä voi vastaanottaa neljä mikro-operaatiota sykliä kohden 256-bittisille FMA-vektoriyksiköilleen, joita tukee 160-merkinnäinen fyysinen rekisteritiedosto. 256-bittisiä lataus-/tallennuspolkuja on parannettu, jotta nämä yksiköt voivat syöttää tietoa tasaisesti raskaiden vektorikuormien alla.
Zen 2 säätää myös tiettyjen operaatioiden latensseja : esimerkiksi liukulukujen kertolasku lyhentää latenssiaan neljästä kolmeen sykliin, mikä auttaa erittäin tiukoissa numeerisissa laskentasilmukoissa. Ja yleisesti ottaen putkessa on joukko pieniä optimointeja, jotka lisäävät synteettisissä vertailuissa ja reaalimaailman sovelluksissa nähtävää ylimääräistä IPC:tä.
Ydinryhmien sisäisen hierarkian osalta AMD käyttää CCX (Core Complex) -konseptia : neljän ytimen lohko, jotka jakavat saman L3-välimuistin (16 Mt Zen 2:ssa). Tämä ylimääräinen koko tarkoittaa hieman suurempaa latenssia, mutta vastineeksi se vähentää vikaantumisprosenttia, erityisesti sovelluksissa, joissa on suuria työryhmiä.
Vertailun vuoksi voimme palauttaa mieleen likimääräiset sisäiset latenssiluvut: noin 4 sykliä L1:lle , noin 12 L2:lle ja noin 40 sykliä L3:lle. Tärkeintä on pitää mahdollisimman paljon dataa L1/L2-kerroksissa ja vähentää liikennettä L3:lle ja DRAM- muistille , minkä saavuttamiseksi mikroarkkitehtuuri ja kääntäjät työskentelevät yhdessä.
Infinity Fabric: siruissa käytetty liima ja sen vaikutus suorituskykyyn
Yksi komponentti, jota ei aina yhdistetä mikroarkkitehtuuriin, mutta joka on elintärkeä Zen 2:ssa ja uudemmissa, on Infinity Fabric . Tämä patentoitu väylä toimii tietoliikenneväylänä CCX-piirien, CCD-piirien, I/O-piirin, muistin ja yleisesti kaikkien SoC-lohkojen välillä.
Infinity Fabric on HyperTransportin , AMD:n vuosia sitten kehittämän nopean väylän, kehitysaskel. HyperTransportia käyttivät myös kolmannet osapuolet, kuten NVIDIA, Cisco, Sun ja muut konsortion jäsenet. IF perii skaalautuvien point-to-point-linkkien filosofian, mutta on mukautettu nykyaikaisten järjestelmäpiirien ja CPU-GPU-yhteenliitäntöjen tarpeisiin.
AMD esittelee Zen 2:ssa IF2:n , joka tukee PCIe 4.0:aa ja 512-bittistä sisäistä väylää CCX-piirien välillä, mikä on kaksinkertainen ensimmäiseen versioon verrattuna. Tämä tarkoittaa tehokkaampaa kaistanleveyttä ja tehokkuuden parannusta, jonka AMD arvioi noin 27 %:ksi IF1:een verrattuna, mikä auttaa lieventämään sirujen välisen vaihdon suorituskykyhaittoja.
Lisäksi Infinity Fabric -kello on osittain irrotettu DRAM-kellosta , minkä ansiosta päämuisti voi skaalautua korkeammille taajuuksille tietyissä tilanteissa pakottamatta välimuistia pysymään tahdissa. Tämä tarjoaa enemmän hienosäätövaraa harrastajille ja järjestelmäsuunnittelijoille.
Palvelinprosessoreissa, kuten EPYC:ssä , joissa on neljä tai useampia laskentasiruja, Infinity Fabric mahdollistaa kaikkien yksiköiden yhdistämisen lähes täydellisillä topologioilla (180 asteen rotaatiot, suorat linkit jne.), jolloin saavutetaan sirulta sirulle -kaistanleveydet, jotka voivat helposti ylittää 150 Gt/s kaksisuuntaisesti käytetyn DDR-muistin nopeudesta riippuen.
Vankan mikroarkkitehtuurin yhdistelmä jokaisessa ytimessä , skaalautuva sirujen käyttö ja riittävän nopeat yhteydet mahdollistavat AMD:lle 32, 64 tai useamman ytimen suorittimien kokoamisen erinomaisella suorituskyvyllä erittäin rinnakkaisissa työkuormissa samalla, kun se säilyttää kilpailukykyisen IPC:n säiettä kohden.
Viime kädessä, kun vertailet prosessoreita pelialan vertailuissa, 3D-renderöinnissä, massiivisessa käännöksessä tai tieteellisessä simulaatiossa, GHz- ja ydinmääräluvut kertovat vain osan totuudesta. Todellinen ero on siinä, miten mikroarkkitehtuuri orkestroi sisäistä suoritusta , miten se hyödyntää tai tuhlaa kutakin kellojaksoa ja mitä kompromisseja valmistaja on tehnyt latenssin, kaistanleveyden, virrankulutuksen ja monimutkaisuuden välillä.

Indeksi
- 1 ISA, makroarkkitehtuuri ja mikroarkkitehtuuri: käsitteiden järjestys
- 2 Mikä tarkalleen ottaen on suorittimen mikroarkkitehtuuri?
- 3 Yhteensopivuus, ISA ja mikroarkkitehtuuriperheet
- 4 ISA-lisenssit ja suunnittelun immateriaalioikeudet
- 5 Syvempi syventyminen nykyaikaisiin mikroarkkitehtuureihin: AMD Zen -kotelo
- 6 Välimuistihierarkia, TLB ja muistin organisointi Zenissä
- 7 Zen ja Zen+: harppaus kuluttajahintaindeksissä ja tehokkuudessa
- 8 Zen 2: siruprosessori, täysi AVX2 ja syvällinen hienosäätö
- 9 Zen 2 -taustajärjestelmä: AGU:t, puskurit ja säädettävät latenssit
- 10 Infinity Fabric: siruissa käytetty liima ja sen vaikutus suorituskykyyn