- La microarchitecture définit la manière dont un processeur implémente une ISA et détermine son IPC, son parallélisme interne et son efficacité réelle, au-delà de la fréquence ou de la taille du cache.
- Les architectures comme AMD Zen et Zen 2 combinent des caches optimisés, une exécution hors séquence, le SMT et de grandes unités vectorielles pour améliorer les performances par cycle et par watt.
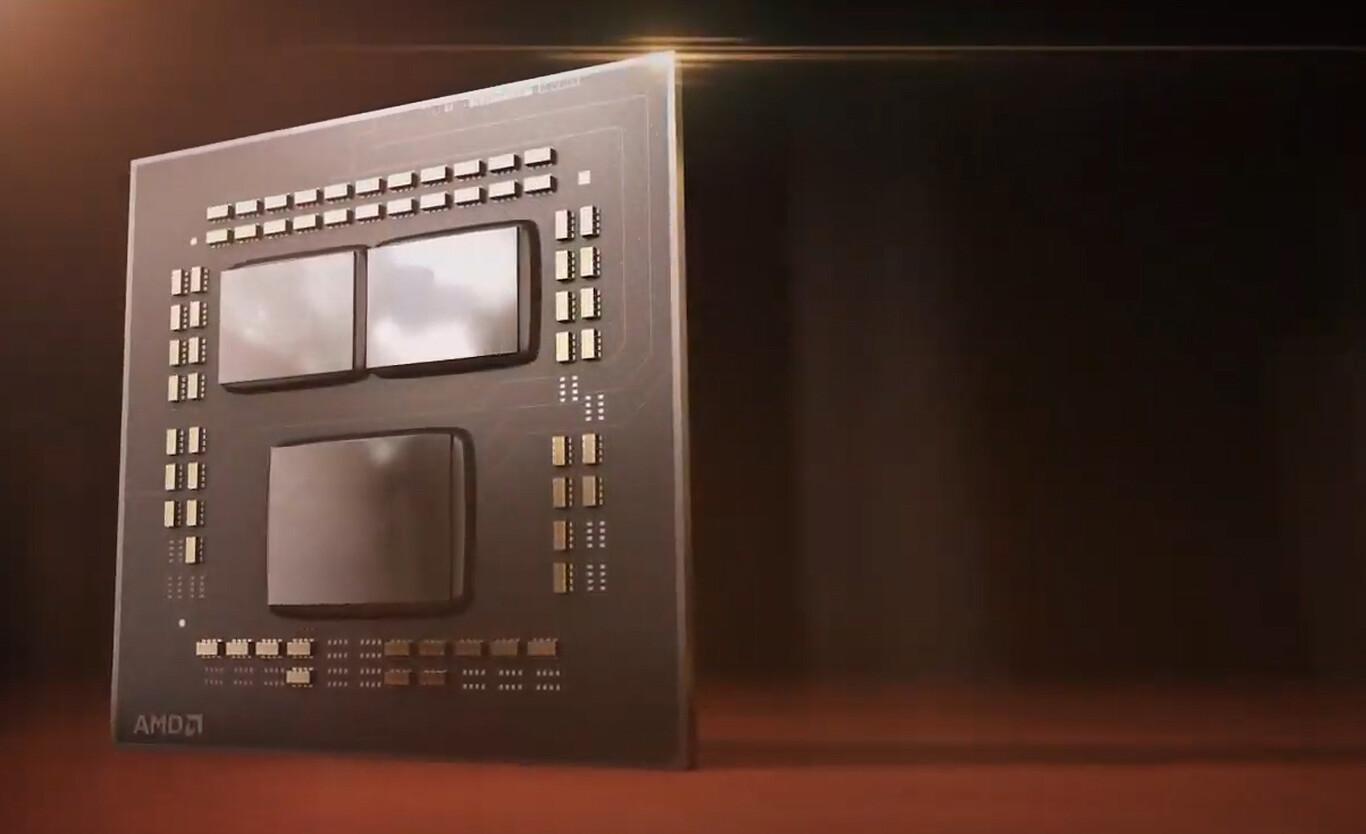
- La stratégie basée sur les chiplets et Infinity Fabric permet d'augmenter le nombre de cœurs dans les processeurs EPYC et Ryzen tout en maintenant des coûts maîtrisés et des performances très compétitives.
La microarchitecture d'un processeur passe souvent au second plan par rapport à des chiffres plus attrayants comme la fréquence en GHz ou la mémoire cache en Mo, mais c'est précisément là, dans la conception interne du processeur, que se décident la plupart de ses performances réelles, son efficacité, et même le type de logiciel qui peut en tirer le meilleur parti.
Lorsque vous lisez des spécifications techniques mentionnant cœurs, threads, cache L3 ou AVX2 , vous constatez concrètement les conséquences d'une microarchitecture particulière. Comprendre l'organisation interne de ces composants, ce qui distingue un Zen 3 d'un Zen 2, ou un processeur hybride Intel d'un Ryzen classique, est essentiel pour choisir judicieusement votre prochain processeur et comprendre pourquoi certains excellent dans les jeux, d'autres dans le rendu et d'autres encore dans les tâches serveur.
ISA, macroarchitecture et microarchitecture : mettre de l’ordre dans les concepts
Avant d'aborder la complexité des pipelines et des prédicteurs, il est utile de distinguer trois niveaux souvent confondus : la macroarchitecture système, l'ISA et la microarchitecture . Chacune décrit une couche différente de l'ordinateur.
D'une part, il y a la macroarchitecture, ou conception globale du système , qui englobe tout ce qui est visible sur la carte mère : processeur, contrôleurs de mémoire, bus, mémoire principale, puces d'entrée/sortie, contrôleurs de stockage, accélérateurs externes et logique DMA. Il s'agit d'une vue d'ensemble de la manière dont les principaux composants matériels sont connectés et dont les données circulent entre eux.
Au-dessus se trouve l' ISA (Instruction Set Architecture) , qui est le jeu d'instructions que le processeur comprend : les types de données qu'il traite, la taille des mots, le nombre et le type de registres, les modes d'adressage, les formats d'instructions, etc. Lorsque vous programmez en assembleur en utilisant des mnémoniques comme ADD, SUB, MUL , ou en invoquant des extensions comme SSE, AVX ou NEON, vous communiquez directement avec l'ISA.
Enfin, nous avons le microcode, ou μISA , qui définit les micro-opérations internes utilisées par certaines architectures complexes (comme x86) pour implémenter leurs instructions CISC. Ce microcode peut être mis à jour par le biais du firmware afin de corriger des bogues ou d'ajouter la prise en charge de nouvelles instructions.
Qu’est-ce que la microarchitecture d’un processeur, exactement ?
La microarchitecture du processeur est en quelque sorte le plan interne qui détermine comment les instructions ISA sont exécutées et comment les données circulent au sein de la puce. Deux processeurs peuvent partager la même ISA (par exemple, AMD64 chez Intel et AMD) et pourtant présenter des comportements et des performances radicalement différents en raison – ou peut-être grâce à – leur microarchitecture.
Cette conception comprend des éléments tels que le type d' unité de contrôle , l'utilisation d'un microcode programmable ou d'une logique câblée ; la hiérarchie de la mémoire ; la profondeur du pipeline ; le nombre d'unités fonctionnelles fonctionnant en parallèle ; et la capacité du processeur à exécuter des instructions dans le désordre et de manière spéculative.
De plus, le concepteur doit choisir la profondeur du pipeline : des processeurs simples sans pipeline, où chaque instruction est traitée du début à la fin avant de passer à la suivante, aux conceptions modernes avec de nombreuses étapes (extraction, décodage, renommage, distribution, exécution, écriture, retrait…) qui permettent à des dizaines d’instructions d’être en cours d’exécution simultanément.
À cela s'ajoute le nombre et le type d' unités d'exécution : unités arithmétiques et logiques (UAL) pour les entiers, unités de multiplication, diviseurs, unités de calcul en virgule flottante (FPU) pour les nombres scalaires et vectoriels à virgule flottante, unités de génération d'adresses (UGA) pour le calcul des adresses mémoire, unités de saut, etc. S'il existe plusieurs unités du même type, on parle de processeurs superscalaires, capables d'exécuter plusieurs instructions par cycle.
C’est le principe de base de techniques avancées telles que l’exécution spéculative , où le processeur anticipe la résolution d’une branche et exécute par avance les instructions de l’une des branches. Si la prédiction est correcte, on gagne du temps ; sinon, le travail effectué est perdu et le pipeline est vidé, avec la pénalité correspondante.
La plupart des processeurs modernes hautes performances utilisent également l'exécution hors séquence (OoO) . Au lieu de respecter strictement l'ordre du programme, le processeur réorganise les instructions en interne et exécute d'abord celles dont les données sont disponibles, évitant ainsi les cycles d'inactivité pendant lesquels d'autres instructions attendent la mémoire ou le résultat des opérations précédentes.
Pour que tout cela fonctionne sans enfreindre la sémantique du programme, on utilise le renommage des registres . Le compilateur voit un ensemble limité de registres logiques, mais la microarchitecture les traduit en un ensemble plus vaste de registres physiques, en assignant dynamiquement de nouvelles destinations afin de rompre les fausses dépendances et de permettre un plus grand parallélisme.
Enfin, la conception peut se concentrer sur l'ajout de parallélisme au niveau du cœur et des threads . Cela inclut tout, des processeurs monocœurs aux puces comportant des dizaines ou des centaines de cœurs (multicœurs), en passant par les systèmes multiprocesseurs avec plusieurs sockets interconnectés par des réseaux maillés à haut débit (Infinity Fabric, Intel Mesh, NVLink, etc.) et la prise en charge du multithreading simultané (SMT) afin que chaque cœur physique puisse gérer deux threads logiques ou plus.
Familles de compatibilité, d'ISA et de microarchitecture
Puisqu'une microarchitecture n'est qu'une implémentation spécifique d'une ISA , une même ISA peut avoir des dizaines de microarchitectures différentes au fil des années et chez différents fabricants. C'est précisément le cas pour x86-64/AMD64 ou ARM.
Si l'on considère uniquement les architectures AMD au sein de l'ISA AMD64, on trouve des familles aussi diverses que K8/Hammer, K10, Bulldozer et toute la gamme Zen (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Elles exécutent toutes le même jeu d'instructions de base, mais leur organisation interne, leurs caches, leurs pipelines et leurs approches d'exécution parallèle sont totalement différents.
Lorsqu'on change d'architecture ISA, le gain en compatibilité est total. Un processeur ARM A64 (comme Apple Silicon) ne peut pas exécuter de fichiers binaires compilés pour x86-64, et inversement, à moins d'utiliser une couche de traduction ou d'émulation telle que Rosetta 2, QEMU ou équivalente, ce qui a un impact sur les performances.
Même parmi les processeurs partageant la même architecture ISA, rien ne garantit qu'ils prennent tous en charge le même jeu d'instructions ou les mêmes extensions. Une puce plus ancienne peut être dépourvue d'AVX2 ou d'AVX-512, ou un SoC ARM peut n'implémenter qu'un sous-ensemble d'extensions optionnelles. Par conséquent, un programme utilisant intensivement AVX-512 peut ne pas démarrer sur un processeur ne proposant que SSE4.
Lors de la compilation de logiciels, il est courant de générer des binaires génériques pour une architecture ISA spécifique (par exemple, x86-64 avec au moins SSE2) sans exploiter pleinement une microarchitecture particulière, afin que l'exécutable fonctionne sur un maximum de processeurs. Cependant, en compilant avec des options d'optimisation pour une microarchitecture spécifique (-march=znver3, -mtune=skylake, etc.), il est possible d'améliorer significativement les performances sur cette famille de processeurs, au prix d'une perte de compatibilité avec les autres.
Licences ISA et propriété intellectuelle de la conception
Non seulement le code source est protégé par des licences, mais les ISA et les microarchitectures constituent également une propriété intellectuelle. Nul ne peut légalement cloner une ISA x86 ou AMD64 sans licence, de même qu'une conception de processeur propriétaire ne peut être copiée sans autorisation.
Dans le domaine des architectures ISA, on distingue trois approches principales. D'une part, les ISA fermées , où le propriétaire contrôle strictement qui peut implémenter des cœurs compatibles. L'exemple classique est l'IA-32 (x86-32), historiquement propriété d'Intel, qui a accordé des licences à AMD, VIA et d'autres, non sans batailles juridiques.
Une situation similaire existe avec l'architecture AMD64/x86-64 , initialement conçue par AMD puis concédée sous licence à Intel (qui la nommait EM64T) par le biais d'accords de licences croisées. D'autres acteurs, comme Hygon en Chine, ont également obtenu des licences pour des versions spécifiques (par exemple, Zen 1 pour le marché chinois).
Viennent ensuite les ISA à licences flexibles , où le propriétaire propose à la fois des licences ISA et des cœurs IP prêts à l'emploi. ARM, SPARC ou OpenPOWER correspondent à cette catégorie : vous pouvez acheter une licence pour utiliser Cortex A/M/R ou Neoverse tels quels, ou une licence vous permettant de concevoir vos propres microarchitectures par-dessus l'ISA, comme le fait Apple avec ses M1/M2/M3 ou Qualcomm avec ses Kryo.
Enfin, il existe des ISA open source , permettant à quiconque de créer des microarchitectures compatibles sans payer de redevances (bien qu'il soit possible de breveter ou de fermer sa propre implémentation). RISC-V en est le meilleur exemple : l'ISA est distribuée sous une licence BSD permissive et offre des options allant de noyaux entièrement ouverts en Verilog ou Chisel à des architectures commerciales propriétaires.
Outre l'ISA, chaque microarchitecture spécifique (cœur Zen 4, Cortex X4, GPU, etc.) constitue un ensemble de propriété intellectuelle brevetée ou enregistrée. On trouve également des conceptions ouvertes, publiées sous forme de cœurs logiciels HDL pour la synthèse dans les FPGA ou l'intégration dans des SoC personnalisés.
Approfondir les microarchitectures modernes : le cas AMD Zen
Pour comprendre comment tout cela se traduit concrètement en performances, rien ne vaut l'analyse d'une gamme de produits spécifique. Grâce à Zen et à ses itérations successives , AMD a radicalement transformé son activité, passant de la difficile ère Bulldozer et des anciens processeurs FX à une concurrence directe (voire un dépassement) d'Intel sur les marchés des ordinateurs de bureau, des serveurs et des ordinateurs portables.
Après l'échec de la stratégie AMD Fusion , l'entreprise s'est restructurée et a opté pour une architecture haute performance, pilotée notamment par Jim Keller. Le plan Zen visait à augmenter considérablement l'IPC (instructions par cycle) par rapport à Bulldozer, à améliorer les performances par watt et à regagner du terrain sur les performances monocœur, domaine où Intel dominait depuis des années.
L'un des changements majeurs a consisté à renforcer le front-end , la partie chargée de récupérer et de préparer les instructions. Zen a introduit un cache de micro-opérations stockant les micro-opérations déjà décodées, à l'instar de certaines microarchitectures Intel comme Conroe. Bulldozer, dépourvu de ce cache, s'appuyait davantage sur la hiérarchie classique du cache d'instructions, ce qui pénalisait son débit.
Le décodeur Zen peut traduire jusqu'à quatre instructions CISC x86-64 par cycle en micro-opérations de type RISC. Ces micro-opérations sont ensuite placées dans une file d'attente alimentée par le tampon de micro-opérations, qui peut à son tour distribuer jusqu'à six micro-opérations par cycle aux ordonnanceurs de traitement. C'est à ce stade que commence l'exécution hors séquence.
AMD a clairement séparé les chemins de traitement des entiers et des nombres à virgule flottante . Côté entiers, les ALU, les AGU et la logique de chargement/stockage sont alimentées par la file d'attente des micro-opérations. Cette logique est capable d'effectuer deux chargements de 16 octets et un stockage de 16 octets par cycle à partir d'un L1D de 32 Ko à 8 voies, avec une politique d'écriture différée.
Les fonctions de calcul en virgule flottante et vectorielle alimentent les unités FMAC et AVX. Grâce à ses deux ports de multiplication et ses deux ports d'addition, Zen peut exécuter simultanément deux opérations FMA 128 bits ou une opération AVX 256 bits par cycle d'horloge. Ce parallélisme au niveau des instructions est l'un des facteurs clés de ses excellentes performances sous des charges de travail intensives en calcul.
Hiérarchie du cache, TLB et organisation de la mémoire dans Zen
La hiérarchie mémoire de Zen est organisée en trois niveaux de cache : un cache L1 séparé pour les instructions et les données, un cache L2 privé par cœur et un cache L3 partagé . Bien qu’elle hérite de la structure de base des microarchitectures précédentes, les tailles, l’associativité et les politiques ont été optimisées.
Le cache d'instructions L1I offre 64 Ko par cœur, avec 4 chemins associatifs, doublant ainsi le nombre de chemins par module par rapport à Bulldozer et réduisant les conflits. Le cache de données L1D passe à 32 Ko, avec 8 chemins et une politique d'écriture différée, contre 16 Ko, 4 chemins et une politique d'écriture immédiate pour Bulldozer, améliorant significativement le taux d'accès et l'efficacité d'écriture.
Le cache L2 est implémenté avec 512 Ko par cœur et une associativité de 8 voies, au lieu des 2 Mo et 16 voies partagées par module de la génération précédente. Le cache L3 , quant à lui, offre plusieurs Mo par ensemble de cœurs avec une associativité de 16 voies, constituant le dernier niveau partagé avant la DRAM.
Parallèlement, Zen sépare les TLB en ITLB (pour les instructions) et DTLB (pour les données) , chacun comportant plusieurs niveaux et des centaines d'entrées, tous protégés par parité. Ceci réduit considérablement la latence de traduction d'adresses virtuelles en adresses physiques, un facteur de plus en plus critique à mesure que la taille de la mémoire augmente.
Lorsqu'on parle d'un cache à 2 voies, 4 voies ou 8 voies , on décrit son associativité, étroitement liée à la notion d'entrelacement en mémoire. Une associativité plus élevée signifie davantage de façons différentes de stocker un bloc de mémoire dans ce cache, réduisant ainsi les conflits, mais au prix d'une logique légèrement plus complexe et d'une latence légèrement accrue.
Il est également important de comprendre la différence entre l'écriture immédiate et l'écriture différée . En écriture immédiate, chaque écriture met à jour simultanément le cache et la mémoire principale, ce qui simplifie la cohérence mais augmente le trafic. En écriture différée, seul le cache est mis à jour et la ligne est marquée d'un bit de modification ; la DRAM n'est mise à jour que lorsque cette ligne est supprimée, ce qui permet d'économiser de la bande passante et d'améliorer les performances au prix d'une logique légèrement plus complexe.
Zen et Zen+ : un bond en avant en matière d'IPC et d'efficacité
Zen a représenté un bond en avant très significatif en matière d'IPC pour AMD par rapport à Bulldozer , grâce à la combinaison d'un meilleur front-end, d'un meilleur prédicteur de branchement, de plus d'unités d'exécution, du SMT au lieu du CMT (chaque cœur complet gère deux threads, au lieu de partager une partie de l'unité de calcul en virgule flottante entre deux cœurs logiques) et d'une hiérarchie de cache beaucoup plus judicieuse.
Outre la conception, AMD a bénéficié de procédés de fabrication plus avancés grâce à la technologie FinFET et à des nœuds plus fins , ce qui permet d'accroître la densité des transistors, de réduire la consommation d'énergie à performances égales et d'atteindre des fréquences plus élevées tout en conservant un TDP ( courbe tension-fréquence ) raisonnable. Cet équilibre entre performances et consommation d'énergie était crucial pour regagner en compétitivité sur le marché des ordinateurs portables et des serveurs.
La transition de Bulldozer à Zen a également apporté des files d'attente de retrait plus longues, des planificateurs d'instructions plus grands, une bande passante interne plus importante, une prédiction de branchement avec des techniques basées même sur des réseaux neuronaux simples et un SMT capable de mieux exploiter les unités d'exécution disponibles.
Dans ce contexte, Zen+ fait son apparition , que l'on pourrait comparer à une « étape intermédiaire » dans l'ancienne stratégie Tick-Tock d'Intel : une conception de base identique à celle de Zen, mais gravée avec une finesse de gravure supérieure, des fréquences améliorées, une latence légèrement réduite et des ajustements de synchronisation interne. Il ne s'agit pas d'une révolution architecturale, mais plutôt d'un perfectionnement qui se traduit par un gain de performances significatif.
Zen 2 : chiplets, AVX2 complet et raffinement poussé
Avec Zen 2 , AMD ne se contente plus d'optimiser le processus de fabrication : l'entreprise introduit des changements microarchitecturaux majeurs et déploie massivement sa stratégie de puces . Au lieu d'une seule puce monolithique de grande taille, elle divise la conception en plusieurs puces de calcul (CCD) plus petites, gravées en 7 nm, et une puce d'E/S distincte de 12 nm gérant la mémoire, le PCIe et les interconnexions.
Cette architecture à base de chiplets améliore le rendement par tranche (la fabrication de puces petites et sans défauts est facilitée), réduit les coûts et simplifie l'augmentation du nombre de cœurs : il suffit d'ajouter des CCD pour atteindre 16, 32 cœurs, voire plus, sur les architectures EPYC et Threadripper. En contrepartie, la communication interne est légèrement plus complexe, car elle repose sur l'interconnexion Infinity Fabric, qu'AMD perfectionne génération après génération.
En termes de performances brutes, AMD parle d' un IPC d'environ +15 % pour Zen 2 par rapport à Zen+ à la même fréquence et d'une amélioration globale des performances par watt pouvant atteindre +75 % par rapport au premier Zen lorsque les améliorations de conception et de processus sont combinées.
Côté traitement vectoriel, Zen 2 apporte la pièce manquante : il offre une prise en charge complète d’AVX2 256 bits en une seule micro-opération , sans scinder les instructions en deux opérations 128 bits comme c’était le cas avec Zen/Zen+. Ainsi, les unités d’exécution vectorielle sont désormais véritablement 256 bits et peuvent traiter les charges de travail AVX2 à pleine vitesse avec une perte de fréquence bien moindre que dans d’autres architectures.
Le cache des micro-opérations est également renforcé, passant à 4 000 entrées (soit le double de sa taille actuelle), tirant parti de l'espace libéré par la réduction de moitié du cache L1I tout en doublant son associativité, qui passe de 4 à 8 voies. Des simulations internes ont permis à AMD de conclure que, pour la plupart des charges de travail réelles, un cache de micro-opérations plus important est plus avantageux qu'un cache L1I plus important.
La capacité du cache L3 par bloc de cœur est doublée , ce qui contribue à réduire les défaillances de dernier niveau, même si la latence d'accès augmente d'environ 35 à 40 cycles. Pour atténuer cet effet, Zen 2 améliore les bandes passantes de chargement et de stockage et affine la politique de préchargement.
Un autre aspect important est le prédicteur de branchement. Zen 2 utilise un prédicteur TAGE (TAgged GEometric) avec plus de 7 000 entrées, capable d'exploiter des historiques de longueur variable et des entrées étiquetées. Cela réduit l'aliasing entre les différentes branches et, selon AMD, diminue d'environ 30 % le nombre de prédictions incorrectes par rapport au système précédent, ce qui se traduit directement par moins de vidages de pipeline et un IPC plus élevé.
Côté serveur Zen 2 : AGU, tampons et latences ajustées
Dans l'ensemble du système de traitement, Zen 2 continue de traiter jusqu'à six micro-opérations par cycle à partir du tampon de réordonnancement, dont la capacité est étendue à environ 224 entrées (contre 192 pour Zen). Les unités d'ordonnancement sont divisées en quatre files d'attente de 16 entrées chacune pour les unités arithmétiques et logiques (UAL) et une file d'attente de 28 entrées pour les unités de génération d'opérations analytiques (UGA).
Le nombre d' unités de génération d'adresses (AGU) passe de deux à trois, mais elles ne sont pas toutes identiques : deux d'entre elles gèrent à la fois les chargements et les écritures, tandis que la troisième est spécialisée dans les opérations de stockage. Cette distribution est conçue pour les profils logiciels typiques, où les chargements sont généralement plus fréquents et critiques que les opérations de stockage.
Dans le plan à virgule flottante, le système de traitement peut recevoir quatre micro-opérations par cycle pour ses unités vectorielles FMA 256 bits, gérées par un fichier de registres physiques de 160 entrées. Les chemins de chargement/stockage 256 bits ont été optimisés afin d'alimenter ces unités de manière soutenue, même sous des charges de travail vectorielles importantes.
Zen 2 ajuste également la latence de certaines opérations : par exemple, la multiplication en virgule flottante voit sa latence passer de 4 à 3 cycles, ce qui est utile pour les boucles de calcul numérique très rapides. De manière générale, un ensemble de petites optimisations réparties tout au long du pipeline contribuent à l’augmentation de l’IPC observée dans les benchmarks synthétiques et les applications réelles.
Concernant la hiérarchie interne par groupes de cœurs, AMD utilise le concept de CCX (Core Complex) : un bloc de 4 cœurs partageant le même cache L3 (16 Mo sur Zen 2). Cette taille supplémentaire induit une latence légèrement supérieure, mais réduit en contrepartie le taux de défaillance, notamment pour les applications nécessitant des volumes de données importants.
À titre indicatif, on peut rappeler les valeurs approximatives de latence interne : environ 4 cycles pour L1 , environ 12 pour L2 et environ 40 cycles pour L3. L’essentiel est de conserver autant de données que possible dans L1/L2 et de réduire le trafic vers L3 et la DRAM , ce que la microarchitecture et les compilateurs s’efforcent de réaliser conjointement.
Infinity Fabric : la colle utilisée dans les chiplets et son impact sur les performances
Un composant souvent négligé au sein de la microarchitecture, mais essentiel dans Zen 2 et les générations suivantes, est l'Infinity Fabric . Ce bus propriétaire sert d'« autoroute » de communication entre les CCX, les CCD, la puce d'E/S, la mémoire et, de manière générale, entre tous les blocs du SoC.
Infinity Fabric est une évolution d'HyperTransport , le bus haut débit qu'AMD a développé il y a plusieurs années et qui a également été utilisé par des tiers tels que NVIDIA, Cisco, Sun et d'autres membres du consortium. IF reprend le principe des liaisons point à point évolutives, mais l'adapte aux besoins des SoC modernes et de l'interconnexion CPU-GPU.
Avec Zen 2, AMD introduit l'IF2 , compatible PCIe 4.0 et doté d'un bus interne 512 bits entre les CCX, soit le double de la première version. Il en résulte une bande passante effective accrue et un gain d'efficacité estimé par AMD à environ 27 % par rapport à l'IF1, ce qui contribue à atténuer la perte de performance liée au changement de chiplet.
De plus, l'horloge Infinity Fabric est partiellement découplée de l'horloge DRAM , ce qui permet à la mémoire principale d'atteindre des fréquences plus élevées dans certains scénarios sans nécessairement forcer l'IF à suivre le rythme, offrant ainsi une plus grande marge de réglage aux passionnés et aux concepteurs de systèmes.
Dans les processeurs de serveurs comme EPYC , avec quatre chiplets de calcul ou plus, Infinity Fabric est ce qui permet de connecter toutes les puces entre elles avec des topologies presque complètes (rotations à 180°, liaisons directes, etc.), atteignant des bandes passantes entre puces qui peuvent facilement dépasser 150 Go/s bidirectionnelles en fonction de la vitesse de la DDR utilisée.
La combinaison d'une microarchitecture robuste dans chaque cœur , d'une conception évolutive utilisant des chiplets et d'interconnexions suffisamment rapides permet à AMD d'assembler des processeurs avec 32, 64 cœurs ou plus offrant des performances exceptionnelles dans les charges de travail hautement parallèles, tout en maintenant un IPC compétitif par thread.
En définitive, lorsqu'on compare des processeurs dans des benchmarks de jeux, de rendu 3D, de compilation massive ou de simulation scientifique, la fréquence (en GHz) et le nombre de cœurs ne donnent qu'une vision partielle. Ce qui fait réellement la différence, c'est la manière dont la microarchitecture orchestre l'exécution interne , dont elle optimise l'utilisation de chaque cycle d'horloge et les compromis opérés par le fabricant entre latence, bande passante, consommation d'énergie et complexité.
