- La coerenza della cache garantisce che tutte le copie degli stessi dati nelle diverse cache e nella RAM rimangano coerenti sui sistemi multi-core.
- La gerarchia della cache con un ultimo livello condiviso semplifica il controllo della coerenza e riduce gli accessi diretti alla memoria principale.
- I protocolli di coerenza utilizzano strategie di invalidazione o aggiornamento della copia, supportate da stati e bit di controllo per riga di cache.
- Il compilatore e il sistema operativo possono integrare la coerenza hardware inserendo istruzioni e configurando la memoria per periodi critici.
Osservando lo schema di un qualsiasi processore multi-core moderno, si nota sempre lo stesso schema: più core, ognuno con la propria cache adiacente, e una cache di ultimo livello condivisa che funge da punto di accesso comune prima di raggiungere la RAM. Questa configurazione non è casuale né frutto di una scelta arbitraria dei progettisti, ma una risposta diretta a un problema critico nei sistemi paralleli: la coerenza della cache.
Senza un robusto meccanismo di coerenza, ogni core potrebbe finire per lavorare con una versione diversa e obsoleta degli stessi dati in memoria , il che, in un programma reale, si traduce in errori sottili, malfunzionamenti imprevedibili e persino arresti anomali del sistema. Pertanto, comprendere come viene mantenuta questa coerenza, sia a livello hardware che software, è fondamentale per comprendere le prestazioni e la stabilità delle moderne CPU multi-core.
Cos'è la coerenza della cache: la metafora del terminale

Immaginate diverse persone sedute davanti a terminali diversi, tutte intente a modificare lo stesso documento memorizzato su un server centrale . Ogni schermo visualizza una copia del file e ci si aspetta che qualsiasi modifica apportata da una persona venga immediatamente visualizzata sugli schermi di tutti gli altri.
Affinché ciò funzioni, è necessario un meccanismo di sincronizzazione che propaghi le modifiche al documento a tutti i terminali, in modo che tutti visualizzino sempre la stessa versione. Finché questo sistema funziona, tutto va bene: chiunque modifichi il testo sa che tutti gli altri visualizzeranno la nuova versione quasi istantaneamente.
Ora immaginate che il sistema di sincronizzazione si guasti improvvisamente. Ogni persona continua a modificare il documento, convinta di lavorare sullo stesso documento condiviso, ma in realtà ogni terminale si ritrova con una copia locale scollegata . Da quel momento in poi, le modifiche apportate da una persona non vengono sincronizzate con le altre e il documento inizia a divergere in modo incontrollato.
Nel campo dell'informatica, questo è esattamente ciò che accadrebbe se la CPU non disponesse di un protocollo di coerenza affidabile: un core modifica i dati in memoria, ma gli altri core continuano a leggere una versione precedente dalle proprie cache private . Ciò crea un terreno fertile per gravi errori logici, dati corrotti e comportamenti non rilevabili dal debugger.
La coerenza della cache è quindi l'insieme dei meccanismi che assicurano che, in un sistema multi-core, tutte le copie degli stessi dati distribuite tra le diverse cache e la RAM mantengano uno stato coerente . Anche se esistono più copie, il sistema deve comportarsi "come se" ce ne fosse una sola.
Cache e gerarchia di memoria in una CPU multi-core
Le cache della CPU sono piccole memorie molto veloci che contengono copie di porzioni di RAM utilizzate di frequente . Quando il processore esegue il codice, invece di accedere continuamente alla RAM (relativamente lenta), tenta di leggere e scrivere nella cache, riducendo drasticamente la latenza.
Il trucco, ovviamente, sta nel fatto che le cache non memorizzano la "versione ufficiale" dei dati, ma solo una replica temporanea . Seguendo la metafora del terminale, la RAM sarebbe il documento sul server, mentre le cache sarebbero gli schermi locali che visualizzano copie di determinate parti del file.
In una CPU multi-core, la progettazione diventa più complessa perché ogni core in genere ha la propria cache di Livello 1 (L1) e persino di Livello 2 (L2) privata . Al di sopra di queste, viene aggiunta una cache di Livello 3 condivisa (ad esempio), situata tra i core e il controller di memoria che fornisce l'accesso alla RAM.
Questa cache condivisa viene introdotta perché consentire a tutti i core di accedere direttamente e intensivamente alla RAM causerebbe conflitti di accesso, contesa sul bus di memoria e un calo significativo delle prestazioni . La cache di ultimo livello funge da "buffer" comune che riduce gli accessi alla RAM e centralizza gran parte del traffico dati.
Inoltre, molte architetture organizzano le cache in modo inclusivo: le righe memorizzate nei livelli più vicini al processore sono presenti anche nei livelli superiori della gerarchia . Ovvero, una riga che compare in L1 è presente anche in L2 e, a sua volta, in L3. Ciò ha una conseguenza molto utile per la coerenza: è sufficiente aggiornare correttamente la cache di livello più basso per controllare lo stato degli altri livelli senza dover accedere continuamente alla RAM.
Perché la memorizzazione nella cache condivisa di ultimo livello è fondamentale per la coerenza
Senza questa cache globale di ultimo livello, ogni core dovrebbe verificare la coerenza direttamente con la memoria principale . Ogni volta che una linea di memoria in una cache privata venisse modificata, sarebbe necessario controllare se altri core mantengono una copia della stessa linea e, in tal caso, aggiornarla o invalidarla ovunque.
In un sistema con molti core, questo carico di lavoro di controlli si tradurrebbe in un numero enorme di transazioni verso la RAM , annullando gran parte del vantaggio di avere cache veloci. Posizionando una cache condivisa tra i core e la memoria, la CPU può concentrare il controllo della coerenza in un'unica posizione intermedia.
In molte implementazioni, le cache ai livelli superiori (più distanti dal processore) contengono copie delle linee presenti nei livelli più vicini al core . Con questa organizzazione, il protocollo di coerenza deve solo garantire che l'ultimo livello sia sincronizzato con la memoria principale e che i livelli privati di ciascun core siano sincronizzati con il livello immediatamente superiore.
Questo può essere visualizzato come una sorta di matrioska: la cache di terzo livello include il contenuto del secondo e del primo livello , il secondo livello include il proprio contenuto e quello del primo livello, e il primo livello conosce solo le proprie righe. Pertanto, controllando la "matrioska" (l'ultimo livello), il sistema può coordinare il resto in modo più efficiente.
Il risultato è che il mantenimento della coerenza diventa più economico in termini di progettazione e traffico di memoria . Invece di costringere ogni core a interagire costantemente con la RAM, il protocollo opera sulla cache condivisa e da lì gestisce quali linee devono essere aggiornate o invalidate nelle cache private.
Metodi di aggiornamento: invalidazione e aggiornamento delle copie
Un problema critico si presenta quando due o più core tentano di accedere, quasi simultaneamente, alla stessa riga di dati replicata su più cache . In questo contesto, i sistemi di coerenza impiegano in genere due strategie fondamentali nella gestione delle operazioni di scrittura.
Il primo metodo si basa sull'invalidazione. Quando un kernel deve scrivere su una specifica linea di cache, il protocollo invalida tutte le copie della stessa linea che potrebbero esistere nelle altre cache . Solo il kernel che deve scrivere mantiene la linea in uno stato che consente la lettura e la scrittura; gli altri, se desiderano utilizzare nuovamente quei dati, dovranno ricaricare la linea dal livello superiore (o dalla memoria) con la versione aggiornata.
La seconda strategia prevede l'aggiornamento. In questo caso, quando un kernel modifica una riga, il sistema tenta di propagare automaticamente il nuovo contenuto alle copie esistenti nelle altre cache . In questo modo, tutte le cache che memorizzavano quella riga ricevono la versione aggiornata senza doverla invalidare e ricaricare in seguito.
Ciascun approccio presenta vantaggi e svantaggi. L'invalidazione è generalmente più efficiente quando le scritture sono frequenti, poiché evita di saturare il sistema di memoria con aggiornamenti che altri core potrebbero non necessitare immediatamente. Al contrario, l'aggiornamento può essere vantaggioso quando molti core leggono frequentemente gli stessi dati che vengono modificati con relativa infrequenza , in quanto riduce la latenza non dovendo ricaricare la riga dopo ogni invalidazione.
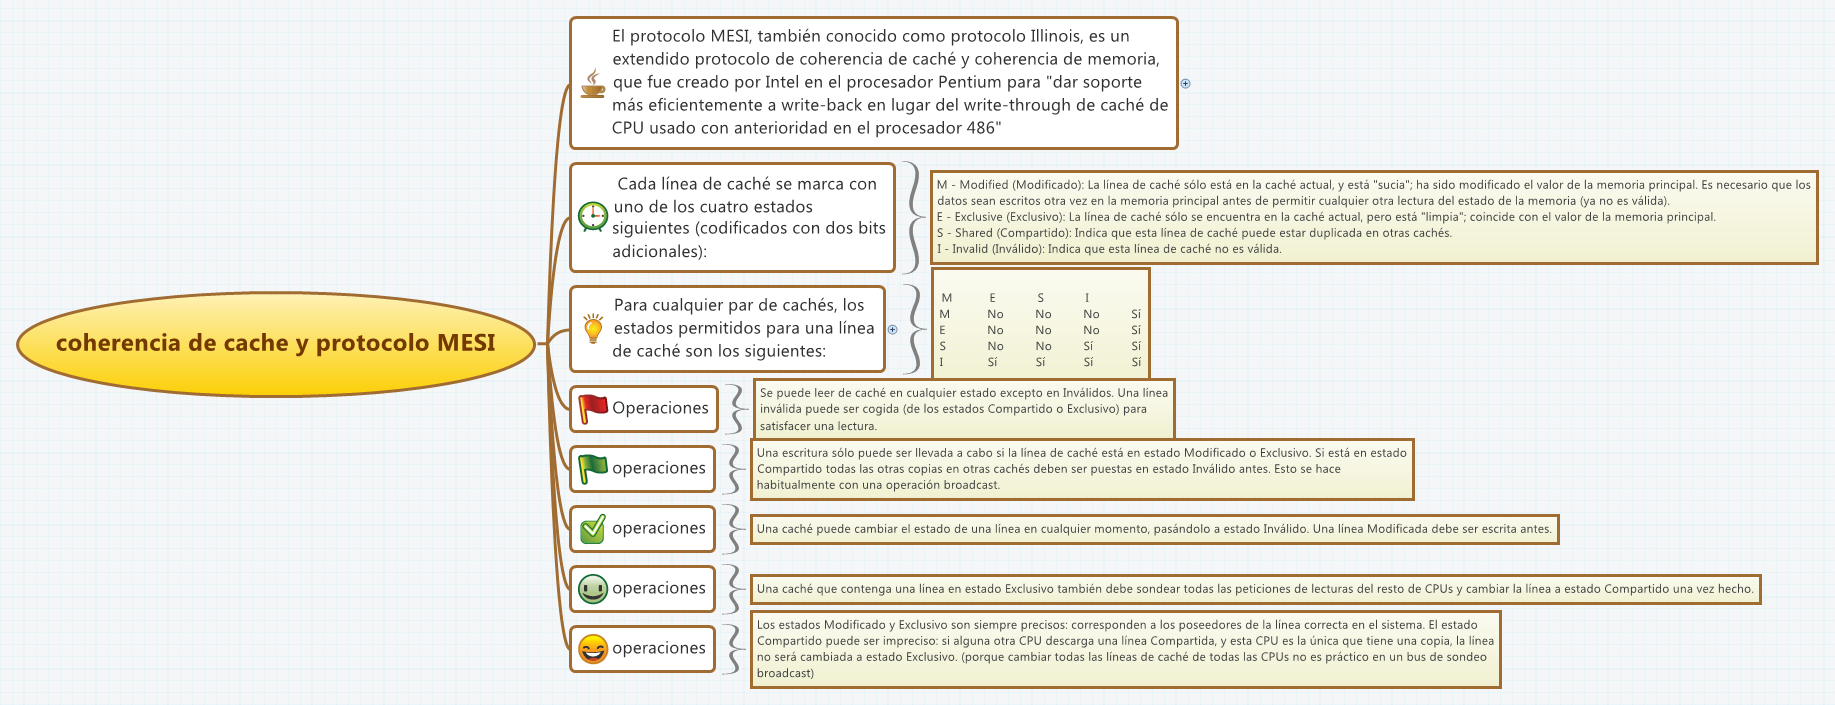
In entrambi i casi, entrambi i metodi utilizzano stati e bit di controllo aggiuntivi nelle linee di cache. Ogni linea in genere include informazioni sulla corrispondenza del suo contenuto con quello presente nella RAM e sul fatto che sia condivisa, modificata, esclusiva, riservata, ecc., a seconda del protocollo specifico (MESI, MOESI, MSI, ecc.). Ciò consente all'hardware di prendere decisioni rapide su come comportarsi quando si verifica un'operazione di lettura o scrittura su una linea già replicata.
Controllo della coerenza tra cache e memoria
Verificare direttamente la coerenza tra tutti i livelli di cache di una CPU o GPU e la memoria principale sarebbe un'impresa titanica, sia in termini di complessità progettuale che di costo in termini di prestazioni. Pertanto, i sistemi moderni organizzano questa verifica in modo gerarchico.
Le cache più vicine al processore (L1, L2) non sono generalmente collegate direttamente alla RAM, ma al livello di cache successivo. Ciò significa che la coerenza non viene verificata rispetto alla memoria principale a ogni livello, bensì rispetto al livello immediatamente superiore . Questo riduce il numero di accessi alla RAM e semplifica la logica richiesta ai livelli inferiori.
In definitiva, il confronto tra il contenuto della cache e quello della RAM viene effettuato tra la cache di ultimo livello e la memoria principale . Se quest'ultimo livello mantiene uno stato corretto e coerente, e ogni livello inferiore mantiene la sua coerenza con quello superiore, l'intera gerarchia rimane coerente senza dover confrontare ripetutamente ogni riga con la RAM.
Quando un kernel scrive su una linea di cache e ne modifica i dati, lo stato di tale linea viene contrassegnato per indicare che non corrisponde più esattamente alla copia memorizzata in memoria . A questo punto, il protocollo coordina l'aggiornamento: contrassegna le copie corrispondenti nelle altre cache come riservate o non valide e, se necessario, scrive il nuovo contenuto sulla linea di memoria principale associata.
Questa organizzazione a cascata consente alle modifiche di propagarsi progressivamente dal kernel, che aggiorna i dati, alla memoria principale, passando attraverso ogni livello di cache in modo controllato. In questo modo, il mantenimento della coerenza non diventa un collo di bottiglia insormontabile per il processore.
Coerenza hardware contro coerenza software
Finora abbiamo discusso di meccanismi di coerenza implementati principalmente a livello hardware: protocolli, bit di stato, cache condivise, ecc. Tuttavia, esiste un altro approccio che mira a spostare parte di questa complessità al software , in particolare al compilatore e al sistema operativo.
Gli schemi di coerenza basati su software tentano di ridurre la necessità di logica on-chip aggiuntiva analizzando il codice e prendendo decisioni in fase di compilazione . L'idea è che se il compilatore è in grado di dedurre quando e come vengono acceduti determinati dati condivisi, potrebbe, in molti casi, impedire che tali dati vengano memorizzati nella cache o gestirne esplicitamente la visibilità.
Questo approccio presenta un chiaro vantaggio: parte del carico di lavoro si sposta dalla fase di esecuzione a quella di compilazione . Invece di lasciare che l'hardware rilevi e gestisca tutti i conflitti in tempo reale, il compilatore tenta di anticiparli e di generare codice che eviti situazioni pericolose.
Lo svantaggio è che l'analisi statica del codice è limitata e, di conseguenza, i compilatori tendono ad essere conservativi . Ciò significa che, per evitare di violare la coerenza, spesso prendono decisioni che riducono l'efficacia delle cache. Se sospettano che alcuni dati possano essere problematici, spesso impediscono che vengano memorizzati nella cache o forzano le sincronizzazioni più frequentemente del necessario.
Pertanto, sebbene questi schemi software siano interessanti in teoria, soprattutto per la semplificazione della progettazione hardware, in pratica non sostituiscono il supporto alla coerenza integrato nella CPU stessa , ma lo integrano in alcuni scenari specifici.
Il ruolo del compilatore nella coerenza della cache
Un elemento chiave degli approcci di coerenza basati sul software è il ruolo del compilatore. Il compilatore può eseguire un'analisi approfondita del codice e determinare quali strutture dati condivise potrebbero non essere sicure per la memorizzazione nella cache . In base a ciò, contrassegna questi elementi in modo speciale o adatta la generazione del codice.
L'approccio più semplice, e anche più conservativo, consiste nell'impedire la memorizzazione nella cache delle variabili di dati condivise . In altre parole, ogni accesso a queste variabili comporta un accesso alla memoria principale o a un'area non memorizzabile nella cache. Questo garantisce la coerenza, ma fa perdere molte opportunità in termini di prestazioni, perché una struttura condivisa può, di fatto, essere utilizzata privatamente durante determinati periodi o in sola lettura in altri.
In realtà, il problema di coerenza si presenta solo negli intervalli in cui almeno un processo può scrivere sulla variabile e un altro processo può leggerla . Al di fuori di questi periodi critici, la variabile può essere considerata ad uso esclusivo di un singolo thread o addirittura come una costante di fatto per un certo periodo, consentendone la memorizzazione nella cache senza problemi.
Le strategie di compilazione più avanzate tentano di identificare i periodi "sicuri" durante i quali la variabile condivisa può essere considerata non in conflitto . A tal fine, il compilatore analizza i percorsi di esecuzione, i potenziali accessi concorrenti e i modelli di sincronizzazione (lock, sezioni critiche, ecc.). Sulla base di questa analisi, suddivide il ciclo di vita della variabile in fasi: alcune adatte alla memorizzazione nella cache, altre che richiedono una gestione speciale.
Durante i periodi critici, quando viene rilevato un accesso simultaneo con operazioni di scrittura, il compilatore inserisce istruzioni aggiuntive nel codice generato per garantire la coerenza della cache . Queste istruzioni possono forzare lo svuotamento della cache, il ricaricamento della memoria, l'utilizzo di barriere di memoria o l'accesso a regioni contrassegnate come non memorizzabili nella cache, a seconda del modello di programmazione e dell'architettura sottostante.
Relazione tra compilatore, sistema operativo e hardware
La frase "il compilatore inserisce istruzioni nel codice generato per garantire la coerenza della cache" potrebbe far pensare che il sistema operativo legga queste istruzioni come se fossero suggerimenti di alto livello e, in base a ciò, decida come eseguire il programma. In realtà, il meccanismo è leggermente diverso.
Quando il compilatore aggiunge questo tipo di istruzioni, introduce nel file binario operazioni specifiche supportate dall'architettura o dall'ambiente di runtime . Ad esempio, può inserire istruzioni per lo svuotamento della cache, barriere di memoria, istruzioni speciali per contrassegnare regioni come non memorizzabili nella cache o chiamate a servizi del sistema operativo che configurano gli attributi di memoria.
Il sistema operativo non interpreta queste istruzioni come "commenti" o "suggerimenti" di alto livello scritti dal compilatore; si limita a eseguire il codice macchina come qualsiasi altro . Tuttavia, alcune di queste istruzioni sono progettate per interagire con il sottosistema di memoria e la gestione della cache, modificando così il modo in cui la CPU accede a determinati dati.
In altre parole, il compilatore esegue un'analisi preliminare e genera codice che, una volta eseguito, produce il comportamento desiderato della cache . Il sistema operativo collabora stabilendo gli attributi della memoria (aree memorizzabili nella cache o non memorizzabili nella cache, politiche di scrittura, ecc.) e fornendo primitive di sincronizzazione, ma non "legge" le istruzioni speciali nel senso di interpretarle semanticamente come farebbe un compilatore.
Può anche accadere che l'hardware, alla vista di determinate istruzioni, attivi specifici meccanismi di coerenza o sincronizzazione . Ad esempio, le istruzioni fence o barrier garantiscono l'ordine di accesso alla memoria e impongono determinati effetti di visibilità lungo la gerarchia della cache. In questo caso, si verifica una collaborazione a tre: il compilatore decide dove posizionare queste istruzioni, il sistema operativo configura l'ambiente di esecuzione e l'hardware implementa il comportamento effettivo a livello di cache e bus di memoria.
Tutti questi elementi, nel loro insieme, assicurano che, anche con più copie degli stessi dati distribuite su cache e memoria principale diverse, i programmi paralleli vengano eseguiti con un modello di memoria coerente . La coerenza della cache, lungi dall'essere un semplice dettaglio interno della CPU, diventa una componente centrale per il funzionamento affidabile ed efficiente dei sistemi multi-core.
Comprendere come si combinano la gerarchia della cache, i protocolli di coerenza hardware e le tecniche di supporto software chiarisce perché le moderne architetture delle CPU condividono una struttura così simile e perché un piccolo guasto in uno qualsiasi di questi meccanismi può innescare un comportamento caotico nelle applicazioni concorrenti che dipendono interamente dal fatto che tutti i core vedano gli stessi dati al momento giusto.