- Analisi delle capacità hardware sia del Raspberry Pi 4 che del potente Model 5.
- Esplorazione di acceleratori esterni come AI HAT+ 2 per ottimizzare l'inferenza generativa.
- Confronto tra l'utilizzo di modelli quantizzati locali e il supporto nelle infrastrutture API esterne.
- Metodologie di implementazione che utilizzano strumenti come Ollama, llama.cpp e ambienti Python.
Se avete mai sognato di avere un assistente virtuale in stile JARVIS a casa vostra, senza dipendere dal cloud e con la massima privacy, probabilmente vi sarete chiesti se una piccola scheda come il Raspberry Pi sia in grado di gestirlo. La risposta breve è sì, anche se l'esperienza varia notevolmente a seconda che si utilizzi l'hardware di base o si decida di potenziarlo con acceleratori specializzati.
L'esecuzione di modelli linguistici estesi (LLM) su dispositivi edge computing consente l'elaborazione direttamente sul dispositivo. Questo non solo elimina i costi mensili del servizio cloud, ma garantisce anche che i dati rimangano all'interno della rete domestica , aspetto fondamentale per chi tiene alla sicurezza della rete domestica e dell'IoT e desidera sperimentare con l'intelligenza artificiale senza restrizioni esterne.

Hardware e funzionalità: dal Raspberry Pi 4 al Raspberry Pi 5
Innanzitutto, è fondamentale capire che non tutte le schede sono uguali. Su un Raspberry Pi 4 è possibile eseguire modelli leggeri, ma le prestazioni sono modeste. Utilizzando strumenti come Ollama , è possibile caricare modelli come tinydolphin , che consentono di chattare tramite il terminale. Sebbene il processo di avvio iniziale possa richiedere alcuni minuti e la macchina possa impiegare un po' di tempo per "pensare" prima di rispondere, una volta che inizia a digitare, lo fa a una velocità accettabile per attività semplici.
Passando al Raspberry Pi 5, la situazione migliora grazie alla sua architettura ARM più potente. In questo caso, la RAM diventa il fattore critico; la versione con 8 GB di RAM è altamente consigliata . Per ottimizzare lo spazio, vengono utilizzate tecniche di quantizzazione (come int4 o 4-bit) , che riducono le dimensioni del modello, consentendogli di entrare in memoria senza sacrificare eccessivamente la precisione.
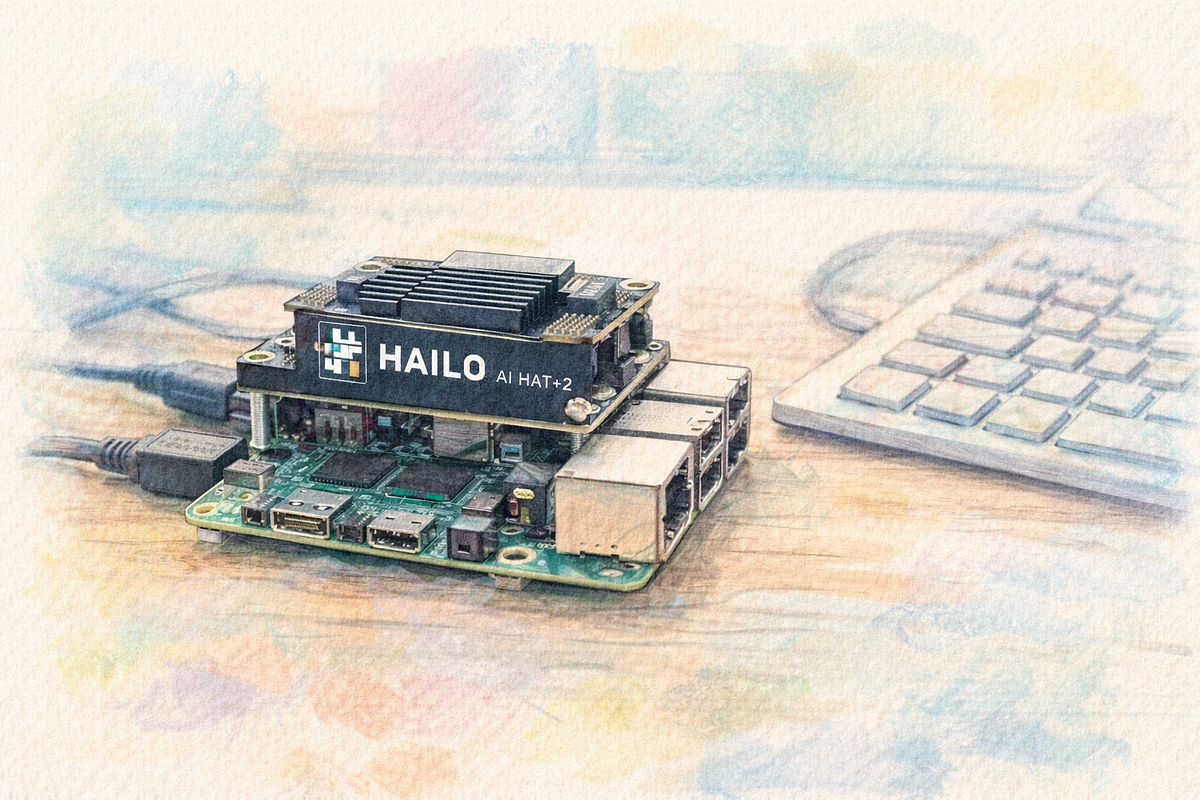
Per gli utenti più esigenti, è arrivato il Raspberry Pi AI HAT+ 2. Questo add-on rappresenta una vera svolta, integrando l' acceleratore Hailo-10H . Mentre il precedente HAT si concentrava sulla visione artificiale (rilevamento di oggetti o segmentazione di scene), il nuovo modello è specificamente progettato per colmare il divario nell'IA generativa, offrendo 40 TOPS di prestazioni di inferenza e 8 GB di RAM dedicati esclusivamente all'acceleratore.

Implementazione tecnica e software
Se decidi di optare per la soluzione puramente software su un Pi 5, lama.cpp È lo strumento standard. Tramite binding Python, è possibile caricare modelli in formato GGUF (come Orca-Mini-3B). Il flusso di lavoro prevede la creazione di un ambiente virtuale e l'installazione llama-cpp-python e configurare uno script per gestire i thread del processore e i prompt utente. Per monitorare che la scheda non si blocchi, è molto utile utilizzare mprof, che consente di analizzare il picco di memoria RAM consumata durante l'esecuzione.
Per chi acquista l'AI HAT+ 2, l'architettura diventa più robusta. L'approccio ideale è installare il driver del kernel Hailo e il relativo runtime. Per praticità, si consiglia di configurare hailo-olama come servizio di sistema (systemd) che si avvia automaticamente all'accensione della scheda, esponendo un'API compatibile con Ollama sulla porta 8000.
Per evitare di dover sempre utilizzare la riga di comando, è possibile installare Apri l'interfaccia utente WebQuesta interfaccia web trasforma il Raspberry Pi in un server di chat professionale, accessibile da qualsiasi browser sulla rete locale. Configurare il OLLAMA_BASE_URL Correttamente, abbiamo un'interfaccia fluida che comunica con l'hardware Hailo, consentendo l'utilizzo di modelli come Qwen2 o Qwen2.5-Coder per attività di programmazione e traduzione a livello locale.
Modelli consigliati e ottimizzazione
È fondamentale essere realistici: un modello con da 1 a 7 miliardi di parametri in esecuzione su un Raspberry Pi non potrà competere in termini di conoscenza generale con un GPT-4 o un Claude, che hanno miliardi di parametri. Tuttavia, i modelli di piccole dimensioni sono eccellenti se ottimizzati . L'AI HAT+ 2 consente l'utilizzo di LoRA (Low-Rank Adaptation) , il che significa che è possibile personalizzare il modello per un compito molto specifico senza dover riaddestrare l'intero sistema.
- TinyDolphin: Ideale per Raspberry Pi 4 grazie al suo bassissimo consumo energetico.
- Orca-Mini-3B: Una bilancia robusta per il Raspberry Pi 5 realizzata con llama.cpp.
- Qwen2 / Qwen2.5: Ottimizzato per l'ecosistema Hailo-10H, ideale per la programmazione e la chat.
- Modelli di linguaggio visivo (VLM): In grado di descrivere le immagini catturate dalla fotocamera del Raspberry Pi in tempo reale.
Se le prestazioni locali risultano insufficienti per un'applicazione di produzione, esiste un'alternativa ibrida. È possibile sviluppare localmente ma delegare l'inferenza ad API esterne come SiliconFlow . Questo permette di mantenere la logica sul Raspberry Pi ma di ottenere risposte immediate tramite il cloud, a costi estremamente bassi per milione di token, evitando così il surriscaldamento o il rallentamento del dispositivo.
Configurare un nodo AI in periferia richiede pazienza, soprattutto a causa delle dipendenze del kernel su distribuzioni come Ubuntu Server. Utilizzare i repository ufficiali di Raspberry Pi è spesso più stabile che compilare tutto da zero. Sebbene l'ecosistema appaia ancora un po' immaturo e ci siano discrepanze tra le versioni dei pacchetti GenAI e la documentazione ufficiale, il risultato finale è un sistema silenzioso, privato e altamente versatile che trasforma la scheda in un cervello autonomo per la domotica.
