- Analisi comparativa tra i modelli proprietari più avanzati e la nuova generazione di modelli open-weight.
- Strategie di distribuzione locale che utilizzano strumenti come Ollama, LM Studio e librerie specifiche per C#.
- Criteri tecnici per la scelta della quantizzazione e del modello in base alla VRAM e all'attività di sviluppo.
Se sei un programmatore, avrai probabilmente già notato la velocità vertiginosa con cui si evolvono gli assistenti di programmazione. Ciò che ieri era considerato lo standard di riferimento è ormai un retaggio del passato, e la sensazione che gli strumenti cambino ogni settimana può essere disorientante. Tra abbonamenti mensili sempre più elevati e la costante incertezza sulla destinazione dei nostri dati, installare l'intelligenza artificiale sul proprio computer è diventata la soluzione più intelligente per chi cerca il controllo totale e la massima privacy.
Non si tratta solo di risparmiare qualche euro al mese, ma di eliminare le dipendenze dalle API e impedire che il codice riservato della tua azienda finisca sui server delle Big Tech. Che tu stia cercando un ausilio per gestire il frontend di Tailwind o una soluzione potente in grado di gestire un intero monorepo, l'ecosistema attuale offre opzioni che, in molti casi, non hanno nulla da invidiare ai modelli a pagamento più costosi sul mercato.
Il panorama dei modelli: proprietari vs. pesi aperti
Quando si parla di pesi massimi, il campo è piuttosto frammentato. Da un lato, abbiamo modelli closed-source come la famiglia Claude di Anthropic. Claude Sonnet 4.6 si è affermato come il compagno ideale per l'uso quotidiano grazie al suo equilibrio tra velocità e precisione, mentre Claude Opus 4.8 è la bestia necessaria per refactoring massicci e architetture di sistema complesse, distinguendosi per la sua capacità di riconoscere i propri errori prima di accettare una risposta.
Dall'altro lato, OpenAI continua a concentrarsi sulla potenza pura e sul dominio del terminale con GPT-5.5 , imbattibile se il flusso di lavoro si basa su script e automazione da console, sebbene a volte possa soffrire di un tasso di allucinazioni più elevato rispetto ai concorrenti. Nel frattempo, Google è tornata alla ribalta con Gemini 3.1 Pro , integrando il deep learning e offrendo un prezzo molto aggressivo che lo rende ideale per chi combina progettazione grafica e programmazione.
Ma la vera novità entusiasmante è ciò che sta accadendo nel mondo open source. Modelli come GLM-5 hanno rivoluzionato il settore, posizionandosi al vertice del mercato dei pesi open source e consentendo a interi team di disporre di un modello di punta senza dover ricorrere a un'API. A questo si aggiunge Kimi K2.5 , un colosso che introduce il concetto di Agent Swarm , permettendo a un massimo di cento sub-agenti di lavorare in parallelo per risolvere un problema di ingegneria, riducendo drasticamente i tempi di esecuzione nei progetti di grandi dimensioni.
Come configurare il proprio ambiente di intelligenza artificiale locale
Per iniziare a eseguire questi modelli sul proprio computer, non è necessario essere esperti di implementazione. L'opzione più semplice e diffusa è Ollama , che funge da gestore di modelli, consentendo di scaricare ed eseguire versioni come Llama 3 o Gemma con un singolo comando. Se si preferisce un'interfaccia più visiva e strumenti per testare diverse quantizzazioni, LM Studio è la scelta giusta, in quanto semplifica la gestione della memoria e il download di file in formato GGUF.
Per gli sviluppatori che desiderano integrare l'IA direttamente nelle proprie applicazioni, esistono approcci più tecnici. Nell'ecosistema .NET, ad esempio, è possibile utilizzare OllamaSharp per comunicare con il server locale tramite HTTP, oppure, se si cerca il controllo assoluto, LlamaSharp . Quest'ultima libreria consente di caricare i pesi del modello direttamente nell'applicazione, permettendo di regolare il numero di layer inviati alla GPU per ottimizzare le prestazioni in base all'hardware disponibile.
Ottimizzazione hardware e VRAM
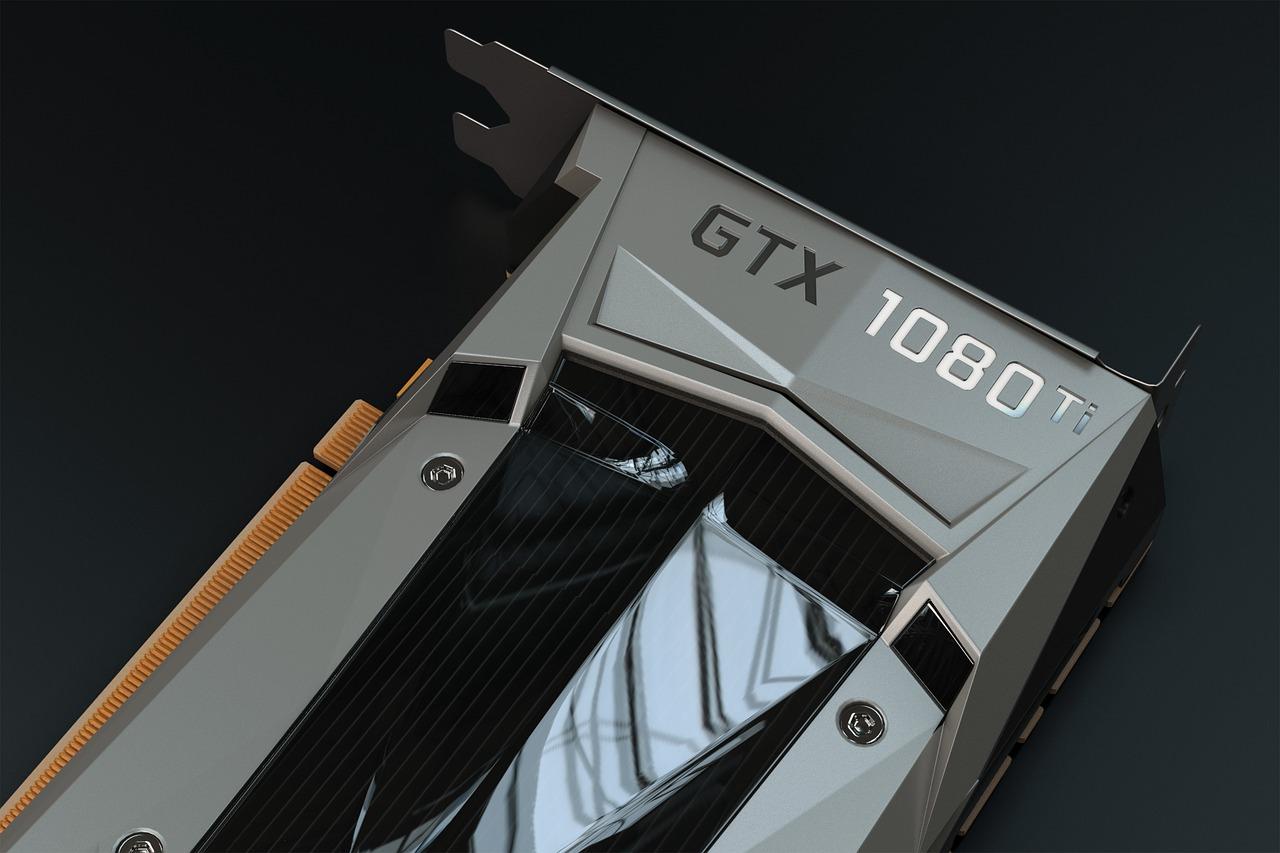
Un errore comune è quello di scegliere un modello basandosi esclusivamente sul numero di specifiche senza considerare la memoria video. Se si possiede una scheda come la RTX 5070 Ti da 16 GB , è necessario prestare attenzione alle dimensioni del modello. Se il modello è troppo grande per la VRAM, il sistema inizierà a utilizzare la RAM di sistema, causando un sottoutilizzo della GPU e un drastico calo dei tempi di risposta, mentre l'utilizzo della CPU aumenterà vertiginosamente.
La chiave sta nella quantizzazione, solitamente rappresentata dalla lettera Q. Una quantizzazione a 4 bit è generalmente il punto ottimale, in quanto riduce significativamente le dimensioni del modello senza compromettere eccessivamente la qualità delle risposte. È fondamentale lasciare memoria sufficiente per il contesto; se si riempie la VRAM al 100% solo con il modello, non ci sarà spazio sufficiente per l'IA per memorizzare i file che le sono stati passati, con conseguenti errori di capacità o risposte incoerenti.
Criteri per la scelta del modello giusto
Non esiste un modello perfetto, ma piuttosto quello giusto per ogni compito. Se il tuo obiettivo è la programmazione pura, cerca modelli focalizzati sulla codifica che comprendano bene il tuo linguaggio, che si tratti di JavaScript, TypeScript o Rust. Un modello focalizzato sulla codifica non solo scrive funzioni, ma è anche in grado di spiegare gli errori e modificare i file senza compromettere la logica esistente del progetto.
- Per chattare e scrivere: Scegli le varianti istruireche sono programmati per eseguire comandi e sostenere conversazioni naturali.
- Per l'analisi dei documenti: Dare priorità ai modelli con un ampia finestra di contesto e strumenti di recupero semantico per impedire all'IA di falsificare i dati.
- Per la visualizzazione e il frontend: I modelli multimodali sono essenziali se si ha bisogno di intelligenza artificiale per analizzare screenshot o diagrammi e convertirli in codice CSS/HTML.
- Per l'automazione: Cerca modelli che supportino Output strutturati JSON e chiamata di funzione.
Per determinare quale sia il modello più adatto alle tue esigenze, l'approccio ideale è quello di effettuare un test comparativo. Prendi due modelli, dai loro esattamente le stesse cinque istruzioni e valuta la loro precisione, il tono e la velocità . In definitiva, il modello migliore non è quello con il punteggio di riferimento più alto, ma piuttosto quello che offre le prestazioni migliori nel tuo effettivo flusso di lavoro.
L'ecosistema locale di intelligenza artificiale è maturato al punto che il divario con i modelli chiusi è quasi irrilevante per molte attività di sviluppo. Combinando strumenti come Ollama o Cursor con modelli aperti come GLM-5 o Qwen, qualsiasi programmatore può disporre di un assistente di alto livello senza compromettere la propria privacy o spendere una fortuna in abbonamenti, mantenendo sempre il pieno controllo sull'esecuzione e la distribuzione dei propri progetti.