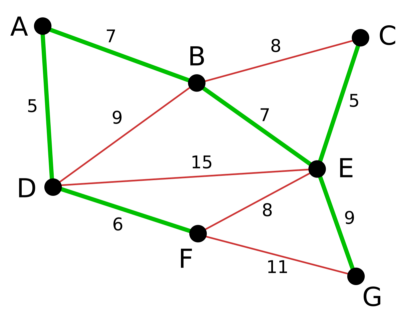
- L'algoritmo di Wilson genera labirinti come alberi casuali uniformi utilizzando percorsi con eliminazione di loop.
- Il modello Wilson (EOQ) calcola la dimensione ottimale del lotto con domanda e prezzi stabili, ma non tiene conto di sconti o stagionalità.
- Il teorema di Wilson caratterizza i numeri primi con (n−1)! ≡ −1 (mod n) e ha generalizzazioni classiche.
Su internet, il termine "Wilson" viene utilizzato per indicare molte cose diverse, il che può generare confusione: si parla infatti dell'algoritmo di Wilson per la generazione di labirinti, del modello di inventario di Wilson (o EOQ) e del teorema di Wilson nella teoria dei numeri. In questo articolo, chiariamo ogni dubbio, partendo dal suo utilizzo originale nei labirinti e distinguendo attentamente gli altri significati, poiché non sono la stessa cosa e non si riferiscono allo stesso ambito.
Se avete mai visto una demo o un'applet in cui un labirinto "cresce" da solo, probabilmente avete già incontrato l'algoritmo di Wilson. Potreste anche aver sentito parlare del modello di Wilson per il calcolo della quantità economica d'ordine o persino del teorema che caratterizza i numeri primi utilizzando i fattoriali. Qui troverete una spiegazione completa con esempi, in modo da poter identificare ogni concetto e utilizzarlo correttamente.
Qual è l'algoritmo di Wilson per i labirinti?
L'algoritmo di Wilson è un metodo di generazione di labirinti basato su cammini casuali con cancellazione dei cicli. Il suo principale vantaggio è che produce un albero di copertura casuale uniforme sulla griglia: in parole semplici, ogni possibile labirinto appare con la stessa probabilità , senza favoritismi verso direzioni o schemi specifici.
L'idea chiave è che i percorsi vengono aggiunti alla rete esistente, ma quando un percorso casuale si interseca con se stesso, il ciclo viene "cancellato" e il percorso continua dal punto in cui si è liberato. Questo dettaglio impedisce al processo di favorire percorsi lunghi e ridondanti o di creare cicli, mantenendo la struttura ad albero che collega tutte le celle. Il risultato è un labirinto "equo": nessun percorso o svolta ha un vantaggio statistico rispetto a un altro.
Esistono progetti e applet creati dalla comunità che dimostrano in modo visivo e divertente l'algoritmo in azione. Tra questi, spiccano alcune applet di Cruz Godar, che permettono di scegliere la dimensione della griglia ed eseguirle per vedere come il labirinto emerge passo dopo passo. Osservarne il funzionamento aiuta a capire perché la cancellazione dei cicli uniforma le probabilità a ogni estensione del grafico.
Costruire e risolvere labirinti, pur sembrando giochi, è strettamente legato a problemi di ricerca e ottimizzazione. Progettarli richiede un equilibrio tra chiarezza e fascino, evitando soluzioni banali o vicoli ciechi impossibili; si tratta di esplorare uno spazio finito con un'infinità di combinazioni. Pertanto, sia su carta che nelle simulazioni digitali, rappresentano un eccellente esercizio di logica, probabilità e pazienza.
Come funziona (in termini pratici)
Di seguito viene fornita una descrizione generale dell'algoritmo, senza codice ma con i meccanismi essenziali per comprenderne il funzionamento. Ricordate che l'obiettivo è costruire un albero (senza cicli) che colleghi tutte le celle, in modo che esista un solo percorso semplice tra due punti qualsiasi.
- Si inizia con una griglia vuota: una cella viene scelta a caso e contrassegnata come parte dell'albero.
- Si sceglie a caso un'altra cella, si inizia un percorso casuale passo dopo passo e, se il percorso si incrocia, i loop vengono immediatamente rimossi (cancellazione del loop).
- Quando la camminata raggiunge l'albero già generato, l'intero percorso rifinito (senza loop) viene "incollato" all'albero.
- Si ripete: scegliamo una nuova cella non connessa, percorriamo il ciclo di eliminazione e ci uniamo all'albero.
- Alla fine, tutte le celle sono collegate e il labirinto è un albero di copertura casuale uniforme, quindi non ci sono distorsioni direzionali o topologiche.
Rispetto ad altri metodi (come Aldous-Broder, Prim o Kruskal adattati ai labirinti), Wilson si distingue per l'uniformità del campionamento dell'albero di copertura. Il suo costo computazionale è ragionevole su griglie tipiche e, soprattutto, garantisce che ogni soluzione sia equiprobabile , un aspetto molto apprezzato in contesti accademici e di simulazione.
Altri significati: Modello di Wilson o EOQ (inventari)
In ambito logistico, il modello di Wilson (chiamato anche EOQ, Economic Order Quantity) non ha nulla a che vedere con i labirinti. Si tratta di un metodo classico per determinare la quantità ottimale di ordine al fine di minimizzare i costi totali di magazzino. Fu reso popolare nel 1934 da R.H. Wilson, sebbene il concetto iniziale fosse stato proposto da Ford Whitman Harris nel 1913.
Il suo scopo è quello di trovare la dimensione del lotto Q che bilanci il costo di emissione degli ordini e il costo di mantenimento delle scorte. Sulla base della domanda annua (D), del costo per ordine (K) e del costo di stoccaggio per unità per periodo (G), si ottiene una quantità che, nell'ambito delle sue ipotesi, riduce il costo totale di magazzino.
La formula più comune è espressa come Q = √(2·D·K/G). Questo valore fornisce la dimensione di ogni lotto; da qui, il numero di ordini annuali sarà D/Q, e con questo si può ricavare il ciclo di riordino. È inoltre importante impostare il punto di riordino (tenendo conto del tempo di consegna) e le scorte di sicurezza per evitare rotture di stock, sebbene la formula di base non includa esplicitamente l'incertezza.
Applicazioni tipiche: Viene utilizzato con materie prime o qualsiasi tipo di merce per la quale i costi di acquisto e stoccaggio possono essere determinati in modo affidabile. In pratica, conoscendo D, K e G con sufficiente affidabilità, l'azienda può dimensionare i lotti e programmare gli approvvigionamenti con maggiore controllo.
Presupposti, vantaggi e limiti del modello Wilson
Le ipotesi sono fondamentali per la validità del risultato. Il modello EOQ presuppone che la domanda sia costante e nota, che il prezzo unitario rimanga stabile, che i costi di stoccaggio siano noti e dipendano dal livello delle scorte, che i tempi di consegna siano costanti e, inoltre, non considera gli sconti per quantità.
- Domanda stabile e indipendente, senza stagionalità o picchi improvvisi.
- Prezzo di acquisto fisso o praticamente invariato nel periodo analizzato.
- Costi di stoccaggio noti per unità e periodo.
- Nessuno sconto quantità e rifornimento immediato o costante.
Principali vantaggi: è semplice da implementare, ampiamente utilizzato e contribuisce a minimizzare i costi di ordinazione e di magazzino in base alle sue condizioni. I benefici includono la riduzione delle scorte eccessive, la diminuzione del rischio di esaurimento scorte (se combinato con un punto di riordino e scorte di sicurezza) e una maggiore chiarezza nella pianificazione degli acquisti. Molte organizzazioni lo apprezzano perché fornisce una base numerica semplice per determinare le quantità da ordinare.
Svantaggi: non funziona bene con la domanda stagionale o irregolare, ignora gli sconti per quantità e presuppone un rifornimento immediato (o fisso), il che è irrealistico in molte catene di approvvigionamento. Pertanto, in contesti come quello del gruppo Toyota, la formula EOQ è stata sostituita da sistemi più robusti come Kanban o Just-in-Time, che gestiscono meglio la variabilità effettiva e il flusso continuo.
Esempi pratici dell'EOQ (Wilson)
Esempio 1 (tipico): Un'azienda con una produzione annua di 10.000 unità acquista 1.000 kg di materia prima. Se ogni ordine costa 200 € e il costo totale annuo di stoccaggio è di 2.000 €, applicando la formula Q = √(2·D·K/G) con D=1.000, K=200 e G=2.000 si ottiene Q ≈ 14,14. Ciò suggerisce lotti da 14 kg e circa 71 ordini all'anno. Si tratta di un esercizio illustrativo in cui, con numeri modesti, possiamo vedere come la dimensione del lotto bilancia ordini e scorte.
Esempio 2: Sillas Grandes World SL distribuisce 6.000 sedie (D), ogni ordine costa 300 € (K) e il costo di stoccaggio annuale per unità è di 5 € (G). Applicando l'equazione, Q ≈ 848,52, il che significa che l'azienda effettuerebbe circa 7,07 ordini all'anno. Con questa dimensione del lotto, l'azienda tende a un livello di inventario più efficiente , riducendo i costi di stoccaggio senza aumentare significativamente i costi di preparazione degli ordini.
Oltre alla formula in sé, è consigliabile calcolare il punto di riordino considerando i tempi di consegna e mantenere scorte di sicurezza, poiché il modello puro non tiene conto dell'incertezza. Inoltre, non stima l'impatto degli sconti per quantità, che a volte potrebbero compensare i costi di magazzino se si utilizzano lotti più grandi.
Da non confondere con il teorema di Wilson (teoria dei numeri)
Il teorema di Wilson appartiene all'aritmetica modulare e afferma essenzialmente che un intero n > 1 è primo se e solo se (n − 1)! ≡ −1 (mod n). L'implicazione "se n è primo, allora (n − 1)! ≡ −1 (mod n)" è solitamente chiamata in senso stretto "teorema di Wilson", e anche l'implicazione inversa è vera. Storicamente, Edward Waring attribuì il risultato a John Wilson (1770), sebbene la prima dimostrazione nota sia stata fornita da Lagrange (1771), e la formulazione risalga in realtà ad Alhazen nell'XI secolo.
Esempio concreto: per p = 11, raggruppando ciascun elemento con il suo inverso moltiplicativo nell'insieme {1, 2, …, p − 1}, il prodotto totale è ≡ −1 (mod p). Tutti i fattori si annullano a coppie poiché g·g^{-1} ≡ 1, eccetto 1 e p − 1, e quindi 10! ≡ −1 (mod 11) . Questo approccio utilizza il fatto che, con p primo, (Z/pZ)^× è un gruppo moltiplicativo e ciascun elemento (eccetto 1 e p − 1) ha un inverso distinto.
Esistono diverse dimostrazioni. Una tecnica polinomiale considera g(x) = (x − 1)(x − 2)···(x − (p − 1)) e f(x) = g(x) − (x^{p−1} − 1). Modulo p, f(x) avrebbe al massimo p − 2 radici se non fosse il polinomio nullo, ma tutti 1, 2, …, p − 1 annullano f(x) per il piccolo teorema di Fermat. Pertanto, f(x) è identicamente 0 mod p; il termine costante porta a (p − 1)! ≡ −1 (mod p).
Non viene utilizzato come test pratico di primalità perché il calcolo di (n − 1)! mod n per n grande è oneroso, ed esistono test più veloci (come il test di Miller-Rabin o test deterministici per ranghi specifici). Ciononostante, può essere utilizzato per dedurre proprietà utili: ad esempio, se p = 2n + 1 è primo, otteniamo ∏_{j=1}^{n} j^2 ≡ (−1)^{n+1} (mod p). E, come corollario parziale, −1 è un residuo quadratico modulo p se p ≡ 1 (mod 4), poiché può essere scritto come il quadrato del prodotto 1·2···2k quando p = 4k + 1, il che mostra quando −1 è elevato al quadrato in Z/pZ.
Esiste anche un "inverso" pratico: per ogni numero composto n > 5, n divide (n − 1)!. Il caso n = 4 è la classica eccezione (3! non è un multiplo di 4). Un modo per vederlo è contare le potenze di un numero primo q che divide n: in (n − 1)! ci sono abbastanza multipli di q per coprire la potenza che appare in n, fatta eccezione per la suddetta eccezione, il che porta al risultato tranne per n = 4.
Gauss generalizzò il teorema: il prodotto di tutte le unità modulo n, ∏_{1≤a<n, (a,n)=1} a, è ≡ −1 (mod n) se n ∈ {4, p^k, 2p^k} con p primo dispari, e ≡ 1 (mod n) in tutti gli altri casi. Dal punto di vista dei gruppi abeliani finiti, il prodotto di tutti i loro elementi è l'identità a meno che non esista esattamente un elemento di ordine 2, nel qual caso il prodotto è quell'elemento di ordine 2.
Tabella illustrativa di (n − 1)! mod n per n = 2…30
La tabella seguente mostra valori specifici per n compreso tra 2 e 30. Per i numeri primi, il resto di (n − 1)! diviso per n è uguale a n − 1 (che è ≡ −1 mod n). Per i numeri composti, il resto è spesso 0. −1 mod n è incluso anche per confronto. Questi dati illustrano chiaramente come si comporta il teorema di Wilson nei casi piccoli e contribuiscono a consolidare l'intuizione.
| n> 1 | (n − 1)! | (n − 1)! mod n | −1 mod n |
|---|---|---|---|
| 2 | 1 | 1 | 1 |
| 3 | 2 | 2 | 2 |
| 4 | 6 | 2 | 3 |
| 5 | 24 | 4 | 4 |
| 6 | 120 | 0 | 5 |
| 7 | 720 | 6 | 6 |
| 8 | 5040 | 0 | 7 |
| 9 | 40320 | 0 | 8 |
| 10 | 362880 | 0 | 9 |
| 11 | 3628800 | 10 | 10 |
| 12 | 39916800 | 0 | 11 |
| 13 | 479001600 | 12 | 12 |
| 14 | 6227020800 | 0 | 13 |
| 15 | 87178291200 | 0 | 14 |
| 16 | 1307674368000 | 0 | 15 |
| 17 | 20922789888000 | 16 | 16 |
| 18 | 355687428096000 | 0 | 17 |
| 19 | 6402373705728000 | 18 | 18 |
| 20 | 121645100408832000 | 0 | 19 |
| 21 | 2432902008176640000 | 0 | 20 |
| 22 | 51090942171709440000 | 0 | 21 |
| 23 | 1124000727777607680000 | 22 | 22 |
| 24 | 25852016738884976640000 | 0 | 23 |
| 25 | 620448401733239439360000 | 0 | 24 |
| 26 | 15511210043330985984000000 | 0 | 25 |
| 27 | 403291461126605635584000000 | 0 | 26 |
| 28 | 10888869450418352160768000000 | 0 | 27 |
| 29 | 304888344611713860501504000000 | 28 | 28 |
| 30 | 8841761993739701954543616000000 | 0 | 29 |
Applicazioni, limiti e raccomandazioni
Se si desidera generare labirinti non distorti, è consigliabile utilizzare l'algoritmo di Wilson: la sua base nei cammini casuali con cancellazione dei cicli garantisce alberi uniformi. Per la gestione delle scorte, il modello di Wilson è utile quando domanda, prezzi e costi sono stabili e noti con precisione; in ambienti volatili, metodologie come Kanban, Just-in-Time o software di pianificazione avanzati possono essere più adatte. In matematica, il teorema di Wilson è un gioiello teorico con interessanti derivazioni (come i residui quadratici), ma non è pratico come test di primalità per numeri grandi.
Non esiste una formula univoca per il calcolo dei costi di ordinazione e stoccaggio: ogni azienda deve analizzare nel dettaglio ore lavorate, processi, trasporto, ricezione merci, personale, affitto, energia, assicurazione e costi finanziari. Molti professionisti stimano le ore necessarie per ogni operazione e applicano una tariffa oraria per la monetizzazione. Questa personalizzazione è fondamentale per garantire che la quantità d'ordine (Q) calcolata sia utile e, insieme a un buon punto di riordino e a scorte di sicurezza adeguate, contribuisca a evitare esaurimenti delle scorte o eccessi di inventario.
È importante ricordare che il termine "algoritmo di Wilson" nelle ricerche si riferisce solitamente al generatore di labirinti, mentre "modello di Wilson" o "EOQ" si riferiscono agli inventari e "teorema di Wilson" alla teoria dei numeri. Distinguerli fin dall'inizio evita confusione e permette di sfruttare al meglio ciascun approccio: labirinti non distorti, lotti ottimali in base a ipotesi realistiche e un'elegante caratterizzazione dei numeri primi che, pur non essendo una dimostrazione pratica di primalità, rimane un tassello prezioso del puzzle matematico.