- המיקרו-ארכיטקטורה מגדירה כיצד מעבד מיישם ISA וקובעת את ה-IPC שלו, את המקבילות הפנימית ואת היעילות בפועל, מעבר לתדירות או לגודל המטמון.
- עיצובים כמו AMD Zen ו-Zen 2 משלבים מטמונים ממוטבים, ביצועים מחוץ לסדר, SMT ויחידות וקטור גדולות כדי לשפר את הביצועים לכל מחזור ולכל וואט.
- אסטרטגיית הצ'יפלט וה-Infinity Fabric מאפשרת הגדלת מספר הליבות ב-EPYC וב-Ryzen תוך שמירה על עלויות מבוקרות וביצועים תחרותיים מאוד.
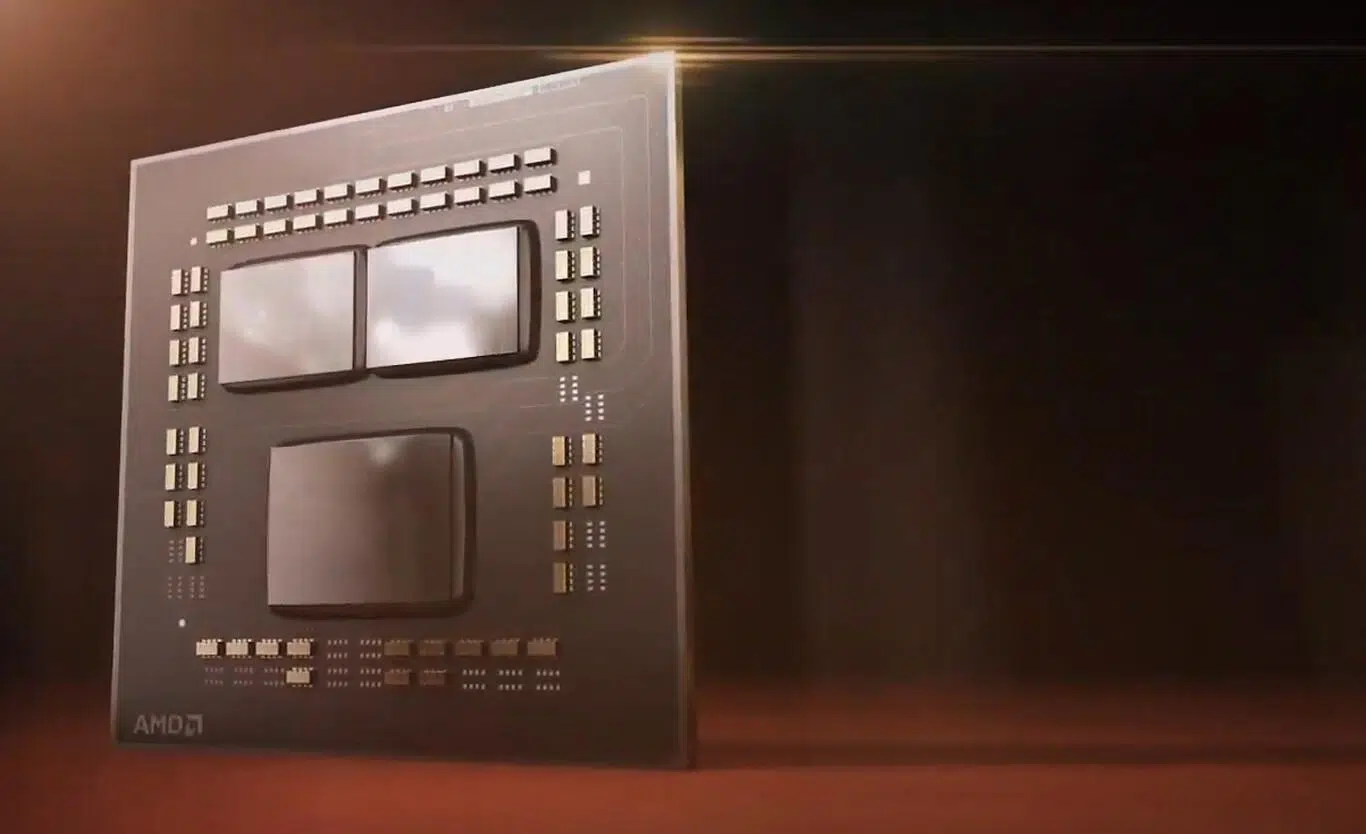
המיקרו -ארכיטקטורה של מעבד נדחקת לעתים קרובות לנתונים בולטים יותר כמו גיגה-הרץ או מגה-בייט של מטמון, אך דווקא שם, בתכנון הפנימי של המעבד, נקבעים רוב הביצועים האמיתיים שלו, יעילותו ואפילו איזה סוג תוכנה יכול לנצל אותו בצורה הטובה ביותר.
כשקוראים מפרטים טכניים שמזכירים ליבות, הליכים, מטמון L3 או AVX2 , רואים למעשה את ההשלכות הקונקרטיות של מיקרו-ארכיטקטורה מסוימת. הבנת האופן שבו רכיבים אלה מאורגנים באופן פנימי, מה מייחד את Zen 3 מ-Zen 2, או את אינטל ההיברידית מ-Ryzen הקלאסי, היא המפתח לבחירת המעבד הבא שלכם בחוכמה ולדעת מדוע חלקם מצטיינים במשחקים, אחרים ברינדור ואחרים במשימות שרת.
ISA, מקרו-ארכיטקטורה ומיקרו-ארכיטקטורה: יצירת סדר במושגים
לפני שנתעמק במורכבות של צינורות (pipelines) ומנבאים, כדאי להבחין בין שלוש רמות שלעתים קרובות מתערבבות זו בזו: מאקרו-ארכיטקטורה של המערכת, ISA ומיקרו-ארכיטקטורה . כל אחת מהן מתארת שכבה שונה של המחשב.
מצד אחד, יש את המקרו-ארכיטקטורה, או עיצוב המערכת הכולל , הכולל את כל מה שרואים על לוח האם: מעבד, בקרי זיכרון, אפיקים, זיכרון ראשי, שבבי קלט/פלט, בקרי אחסון, כל מאיץ חיצוני ולוגיקת DMA. זוהי תמונה ברמה גבוהה של האופן שבו רכיבי החומרה הגדולים מתחברים וכיצד נתונים זורמים ביניהם.
מעל זה נמצאת ה- ISA (ארכיטקטורת מערך ההוראות) , שהיא מערך ההוראות שהמעבד מבין: סוגי הנתונים שהוא מטפל בהם, גודל המילים, מספר וסוג האוגרים, מצבי כתובת, פורמטי הוראות וכו'. כשאתה מתכנת באסמבלי באמצעות mnemonics כמו ADD, SUB, MUL , או מפעיל הרחבות כמו SSE, AVX או NEON, אתה מתקשר ישירות עם ה-ISA.
לבסוף, יש לנו את המיקרו-קוד, או μISA , אשר מגדיר את המיקרו-פעולות הפנימיות בהן משתמשות ארכיטקטורות מורכבות מסוימות (כמו x86) כדי ליישם את הוראות ה-CISC שלהן. ניתן לעדכן את המיקרו-קוד הזה באמצעות קושחה כדי לתקן באגים או להוסיף תמיכה להוראות חדשות.
מהי בדיוק המיקרו-ארכיטקטורה של מעבד?
המיקרו -ארכיטקטורה של המעבד היא למעשה התוכנית הפנימית שקובעת כיצד הוראות ISA מבוצעות וכיצד נתונים נעים בתוך השבב. שני מעבדים יכולים לחלוק את אותו ISA (לדוגמה, AMD64 באינטל וב-AMD) ועדיין להיות בעלי התנהגות וביצועים שונים באופן קיצוני עקב - או אולי בגלל - המיקרו-ארכיטקטורה שלהם.
תכנון זה כולל אלמנטים כגון סוג יחידת הבקרה , האם נעשה שימוש במיקרו-קוד הניתן לתכנות או בלוגיקה קווית; היררכיית הזיכרון; עומק הצינור; כמה יחידות פונקציונליות פועלות במקביל; והאם המעבד מסוגל לבצע הוראות בצורה לא מסודרת ובאופן ספקולטיבי.
בנוסף, על המתכנן לבחור את עומק הצינור : החל ממעבדים פשוטים ללא צינור, שבהם כל הוראה מעובדת מתחילתה ועד סופה לפני תחילתה של הבאה, ועד לעיצובים מודרניים עם שלבים רבים (אחזור, פענוח, שינוי שם, שיגור, ביצוע, כתיבה חוזרת, ביטול הפעלה...) המאפשרים לעשרות הוראות להיות בתהליך פעולה בו זמנית.
קשור לכך מספר וסוג יחידות הביצוע : ALUs עבור מספרים שלמים, יחידות כפל, מחלקים, FPUs עבור מספרים סקלריים ווקטוריים נקודה צפה, AGUs (יחידות יצירת כתובות) לחישוב כתובות זיכרון, יחידות קפיצה וכו'. אם יש מספר יחידות מאותו סוג, אנו מדברים על מעבדים סופר-סקלריים, המסוגלים לשלוח מספר הוראות בכל מחזור.
זהו הבסיס לטכניקות מתקדמות כמו ביצוע ספקולטיבי , שבו המעבד צופה את הרזולוציה של ענף ומבצע הוראות מאחד הענפים מראש. אם התחזית נכונה, נחסך זמן; אם היא נכשלת, העבודה שבוצעה נמחקת והצינור מרוקן, עם העונש המתאים.
רוב המעבדים המודרניים בעלי הביצועים הגבוהים משתמשים גם בביצוע מחוץ לסדר (OoO) . במקום לדבוק בקפדנות בסדר התוכנית, המעבד מסדר מחדש באופן פנימי את ההוראות ומבצע תחילה את אלו שהנתונים שלהן מוכנים, תוך הימנעות ממחזורי סרק בעוד שאחרים ממתינים לזיכרון או לתוצאה של פעולות קודמות.
כדי שכל זה יעבוד מבלי להפר את הסמנטיקה של התוכנית, נעשה שימוש בשינוי שם של אוגרים . המהדר רואה קבוצה מוגבלת של אוגרים לוגיים, אך המיקרו-ארכיטקטורה מתרגמת אותם לבנק גדול יותר של אוגרים פיזיים, תוך הקצאה דינמית של יעדים חדשים כדי לשבור תלויות שווא ולאפשר מקביליות רבה יותר.
לבסוף, התכנון יכול להתמקד בהוספת מקביליות ברמת הליבה והתהליך . זה כולל הכל, החל ממעבדים בעלי ליבה אחת ועד שבבים עם עשרות או מאות ליבות (manycore), מערכות מרובות מעבדים עם מספר שקעים המחוברים זה לזה באמצעות רשתות רשת במהירות גבוהה (Infinity Fabric, Intel Mesh, NVLink וכו'), ותמיכה בריבוי הליכים סימולטניים (SMT) כך שכל ליבה פיזית יכולה להתמודד עם שני הליכים לוגיים או יותר.
תאימות, ISA ומשפחות מיקרו-ארכיטקטורה
מכיוון שמיקרו-ארכיטקטורה היא רק יישום ספציפי אחד של ISA , ISA יחיד יכול לכלול עשרות מיקרו-ארכיטקטורות שונות לאורך השנים ובין יצרנים שונים. זה בדיוק מה שקורה עם x86-64/AMD64 או ARM.
אם נבחן אך ורק את AMD בתוך ה-AMD64 ISA, אנו מוצאים משפחות מגוונות כמו K8/Hammer, K10, Bulldozer וכל סדרת Zen (Zen, Zen+, Zen 2, Zen 3, Zen 4...). כולן מבצעות את אותה מערך הוראות בסיסי, אך הארגון הפנימי שלהן, המטמונים, הצינורות וגישות הביצוע המקבילות שלהן שונות לחלוטין.
כאשר אנו מחליפים ISA, הקפיצה בתאימות היא מוחלטת. מעבד מבוסס ARM A64 (כמו Apple Silicon) אינו יכול להריץ קבצים בינאריים שעברו קומפילציה עבור x86-64, ולהיפך, אלא אם כן נעשה שימוש בשכבת תרגום או אמולציה כמו Rosetta 2, QEMU או דומים, עם עלות ביצועים תואמת.
אפילו בין מעבדים שחולקים ISA, אין ערובה שכולם תומכים באותה קבוצת הוראות או הרחבות. שבב ישן יותר עשוי לחסר AVX2 או AVX-512, או ש-ARM SoC עשוי ליישם רק תת-קבוצה של הרחבות אופציונליות. לכן, קובץ בינארי המשתמש במידה רבה ב-AVX-512 עלול להיכשל באתחול על מעבד המציע רק SSE4.
בעת קומפילציה של תוכנה, מקובל ליצור קבצים בינאריים גנריים עבור ISA ספציפי (לדוגמה, x86-64 עם לפחות SSE2) מבלי לנצל באופן מלא אף מיקרו-ארכיטקטורה מסוימת, כך שהקובץ הניתן להרצה יפעל על כמה שיותר מעבדים. עם זאת, אם מבצעים קומפילציה עם דגלי כוונון עבור מיקרו-ארכיטקטורה ספציפית (-march=znver3, -mtune=skylake וכו'), ניתן לשפר משמעותית את הביצועים במשפחה ספציפית זו, במחיר של אובדן תאימות עם אחרים.
רישיונות ISA וקניין רוחני של העיצוב
לא רק שקוד התוכנית מוגן על ידי רישיונות: גם ISA ומיקרו-ארכיטקטורות הן קניין רוחני. איש אינו יכול לשכפל באופן חוקי ISA של x86 או AMD64 ללא רישיון, בדיוק כפי שלא ניתן להעתיק עיצוב קנייני של מעבד ללא רשות.
בתחום של מערכות ISA, ישנן שלוש גישות עיקריות. מצד אחד, ישנן מערכות ISA סגורות , שבהן הבעלים שולט היטב במי יכול ליישם ליבות תואמות. הדוגמה הקלאסית היא IA-32 (x86-32), שהייתה בבעלות היסטורית של אינטל, אשר העניקה רישיונות ל-AMD, VIA ואחרות, לא בלי מאבקים משפטיים.
מצב דומה קיים עם AMD64/x86-64 , שתוכנן בתחילה על ידי AMD ומאוחר יותר הועבר ברישיון לאינטל (שקראה לו EM64T) באמצעות הסכמי רישוי צולבים. שחקנים אחרים, כמו Hygon בסין, השיגו גם הם רישיונות לגרסאות ספציפיות (לדוגמה, Zen 1 עבור השוק הסיני).
בנוסף, יש לנו ISA עם רישוי גמיש , שבו הבעלים מציע גם רישיונות ISA וגם ליבות IP מוכנות לשילוב. ARM, SPARC או OpenPOWER מתאימים כאן: ניתן לשלם כדי להשתמש ב-Cortex A/M/R או Neoverse כפי שהם, או עבור רישיון המאפשר לעצב מיקרו-ארכיטקטורות משלכם על גבי ה-ISA, כפי שעושה אפל עם ה-M1/M2/M3 שלה או קוואלקום עם ה-Kryo שלה.
לבסוף, ישנם מערכות ISA בקוד פתוח , שבהן כל אחד יכול ליצור מיקרו-ארכיטקטורות תואמות מבלי לשלם תמלוגים עבור ה-ISA (אם כי ניתן לרשום פטנט או לסגור את המימוש שלו). RISC-V הוא הדוגמה הטובה ביותר: ה-ISA נמצא תחת רישיון BSD מתיר, וישנן אפשרויות הנעות בין ליבות פתוחות לחלוטין ב-Verilog או Chisel ועד עיצובים מסחריים סגורים.
בנוסף ל-ISA, כל מיקרו-ארכיטקטורה ספציפית (ליבת Zen 4, Cortex X4, עיצוב GPU וכו') היא בלוק של קניין רוחני רשום או פטנטי. ישנם גם כאן עיצובים פתוחים, שפורסמו כליבות רכות על HDL לסינתזה ב-FPGA או שילוב ב-SoCs מותאמים אישית.
התעמקות במיקרו-ארכיטקטורות מודרניות: מארז AMD Zen
כדי לראות כיצד כל זה מתורגם לביצועים בעולם האמיתי, אין כמו לנתח משפחת מוצרים ספציפית. AMD שינתה באופן דרמטי את עסקיה הודות ל- Zen ולגרסאותיה העוקבות , ועברה מעידן הבולדוזר הקשה ומעבדי ה-FX הישנים למתחרים ראש בראש (ולפעמים אף עוקפים את) אינטל בשווקי מחשבים שולחניים, שרתים ומחשבים ניידים.
לאחר כישלון אסטרטגיית ה-Fusion של AMD , החברה ביצעה ארגון מחדש ובחרה בתכנון בעל ביצועים גבוהים, בהובלת ג'ים קלר, בין היתר. תוכנית ה-Zen נועדה להגדיל באופן אגרסיבי את ה-IPC (הוראות למחזור) בהשוואה ל-Buldozer, לשפר את הביצועים לוואט, ולהחזיר לעצמה את הקרקע בביצועי ליבה בודדת, שם החזיקה אינטל ביתרון במשך שנים.
אחד השינויים המרכזיים היה חיזוק החזית , החלק האחראי על אחזור והכנת הוראות. Zen הציגה מטמון מיקרו-פעולות שמאחסן מיקרו-פעולות שכבר פוענחו, בדומה למה שעשו חלק מהמיקרו-ארכיטקטורות של אינטל כמו Conroe. ל-Buldozer חסרה תכונה זו והסתמכה יותר על היררכיית מטמון ההוראות הקלאסית, מה שהשפיע לרעה על התפוקה שלה.
המפענח של Zen יכול לתרגם עד ארבע הוראות CISC x86-64 בכל מחזור למיקרו-אופים דמויי RISC. המיקרו-אופים הללו מוצבים לאחר מכן בתור המוזן על ידי מאגר המיקרו-אופים, אשר בתורו יכול לשלוח עד שישה מיקרו-אופים בכל מחזור למתזמני הקצה האחורי. כאן מתחילה הביצוע שלא לפי הסדר.
AMD הפרידה בבירור בין נתיבי המספר השלם והנקודה הצפה . בצד השלם, יחידות ALU, יחידות AGU ולוגיקת טעינה/אחסון מוזנות מתור המיקרו-אופס. לוגיקה זו מסוגלת לבצע שתי טעינות של 16 בתים ואחסון אחד של 16 בתים לכל מחזור מ-L1D 8-כיווני בנפח 32 KB, עם מדיניות כתיבה חוזרת.
צד הנקודה הצפה והווקטור מזינים יחידות FMAC ו-AVX. עם שני יציאות כפל ושני יציאות חיבור, Zen יכול לבצע בו זמנית שתי פעולות FMA של 128 סיביות או פעולת AVX אחת של 256 סיביות לכל מחזור שעון. מקביליות ברמת ההוראה הזו היא אחד המפתחות לביצועים החזקים שלה תחת עומסי עבודה עתירי חישוב.
היררכיית מטמון, TLB וארגון זיכרון ב-Zen
היררכיית הזיכרון ב-Zen מאורגנת לשלוש רמות מטמון: L1 נפרד להוראות ונתונים, L2 פרטי לכל ליבה, ו-L3 משותף . למרות שהוא יורש את המבנה הבסיסי של מיקרו-ארכיטקטורות קודמות, גדלים, אסוציאטיביות ומדיניות שוכללו.
ה- L1I (מטמון הוראות) מציע 64 KB לכל ליבה, עם 4 נתיבים אסוציאטיביים, מה שמכפיל את מספר הנתיבים לכל מודול בהשוואה ל-Buldozer ומפחית קונפליקטים. ה- L1D (מטמון נתונים) גדל ל-32 KB, 8 נתיבים ומדיניות כתיבה חוזרת, בהשוואה ל-16 KB, 4 נתיבים וכתיבה חוזרת של Bulldozer, מה שמשפר משמעותית הן את קצב הפגיעה והן את יעילות הכתיבה.
מטמון L2 מיושם כ-512 KB לליבה וב-8 כיוונים, במקום 2 MB ל-16 כיוונים משותפים לכל מודול בדור הקודם. מטמון L3 , בינתיים, מציע מספר MB לליבה עם אסוציאטיביות של 16 כיוונים, ופועל כרמה המשותפת האחרונה לפני המעבר ל-DRAM.
במקביל, Zen מפריד את קבצי ה-TLB לקבצי ITLB (להוראות) ו-DTLB (לנתונים) , כל אחד עם מספר רמות ומאות ערכים, כולם עם הגנת זוגיות. זה מפחית משמעותית את השהיית תרגום הכתובות מווירטואלי לפיזי, שהופכת קריטית יותר ויותר ככל שגודל הזיכרון גדל.
כשאנחנו מדברים על מטמון דו-כיווני, 4-כיווני או 8-כיווני , אנחנו מתארים את האסוציאטיביות שלו, הקשורה קשר הדוק לרעיון של שילוב בזיכרון. אסוציאטיביות רבה יותר פירושה דרכים שונות יותר לאחסן בלוק זיכרון באותו מטמון, מה שמפחית קונפליקטים, אך במחיר של לוגיקה מורכבת מעט יותר ועלייה קלה בזמן ההשהיה.
חשוב גם להבין את ההבדל בין כתיבה-דרך (write-through) לכתיבה-אחורה (write-back) . בכתיבה-אחורה, כל כתיבה מעדכנת בו זמנית את המטמון (cache) ואת הזיכרון הראשי, מה שמפשט את העקביות אך מגדיל את התעבורה. בכתיבה-אחורה, רק המטמון נכתב, והשורה מסומנת בביט מלוכלך (dirty bit); ה-DRAM מתעדכן רק כאשר שורה זו מפונה, מה שחוסך רוחב פס ומשפר את הביצועים במחיר של לוגיקה מורכבת מעט יותר.
Zen ו-Zen+: קפיצת מדרגה במדד המחירים לצרכן וביעילות
Zen ייצג קפיצת מדרגה משמעותית מאוד ב-IPC עבור AMD בהשוואה ל-Bulldozer , הודות לשילוב של חזית טובה יותר, ניבוי ענפים טוב יותר, יותר יחידות ביצוע, SMT במקום CMT (כל ליבה מלאה מטפלת בשני הליכים, במקום לחלוק חלק מה-FPU בין שתי ליבות לוגיות) והיררכיית מטמון הגיונית הרבה יותר.
בנוסף לעיצוב, AMD נהנתה מתהליכי ייצור מתקדמים יותר עם FinFET וצמתים קטנים יותר , המאפשרים צפיפות טרנזיסטורים מוגברת, צריכת חשמל מופחתת באותם ביצועים ותדרים גבוהים יותר תוך שמירה על TDP ( עקומת מתח-תדר ) סבירה. איזון ביצועים זה לוואט היה קריטי להשבת התחרותיות במחשבים ניידים ושרתים.
המעבר מ- Bulldozer ל-Zen הביא גם תורי פרישה ארוכים יותר, מתזמני הוראות גדולים יותר, רוחב פס פנימי גדול יותר, חיזוי ענפים עם טכניקות המבוססות אפילו על רשתות עצביות פשוטות, ו-SMT המסוגל לדחוס טוב יותר את יחידות הביצוע הזמינות.
בהקשר זה, עולה Zen+ , שאותו נוכל לראות כמקבילה ל"טיק" באסטרטגיית הטיק-טוק הישנה של אינטל: אותו עיצוב בסיסי כמו Zen, אך מיוצר על צומת משופר יותר, עם שיפורי תדר, הפחתות קלות של השהייה והתאמות תזמון פנימיות. זו לא מהפכה ארכיטקטונית, אלא עידון שמתורגם לכמה נקודות ביצועים נוספות.
Zen 2: שבבים, AVX2 מלא ועידון עמוק
עם Zen 2 , AMD כבר לא רק מלטשת את התהליך: היא מציגה שינויים משמעותיים במיקרו-ארכיטקטורה ומשיקה באופן מסיבי את אסטרטגיית השיבלים שלה . במקום שבב מונוליטי גדול אחד, היא מחלקת את העיצוב למספר שבבי מחשוב קטנים יותר ב-7 ננומטר (CCDs) ושבב קלט/פלט נפרד ב-12 ננומטר המטפל בזיכרון, PCIe וחיבורים.
גישת שבבים זו משפרת את התפוקה לכל פרוסה (קל יותר לייצר שבבים קטנים וללא פגמים), מפחיתה עלויות ומקלה על הגדלת מספר הליבות: פשוט הוסיפו עוד CCDs כדי להגיע ל-16, 32 או יותר ליבות ב-EPYC וב-Threadripper. הפשרה היא תקשורת פנימית מורכבת מעט יותר, התלויה בחיבור Infinity Fabric, ש-AMD משפרת דור אחר דור.
מבחינת ביצועים גולמיים, AMD מדברת על כ- +15% IPC עבור Zen 2 בהשוואה ל-Zen+ באותו תדר ושיפור ביצועים כללי לוואט שיכול להיות כ-+75% בהשוואה ל-Zen הראשון כאשר משלבים שיפורי עיצוב ותהליך.
בקצה האחורי של הווקטורים, Zen 2 לוקח את החלק החסר: הוא מציע תמיכה מלאה ב-AVX2 של 256 סיביות במיקרו-אופ יחיד , מבלי לפצל הוראות לשתי פעולות של 128 סיביות כפי שהיה במקרה של Zen/Zen+. משמעות הדבר היא שיחידות ביצוע הווקטורים הן כעת באמת 256 סיביות ויכולות לעבד עומסי עבודה של AVX2 במהירות מלאה עם עונש תדר קטן בהרבה מאשר בעיצובים אחרים.
גם מטמון המיקרו-אופס מתחזק, והוא גדל ל -4K ערכים (כפליים מגודלו), תוך ניצול חלק מהשטח שהתפנה על ידי צמצום מטמון ה-L1I בחצי אך הכפלת האסוציאטיביות שלו מ-4 ל-8 דרכים. סימולציות פנימיות הובילו את AMD למסקנה שעבור רוב עומסי העבודה בעולם האמיתי, מטמון uop גדול יותר יתרון יותר ממטמון L1I גדול יותר.
קיבולת המטמון של L3 לכל בלוק ליבה מוכפלת , מה שעוזר להפחית כשלים ברמה האחרונה, אם כי זמן השהיית הגישה עולה מכ-35 ל-40 מחזורים. כדי למתן השפעה זו, Zen 2 משפר את רוחבי הפס של הטעינה והאחסון ומשפר את מדיניות ה-prefetch.
היבט חשוב נוסף הוא חיזוי הענפים. Zen 2 משתמש בחיזוי TAGE (TAgged GEometric) עם למעלה מ-7 ערכים, המסוגל למנף היסטוריות באורך משתנה וערכים מתויגים. זה מפחית את ה-aliasing בין ענפים שונים, ולדברי AMD, מקטין את מספר התחזיות השגויות בכ-30% בהשוואה לתוכנית הקודמת, מה שמתורגם ישירות לפחות ניקוי צינורות ו-IPC גבוה יותר.
Zen 2 Back-end: AGUs, buffers ו-latencies מותאמים
בכל ה-back-end, Zen 2 ממשיך לשלוח עד שש מיקרו-פעולות (micro-ops) בכל מחזור ממאגר ההזמנה מחדש, אשר הורחב לכ-224 ערכים (בהשוואה ל-192 של Zen). יחידות התזמון מחולקות לארבעה תורים עבור יחידות ALU של 16 ערכים כל אחד ותור אחד עבור יחידות AGU של 28 ערכים.
מספר יחידות יצירת הכתובות (AGUs) גדל משתיים לשלוש, אם כי לא כולן זהות: שתיים מהן יכולות להתמודד גם עם טעינות וגם עם כתיבות, בעוד שהשלישית מתמחה בפעולות אחסון. חלוקה זו מיועדת לפרופילי תוכנה אופייניים, שבהם טעינות בדרך כלל תכופות וקריטיות יותר מפעולות אחסון.
במישור הנקודה הצפה, הקצה האחורי יכול לקבל ארבעה מיקרו-אופים בכל מחזור ליחידות וקטור FMA של 256 סיביות, הנתמכות על ידי קובץ אוגר פיזי בן 160 ערכים. נתיבי הטעינה/אחסון של 256 סיביות שופרו כדי להזין יחידות אלו בקצב מתמשך תחת עומסי עבודה וקטוריים כבדים.
Zen 2 גם מתאים את זמן ההשהיה של פעולות מסוימות : לדוגמה, כפל נקודה צפה מפחית את זמן ההשהיה שלו מ-4 ל-3 מחזורים, מה שעוזר עם לולאות חישוב מספריות צפופות מאוד. ובכלל, יש קבוצה של אופטימיזציות קטנות הפרוסות לאורך הצינור שמצטברות לאותו IPC נוסף שנראה במבחני ביצועים סינתטיים וביישומים בעולם האמיתי.
בנוגע להיררכיה הפנימית לפי קבוצות ליבות, AMD משתמשת בקונספט CCX (Core Complex) : בלוק של 4 ליבות שחולקות את אותו מטמון L3 (16 MB ב-Zen 2). גודל נוסף זה מרמז על השהייה מעט גבוהה יותר, אך בתמורה מפחית את שיעור הכשלים, במיוחד ביישומים עם מערכי עבודה גדולים.
לצורך התייחסות, נוכל להיזכר בנתוני השהייה פנימית משוערים: כ -4 מחזורים עבור L1 , כ-12 עבור L2, וכ-40 מחזורים עבור L3. המפתח הוא לשמור כמה שיותר נתונים ב-L1/L2 ולהפחית את התעבורה ל-L3 ול- DRAM , דבר שהמיקרו-ארכיטקטורה והמהדרים פועלים יחד כדי להשיג.
בד אינפיניטי: הדבק המשמש בצ'יפלטס והשפעתו על הביצועים
רכיב אחד שאינו תמיד קשור למיקרו-ארכיטקטורה, אך חיוני ב-Zen 2 ואילך, הוא Infinity Fabric . אפיק קנייני זה משמש כ"כביש מהיר" לתקשורת בין CCXs, CCDs, שבב הקלט/פלט, הזיכרון, ובכלל, בין כל בלוקי ה-SoC.
Infinity Fabric הוא אבולוציה של HyperTransport , אפיק התקשורת המהיר ש-AMD פיתחה לפני שנים, וששימש גם צדדים שלישיים כמו NVIDIA, Cisco, Sun וחברים אחרים בקונסורציום. IF יורש את הפילוסופיה של קישורים נקודה-לנקודה ניתנים להרחבה, אך מותאם לצרכים של SoCs מודרניים וחיבור CPU-GPU.
ב-Zen 2, AMD מציגה את IF2 , עם תמיכה ב-PCIe 4.0 ואפיק פנימי של 512 סיביות בין שבבי CCX, כפול מזה של הגרסה הראשונה. זה מתורגם לרוחב פס יעיל יותר ושיפור יעילות ש-AMD מעריכה בכ-27% בהשוואה ל-IF1, מה שעוזר להפחית את עונש הביצועים של מעבר בין שבבים.
יתר על כן, שעון ה-Infinity Fabric מנותק חלקית משעון ה-DRAM , מה שמאפשר לזיכרון הראשי להתרחב לתדרים גבוהים יותר בתרחישים מסוימים מבלי בהכרח לאלץ את ה-IF לעמוד בקצב, מה שמציע יותר מרחב כוונון עדין לחובבים ולמתכנני מערכות.
במעבדי שרתים כמו EPYC , עם ארבעה שבבי מחשוב או יותר, Infinity Fabric הוא מה שמאפשר לחבר את כל הקוביות יחד עם טופולוגיות כמעט שלמות (סיבובים של 180 מעלות, קישורים ישירים וכו'), ולהשיג רוחבי פס מסוג die-to-die שיכולים בקלות לעלות על 150 ג'יגה-בייט/שנייה דו-כיווני, תלוי במהירות ה-DDR בו נעשה שימוש.
השילוב של מיקרו-ארכיטקטורה חזקה בכל ליבה , עיצוב ניתן להרחבה באמצעות שבבים (chiplets) וחיבורים מהירים מספיק מאפשרים ל-AMD להרכיב מעבדים עם 32, 64 או יותר ליבות עם ביצועים יוצאי דופן בעומסי עבודה מקבילים ביותר, תוך שמירה על IPC תחרותי לכל הליך.
בסופו של דבר, כשמשווים מעבדים במבחני ביצועים למשחקים, רינדור תלת-ממדי, קומפילציה מסיבית או סימולציה מדעית, נתוני מספר ה-GHz ומספר הליבות מספרים רק חלק מהסיפור. מה שבאמת עושה את ההבדל הוא האופן שבו המיקרו -ארכיטקטורה מתזמרת את הביצועים הפנימיים , כיצד היא מנצלת או מבזבזת כל מחזור שעון, ואילו פשרות עשה היצרן בין השהייה, רוחב פס, צריכת חשמל ומורכבות.

אינדקס
- 1 ISA, מקרו-ארכיטקטורה ומיקרו-ארכיטקטורה: יצירת סדר במושגים
- 2 מהי בדיוק המיקרו-ארכיטקטורה של מעבד?
- 3 תאימות, ISA ומשפחות מיקרו-ארכיטקטורה
- 4 רישיונות ISA וקניין רוחני של העיצוב
- 5 התעמקות במיקרו-ארכיטקטורות מודרניות: מארז AMD Zen
- 6 היררכיית מטמון, TLB וארגון זיכרון ב-Zen
- 7 Zen ו-Zen+: קפיצת מדרגה במדד המחירים לצרכן וביעילות
- 8 Zen 2: שבבים, AVX2 מלא ועידון עמוק
- 9 Zen 2 Back-end: AGUs, buffers ו-latencies מותאמים
- 10 בד אינפיניטי: הדבק המשמש בצ'יפלטס והשפעתו על הביצועים