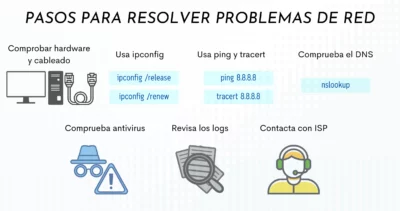
- ネットワーク障害による経済的損失は企業の規模によって大きく異なり、大企業では1時間あたり30万ドルを超える場合もある。
- 収益の直接的な損失にとどまらず、システム停止はブランドイメージ、SEOランキング、そして労働生産性を低下させる。
- 合成監視やフォールトトレランスといった回復力強化戦略を導入することこそが、高可用性を実現する唯一の方法である。

おそらく皆さんも経験したことがあるか、耳にしたことがあるでしょう。突然ネットワークが停止し、業務の流れが完全に止まってしまうのです。一時的な問題のように思えるかもしれませんが、ネットワークのダウンタイムは、小規模なオンラインストアからフォーチュン500企業まで、あらゆる規模の企業に影響を与える慢性的な問題です。ケーブルの接続ミスといった単純な人為的ミスから、自然災害、ソフトウェアアップデートの失敗まで、原因は様々ですが、結果は常に同じです。それは、会計上の損失です。
今日のデジタルエコシステムでは、あらゆるものが24時間7日利用可能であることが求められます。そのため、インフラの信頼性は贅沢品ではなく、生き残りの基盤となります。システムがダウンすると、単に販売が停止するだけでなく、顧客の信頼や社内プロセスの効率性が危機に瀕します。だからこそ、ネットワークダウン時にどれだけのコストがかかるかを正確に把握することが、場当たり的な対応から脱却し、本格的なレジリエンス戦略への投資を開始するための第一歩となるのです。

ネットワークがダウンした場合、実際にどれくらいの金額が損失するのでしょうか?

正確な数字を挙げるのは多くの要因に左右されるため複雑ですが、ガートナーやITICといったコンサルティング会社のデータは驚くべきものです。平均すると、中規模または大規模企業では、1時間のシステム停止で30万ドル以上の損失が発生すると推定されています。影響が甚大な極端なケースもあり、例えば、不適切なアップデートが原因で発生した世界規模のシステム障害は、銀行や医療などの業界でわずか数日のうちに数十億ドルの損失をもたらしました。
さらに細かく見ていくと、1分あたりのコストは業種によって異なります。大企業の場合、1分あたり約5.600ドルの損失となる可能性がありますが、中小企業(SME)の場合は137ドルから427ドルの範囲になる可能性があります。一見少ない金額に見えるかもしれませんが、中小企業にとっては、この金額が会社の存続を左右するほどの大きな問題となるのです。

ダウンタイムのコストを押し上げる要因

景気後退の影響は必ずしも同じではありません。市場セクターが決定的な要因となります。銀行、病院、製造工場などは、業務プロセスが極めて重要であり、遅延が許されないため、学校や建設会社よりもはるかに深刻な損失を被ります。同様に、組織の規模も重要な役割を果たします。従業員数が多いほど、生産性の低下による損失は大きくなります。何百人もの従業員が給与を受け取りながらも、価値を生み出すことができないからです。
ビジネスモデルも忘れてはなりません。主な収入源がeコマースであれば、サーバー障害は即座に大惨事となります。一方、実店舗とデジタルサポートを併用している場合は、影響は少ないものの、やはり損害は大きいと言えます。IoTの登場やクラウドの導入により、現代のネットワークは複雑化し、新たな脆弱性が生まれています。そのため、障害の発生頻度が高まり、解決もより困難になっています。
目に見えないコスト:収益損失だけにとどまらない

2時間でどれだけの売上が失われたかは誰でも計算できますが、真の危険は目に見えないコストにあります。最も深刻なダメージは信頼の喪失です。エラーページに遭遇した顧客は二度と戻ってこないでしょう。さらに、Googleをはじめとする検索エンジンクローラーは信頼性の低さをペナルティとするため、AIによるSEOや検索エンジンランキングへのダメージは現実のものです。
社内における生産性の低下は甚大です。1,000人の従業員が遊休状態にある場合、その1時間分の人件費は純損失となります。さらに、サービスレベル契約( SLA)に基づくペナルティも考慮しなければなりません。SLAでは、企業が約束した稼働率を満たせなかった場合、顧客に返金したり、クレジットを提供したりすることが義務付けられています。
9の法則と高可用性

IT業界では、可用性はシステムが稼働している時間の割合で測定されます。よく知られている「9の法則」は、許容できるダウンタイムの目安を示しています。
- 99%: 許容範囲内に見えるが、これは年間約87,6時間のダウンタイムに相当する。
- 99,9%: これにより問題は年間8,76時間にまで軽減されるが、それでも健全な財政バランスを保つには多すぎる。
- 99,99%: サーバークラスタとフェイルオーバーのおかげで、ダウンタイムは年間約52,6分にまで短縮されます。
- 99,999%: それは標準です フォールトトレランス年間ダウンタイムが5分を超えないこと。
- 99,99999%: 年間ダウンタイムが3,15秒未満というほぼ完璧な状態を維持するには、極めて堅牢なエンジニアリングが求められる。

ダウンタイムを最小限に抑え、対処するための戦略
単に待つことを避けるためには、企業は積極的なアプローチを採用する必要があります。最適なソリューションの1つがスマートアウトオブバンド(OOB)です。これは、メインネットワークとは独立してリモートデバイスの管理と監視を可能にし、問題発生現場に技術者を派遣する必要性をなくします。
ネットワークトラフィックの監視も非常に重要です。これには、複数の地域からユーザーエクスペリエンスをシミュレートし、顧客からの苦情が出る前にエラーを検出することが含まれます。ホームページだけでなく、ログイン、決済ゲートウェイ、APIなど、コンバージョンファネル全体を監視することが不可欠です。
インフラストラクチャを保護するための実践的な手順
インシデントの発生頻度と期間を短縮するために、以下のガイドラインに従うことをお勧めします。
- 単一障害点を排除する: システム全体を単一のサーバーやケーブルに依存させないようにしてください。
- 災害復旧計画: 混乱が生じた際に迅速に行動できるよう、明確かつ最新の指示書を用意しておくこと。
- MRO在庫管理: 重要な予備部品は手元に置いておけば、交換部品が届くまで何週間も待つ必要がなくなります。
- 旧式機器のアップグレード: 古い機械は故障しやすく、修理もより困難です。
- 厳格なバックアップ: 特にPLCやSCADAシステムでは、データの損失が工場全体の操業を麻痺させる可能性がある。
究極の鍵は、透明性のあるコミュニケーションにある。障害が発生した場合、関係者や顧客に速やかに情報を提供することで、評判へのダメージを軽減できる。外部監視、ハードウェアの冗長化、そして障害発生後の事後分析の文化を組み合わせることで、組織は脆弱なインフラストラクチャを、四半期ごとの利益を損なうことなく、あらゆる予期せぬ事態に耐えうる強靭なネットワークへと変革できる。