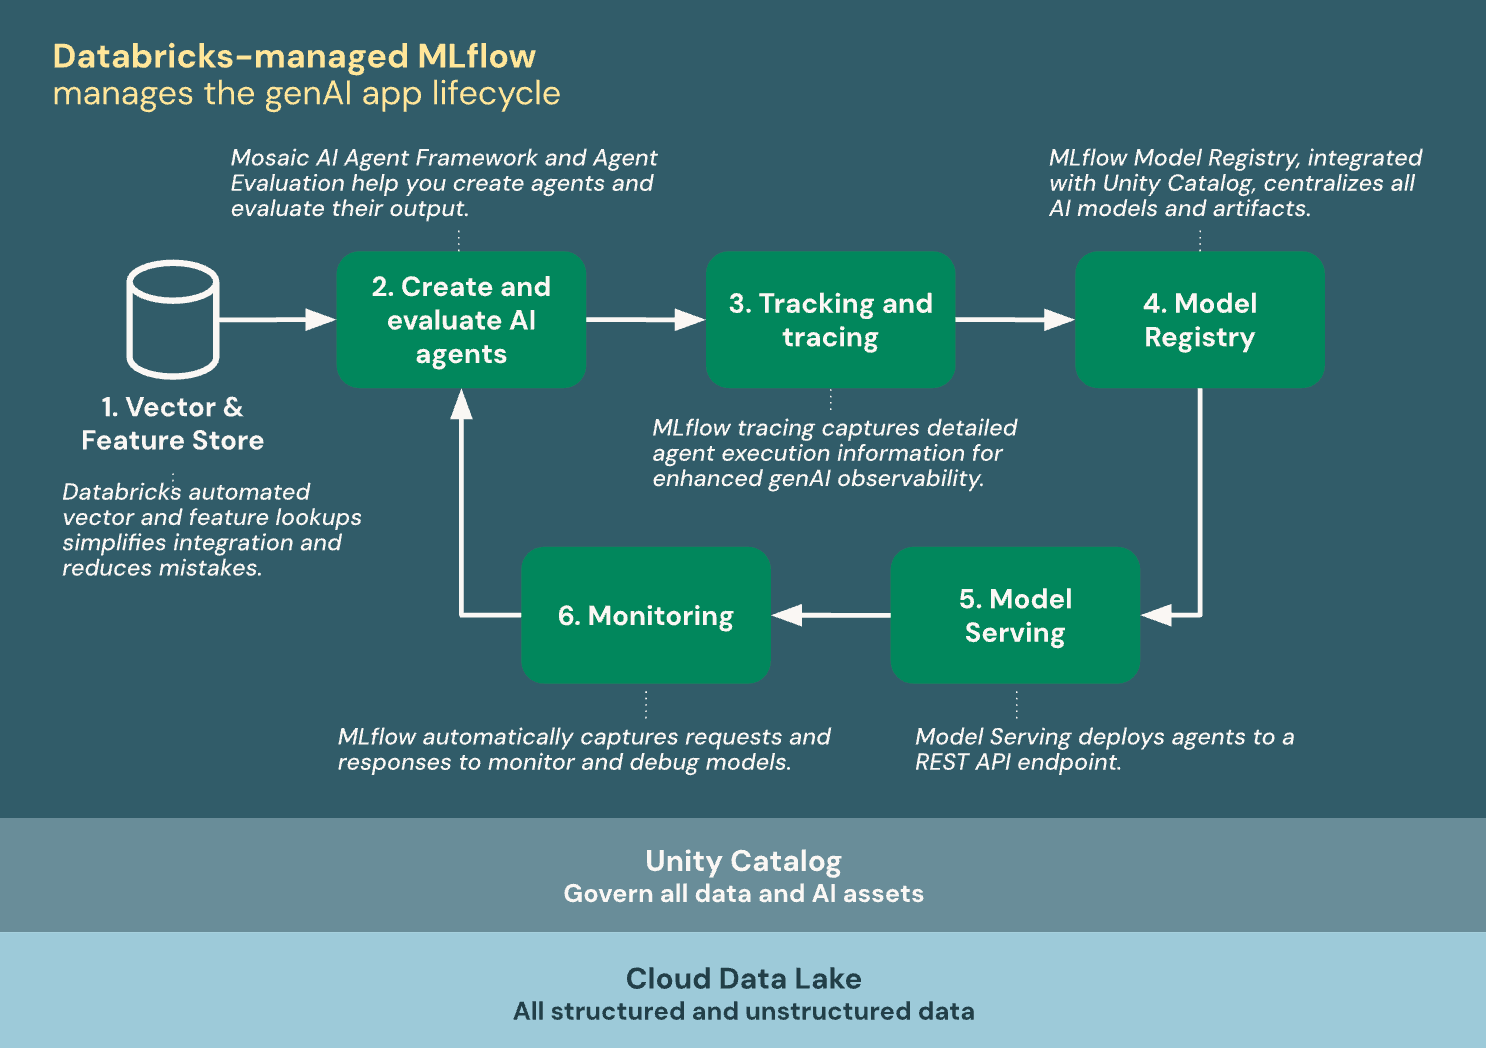
- Agent Bricks、AI Playground、MLflow は、Unity Catalog のガバナンスにより、プロトタイプからデプロイメントまですべてをカバーします。
- ResponsesAgent は、MLflow および AI Gateway と統合されたストリーミング、マルチエージェント、豊富なトレースを実現します。
- deploy() を使用してデプロイすると、リアルタイムの追跡とレビューが可能な安全なエンドポイントが作成されます。

Databricks で AI エージェントを構築することは、もはや高度な技術を持つ人だけの領域ではありません。AI Playground のようなビジュアル環境、Agent Bricks による自動化、MLflow フレームワークなどを活用することで、アイデアからプロトタイプ、そしてプロトタイプから本番環境へと、迷うことなくスムーズに移行できます。このガイドでは、ツールを呼び出し、データをクエリし、Unity Catalogガバナンスと統合するエージェントを作成、評価、デプロイするために必要なすべてを簡潔にまとめています。
ノーコードアプローチとPython開発について学ぶだけでなく、MLflow(ChatAgentとResponsesAgent)を使ったエージェントのパッケージ化、カタログへのリソース登録、リアルタイム監視の有効化、Model Servingを使ったスケーリングの方法も習得できます。さらに、ReactとFastAPIで構築されたサンプルアプリも含まれており、エージェントをエンタープライズWebインターフェースにシームレスに統合できます。
Databricks でエージェントを作成するためのオプション
スピードとシンプルさを重視するなら、Agent Bricksは高品質でドメインに適合したエージェントシステムを構築するための自動化されたワークフローを提供します。ユースケースを指定し、Unityカタログデータを接続するだけで、プラットフォームがエージェントのバリアントを生成し、評価に基づいて最適化を行い、組み込みのガバナンスとセキュリティ機能で改良を可能にします。
きめ細かな制御が必要で、使い慣れたライブラリを再利用したい場合は、Mosaic AI Agent FrameworkとMLflowを組み合わせたコードベースのアプローチが最適です。Pythonを使用すれば、エージェントロジックの定義、ツール呼び出しの有効化、詳細なトラッキングの実行、そして最終的にはDatabricksエコシステムを使用したパッケージ化と本番環境へのデプロイが可能です。
既にサードパーティ製のフレームワークを使用している場合は、LangGraph/ LangChain、LlamaIndex 、または独自のPython実装がネイティブでサポートされています。MLflowのモデルシグネチャとエージェントインターフェースのおかげで、ゼロから書き直すことなく、それらを評価および監視機能に組み込むことができます。
驚異的なスピードでプロトタイプを作成したいですか?AI Playgroundを使えば、モデルと仮想マシンを選択し、ローコードインターフェースを介してLLMにツールを追加し、チャットで検証できます。その後、エージェントを本番環境に対応したコードにエクスポートし、標準的な開発ライフサイクルを続行します。
モデル署名とプラットフォーム機能との互換性
Azure Databricks は、MLflow モデル署名を使用してエージェントの入力スキーマと出力スキーマを記述します。AI Playground や評価などの製品機能では、相互運用性を確保するために、エージェントがサポートされている署名のいずれかに準拠している必要があります。
エージェントを構築する際に推奨される方法に従うと、MLflow は追加の手順なしに互換性のあるシグネチャを自動的に推論します。そうでない場合は、実装がエージェントの入出力に関する従来のスキーマのいずれかのシグネチャに準拠していることを確認し、Databricks ツールとの統合時に予期せぬ問題が発生しないようにしてください。
クイックチュートリアル: Mosaic AI エージェントフレームワークを使用した最初のエージェント
目標は、 Databricks でホストされる LLM 組み込み関数などのツールを実行できる system.ai.python_exec UnityカタログからPythonコードを実行するためのライブラリを追加します。さらに、 MLflowによる追跡 トレースと診断を検査します。
基本的なワークスペース要件: エージェント機能を有効にし、 モデルサービングへのアクセスランタイム環境では、次のようなパッケージをインストールします。 mlflow, databricks-openai エージェントパッカー(databricks-agent o databricks-agents(従うガイドとバージョンによって異なります)、依存関係をロードするために Python を再起動します。
公開されている OpenAI クライアントを使用してモデル サービスへの接続を定義します。 ワークスペースクライアント、 アクティブ mlflow.openai.autolog() 自動計測のためのツールと利用可能なツールを記録します。その中には、 system.ai.python_exec これはステートレス Python インタープリターとして機能し、LLM がダイアログ中に計算を解決したりデータを操作したりできるようにします。
次のような関数で run_agent()ユーザーのプロンプトをチャットエンドポイントに送信します(例えば、次のようなモデルはデータブリックス-クロード-3-7-ソネット«可能な管理 ツールの呼び出し アシスタント メッセージとツール応答を一貫したリストで返します。
テストするには、コードを必要とするクエリ(例:100番目のフィボナッチ数を計算するクエリ)を実行し、ウィザードの出力と、関連するノートブックまたは実験に記録されたMLflowトレースの両方を確認してください。これにより、パッケージ化する前にオーケストレーションを洗練させることができます。
MLflow でパッケージ化され、Model Serving にデプロイされる
エージェントを本番環境に準備するための推奨方法は、インターフェースを実装することです。 MLflow チャットエージェント方法が必要です predict() メッセージを受け取り、エージェントロジックを呼び出し、 チャットエージェントレスポンス メッセージ リスト (該当する場合は、ツールに関連付けられた中間メッセージを含む)。
従属を容易にするために、すべてのコードを1つのPythonファイルに統合します(たとえば、 %%writefile quickstart_agent.py (ノートパソコンで作業している場合)。最後に、 mlflow.models.set_model() クラスのインスタンスを渡す(例: QuickstartAgent)を確立するために エントリーポイント 推論。
エージェントを登録する ユニティカタログ とともに mlflow.pyfunc.log_modelを含む リソース 実稼働時に必要となるLLMモデルのエンドポイント(例: DatabricksServingEndpoint)とエージェントが呼び出すカタログ関数(例: DatabricksFunction とともに system.ai.python_execしたがって、Databricksは 認証を構成する 展開時にこれらのリソースを使用します。
最後に、エージェントAPIを使用して Deplegar モデルをサービスエンドポイントに送信する: from databricks import agents y agents.deploy(model_name, model_version)エンドポイントが起動すると、 AI Playgroundからのチャット関心のある関係者と共有し、フィードバックの収集を開始します。
さらなる改善を目指すなら、Databricksはエージェントの品質測定、非構造化データ上での検索機能付きエージェント(RAG)の構築、複数ターンの会話の制御に関するガイドに加え、LangGraph、純粋なPython、OpenAIといった代替手段も提供しています。
ResponsesAgent: プロダクションエージェント向けの最新インターフェース
しかし チャットエージェント うまく機能し、MLflowは今日それを推奨しています レスポンスエージェント 本格的なエージェント向け。このインターフェースはスキームと互換性があります Responses OpenAIのエージェントの統合を可能にし、 あらゆるフレームワーク Databricks の機能 (登録、追跡、評価、展開、および監視) をスムーズに利用できます。
主な利点: ネイティブサポート sistemas マルチエージェント、終了モード ストリーミング、メッセージとツール呼び出しの完全な履歴、ツール呼び出しの確認、 長持ちするツール。 さらに、それは、 型付きインターフェース Pythonでは、自動署名推論、自動追跡 predict y predict_stream 推論テーブルの改善 AIゲートウェイ.
このアプローチのインストール要件: databricks-agents 1.2.0件以上, mlflow 3.1.3件以上 y Python 3.10以降 (Serverless または Databricks Runtime 13.3 LTS+ を使用)。Databricks では、以下のパッケージも推奨されています。 AIブリッジ 一般的な統合用。
便利な統合: databricks-openai (オープンAI)、 databricks-langchain (LangChain/LangGraph)、 databricks-dspy (DSPy)と databricks-ai-bridge (純粋なPythonエージェント)。これらのパーツを使えば、シンプルなエージェントから 複雑なパイプライン 回復とツールコール付き。
すでに組み込みエージェントがある場合は、それを継承するクラスでラップします。 mlflow.pyfunc.ResponsesAgent。 埋め込む predict 入力と出力を変換する ResponsesAgentスキーマストリーミングには、 predict_stream、放出 デルタ そして最後のイベント response.output_item.done 完全な回答を追加してください。
ストリーミングエラーに関しては、Mosaic AIは、最後のトークンとともに失敗を伝播します。 databricks_output.errorクライアントはそれを正しくキャプチャして表示し、 浄化体験.
回収システム、カスタム入力、トレーサビリティ
多くのエージェントは リサイクル業者 ベクトルインデックス上のRAGの場合。検索範囲が異なるスキームを公開している場合は、次のようにマッピングできます。 mlflow.models.set_retriever_schema宣言する primary_key, text_column, doc_uri そして他の列。AI Playgroundでは 情報源へのリンク 回復され、評価が適用される 関連性スコアラー 自動的に
エージェントが追加情報を必要とする場合(例: クライアントタイプ o セッションID)、使用 custom_inputs メタデータを返す custom_outputs チャット履歴を汚さないようにしましょう。AIプレイグラウンドとレビューアプリの両方で入力できます。 カスタム入力 UI から。
deploy() によるデプロイメント、要件、自動化されたアクション
Mosaic AI Model Servingにエージェントを公開するには、関数を使用します。 deploy() Python APIの。MLflow 3では、 mlflow >= 3.1.3 y databricks-agents >= 1.1.0 (ノートブック外でデプロイする場合)。MLflow 2.xでは、最小値は変更されます(たとえば、 mlflow >= 2.13.1 y databricks-agents >= 0.12.0確認する Unityカタログにエージェントを登録する 展開する前に。
に呼び出します deploy() スケーラブルなエンドポイントを構築する 自動バランス調整を設定し、 安全な認証 Databricksリソース(ベクターインデックス、カタログ関数)の所有者権限をチェックし、 審査申請 利害関係者との協力のため。
また、 MLflow でのリアルタイム監視(アクティブな実験と推論テーブルにトレースが記録される)も可能になります。MLflow 3 では、自動品質評価による本番環境監視を設定できます。REST リクエストとコメントは、最新のフィードバック API を使用して推論テーブルにログ記録されます。
カスタマイズするには、引数を渡す deploy() として scale_to_zero_enabled=True最初のリクエストのレイテンシは高くなりますが、ダウンタイム後のコストを削減できます。さらに、 リスト、取得、削除 エージェント API 経由のデプロイメント。
状態、構成、実行パターンのベストプラクティス
モデルサービングは分散されているので、避けてください ローカルキャッシュ 異なる返答が会話の異なる展開に対応できると仮定し、状態を再構成する。 辞書の ResponsesAgentRequest 各 predict そして、国家を設計する スレッドセーフ.
内部の状態を初期化する predict エージェントコンストラクタでは、単一のレプリカで複数のユーザーからの会話を処理できるため、 情報漏洩 高スループット環境における同時実行の競合。
エージェントの行動をパラメータ化する ModelConfig (辞書またはYAML)。例えば、次のように定義します。 model_serving_endpointLLMパラメータとプロンプトテンプレート。その構成を開発環境にロードし、本番環境にプロモートします。 コードに触れることなく.
エージェントサーバー上でイベントループや非同期フレームを導入することは避けてください。Databricksは並行処理を内部的に処理します。同期コードまたはコールバックを使用してください。そうしないと、 「このイベントループは既に実行中です」などのエラーや、予期しない動作が発生する可能性があります。
Agent Bricks: 価値を加速する「コード不要」の自動化
2025年に導入されたAgent Bricksは、コーディング不要のシームレスなエージェント作成ワークフローを提供します。タスクを自然言語で入力し、データを接続すると、プラットフォームがモデルを選択し、合成データを生成し、評価とプロセスの改善を行い、 Unity Catalogガバナンスを備えた本番環境対応のエージェントを提供します。
その利点としては、エンドツーエンドの自動化、Databricksにおけるスケーラビリティ(3日間非アクティブ状態が続くとエンドポイントをゼロまでスケールダウン可能)、Lakehouse上での使用状況とコスト分析、そしてすぐに使用できるエージェントの種類(情報抽出、カスタムLLM、ナレッジアシスタント、複雑なオーケストレーションのためのマルチエージェントスーパーバイザー)などが挙げられます。
制限事項としては、生成されたコードが現在ダウンロードできないため、詳細なカスタマイズが制限されること、またテンプレートカタログがLakehouseおよびUnity Catalogと既に統合されている組織向けに設計されていることが挙げられます。一部のユーザーは、コスト指標の粒度が不足していると感じています。
例: マルチエージェントとステートフルエージェント
公式ドキュメントには、OpenAI(DatabricksとOpenAIホスト型モデルの両方に対応したシンプルなチャットとツール呼び出し)、LangGraph(ツール呼び出し)、DSPy (ツール呼び出しを1ターンで行う)を使用したノートブックが掲載されています。これらは、カスタムツールや品質評価で機能を拡張するための優れた基盤となります。
複数の専門家を連携させるには、Genieなどのツールを使って協力システムを構築できます。また、会話の記憶機能に関心がある場合は、チェックポイントやチャットスレッドの永続化を可能にするステートフルエージェントがサポートされています。
公式ドキュメントには、OpenAI(DatabricksとOpenAIホスト型モデルの両方に対応したシンプルなチャットとツール呼び出し)、LangGraph(ツール呼び出し)、DSPy (ツール呼び出しを1ターンで行う)を使用したノートブックが掲載されています。これらは、カスタムツールや品質評価で機能を拡張するための優れた基盤となります。
Databricks 上のアプリ: React を使用した UI と FastAPI のバックエンド
Databricksアプリは、外部インフラストラクチャを構築することなく、豊富なインターフェースを提供する堅牢なプラットフォームです。Databricks SQL、 Unityカタログ、モデルサービング、ジョブとネイティブに統合され、プラットフォームのセキュリティおよびコンプライアンス制御を継承します。
非常に実用的なパターンとしては、 React(ストリーミング、メッセージレンダリング、Markdown UXをサポート)でフロントエンドを作成し、 FastAPIでエージェントエンドポイントへの橋渡し役となるバックエンドを作成する方法があります。バックエンドはユーザーのリクエストをモデルサービスにルーティングし、構造化されたレスポンスをクライアントに返します。
FastAPI では、サブアプリケーションのアセンブリ順序が重要です。 app.mount("/api", api_app) APIルートを指示する(例: /api/chat)そして、 app.mount("/", ui_app) Reactビルドの静的ファイルをルートディレクトリに提供します。このスキームは ルートの明確さ UI をエンドポイントから分離します。
環境変数を設定する(例: SERVING_ENDPOINT_NAME またはUnity CatalogのエージェントモデルのFQN)をDatabricksのアプリ定義から取得します。フロントエンド(npm run build)、ファイルの同期、依存関係の宣言(requirements.txt)で始まります ガンニコーン + ウビコーン ASGI の労働者。
実例:製造業務向けチャットボット
製造オペレーション管理(MOM)のシナリオでは、Databricksのチャットボットが、ボトルネック分析、在庫追跡、レポート作成などにおいて生産管理者を支援できます。機能はUnityカタログでツールとして公開され(SQLまたはPython経由)、エージェントはコンテキストに基づいてそれらを呼び出します。
例: 関数 identify_bottleneck_station Databricks SQLでクエリを実行して、最も遅延が発生するステージを検出します。 check_inventory_levelsリアルタイムの在庫情報を返します。エージェントはまた、 メールを送信する、レポートを作成し、感情分析を実行します。これらはすべてツール呼び出しによって調整されます。
モデルサービングエンドポイントをデプロイすると、標準のバックエンドとして機能します。Reactアプリはこのエンドポイントを利用し、洗練されたユーザーエクスペリエンスでリアルタイムのレスポンスを表示します。また、ResponsesAgentで有効にするとトークンストリーミングもサポートされます。
ChatCompletionsからの移行と互換性
既存のエージェントがOpenAIのChatCompletions APIを使用している場合、受信/送信メッセージを変換し、必要に応じてストリーミング差分をResponsesAgentStreamEventにマッピングするコンテナを使用してResponsesAgentに移行できます。これにより、コアロジックを書き換えることなく、テレメトリと可観測性を最新化できます。
デプロイメントの一覧表示と管理には、エージェントAPIを使用すると、既存のデプロイメントの一覧表示、特定のデプロイメントの取得(名前とバージョンによる)、不要になったエンドポイントの削除が可能です。外部リソースの認証情報は、環境変数とシークレットを使用して管理することを忘れないでください。
Databricksは、AI Playgroundによるアイデア創出やAgent Bricksによる自動化から、コード開発(Mosaic AI、MLflow、LangGraph、DSPy)、パッケージング、Unityカタログへの登録、deploy()によるデプロイ、そして本番環境の監視まで、包括的なソリューションを提供します。適切なモデル署名、分散環境におけるセキュアな状態管理、パラメータ化された構成といったベストプラクティスを活用することで、プラットフォーム上のWebアプリケーションに統合可能な、信頼性が高く、ガバナンスの取れたエージェントを提供できます。
