- Google TPU v7 Ironwood は第 7 世代の TPU であり、チップあたり 4.614 TFLOP FP8 と 192 GB の HBM3e を備え、推論時代向けに特別に設計されています。
- このアーキテクチャは、1,77 PB の共有メモリ、9,6 Tb/s ICI ネットワーク、および 10 MW 近くに最適化された液体冷却を備えたスーパーポッドで最大 9.216 個のチップまで拡張できます。
- Ironwood は Axion CPU とともに AI ハイパーコンピュータに統合されており、大規模な AI ワークロードのパフォーマンス、エネルギー効率、コストの強力なバランスを実現します。
- Anthropicとの大型契約と垂直統合戦略により、AIチップ市場におけるNvidiaの主要競争相手としてのGoogleの役割が強化されます。

人工知能の加速は、変革期を迎えています。もはや、大規模なモデルを訓練し、その性能を誇示するだけでは十分ではありません。今や真の課題は、AIのエネルギー消費量やインフラコストを急激に増加させることなく、何百万ものユーザーが毎日利用できるようにすることです。こうした状況の中、Google TPU v7 Ironwoodが登場しました。これは、単に応答するだけでなく、思考し、推論し、継続的に行動するAIのために設計されたハードウェアです。
Ironwoodは、 Googleの第7世代Tensor Processing Unit(TPU)であり、同社によれば、これまでで最もパワフルでスケーラブルかつ効率的なチップです。これは、いわゆる「推論の時代」に向けて設計されており、新しいモデルのトレーニングにかかる時間よりも、モデルを稼働させ、推論を続け、24時間体制で結果を生成するのにかかるコストが重要視されます。Google TPU v7 Ironwoodとは一体何なのか、何が特別なのか、そしてなぜNvidiaをはじめとする業界の巨人たちに衝撃を与えているのか、詳しく見ていきましょう。
Google TPU v7 Ironwood とは何ですか? なぜそれほど重要なのですか?
Ironwoodは、最先端の人工知能モデルを実行するためにGoogleが開発した、基本的にカスタムメイドのAIアクセラレータです。これは、機械学習ワークロード向けに特別に設計されたチップであるTensor Processing Unit(TPU)ファミリーに属しており、Googleの社内サービス(検索、YouTube、広告、翻訳など)を10年近く支えてきたほか、最近ではGoogle Cloudソリューションにも採用されています。
この第7世代は、これまでのTPUで蓄積されたすべての経験に基づいて構築されており、学習可能性を犠牲にすることなく、推論および複雑な推論タスクのパフォーマンスを最大化するという明確な目標を掲げています。大規模言語モデル(LLM)、エキスパート混合モデル、拡張リコールシステム、およびメモリ内に多くのコンテキストを維持する必要のあるAIエージェントは、 Ironwoodが処理するように設計されたワークロードの種類です。
Ironwoodは単に「より高速なチップ」というだけでなく、 Google CloudのAIハイパーコンピューターアーキテクチャに統合されています。このアーキテクチャでは、コンピューティング、ネットワーク、ストレージ、ソフトウェアが一体的に設計されています。これにより、シリコンからコンテナオーケストレーターに至るまで、あらゆるレベルで微調整が可能になり、電力とクロックサイクルを最大限に活用できます。
もう一つの重要な点は、Ironwoodが推論時代に向けてゼロから設計された初のTPUであるということです。これまで、ほとんどのAIシステムは主に大規模モデルのトレーニングを目的として設計されていましたが、今後は、単に反応するだけでなく、予測し、データを検索し、組み合わせ、結論を返すエージェントを用いて、それらのモデルを効率的かつ繰り返し実行することに焦点が移りつつあります。
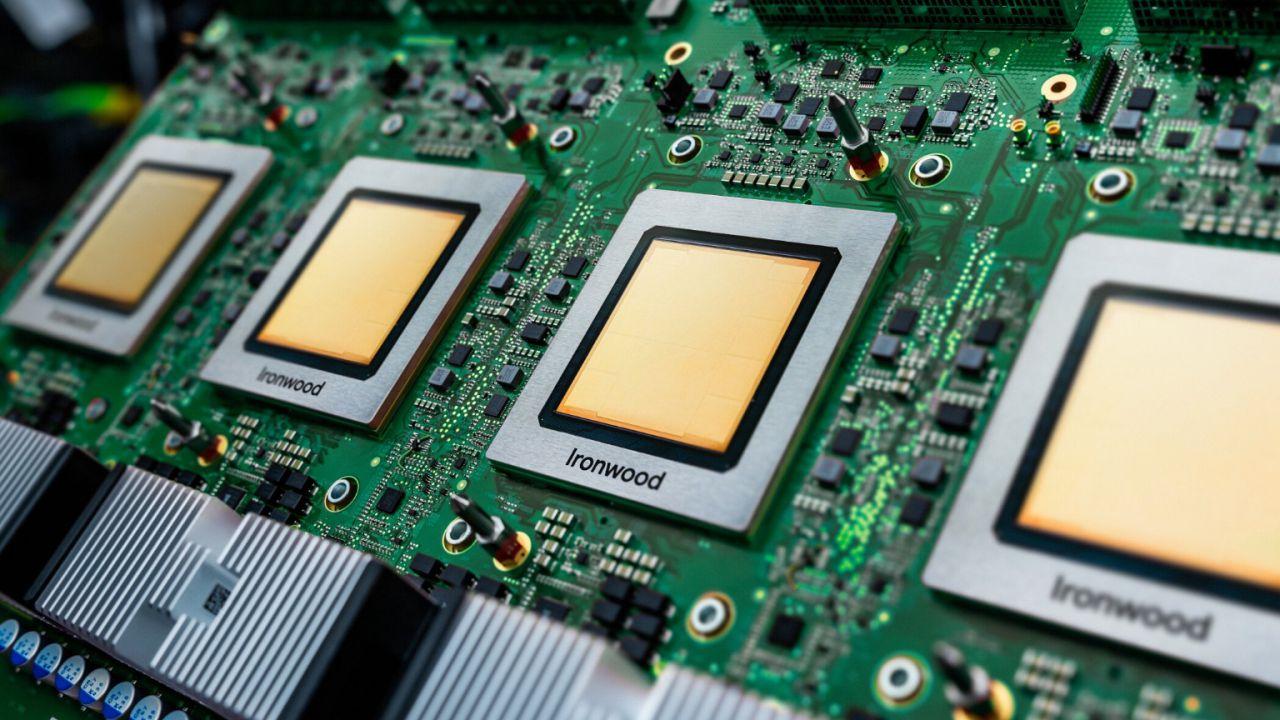
TPU v7 Ironwoodの主な技術的特徴
技術面では、IronwoodはAIチップのような競争の激しい市場においても、目覚ましい性能を誇っています。各チップは4.614テラフロップスのFP8精度演算能力を発揮し、これはTPU v4の16倍以上の演算能力であり、前世代と比較しても大きな飛躍となっています。
この膨大な処理能力を支えるため、各チップには次世代HBM3eメモリが192GB搭載されており、帯域幅は約7,3~7,4TB/sに達します。この高速演算とメモリの組み合わせこそが、巨大なモデルや非常に長いコンテキストをボトルネックなく処理することを可能にするのです。
Ironwoodは、高度な5ナノメートルプロセスを使用して製造され、チップあたり約600ワットを消費します。これは高く聞こえるかもしれませんが、ワットあたりの性能を比較すると、非常に競争力のある結果となっています。前世代のTrillium(TPU v6e)と比較すると、Ironwoodはワットあたりの性能が2倍になっています。
これらの改善は、トレーニングとサービスの両方の処理において顕著に現れます。トレーニングにおいては、Ironwoodは次世代モデル(GeminiやVeoなど)や他社製モデルの処理を高速化できます。また、サービスにおいては、AIデータセンターの消費電力がギガワット単位にまで達する現在、Ironwoodは大規模な推論をより低いエネルギーコストで実行することを可能にします。

チップからスーパーポッドまで:アイアンウッドのスケール方法
Ironwoodの真の魅力は、単一のチップにあるのではなく、AIスーパーコンピュータを構築するための拡張性にある。各Ironwood SoCは4つのチップを搭載したPCBA上に実装され、各ラックにはこれらのボードが16枚統合されているため、ラックあたり合計64個のチップが搭載されることになる。
そこからラックがグループ化され、アイアンウッド・スーパーポッドが形成されます。完全なスーパーポッドは144個のラックで構成され、これは相互接続された9.216個のチップに相当します。合計すると、約42,5エクサフロップスのFP8性能と約1,77ペタバイトの共有HBMメモリとなり、これらはすべてAIモデルのための膨大な論理リソースとして利用可能です。
チップ間の相互接続は、 3Dトーラス(4x4x4)設計で最大9,6Tb/sの速度を実現するICI(Inter-Chip Interconnect)ネットワークによって行われます。このトポロジーにより、システムが数千個のアクセラレータに拡張された場合でも、レイテンシを低減し、高い転送速度を維持できます。これは、分散トレーニングや高度に並列化された推論ワークロードにとって不可欠です。
スーパーポッドを超えて、インフラストラクチャは、 64個の接続されたチップのブロックを組み合わせ、最大1,8PB/sの光バックボーンでリンクすることで、さらに拡張できます。この受動銅ケーブル、光ファイバー、光スイッチの組み合わせにより、さまざまな顧客やモデル向けにカスタムクラスタを構成する際に、非常に高い柔軟性が得られます。
電力に関して言えば、この規模のシステムでは10メガワット近い電力容量が必要となるため、冷却と効率性を非常に重視する必要がある。各ラックは100kWを超える電力消費に対応するように設計されているため、システム全体が液冷と高度な電力分配を前提としてゼロから設計されている。

冷凍、消費、エネルギー効率
これほど驚異的な電力密度を誇るとなると、当然ながら疑問に思うのは、Googleはどのようにしてこれらすべてを熱的に制御しているのか、ということだ。その答えは、アイアンウッド・スーパーポッド専用に設計された最先端の液体冷却システムにある。
各ラックには、漏洩検知器と416V AC電源冗長性を備えた冷却液分配ユニット(CBU)が統合されています。この構成により、過熱を防ぐだけでなく、長時間の停止が数百万ユーロの損失や大規模なサービス中断につながる可能性のある重要なAIワークロードに対して、高い信頼性を提供します。
Ironwoodは、最もパワフルなシステムを目指すだけでなく、最も効率的なシステムの一つとなることも目指しています。Trilliumと比較して、TPU v7は消費電力1ワットあたりのパフォーマンスが2倍です。つまり、2024年のエネルギー予算が同じであれば、Ironwoodを搭載したデータセンターは2026年までに推論処理能力を最大2倍に向上させることができるということです。
このアプローチは、この分野における不都合な現実に対処するものです。すなわち、 AIの拡大を阻害する要因は、シリコンではなくエネルギーになりつつあるということです。多くの国の電力網は、主要なデータセンター地域で容量の限界に達し始めており、1ワットあたりからより多くの有用な作業を引き出すことは、もはや利点ではなく、必要不可欠なこととなっています。
さらに、Ironwoodのアーキテクチャは、分散システムにおける主要なエネルギー消費源である不要なデータ移動を最小限に抑えるように最適化されています。大容量HBMメモリと高速ネットワークの組み合わせは、まさにその目的、つまりデータに近い場所での処理と、データセンター内でのコストのかかるデータ転送の削減を目指しています。
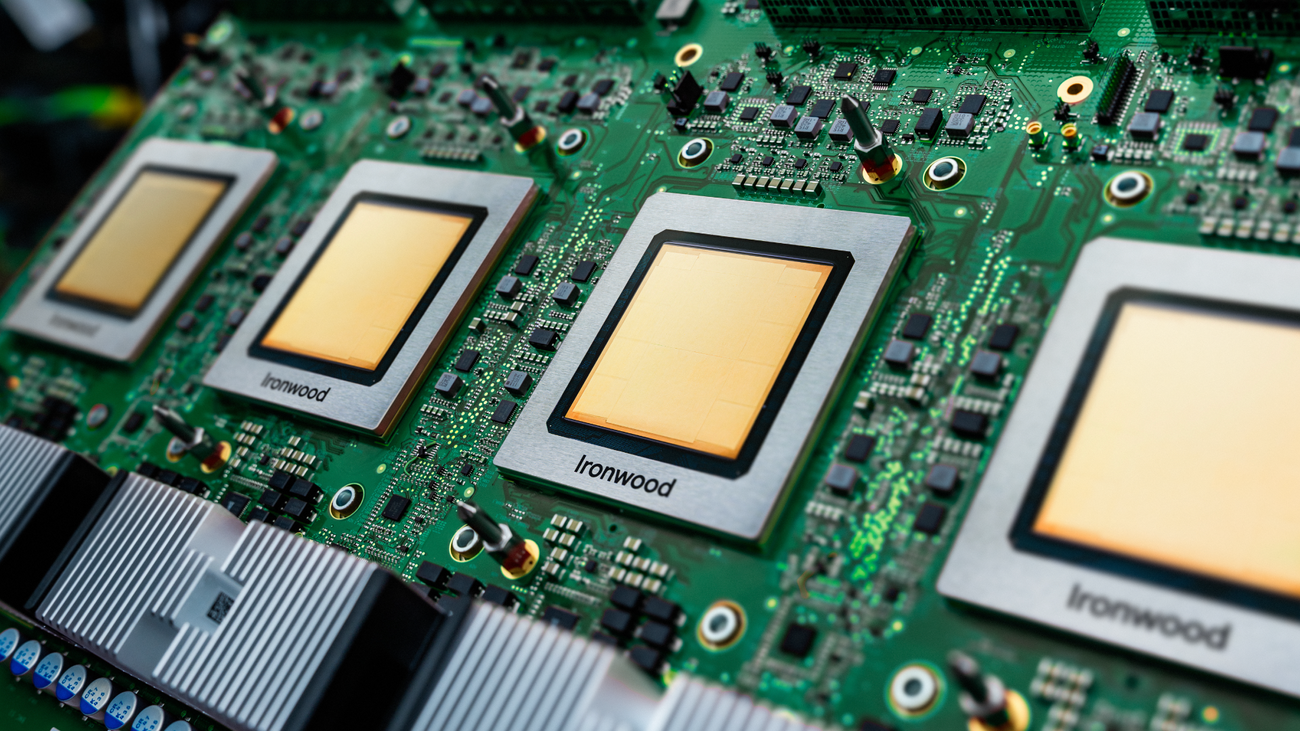
AIハイパーコンピュータとソフトウェア層におけるアイアンウッド
Ironwoodは単独で存在するものではなく、Google CloudのAIハイパーコンピューターアーキテクチャに深く統合されています。このコンセプトは、ハードウェア(Axion CPUとTPU)、高速ネットワーク、ストレージ、オーケストレーションおよびスケジューリングソフトウェアを単一の設計フレームワーク内に統合するものです。
ソフトウェア層では、GoogleはPathwaysスタックを採用しており、これにより数万個のIronwood TPUをあたかも単一の論理リソースであるかのように連携させることができます。Pathwaysに加え、MaxText(大規模なLLMトレーニング用)などのツールや、Cluster Directorを介したKubernetes Engineとの統合も強化され、クラスタのスケジューリングと耐障害性が最適化されています。
推論コンポーネントに関しては、GoogleはvLLMのサポートを拡張し、GPUとTPUの両方に対応させたことで、最小限のコード変更で異なるタイプのアクセラレータ間でモデルやワークロードを容易に移行できるようになりました。さらに、同社が公開したデータによると、GKE Inference Gatewayは初期リクエストのレイテンシを最大96%削減し、サービスコストを約30%削減できるとのことです。
つまり、顧客は高速なチップだけでなく、エンドツーエンドで最適化された完全なプラットフォームを手に入れることができるのです。実際、IDCはAIハイパーコンピューターの顧客について、3年間で353%の投資収益率を達成し、ITコストを約28%削減したと報告しています。
究極の目標は明確です。複雑なインフラストラクチャの管理に煩わされることなく、企業がIronwoodのパワーを活用できるようにすることです。理想的なユーザーは、自社のモデルとニーズを定義するだけで、Google CloudコントロールプレーンがTPU、Axion、ネットワーク、ストレージ、ソフトウェアをシームレスにオーケストレーションします。

「推論の時代」とアイアンウッドの役割
長年にわたり、AIに関する議論の多くは、ますます大規模なモデルのトレーニングを中心に展開されてきた。しかし、市場は厳しい現実に直面している。トレーニングがどれほど素晴らしいものであっても、持続的な収益は、日々大規模な推論を提供することから生まれるのだ。
Googleはこの新しい時代を「推論の時代」と呼んでいます。ユーザーが質問をするのを待つだけの受動的なモデルではなく、データを取得し、コンテキストを分析し、サブプロセスを調整し、自発的に推奨事項や処理済みの情報を提供するAIエージェントへと移行しつつあります。
Ironwoodは、複雑な推論、広範なコンテキスト、永続的な状態を持つモデルといった、まさにこのようなワークロード向けに設計されています。大容量の共有メモリとネットワーク帯域幅は、同じAIシステムの複数のコンポーネントがトラフィック過多に陥ることなく、協調的に動作することを可能にするためのものです。
このシナリオでは、GoogleはNvidiaとは異なる戦略を採用しています。Blackwellチップは最先端のトレーニングを牽引し続け、特定の構成では非常に高速な推論速度を実現すると謳っていますが、Googleは本番環境におけるモデルの継続的かつ大規模な実行を最適化することに注力し、ハードウェアとクラウドを単一の統合パッケージとして提供することを目指しています。
同社はNVIDIAを全面的に置き換えるつもりはなく、推論市場全体のシェアを拡大していくことを目指している。社内の試算によると、2027年までにGoogleのTPUは、特にGoogle Cloudを既に利用している大企業の間で、同市場の最大30%を占める可能性があるという。
アントロピックとの契約と商業的後押し
Ironwoodの商業的な飛躍のきっかけとなったのは、Claudeモデルの開発元であるAnthropic社だった。2025年10月23日、同社はGoogleと大規模な契約を締結し、最大100万個のTPUを使用し、Google Cloudのインフラに数百億ドルを投資することを約束した。
この契約では、2026年までに1ギガワットを超えるエネルギー消費量が見込まれており、これはAI分野の大手企業が事業を展開する規模の大きさを物語る巨大な数字である。アイアンウッドは一夜にして、ロードマップ上の野心的なプロジェクトから、強い需要に裏打ちされた本格的な投資へと変貌を遂げた。
Googleにとって、この契約は最大の懸念事項の一つ、つまり利用が保証されないままデータセンターの容量を構築するという問題を解決するものです。Anthropicを主要顧客とすることで、Googleは新たな施設、電力契約、そしてIronwoodスーパーポッドの展開について、投資収益率をより明確に把握した上で計画を立てることができます。
AnthropicがNvidiaの次世代TPUを待ったり、他のハイパースケーラーの独自ハードウェアに頼ったりするのではなく、Ironwoodを選択したことは、GoogleのTPUの効率性と市場投入までのスピードに対する自信の明確な表れである。「推論能力を高め、消費電力を抑える」というのが、この動きの暗黙のモットーと言えるだろう。
こうした長期契約は、グーグルが(チップ製造からエネルギー供給に至るまで)自社のコスト交渉をより有利に進め、AIコンピューティングの需要が供給をはるかに上回る市場における自社の地位を強化する上でも役立つ。
AIチップ市場への影響とNvidiaとの競争
Ironwoodの発売は、これまでNvidiaのGPUが圧倒的なシェアを占めてきたAIハードウェア市場において、まさにゲームチェンジャーとなるだろう。動きを見せているのはGoogleだけではない。AWSはTrainium2シリーズを推進しており、Microsoftも遅延はあるもののMaiaプログラムを進めている。
Nvidiaは、Hopper、Blackwell、そして今後登場するRubinアーキテクチャなど、ラックあたり数エクサフロップスの構成を目指す最先端のトレーニング分野で引き続きリードしている。しかし、Googleは、各ハイパースケーラーが独自のチップ、ネットワーク、ソフトウェア、クラウドサービスを設計する、複数の垂直統合型エコシステムというモデルへと市場を牽引している。
この新たな状況において、IronwoodはCUDAエコシステムに完全に依存することなく大規模な推論インフラストラクチャを求める企業にとって、確かな代替選択肢としての地位を確立しています。カスタムTPUとAxion CPU、そしてGoogle Cloudプラットフォームの組み合わせは、予測可能なコスト、パフォーマンス、可用性を必要とする企業にとって非常に魅力的なソリューションとなります。
この動きは、もはや唯一の選択肢ではなくなった環境下で高価格を正当化しなければならないNvidiaにもプレッシャーを与えている。Amazon、Microsoft、Googleが自社の技術スタックを強化するにつれ、市場は単一チップベンダーモデルから、各クラウドプロバイダー内で高度に最適化されたクローズドソリューションの寄せ集めへと移行しつつある。
しかし、IronwoodやTPU全般の成功は、GoogleのソフトウェアスタックがCUDAエコシステムと同じペースで成熟し続けるかどうかに大きく左右されるだろう。クラスタの利用率が低下した場合(例えば90%から70%に低下した場合)、全体的な効率が低下し、価格競争力にも影響が出る可能性がある。
Axion: AIインフラストラクチャ向けCPUアドオン
Ironwoodの発表と同時に、GoogleはArm NeoverseアーキテクチャをベースとしたカスタムCPUであるAxionファミリーを強化した。TPUは機械学習の最も負荷の高い部分を担う一方、AxionはAI関連の汎用ワークロードを処理する。
新しいN4Aインスタンスは、最大64個のvCPU、512GBのDDR5メモリ、50Gbpsのネットワーク帯域幅を提供し、同等のx86マシンと比較して最大100%の価格性能比向上を実現しています。一方、C4A Metalは、Android開発、自動車アプリケーション、高度なシミュレーションなどのシナリオ向けに設計された、Google Cloud初のArmベースのベアメタル版です。
Vimeoのような企業は、ビデオのトランスコーディングにおいて30%の改善を報告しており、ZoomInfoはデータ分析プロセスの効率が60%向上したと報告している。Riseなどの他の企業は、安定したレイテンシを維持しながら、コンピューティングパワーの消費を約20%削減したと主張している。
基本的な考え方は、Axionが汎用コンピューティングの基盤レイヤーとして機能することです。つまり、データ準備、マイクロサービス、Webサービス、ビジネスロジックなどを担います。その基盤の上に、Ironwood TPUは得意分野であるAIモデルのトレーニング、推論、および論理的思考の高速化に特化します。
この組み合わせは、次世代コンピューティングがハイブリッド型になるというビジョンを強化するものです。つまり、ワークフロー管理には効率的なCPU、集中的な計算処理にはTPU(またはその他のアクセラレータ)が用いられるということです。これらすべては、AIハイパーコンピュータプラットフォームとGoogle Cloudツールによって統合されます。
アルファベットの投資見通しとマージン保護
財務的な観点から見ると、Ironwoodは単なる高性能チップ以上の存在だ。クラウドAI事業におけるAlphabetの利益率を守るための戦略的な構成要素なのである。ハイパースケーラーは2027年までにギガワット級の電力容量を達成する見込みであり、インフラ投資は今後も巨額に及ぶと予想される。
Googleは自社でチップを設計することで、シリコン設計からクラウド展開まで、バリューチェーン全体で価値を獲得できる。利益率の低いサードパーティ製ハードウェアを再販するのではなく、設備投資(CAPEX)を競争優位性へと転換し、自社サービスの差別化を図るためのツールとして活用している。
Ironwoodのワットあたりのパフォーマンス向上により、データセンターの1メガワットあたりの推論処理能力が大幅に向上しました。vLLM、Pathways、GKE Inference Gatewayなどのソフトウェア最適化と組み合わせることで、Googleは収益性を損なうことなく、競争力のある価格設定を実現しています。
Anthropicとの契約は、Googleの設備投資計画にさらなる安定性をもたらす。インフラを「闇雲に」構築して顧客が来るのを待つのではなく、長期契約に基づいて拡張規模の大部分を決定できるようになり、不確実性や過剰設備のリスクを軽減できる。
とはいえ、未解決の疑問は依然として残っています。Googleが今後さらに多くの大手アンカークライアントを獲得できるのか、エネルギープロジェクトや新しい変電所の建設が予定通りに進むのか、そしてソフトウェアスタックの高い利用率を維持できるのか、といった点です。潜在力はありますが、Ironwoodが技術的な成功を収め、持続的な利益を生み出す原動力となるためには、実行力が鍵となります。これは投資アドバイスではありません。
総合的に見ると、Google TPU v7 Ironwoodは、スペックシート上のテラフロップス値をはるかに超える世代的な飛躍を表しています。膨大な共有メモリ、高度な光ネットワーク、液冷システム、そして高度に統合されたクラウドを組み合わせることで、24時間稼働する新たなAIエージェントとモデルの波を支えます。エネルギーが逼迫し、モデルが絶えず増大し、AIスタックの支配権をめぐる競争が激化する世界において、Ironwoodは「推論の時代」を到来させ、人工知能がグローバル規模でどのように、どこで、どのくらいのコストで実行されるかを再定義するために設計されたインフラストラクチャの中核として台頭しています。
