- ほとんどのRAIDシステム障害は、障害発生後の最初の数分間の性急な対応によって悪化する。
- 各RAIDレベルはデータとパリティの管理方法が異なり、それによって実際のリスクと復旧戦略が決まります。
- 専門家による介入は、ディスククローニング、仮想アレイ再構築、および高度な論理解析技術を組み合わせたものです。
- RAIDはバックアップに取って代わるものではありません。データの保護には、予防と適切な対応が不可欠です。
RAIDシステムに障害が発生した場合、最初の数分間が極めて重要です。障害発生後のいわゆる「ゴールデンアワー」と呼ばれるこの時間帯に、ほとんどの人的ミスが発生し、復旧可能な問題が取り返しのつかない大惨事へと発展してしまうのです。原因が分からないままディスクを無闇に交換したり、何度も再起動を繰り返したり、再構築を試みたりすることは、通常、データ損失へと至る最短ルートです。
なぜRAID復旧はこれほどまでにデリケートなのか?
多くの重大なインシデントにおいて、データ損失は最初のハードウェア障害ではなく、最初の1時間以内に行われた性急な対応によって引き起こされます。この期間は非常に重要です。ディスクの位置がずれたり、初期化プロセスが誤って開始されたり、再構築が強制されたり、システムが同じストレージアレイ上の不完全なバックアップから起動したりする可能性があり、かつては複雑ではあったものの対処可能だった問題が、ほぼ解決不可能な難題へと変わってしまうのです。
最も一般的なリスク状況としては、ディスクを誤った順序で交換すること(RAID 0、1、5、6、10など)、構成のクローン作成や文書化を行わずにコントローラを別のモデルに交換すること、実際の状態を分析せずにディスクを強制的に「オンライン」にすること、誤ったボリュームを初期化すること、または未完了のまま放置された再構築を開始してアレイの内部構造をさらに破損させることなどが挙げられます。
また、特に危険なのは、破損したシステムへのバックアップの直接復元、不安定なアレイを使用したVMware Storage vMotionタイプのストレージ移行、および回復可能な情報を含むディスクに新しいRAID構成メタデータを書き込む操作です。
RAIDアレイは、ほとんどの物理サーバー、NAS、SANシステムの基盤となるものですが、問題の原因がアレイ自体にあるかどうかは必ずしもすぐには分かりません。そのため、疑わしい場合は、ディスクへの書き込みをすべて停止し、状況を詳細に記録し、それ以上の変更を加える前にデータ復旧の専門家に相談するのが賢明です。
典型的な人的ミスと基本的な優良事例
RAIDシステムが劣化状態に陥ったり、1つ以上のディスクが故障したり、NASが起動しなくなったりした場合、本能的な反応として「何とか動くまで」あれこれ試してみたくなるものです。しかし、このやり方はほとんどの場合、問題を悪化させる結果となります。なぜなら、あらゆる操作がディスク上に痕跡を残し、まだ無事なパリティ、メタデータ、またはユーザーデータを上書きしてしまう可能性があるからです。
復旧を困難にする最も一般的なエラーとしては、同じコントローラとディスクを使用して新しいRAIDを構成したり、それらのディスクを別のストレージエンクロージャに挿入して「認識されるかどうか」を確認したり、ドライブベイの物理的な順序を変更したりといった操作が挙げられます。多くの場合、これらの操作によって元の構成が上書きされ、パリティストライプが破壊され、復旧の成功率が大幅に低下します。
もう一つよくある悪い習慣は、発生した事象を一切記録しないことです。複雑な障害が発生した場合、停電、システムメッセージ、ディスクの変更、再構築の試み、ファームウェアの更新など、すべての事象を時系列順に記録することが不可欠です。この情報は、専門の技術者が後々、状況を解明するのに役立ちます。
アレイ内の各ディスクの正確な位置を記録し、保存しておくことも同様に重要です。ディスクベイを「目視」で変更したり、故障したと思われるディスクを廃棄したりするのは無謀です。後でラボでRAIDを再構築する必要が生じた場合、どのディスクがどのスロットにあったかを把握し、元のディスク(交換したディスクも含めて)をすべて用意しておくことが、大きな違いを生む可能性があります。
一般的に、RAID障害が発生した場合は、以下の手順を実行する必要があります。コンピュータを停止し、何も再構成せず、すべてのディスクにラベルを付け、障害に関する情報をできるだけ多く収集し、データが重要な場合は、実験を続ける前に専門のデータ復旧サービスに連絡してください。
プロフェッショナルがRAIDシステム復旧に取り組む方法
RAIDデータ復旧を専門とする企業は、あらゆる技術的な判断においてさらなる損傷のリスクを最小限に抑える必要があるため、高度に体系化された手順に基づいて作業を行います。複数のディスクとテラバイト規模のデータが関係する典型的なケースでは、即興的な手順は大きな損失につながる可能性があります。
非常に分かりやすい実例として、12台のディスクと約12TBのデータを持つRAIDアレイが挙げられます。バックアップが適切に管理されていなかったため、唯一の有効な解決策は、専門のRAIDデータ復旧会社に連絡することでした。状況は緊急を要し、できるだけ早く運用を再開する必要がありました。再構成中に2台のディスクが故障したため、アレイはすでに危機的な状態に陥っていました。
このような場合、専門家は通常、まず正常に動作しているすべてのディスクをクローンし、常にオリジナルではなくコピーに対して作業を行います。同時に、ラボでの介入(クリーンルーム、ヘッド交換、ドナー機器の使用など)または高度な部分読み取り技術を用いて、物理的に損傷したドライブを可能な限り修復しようと試みます。
12TBドライブの場合、最大の問題は、RAID再構成が2回目の障害発生前に開始されていたため、コントローラが既に新しいパリティ値を部分的に再計算していたことでした。しかし、2台目のディスクがプロセスの初期段階で故障したため、古い論理構造の大部分がまだ復旧可能だったという利点もありました。
破損したディスクの1枚を復旧し、完全なコピーを作成した後、課題となったのは、ディスクの順序、ブロックサイズ、パリティの分布、処理途中の変更の可能性など、アレイの論理構造を手動で再構築することでした。この作業は数日かかることもありましたが、データの約90%を復旧することができました。状況を考慮すると、これはRAID復旧において高い成功率と言えるでしょう。
専門サービス:通常提供されるサービス内容と仕組み
RAIDデータ復旧を専門とする企業は、特に重要なサーバーや運用中のNASデバイス向けに、迅速かつ無料の診断サービスを提供しているのが一般的です。場合によっては、数時間以内に問題を評価し、実現可能性レポートと固定価格の見積もりを提供し、「復旧できなければ料金はいただきません」というポリシーを遵守することを約束しています。
一般的なサービスは、クライアントがRAID復旧のための無料見積もりを依頼することから始まります。この初期段階では、アレイの種類(RAID 0、1、5、6、10、JBODなど)、ディスクの数、ファイルシステム(ext4、Btrfs、XFS、HFS+、NTFSなど)、使用されているハードウェア(Synology NAS、QNAP、有名ブランドのサーバー、SANアレイなど)、およびこれまでに発生した症状と講じた対策の詳細な説明に関する情報が収集されます。
研究が承認されると、通常、会社は機器やディスクの無料回収を手配し、梱包に関する詳細な指示を示します。帯電防止材または緩衝材入りの包装材を使用し、機器を衝撃吸収材入りの頑丈な箱に入れ、輸送中にディスクが動かないようにし、申請番号を明記したラベルを貼付してください。
ラボに戻った技術者たちは、各ディスクの物理的および論理的な診断を行い、可能な限りビット単位のイメージを作成し、セクターの状態を評価し、RAIDを仮想的に再構築する方法を決定します。その後、復旧可能なデータの推定割合と概算の所要時間を含む最終的な見積もりが提示されます。
クライアントの承認が得られれば、実際の復旧作業が開始されます。専門家は、管理された環境でドライブを安定化させ、RAIDをセットアップした後、アクセス可能なファイルのリストを作成します。この時点までは、通常、クライアントは何も支払いません。リストの内容が問題ないと判断された場合にのみ、データは新しいストレージメディア(外付けハードドライブ、交換用NASなど)にコピーされ、送料込みでクライアントに返送されます。
基礎知識:RAIDの内部動作
RAIDシステムとは、簡単に言えば、複数の物理ディスクを単一の論理ユニットとしてオペレーティングシステムに認識させるシステムのことです。重要なのは、データの分散方法、そして場合によってはディスク間のパリティを設定することで、パフォーマンス、容量、耐障害性、あるいはこれらの組み合わせを向上させることです。
RAID技術では、データをストライプまたはブロックに分割し、複数のディスクに並列に書き込むことで、転送を統合してアクセス速度を向上させます。さらに、冗長データ(パリティ)を特定のレベルに保存することで、アレイ設計で規定された障害制限を超えない限り、サービスの中断なしに障害が発生したディスクからデータを再計算できます。
もう一つの重要な利点は、多くのシステムでディスクのホットスワップが可能なことです。これは、サーバーやストレージアレイをシャットダウンすることなく、故障したディスクを物理的に取り外して交換できることを意味し、システムが動作を継続している間に、コントローラがバックグラウンドで新しいディスク上に失われたデータを再構築できます。
すべての状況に適合する「完璧なRAIDレベル」は存在しません。各レベルは、パフォーマンス、セキュリティ、および使用可能な容量の間で異なるバランスを優先します。したがって、修復や復旧作業を試みる前に、どのような種類のRAIDが構成されているかを理解することが非常に重要です。
何らかの問題が発生した場合、RAIDは設計上の耐障害性を満たしていれば、通常はデータ自体を再構築できます。しかし、物理的、論理的、または人的な問題が連続して発生すると、アレイの整合性が失われ、自力で復旧できなくなるため、専門家の介入が必要になります。
一般的なRAIDレベルとその特性
各RAIDレベルは、ディスク間のデータ分散とパリティ管理の方法が異なり、障害発生時の動作に明確な違いが生じます。これらの違いを理解することで、実際の障害リスクと復旧成功の可能性を適切に評価することができます。
高性能で知られるRAID 0は、冗長な情報を一切保存することなく、データを少なくとも2台のディスクにストライプ状に分散します。つまり、各ファイルの一部がすべてのドライブに分散されているため、 1台のディスクが故障するとボリューム全体が失われます。最大の利点は速度ですが、データセキュリティの観点からは非常に脆弱です。
RAID 1(ミラーリング)は、2台のディスクに同一のデータコピーを保持します。片方のディスクが故障しても、もう片方のディスクは問題なく動作し続けます。シンプルで信頼性が高く、読み取り速度も良好ですが、使用可能な容量は1台のディスク分に相当するため、実質的には容量が犠牲になります。復旧時には、少なくとも1台のディスクが無事であれば、作業ははるかに容易になります。
RAID 3やRAID 4といった、今日ではあまり一般的ではないRAIDレベルも存在し、これらはデータディスクと専用のパリティディスクを組み合わせたものです。RAID 3では、データディスクへのアクセスは同時になるため、パリティディスクがボトルネックになる可能性があります。一方、RAID 4では、各データディスクへのアクセスがより独立して行えるため、特定のワークロードにおいてパフォーマンスが向上します。
RAID 5は、サーバーやNAS環境において最も広く使用されているRAID構成と言えるでしょう。複数のディスクにデータをストライプ状に分散させ、パリティブロックをすべてのドライブに分散配置することで、パリティ専用のディスクを1つだけ用意する必要がありません。この構成により、ディスクが故障した場合でも、交換用ディスクにデータを復旧することが可能です。ただし、復旧プロセス中に2つ目のディスクが故障しないことが前提となります。
RAID 6は、各データセットに2つのパリティブロックを保存することでセキュリティをさらに強化し、最大2台のディスクが同時に故障してもデータ損失を防ぐことができます。パリティのためにディスク容量と処理能力はより多く必要になりますが、その代わりに連鎖的な障害が発生した場合の許容誤差が大幅に大きくなり、大規模アレイでは非常に重要な機能となります。
これらの「定番」RAIDレベルに加え、RAID 10(ミラーリング+ストライピング)、RAID 50または60、そしてディスクを単純に連結して大容量ボリュームを形成するリニア構成やJBOD構成など、真の冗長性を持たない組み合わせも存在します。しかし、いずれの場合も、RAIDは適切に設計されたバックアップシステムに取って代わるものではありません。
典型的なRAIDシステムの障害と、復旧が複雑になる場合
RAIDシステムは堅牢性で定評があり、それは当然のことですが、問題とは無縁ではありません。実際には、物理的、論理的、そして人的なエラーが発生し、それらが複雑に絡み合うことで、復旧が困難な状況に陥ることがよくあります。
論理的な観点から言えば、最も深刻な障害の一つはパリティストライプの消失または破損です。データとパリティがディスク全体にどのように分散されているかを示すメタデータが劣化すると、RAIDは情報を自力で再生できなくなり、これらのストライプを手動または半自動で特定して再構築するには外部からの介入が必要になります。
ハードウェアに関して言えば、統計によると、あらゆるインフラストラクチャにおいて、毎年ごくわずかな割合のディスク(約2~3%)が物理的に故障する可能性がある。多数のディスクで構成されるアレイでは、少なくとも1台のディスクが故障する可能性は無視できない。機械的な故障、電力サージ、ファームウェアの不具合、極端な温度、または低品質のコンポーネントなどが、物理的故障の一般的な原因である。
再構築中に2つ目の障害が発生すると、特にRAID 5や多数のディスクを使用した構成では、問題がさらに深刻化します。システムが障害が発生したディスクからデータを再生している最中に、別のディスクで深刻なエラーが発生すると、アレイは劣化状態から完全にアクセス不能な状態に陥る可能性があります。想定される許容範囲を超える数のディスクが障害を起こすと、RAIDの内部ロジックではもはや対応できず、高度な復旧技術を使用する必要があります。
人為的ミスも問題の一因となります。既に警告が出ているディスクの交換を遅らせたり、コントローラーのアラームを無視したり、度重なる停電時にシステムを不適切にシャットダウンしたり、不適切なドライバーをインストールしたり、強制的に連続して再起動したり、最新のバックアップがないままメンテナンス手順を実行したりすることは、データ損失のリスクを大幅に高める行為です。
専門ソフトウェアの使用:R-Studioを用いた実践例
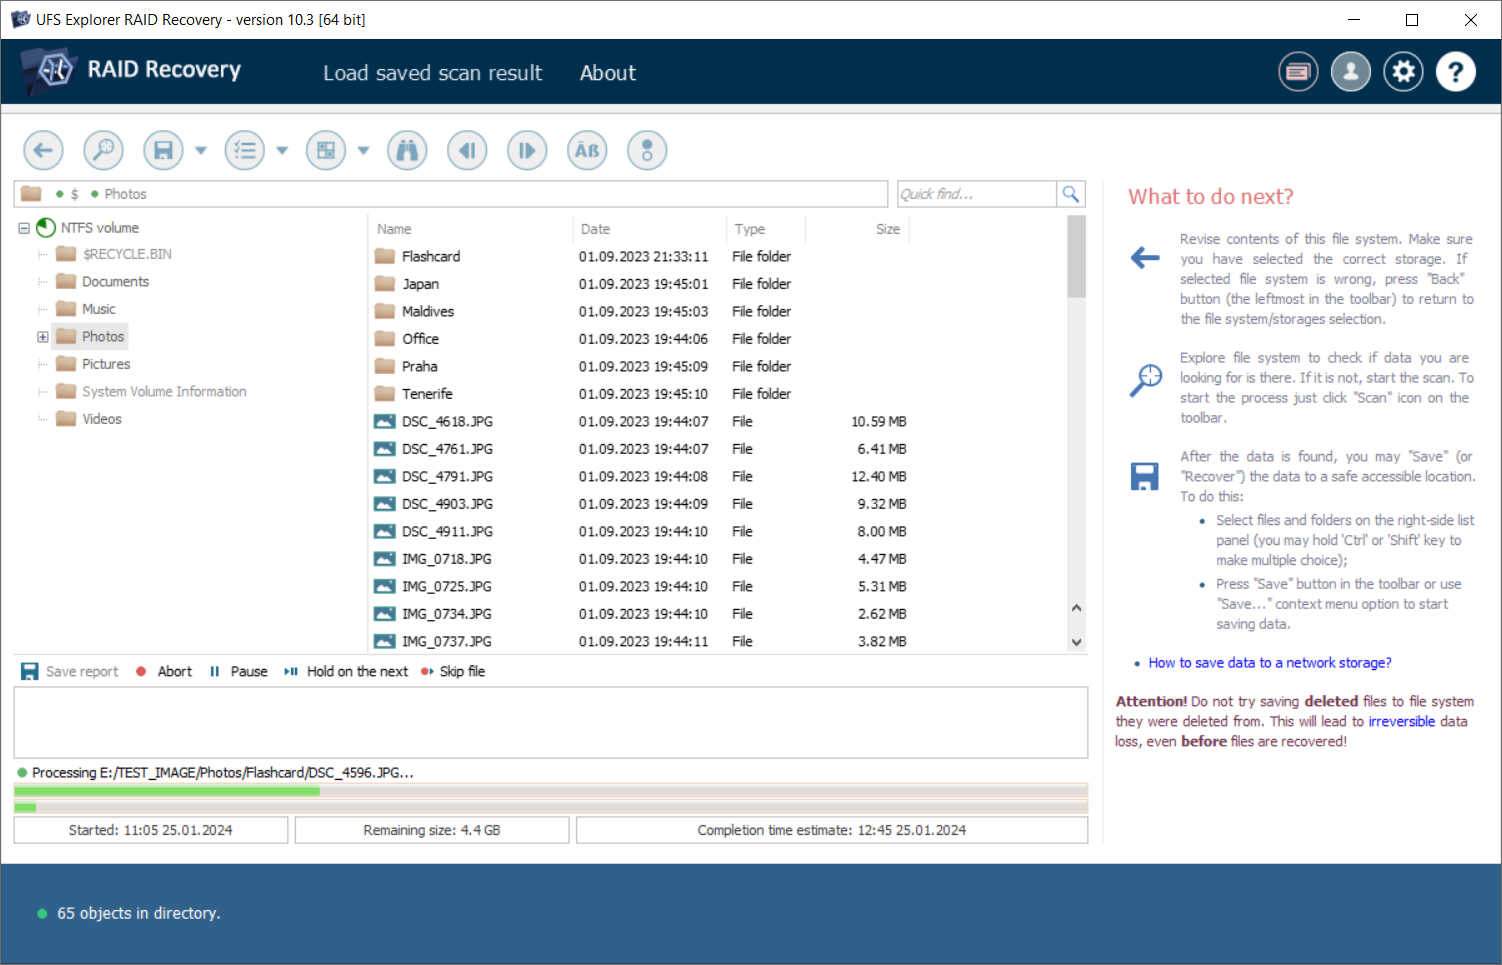
元のコントローラーからRAIDにアクセスできなくなった場合、技術的な選択肢の一つとして、専用ソフトウェアを使用して仮想的にアレイを再構築する方法があります。R-Studioのようなツールを使用すると、まだ整合性が保たれているRAIDを通常のボリュームとして検出でき、より深刻なケースでは、ディスクまたはディスクイメージから仮想RAIDを作成することもできます。
動作原理は、物理ディスクまたはそのイメージコピーに基づいて仮想RAIDアレイを作成することです。ディスク数、ブロックサイズ、開始オフセット、RAIDタイプ(0、1、4、5、6、10、JBOD、ZFS RAIDZ、RAIDZ2など)、ディスク順序などのパラメータを手動で入力します。ソフトウェアが有効なファイルシステムを検出すると、この仮想RAIDアレイはナビゲーション可能なボリュームとして表示され、そこからファイルを一覧表示したり復元したりできます。
例えば、3台のディスク、64KBブロック、非同期左パリティを備えたシンプルなRAID 5アレイの場合、3台のディスクを正しい順序で選択し、ブロックサイズを指定し、適切なオフセットを設定するだけで、ツールがパーティションを識別します。その後、ボリュームを開き、フォルダを調べ、ファイル(特に大きなファイル)をプレビューし、構造が正しくマウントされていることを確認できます。
4KBブロックとカスタムパリティパターンを使用したRAID 5のような複雑な構成では、ブロック順序テーブルを手動で定義する必要があります。これは、各データブロックまたはパリティブロックがどのディスクに格納されているかを、行ごとに入力し、順序が一貫していることを確認する作業です。ソフトウェアは、このテーブルに不整合が検出された場合、変更を適用する前に修正できるよう警告を表示します。
重要な注意点として、これらの仮想RAIDはソフトウェア内の純粋な論理オブジェクトであり、作成元のディスクには何も書き込みません。これにより、さらなる損傷のリスクを冒すことなくファイルシステムを正しく再構築できるパラメータの組み合わせが見つかるまで、さまざまな組み合わせを試すことができます。
物理ディスクが欠落している場合、一部のツールでは、それを「欠落ディスク」または空き領域に置き換えることで、劣化したRAIDの動作をシミュレートできます。しかし、ファイルの復元を確実に行うには、すべてのパラメータが正しい必要があります。ブロックサイズが1つでも間違っていたり、オフセットの計算が間違っていたりすると、抽出されたファイルが破損する可能性があるため、技術的な専門知識が重要になります。
RAIDの種類とデータ損失時の挙動
従来のRAIDレベルに加え、今日のRAIDシステムは、ハイブリッド構成やリニア構成など、多種多様な構成をサポートしています。これらの構成はそれぞれ、重大な障害発生後のデータ復旧において、特有の課題を抱えています。
RAID 0(純粋なストライピング)アレイでは、データは小さなグループに分割され、アレイ内のすべてのディスクに順番に書き込まれます。総容量はすべてのドライブの合計ですが、冗長性は一切ありません。いずれかのディスクが故障すると、ボリューム全体が使用不能になり、復旧するには、残存するディスクから可能な限りのデータを復元する高度な技術を用いるしかありません。
RAID 1は、ミラーリングされた各ディスク上のすべてのデータの同一のコピーを常に保持します。このシンプルさは、復旧プロセスにおいて大きな利点となります。なぜなら、いずれかのディスクが無事であれば、そのデータに独立したディスクであるかのように直接アクセスしたり、その内容を新しいドライブにコピーして後でミラーリングを再構築したりできるからです。
RAID 4やRAID 5のようにパリティの分散方法が異なるRAIDレベルでは、使用可能な容量は通常、すべてのディスクの容量の合計から1つのディスクの容量を差し引いた値になります。ディスク障害が連続して発生し、設計で許容されるよりも多くのディスクが失われた場合、パリティからディスクのデータを数学的に再構築する必要があるため、復旧が複雑になります。
リニア構成またはJBOD(Just a Bunch Of Disks)構成では、同じサイズまたは異なるサイズの複数のディスクをグループ化して、データを並列に分散することなく、単一の大きな論理ユニットを形成します。これらの構成では、パフォーマンスの向上や冗長性はほとんど得られません。いずれかのディスクが故障すると、ボリューム全体へのアクセスが失われます。このような場合、復旧には各ディスクの作業が必要となり、影響を受けていないセグメントから手動でコンテンツを再構築する必要があります。
これらのシナリオはすべて、ストレージ技術がどれほど高度であっても、外部バックアップと検証済みバックアップが依然として不可欠であることを示しています。RAIDは特定の障害発生時のダウンタイムを短縮または解消しますが、偶発的な削除、論理的な破損、マルウェア攻撃、ファイルシステムレベルで情報を破壊する構成エラーからは保護しません。
リスクを最小限に抑え、データを保護するための重要なヒント
まず最初に、当たり前のように思えるかもしれませんが、 RAID自体に依存しない定期的なバックアップポリシーを維持することをお勧めします。これには、サーバー、ワークステーション、スマートフォン、NASシステム、その他貴重なデータが保存されているあらゆるデバイスが含まれます。こうすることで初めて、深刻な障害が発生した場合でも、フォレンジックリカバリの成功に頼ることなくサービスを復旧できます。
万が一、データ障害が発生し、バックアップが利用できない場合は、手順とその潜在的な影響を十分に理解せずに、自己修復を試みるのは避けるのが賢明です。ファイルシステム修復ツールを実行したり、自動再構築を開始したり、ドライブをベイ間で交換したりする前に、データ復旧の専門家に相談し、状況を詳しく説明することをお勧めします。
また、障害の初期兆候にも注意を払うことが不可欠です。例えば、再割り当てセクタが表示され始めるディスク、アラートを生成するコントローラ、I/O警告を含むシステムログ、劣化状態としてマークされるストレージアレイなどです。怠惰さやサービス停止への恐怖からこれらの症状を無視すると、通常ははるかに深刻でコストのかかる障害の前兆となります。
最後に、データが貴重なものである場合は、事前に信頼できるデータ復旧業者を特定しておくことが賢明です。いざという時、直接連絡できる業者がいれば、対応時間が短縮され、最初から的確な指示を受けることができ、可能な限り多くのデータを復旧できる可能性が高まります。
数え切れないほどの事例で蓄積された経験から、適切なRAID設計、信頼性の高いバックアップ、障害発生時の冷静な対応、そして必要に応じた専門家によるサポートの組み合わせこそが、制御された危機と壊滅的なデータ損失との真の分かれ目となることが証明されている。