- Mikroarchitektūra apibrėžia, kaip CPU įgyvendina ISA ir lemia jo IPC, vidinį lygiagretumą ir faktinį efektyvumą, neskaitant dažnio ar talpyklos dydžio.
- Tokie dizainai kaip AMD Zen ir Zen 2 sujungia optimizuotas talpyklas, ne eilės tvarka vykdomą vykdymą, SMT ir didelius vektorinius blokus, kad padidintų našumą per ciklą ir vienam vatui.
- Lustų ir „Infinity Fabric“ strategija leidžia padidinti branduolių skaičių EPYC ir „Ryzen“ lustuose, išlaikant kontroliuojamas išlaidas ir labai konkurencingą našumą.
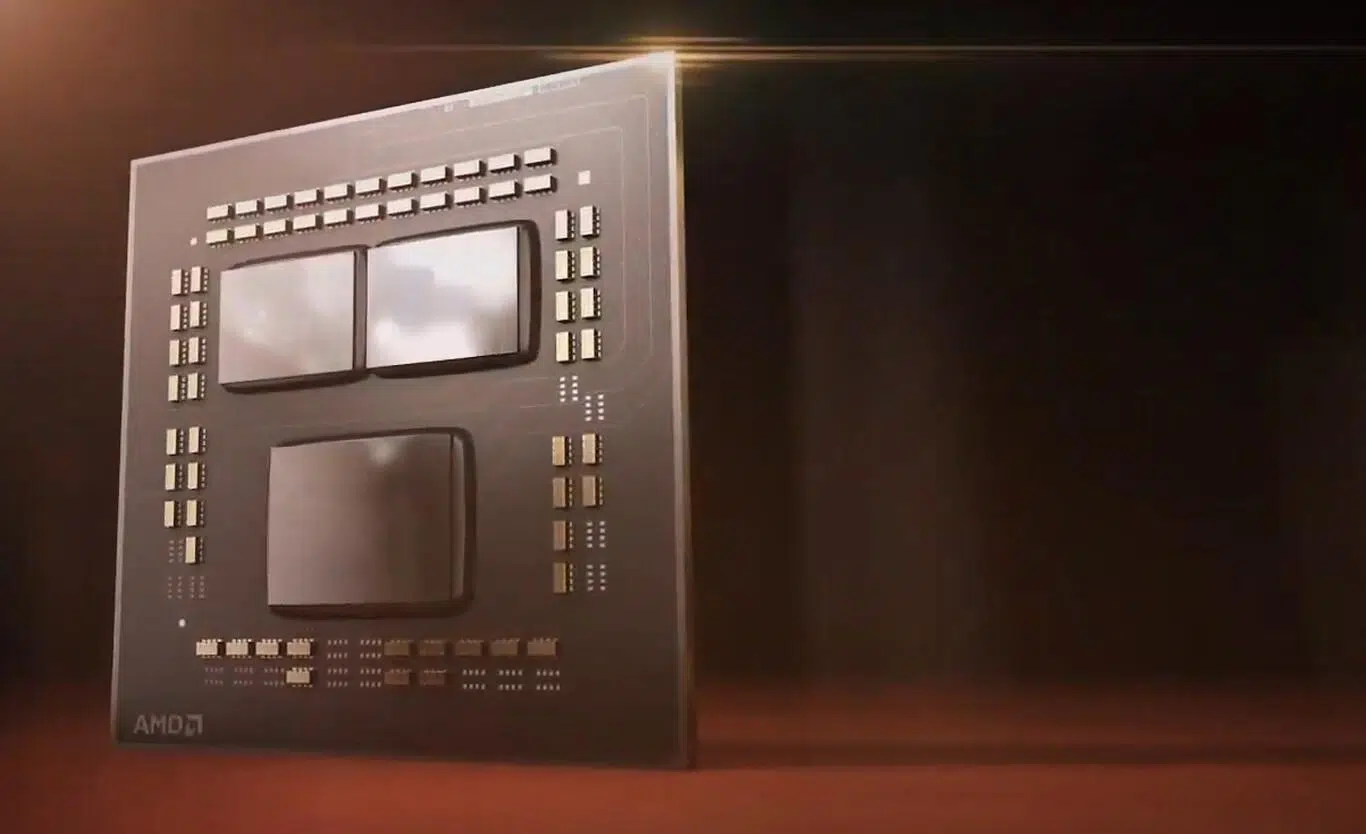
CPU mikroarchitektūra dažnai nustumiama į antrą planą, o tokie akį traukiantys skaičiai kaip GHz ar MB talpyklos, tačiau būtent ten, procesoriaus vidinėje konstrukcijoje, ir priklauso nuo tikrojo jo našumo, efektyvumo ir netgi kokios rūšies programinė įranga gali geriausiai tuo pasinaudoti.
Kai skaitote technines specifikacijas, kuriose minimi branduoliai, gijos, L3 talpykla arba AVX2 , iš tikrųjų matote konkrečias konkrečios mikroarchitektūros pasekmes. Supratimas, kaip šie komponentai yra organizuoti viduje, kuo „Zen 3“ skiriasi nuo „Zen 2“ arba hibridinis „Intel“ skiriasi nuo klasikinio „Ryzen“, yra labai svarbus norint išmintingai pasirinkti kitą procesorių ir žinoti, kodėl vieni puikiai veikia žaidimuose, kiti – atvaizdavime, o dar kiti – serverio užduotyse.
ISA, makroarchitektūra ir mikroarchitektūra: sąvokų tvarkos suvedimas
Prieš pradedant gilintis į sudėtingą duomenų srautų ir prognozavimo priemonių veikimą, naudinga atskirti tris dažnai painiojamus lygius: sistemos makroarchitektūrą, ISA ir mikroarchitektūrą . Kiekvienas iš jų apibūdina skirtingą kompiuterio sluoksnį.
Viena vertus, yra makroarchitektūra arba bendras sistemos dizainas , apimantis viską, ką matote pagrindinėje plokštėje: procesorių, atminties valdiklius, magistrales, pagrindinę atmintį, įvesties / išvesties lustus, atminties valdiklius, bet kokius išorinius greitintuvus ir DMA logiką. Tai bendras vaizdas, kaip jungiasi dideli aparatinės įrangos komponentai ir kaip tarp jų teka duomenys.
Virš jo yra ISA (instrukcijų rinkinio architektūra) – tai instrukcijų rinkinys, kurį supranta procesorius: apdorojamų duomenų tipai, žodžių dydis, registrų skaičius ir tipas, adresavimo režimai, instrukcijų formatai ir kt. Kai programuojate asemblerio kalba naudodami mnemoniką, tokią kaip ADD, SUB, MUL , arba iškviečiate plėtinius, tokius kaip SSE, AVX arba NEON, jūs tiesiogiai bendraujate su ISA.
Galiausiai turime mikrokodą arba μISA , kuris apibrėžia vidines mikrooperacijas, kurias kai kurios sudėtingos architektūros (pvz., x86) naudoja savo CISC instrukcijoms įgyvendinti. Šį mikrokodą galima atnaujinti naudojant programinę-aparatinę įrangą, kad būtų ištaisytos klaidos arba pridėtas naujų instrukcijų palaikymas.
Kas tiksliai yra procesoriaus mikroarchitektūra?
CPU mikroarchitektūra iš esmės yra vidinis planas, kuris nustato, kaip vykdomos ISA instrukcijos ir kaip duomenys juda luste. Du procesoriai gali dalytis tuo pačiu ISA (pavyzdžiui, AMD64 „Intel“ ir AMD), tačiau jų elgesys ir našumas gali radikaliai skirtis dėl – arba galbūt dėl – jų mikroarchitektūros.
Šis projektas apima tokius elementus kaip valdymo bloko tipas , ar naudojamas programuojamas mikrokodas, ar aparatinė logika; atminties hierarchija; konvejerio gylis; kiek funkcinių blokų veikia lygiagrečiai; ir ar procesorius gali vykdyti instrukcijas ne eilės tvarka ir spekuliatyviai.
Be to, projektuotojas turi pasirinkti konvejerio gylį : nuo paprastų procesorių be konvejerio, kur kiekviena instrukcija yra apdorojama nuo pradžios iki pabaigos prieš pradedant kitą, iki modernių dizainų su daugybe etapų (gavimas, dekodavimas, pervadinimas, išsiuntimas, vykdymas, įrašymas atgal, pašalinimas iš darbo...), kurie leidžia vienu metu vykdyti dešimtis instrukcijų.
Su tuo susijęs vykdymo vienetų skaičius ir tipas : ALU sveikiesiems skaičiams, daugybos vienetai, dalikliai, FPU skaliariniams ir vektoriniams slankiojo kablelio skaičiams, AGU (adresų generavimo vienetai) atminties adresams apskaičiuoti, šuolių vienetai ir kt. Jei yra keli to paties tipo vienetai, kalbame apie superskaliarinius procesorius, galinčius išsiųsti kelias instrukcijas per ciklą.
Tai yra pažangių metodų, tokių kaip spekuliacinis vykdymas , pagrindas , kai CPU numato šakos išsprendimą ir iš anksto vykdo instrukcijas iš vienos iš šakų. Jei prognozė teisinga, sutaupoma laiko; jei ji nepavyksta, atliktas darbas išmetamas ir konvejeris ištuštinamas su atitinkama bauda.
Dauguma šiuolaikinių didelio našumo procesorių taip pat naudoja ne eilės tvarkos (OoO) vykdymą . Užuot griežtai laikęsis programos tvarkos, procesorius viduje pertvarko instrukcijas ir pirmiausia vykdo tas, kurių duomenys yra paruošti, vengdamas prastovų ciklų, kol kiti laukia atminties arba ankstesnių operacijų rezultato.
Kad visa tai veiktų nepažeidžiant programos semantikos, naudojamas registrų pervadinimas . Kompiliatorius mato ribotą loginių registrų rinkinį, tačiau mikroarchitektūra juos paverčia didesniu fizinių registrų banku, dinamiškai priskirdama naujas paskirties vietas, kad būtų nutrauktos klaidingos priklausomybės ir užtikrintas didesnis lygiagretumas.
Galiausiai, projektuojant galima sutelkti dėmesį į lygiagretumo pridėjimą branduolio ir gijų lygmenyje . Tai apima viską – nuo vieno branduolio procesorių iki lustų su dešimtimis ar šimtais branduolių (daugelio branduolių), daugiaprocesorių sistemų su keliais lizdais, sujungtais didelės spartos tinkliniais tinklais („Infinity Fabric“, „Intel Mesh“, „NVLink“ ir kt.), ir vienalaikio daugiasriegiškumo (SMT) palaikymą, kad kiekvienas fizinis branduolys galėtų apdoroti dvi ar daugiau loginių gijų.
Suderinamumas, ISA ir mikroarchitektūrų šeimos
Kadangi mikroarchitektūra yra tik vienas konkretus ISA įgyvendinimas , vienas ISA bėgant metams ir skirtingų gamintojų gali turėti dešimtis skirtingų mikroarchitektūrų. Būtent tai ir nutinka su x86-64/AMD64 arba ARM.
Žvelgiant vien tik į AMD AMD64 ISA kontekste, randame tokias skirtingas šeimas kaip K8/Hammer, K10, Bulldozer ir visa Zen serija („Zen“, „Zen+“, „Zen 2“, „Zen 3“, „Zen 4“...). Jie visi vykdo tą patį pagrindinį instrukcijų rinkinį, tačiau jų vidinė organizacija, talpyklos, konvejeriai ir lygiagretaus vykdymo metodai yra visiškai skirtingi.
Kai keičiame ISA, suderinamumo šuolis yra absoliutus. ARM A64 pagrindu sukurtas procesorius (pvz., „Apple Silicon“) negali paleisti x86-64 kompiliuotų dvejetainių failų ir atvirkščiai, nebent naudojamas vertimo ar emuliacijos sluoksnis, pvz., „Rosetta 2“, „QEMU“ ar panašus, su atitinkamomis našumo sąnaudomis.
Net ir tarp procesorių, kurie dalijasi ISA, nėra garantijos, kad jie visi palaikys tą patį instrukcijų rinkinį ar plėtinius. Senesnėje mikroschemoje gali trūkti AVX2 arba AVX-512, arba ARM SoC gali įgyvendinti tik dalį pasirenkamų plėtinių. Todėl dvejetainis failas, kuris intensyviai naudoja AVX-512, gali nepavykti paleisti procesoriuje, kuris siūlo tik SSE4.
Kompiliuojant programinę įrangą, įprasta generuoti bendrinius dvejetainius failus konkrečiai ISA šeimai (pavyzdžiui, x86-64 su bent SSE2), visiškai neišnaudojant jokios konkrečios mikroarchitektūros, kad vykdomasis failas veiktų kuo daugiau procesorių. Tačiau jei kompiliuojate su derinimo vėliavėlėmis konkrečiai mikroarchitektūrai (-march=znver3, -mtune=skylake ir kt.), galite žymiai pagerinti našumą toje konkrečioje šeimoje, tačiau prarandate suderinamumą su kitomis.
ISA licencijos ir dizaino intelektinė nuosavybė
Licencijomis apsaugotas ne tik programos kodas: ISA ir mikroarchitektūros taip pat yra intelektinė nuosavybė. Niekas negali legaliai klonuoti x86 ar AMD64 ISA be licencijos, lygiai taip pat, kaip patentuoto procesoriaus dizaino negalima kopijuoti be leidimo.
ISA srityje yra trys pagrindiniai metodai. Viena vertus, yra uždari ISA , kur savininkas griežtai kontroliuoja, kas gali įdiegti suderinamus branduolius. Klasikinis pavyzdys yra IA-32 (x86-32), istoriškai priklausęs „Intel“, kuris suteikė licencijas AMD, VIA ir kitoms kompanijoms, ne be teisinių ginčų.
Panaši situacija yra ir su AMD64/x86-64 , kurį iš pradžių sukūrė AMD, o vėliau pagal kryžminio licencijavimo sutartis licencijavo „Intel“ (kuri jį pavadino EM64T). Kiti rinkos dalyviai, pavyzdžiui, „Hygon“ Kinijoje, taip pat įsigijo licencijas konkrečioms versijoms (pavyzdžiui, „Zen 1“ Kinijos rinkai).
Taip pat turime ISA su lanksčiu licencijavimu , kur savininkas siūlo ir ISA licencijas, ir paruoštus integravimui IP branduolius. Čia tinka ARM, SPARC arba OpenPOWER: galite sumokėti už „Cortex A/M/R“ arba „Neoverse“ naudojimą tokį, koks jis yra, arba už licenciją, kuri leidžia jums kurti savo mikroarchitektūras ISA pagrindu, kaip „Apple“ daro su savo M1/M2/M3 arba „Qualcomm“ su savo „Kryo“.
Galiausiai, yra atvirojo kodo ISA , kur kiekvienas gali kurti suderinamas mikroarchitektūras nemokėdamas autorinių atlyginimų už ISA (nors gali patentuoti arba uždaryti savo įdiegimą). Geriausias pavyzdys yra RISC-V: ISA yra pagal leidžiamąją BSD licenciją, o yra įvairių variantų – nuo visiškai atvirų branduolių „Verilog“ ar „Chisel“ kalbomis iki uždarų komercinių dizainų.
Be ISA, kiekviena konkreti mikroarchitektūra („Zen 4“ branduolys, „Cortex X4“, GPU dizainas ir kt.) yra patentuotos arba registruotos intelektinės nuosavybės blokas. Čia taip pat yra atvirų dizainų, publikuojamų kaip minkštieji branduoliai HDL terpėje, skirti sintezei FPGA arba integracijai į individualius SoC.
Gilinimasis į šiuolaikines mikroarchitektūras: AMD Zen korpusas
Norint pamatyti, kaip visa tai virsta realiu našumu, nėra nieko geriau už konkrečios produktų šeimos analizę. AMD smarkiai pakeitė savo verslą dėl „Zen“ ir jo vėlesnių iteracijų , pereidama nuo sudėtingos „Bulldozer“ eros ir senų FX procesorių prie konkuruojančių (o kartais net lenkiančių) „Intel“ stalinių, serverių ir nešiojamųjų kompiuterių rinkose.
Po „AMD Fusion“ strategijos nesėkmės bendrovė restruktūrizavosi ir pasirinko didelio našumo dizainą, kuriam vadovavo, be kita ko, Jimas Kelleris. „Zen“ plano tikslas buvo agresyviai padidinti IPC (instrukcijas per ciklą), palyginti su „Bulldozer“, pagerinti našumą vienam vatui ir susigrąžinti pozicijas vieno branduolio našumo srityje, kur „Intel“ daugelį metų pirmavo.
Vienas iš pagrindinių pakeitimų buvo priekinės dalies, atsakingos už instrukcijų gavimą ir paruošimą, sustiprinimas. „Zen“ pristatė mikrooperacijų talpyklą , kurioje saugomos jau iššifruotos mikrooperacijos, panašiai kaip tai darė kai kurios „Intel“ mikroarchitektūros, tokios kaip „Conroe“. „Bulldozer“ šios talpyklos trūko ir labiau rėmėsi klasikine instrukcijų talpyklos hierarchija, o tai neigiamai paveikė jos pralaidumą.
„Zen“ dekoderis gali konvertuoti iki keturių CISC x86-64 instrukcijų per ciklą į RISC tipo mikrooperacijas. Šios mikrooperacijos tada patalpinamos į eilę, kurią maitina mikrooperacijų buferis, kuris savo ruožtu gali išsiųsti iki šešių mikrooperacijų per ciklą į galinius planuoklius. Čia prasideda ne eilės tvarka vykdomos instrukcijos.
AMD aiškiai atskyrė sveikojo ir slankiojo kablelio kelius . Sveikojo skaičiaus pusėje ALU, AGU ir įkėlimo/įrašymo logika maitinami iš mikro-operacijų eilės. Ši logika gali atlikti du 16 baitų įkėlimus ir vieną 16 baitų įkėlimą per ciklą iš 32 KB, 8 kanalų L1D su įrašymo atgal politika.
Slankiojo kablelio ir vektorinė pusės maitina FMAC ir AVX įrenginius. Turėdama du daugybos ir du sudėties prievadus, „Zen“ gali vienu metu vykdyti dvi 128 bitų FMA operacijas arba vieną 256 bitų AVX operaciją per takto ciklą. Šis instrukcijų lygio lygiagretumas yra vienas iš pagrindinių jo puikaus našumo veiksnių esant intensyviems skaičiavimo krūviams.
Talpyklos hierarchija, TLB ir atminties organizavimas „Zen“ programoje
„Zen“ atminties hierarchija yra suskirstyta į tris talpyklos lygius: atskirą L1 instrukcijoms ir duomenims, privatų L2 kiekvienam branduoliui ir bendrą L3 . Nors ji paveldi pagrindinę ankstesnių mikroarchitektūrų struktūrą, dydžiai, asociatyvumas ir politikos buvo patobulinti.
L1I (instrukcijų talpykla) siūlo 64 KB kiekvienam branduoliui su 4 asociatyviais keliais, padvigubindama kelių skaičių viename modulyje, palyginti su „Bulldozer“, ir sumažindama konfliktus. L1D ( duomenų talpykla) padidinta iki 32 KB, 8 kelių ir atgalinio įrašymo politikos, palyginti su „Bulldozer“ 16 KB, 4 keliais ir įrašymo perdavimu, o tai žymiai pagerina tiek paspaudimų dažnį, tiek įrašymo efektyvumą.
L2 talpykla įdiegta kaip 512 KB kiekvienam branduoliui ir 8 krypčių, vietoj ankstesnės kartos 2 MB, bendrinamų kiekvienam moduliui 16 krypčių. Tuo tarpu L3 talpykla siūlo kelis MB kiekvienam branduolio rinkiniui su 16 krypčių asociatyvumu, veikiančiu kaip paskutinis bendrinamas lygis prieš perduodant į DRAM.
Lygiagrečiai „Zen“ atskiria TLB į ITLB (instrukcijoms) ir DTLB (duomenims) , kurių kiekvienas turi kelis lygius ir šimtus įrašų, visi su pariteto apsauga. Tai žymiai sumažina virtualaus į fizinį adreso vertimo delsą, kuri tampa vis svarbesnė didėjant atminties dydžiui.
Kai kalbame apie tai, ar talpykla yra dvipusė, keturpusė arba aštuoniapusė , apibūdiname jos asociatyvumą, kuris yra glaudžiai susijęs su atminties įterpimo idėja. Didesnis asociatyvumas reiškia daugiau skirtingų būdų saugoti atminties bloką toje talpykloje, sumažinant konfliktus, tačiau šiek tiek sudėtingesnės logikos ir šiek tiek padidėjusio delsos kaina.
Taip pat svarbu suprasti skirtumą tarp įrašymo per tekstą ir atgalinio įrašymo . Įrašymo per tekstą metu kiekvienas įrašymas vienu metu atnaujina ir talpyklą, ir pagrindinę atmintį, taip supaprastinant nuoseklumą , bet padidinant srautą. Įrašymo per tekstą metu įrašoma tik į talpyklą, o eilutė pažymima nešvariu bitu; DRAM atnaujinama tik tada, kai ta eilutė iškeldinama, taip taupant pralaidumą ir pagerinant našumą šiek tiek sudėtingesnės logikos sąskaita.
„Zen“ ir „Zen+“: VKI ir efektyvumo šuolis
„Zen“ reiškė labai reikšmingą AMD IPC šuolį, palyginti su „Bulldozer“ , dėl geresnės priekinės dalies, geresnio šakų prognozavimo, daugiau vykdymo vienetų, SMT vietoj CMT (kiekvienas pilnas branduolys apdoroja dvi gijas, o ne dalijasi dalimi FPU tarp dviejų loginių branduolių) ir daug protingesnės talpyklos hierarchijos derinio.
Be dizaino, AMD pasinaudojo pažangesniais gamybos procesais su „FinFET“ ir mažesniais mazgais , kurie leido padidinti tranzistorių tankį, sumažinti energijos suvartojimą tuo pačiu našumu ir pasiekti aukštesnius dažnius, išlaikant pagrįstą TDP ( įtampos ir dažnio kreivę ). Šis našumo ir vato balansas buvo labai svarbus norint atgauti konkurencingumą nešiojamųjų kompiuterių ir serverių pramonėje.
Perėjimas nuo „Bulldozer“ prie „Zen“ taip pat atnešė ilgesnes išėjimo į pensiją eiles, didesnius instrukcijų planuoklius, didesnį vidinį pralaidumą, šakų prognozavimą naudojant metodus, pagrįstus net paprastais neuroniniais tinklais, ir SMT, galintį geriau išnaudoti turimus vykdymo vienetus.
Šiame kontekste iškyla „Zen+“ , kurį galėtume laikyti „tikinimo“ atitikmeniu senojoje „Intel“ „Tick-Tock“ strategijoje: tas pats pagrindinis dizainas kaip ir „Zen“, bet pagamintas naudojant rafinuotesnį mazgą, su dažnio patobulinimais, šiek tiek sumažintu delsos laiku ir vidiniais laiko koregavimais. Tai ne architektūrinė revoliucija, o patobulinimas, reiškiantis keletą papildomų našumo taškų.
„Zen 2“: mikroschemos, pilnas AVX2 ir gilus rafinavimas
Su „Zen 2“ AMD nebėra tik proceso šlifavimas: ji įdiegia esminius mikroarchitektūros pakeitimus ir masiškai pradeda savo lustų strategiją . Vietoj vieno didelio monolitinio lusto, ji padalija dizainą į keletą mažesnių 7 nm skaičiavimo lustų (CCD) ir atskirą 12 nm įvesties/išvesties lustą, skirtą atmintiai, PCIe ir jungtims.
Šis lustų gamybos metodas pagerina vienos plokštelės išeigą (lengviau gaminti mažus, be defektų lustus), sumažina sąnaudas ir palengvina branduolių skaičiaus didinimą: tereikia pridėti daugiau CCD, kad pasiektumėte 16, 32 ar daugiau branduolių EPYC ir „Threadripper“. Kompromisas yra šiek tiek sudėtingesnė vidinė komunikacija, priklausanti nuo „Infinity Fabric“ sujungimo, kurį AMD tobulina karta po kartos.
Kalbant apie gryną našumą, AMD teigia, kad „Zen 2“ esant tam pačiam dažniui padidino IPC apie 15 %, palyginti su „Zen+“ , o bendras našumo padidėjimas vienam vatui gali siekti apie 75 %, palyginti su pirmuoju „Zen“, derinant dizaino ir proceso patobulinimus.
Vektorinėje valdymo sistemoje „Zen 2“ pakeičia trūkstamą dalį: ji siūlo visišką 256 bitų AVX2 palaikymą vienoje mikroprocesoriuje , neskaidydama instrukcijų į dvi 128 bitų operacijas, kaip buvo „Zen“ / „Zen+“ atveju. Tai reiškia, kad vektoriaus vykdymo blokai dabar yra išties 256 bitų ir gali apdoroti AVX2 darbo krūvius visu greičiu su daug mažesne dažnio bauda nei kituose modeliuose.
Taip pat sustiprinama mikro-operacijų talpykla, padidinant ją iki 4K įrašų (dvigubai daugiau), pasinaudojant dalimi vietos, atlaisvintos perpus sumažinant L1I talpyklą, bet padvigubinant jos asociatyvumą nuo 4 iki 8. Vidiniai modeliavimai leido AMD padaryti išvadą, kad daugumai realaus pasaulio darbo krūvių didesnė UOP talpykla yra pranašesnė nei didesnė L1I talpykla.
Kiekvieno branduolio bloko L3 talpyklos talpa padvigubėja , o tai padeda sumažinti paskutinio lygio gedimus, nors prieigos delsa padidėja nuo maždaug 35 iki 40 ciklų. Siekiant sušvelninti šį poveikį, „Zen 2“ pagerina apkrovos ir saugojimo pralaidumą bei patikslina išankstinio įkėlimo politiką.
Kitas svarbus aspektas yra šakų prognozavimo priemonė. „Zen 2“ naudoja TAGE (TAgged GEometric) prognozavimo priemonę su daugiau nei 7 įrašų, galinčią panaudoti kintamo ilgio istorijas ir pažymėtus įrašus. Tai sumažina skirtingų šakų slinkimą ir, anot AMD, sumažina neteisingų prognozių skaičių maždaug 30 %, palyginti su ankstesne schema, o tai tiesiogiai reiškia mažiau konvejerio praplovimų ir didesnį IPC.
„Zen 2“ vidinė sistema: AGU, buferiai ir reguliuojami delsos laikai
Visame užkulisiuose „Zen 2“ ir toliau atlieka iki šešių mikro-opacijų per ciklą iš pertvarkymo buferio, kuris išplėstas iki maždaug 224 įrašų (palyginti su „Zen“ 192). Planavimo vienetai yra suskirstyti į keturias eiles ALU po 16 įrašų kiekvienoje ir vieną eilę AGU su 28 įrašais.
Adresų generavimo vienetų (AGU) skaičius padidėja nuo dviejų iki trijų, nors jie ne visi yra identiški: du iš jų gali apdoroti ir įkėlimus, ir įrašymus, o trečiasis specializuojasi saugojimo operacijose. Šis paskirstymas skirtas tipiniams programinės įrangos profiliams, kur įkėlimai paprastai yra dažnesni ir svarbesni nei saugojimo operacijos.
Slankiojo kablelio plokštumoje galinis modulis gali priimti keturias mikrooperacijas per ciklą savo 256 bitų FMA vektoriaus blokams, kuriuos palaiko 160 įrašų fizinio registro failas. 256 bitų įkėlimo/saugojimo keliai buvo patobulinti, kad šie blokai būtų tiekiami pastoviu greičiu esant dideliems vektoriaus darbo krūviams.
„Zen 2“ taip pat koreguoja tam tikrų operacijų delsą : pavyzdžiui, slankiojo kablelio daugybos delsa sumažinama nuo 4 iki 3 ciklų, o tai padeda atliekant labai glaustus skaitmeninius skaičiavimus. Be to, apskritai visame ciklų cikle yra nedidelių optimizavimų, kurie sukuria papildomą IPC, matomą sintetiniuose etalonuose ir realaus pasaulio programose.
Kalbant apie vidinę hierarchiją pagal branduolių grupes, AMD naudoja CCX (Core Complex) koncepciją : 4 branduolių blokas, turintis tą pačią L3 talpyklą (16 MB „Zen 2“). Šis papildomas dydis reiškia šiek tiek didesnį delsos laiką, tačiau dėl to sumažėja gedimų dažnis, ypač programose su dideliais darbiniais rinkiniais.
Informacijai galime prisiminti apytikslius vidinio delsos rodiklius: apie 4 ciklus L1 , apie 12 L2 ir apie 40 ciklų L3. Svarbiausia – kuo daugiau duomenų laikyti L1/L2 ir sumažinti srautą į L3 ir DRAM – tai pasiekti kartu veikia mikroarchitektūra ir kompiliatoriai.
„Infinity Fabric“: klijai, naudojami mikroschemų gamyboje, ir jų poveikis našumui
Vienas komponentas, ne visada susijęs su mikroarchitektūra, bet gyvybiškai svarbus „Zen 2“ ir vėlesnėse versijose, yra „Infinity Fabric “. Ši patentuota magistralė veikia kaip ryšio „greitkelis“ tarp CCX, CCD, įvesties/išvesties mikroschemų, atminties ir apskritai tarp visų SoC blokų.
„Infinity Fabric“ yra „HyperTransport“ – AMD prieš daugelį metų sukurtos didelės spartos magistralės, kurią taip pat naudojo trečiosios šalys, tokios kaip „NVIDIA“, „Cisco“, „Sun“ ir kiti konsorciumo nariai, – evoliucija. IF paveldi keičiamo mastelio „taškas-taškas“ jungčių filosofiją, tačiau pritaikyta šiuolaikinių SoC ir CPU-GPU sujungimų poreikiams.
„Zen 2“ versijoje AMD pristato IF2 su PCIe 4.0 palaikymu ir 512 bitų vidine magistrale tarp CCX – dvigubai daugiau nei pirmojoje versijoje. Tai reiškia didesnį efektyvų pralaidumą ir efektyvumo pagerėjimą, kurį AMD vertina maždaug 27 %, palyginti su IF1, o tai padeda sumažinti našumo nuostolius, kylančius perjungiant mikroschemų rinkinius.
Be to, „Infinity Fabric“ laikrodis yra iš dalies atsietas nuo DRAM laikrodžio , todėl pagrindinė atmintis tam tikrais atvejais gali būti keičiamo dažnio, nebūtinai priversdama tarpinį dažnį neatsilikti, o tai suteikia entuziastams ir sistemų kūrėjams daugiau tikslumo galimybių.
Serverių procesoriuose, tokiuose kaip EPYC , su keturiais ar daugiau skaičiavimo lustų, „Infinity Fabric“ technologija leidžia sujungti visus mikroschemų rinkinius beveik pilnomis topologijomis (180º pasukimai, tiesioginiai ryšiai ir kt.), pasiekiant pralaidumą nuo mikroschemų iki mikroschemų, kuris, priklausomai nuo naudojamos DDR atminties greičio, gali lengvai viršyti 150 GB/s dvikrypčiu ryšiu.
Tvirtos mikroarchitektūros kiekviename branduolyje , keičiamo dydžio dizaino naudojant mikroschemas ir pakankamai greitų jungčių derinys leidžia AMD surinkti 32, 64 ar daugiau branduolių procesorius, pasižyminčius puikiu našumu esant labai lygiagretiems darbo krūviams, išlaikant konkurencingą IPC vienam gijai.
Galiausiai, lyginant procesorius žaidimų testuose, 3D vaizdavime, masiniame kompiliavime ar moksliniame modeliavime, GHz ir branduolių skaičiaus duomenys pasako tik dalį istorijos. Tikrąjį skirtumą lemia tai, kaip mikroarchitektūra organizuoja vidinį vykdymą , kaip ji naudoja arba eikvoja kiekvieną takto ciklą ir kokius kompromisus gamintojas padarė tarp delsos, pralaidumo, energijos suvartojimo ir sudėtingumo.

Rodiklis
- 1 ISA, makroarchitektūra ir mikroarchitektūra: sąvokų tvarkos suvedimas
- 2 Kas tiksliai yra procesoriaus mikroarchitektūra?
- 3 Suderinamumas, ISA ir mikroarchitektūrų šeimos
- 4 ISA licencijos ir dizaino intelektinė nuosavybė
- 5 Gilinimasis į šiuolaikines mikroarchitektūras: AMD Zen korpusas
- 6 Talpyklos hierarchija, TLB ir atminties organizavimas „Zen“ programoje
- 7 „Zen“ ir „Zen+“: VKI ir efektyvumo šuolis
- 8 „Zen 2“: mikroschemos, pilnas AVX2 ir gilus rafinavimas
- 9 „Zen 2“ vidinė sistema: AGU, buferiai ir reguliuojami delsos laikai
- 10 „Infinity Fabric“: klijai, naudojami mikroschemų gamyboje, ir jų poveikis našumui