- Fundamentāla atšķirība starp modeļa apmācības fāzi un secinājumu fāzi, lai radītu komerciālu vērtību.
- Izvietošanas arhitektūru analīze: no centralizētas mākoņdatošanas līdz perifērijas skaitļošanai (Edge AI).
- Tehnisko aparatūras prasību novērtējums, īpaši videoatmiņas (VRAM) nozīme grafikas procesoros (GPU) modeļa izpildei.
- Optimizācijas stratēģijas, piemēram, kvantēšana un mazo valodu modeļu (SLM) izmantošana, lai uzlabotu darbības efektivitāti.

Runājot par mākslīgo intelektu, vairums cilvēku iztēlojas milzīgus mācību procesus un superdatorus, kas apstrādā triljonus datu punktu. Tomēr ir procesa daļa, kurā notiek īstā biznesa maģija: secinājumu veidošana. Būtībā tas ir brīdis, kad mākslīgais intelekts pārstāj mācīties un sāk strādāt, pielietojot visu, ko ir iemācījies, lai risinātu reālas pasaules problēmas un pieņemtu lēmumus, pamatojoties uz datiem, ko tas nekad iepriekš nav redzējis.
Mūsdienu vidē uzņēmumi ir pārgājuši tālāk par mākslīgā intelekta uztveršanu kā laboratorijas eksperimentu un padarījuši to par būtisku ikdienas darbības sastāvdaļu . Vairs nav tikai jāizveido visspēcīgākais modelis, bet gan tas, kā to uzticami, droši un, galvenais, ienesīgi darbināt, pārnesot darba slodzi no teorijas uz aktīvu ražošanu hibrīdvidē.

Apmācība pret secinājumiem: tie nav viens un tas pats
Lai izvairītos no neskaidrībām, ir svarīgi skaidri nošķirt šos divus posmus. Apmācība ir līdzīga mākslīgā intelekta skolas gadiem; tas ir intensīvs process, kurā modelis analizē vēsturiskos datus un etiķetes, lai atrastu modeļus. Lielos datu centros tiek izmantoti jaudīgi aparatūras paātrinātāji , piemēram , GPU vai TPU , un reakcijas laiks nav prioritāte, jo process var ilgt vairākas dienas vai nedēļas.
Savukārt secinājumi ir pēdējais tests, kas tiek piemērots reāllaikā. Tas ir izpildes process, kurā modelis saņem ievades datus (fotoattēlu, tekstu vai sensora rādījumu) un atgriež tūlītēju rezultātu. Šajā fāzē latentums kļūst kritisks , un efektivitāte ir galvenā. Lai gan apmācība liek pamatus, secinājumi ir tas, kas rada tiešu ekonomisko vērtību organizācijai.
Izvietošanas stratēģijas: mākonis, lokālā vide un Edge
Nav vienas metodes secinājumu veikšanai. Atkarībā no datu steidzamības un apjoma uzņēmumi izvēlas no vairākām pieejām. Pakešu secinājumi ir ideāli piemēroti apjomīgiem, nesteidzamiem uzdevumiem, piemēram, finanšu analīzei vienas nakts laikā vai liela mēroga dokumentu kategorizēšanai, kur dati tiek apstrādāti mākonī un rezultāti tiek atgriezti vēlāk.

Tad mums ir reāllaika secinājumi , kas ir būtiski tērzēšanas robotiem vai krāpšanas atklāšanas sistēmām, kur atbildei ir jānonāk milisekundēs. Lai gan mākonis joprojām ir dominējošā iespēja tā mērogojamības dēļ, tas sāk izrādīt savus ierobežojumus tīkla latentuma un augsto joslas platuma izmaksu dēļ, apstrādājot terabaitus datu.
Šeit noder Edge Inference jeb Edge AI . Apstrādājot datus tieši ierīcē (IoT sensorā, robotā vai viedtālrunī), tiek panākta ārkārtīgi zema latentuma pakāpe un ievērojami lielāka privātuma pakāpe, jo sensitīvai informācijai nav jānokļūst attālā serverī. Tas ir ļoti svarīgi nozarēs, kur milisekundes aizkave var būt kritiska, piemēram, autonomajā braukšanā vai teleķirurģijā.
Augu secinājumi un 4.0 rūpniecība
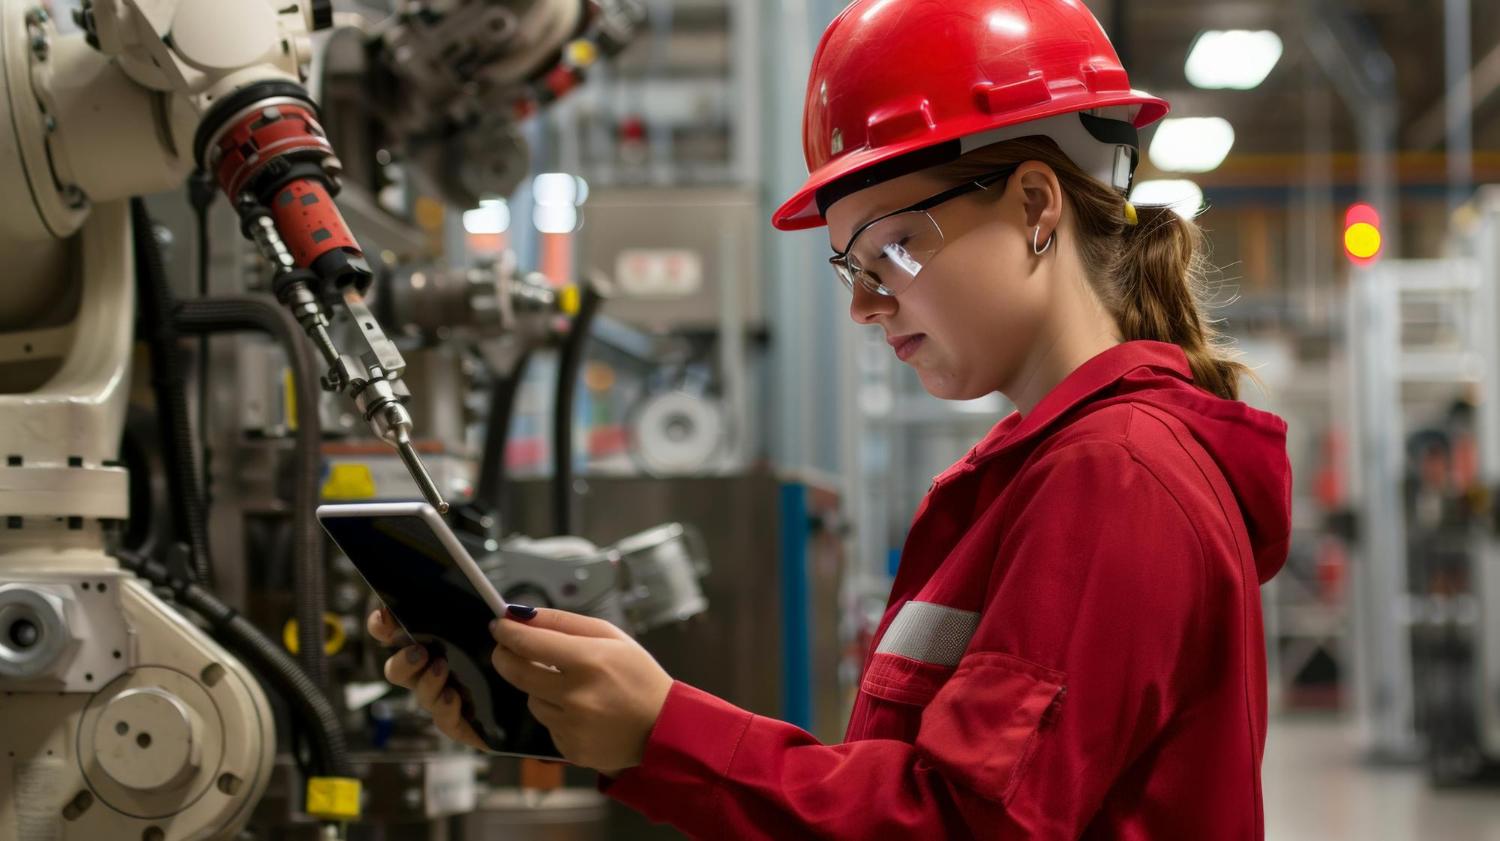
Ražošanas nozarē secinājumu tehnoloģija ir īsts dārgakmens. Tā ļauj mašīnām nekavējoties pieņemt inteliģentus lēmumus, neizmantojot interneta savienojumu. Tas nozīmē reāllaika kvalitātes kontroli , atklājot bojātas detaļas montāžas līnijā, pirms tās kļūst par nevajadzīgiem izdevumiem.

Turklāt tas veido paredzamās apkopes pamatu . Mākslīgā intelekta modeļi reāllaikā analizē iekārtu stāvokli un sniedz agrīnus brīdinājumus, pirms kaut kas sabojājas, novēršot ražošanas pārtraukumus, kas varētu izmaksāt tūkstošiem eiro. Pārtikas un elektronikas rūpniecībā tas nodrošina, ka gala produkts vienmēr atbilst visstingrākajiem kvalitātes standartiem.
Tehniskās prasības un modeļa optimizācija
Ja uzņēmums nolemj veikt secinājumus lokāli, aparatūra ir galvenais faktors. Grafiskās kartes (GPU) ir būtiskas to paralēlās arhitektūras dēļ. Vissvarīgākais faktors ir ne tikai jauda, bet arī VRAM (video atmiņa); ja modelis pilnībā ietilpst VRAM, reakcijas laiks strauji palielinās. Pretējā gadījumā sistēma paļaujas uz parasto RAM, kas visu ievērojami palēnina.
Lai šie modeļi darbotos ierobežotās ierīcēs, tiek izmantotas optimizācijas metodes. Kvantēšana samazina modeļa svaru precizitāti (piemēram, no 32 līdz 4 bitiem), padarot failu daudz mazāku un ātrāku, neupurējot pārāk lielu precizitāti. No otras puses, LoRA (Low-Rank Adaptation) ļauj pielāgot lielus modeļus konkrētiem uzdevumiem, neapmācot visu modeli atkārtoti, kas ir daudz lētāk un ātrāk.

Arī mazo valodu modeļi (SLM) iekaro popularitāti . Atšķirībā no masīvajiem LLM, SLM ir izstrādāti tā, lai būtu efektīvi un viegli, padarot tos ideāli piemērotus perifērijas aparatūrai. Lai risinātu aparatūras fragmentācijas problēmu, tiek izmantots WebAssembly (Wasm) , kas ļauj mākslīgajam intelektam darboties gandrīz ar sākotnējo ātrumu jebkurā ierīcē neatkarīgi no tās procesora.
Pārvaldības, drošības un darbības rīki
Pārejot uz mākslīgā intelekta izmantošanu ražošanā, tā vairs nav tikai spēle, bet gan misijai kritiski svarīga darba slodze. Daudzi uzņēmumi jau darbojas hibrīdās vai daudzmākoņu vidēs , kas prasa ieviest stingru maršrutēšanas un drošības kontroli. Pārvaldība tagad koncentrējas uz uzvednes, marķiera un API slāņiem, kur drošības pārvaldība mākslīgā intelekta izstrādes vidēs ir ļoti svarīga , lai novērstu datu noplūdes.
Tiem, kas vēlas eksperimentēt ar lokālo secinājumu metodi, ir pieejami daži ļoti jaudīgi rīki. LM Studio ir lieliska iespēja lietotājiem, kas meklē vienkāršu grafisko saskarni un saderību ar Hugging Face modeļiem. Izstrādātājiem Ollama ir galvenais rīks, jo tas ir atvērtā koda un ļauj ļoti efektīvi izmantot lokālo mākslīgo intelektu datorā, izmantojot Docker konteinerus.

Ir arī citas interesantas alternatīvas, piemēram, Llama.cpp plašam aparatūras atbalstam vai Jan tiem, kam prioritāte ir 100% bezsaistes vide. Ir pat viedtālruņu lietotnes, piemēram, PocketPal, kas ļauj veikt secinājumus tieši jūsu kabatā, pierādot, ka mākslīgajam intelektam vairs nav obligāti nepieciešams superdators, lai tas būtu noderīgs.
Tendence ir skaidra: mākslīgais intelekts virzās uz izkliedētu modeli. Nākotne nav vienotās, centralizētās smadzenēs mākonī, bet gan intelektuālā secinājumu tīklā , kas izkliedēts datu centros un lokālās ierīcēs. Šī hibrīda arhitektūra ļauj līdzsvarot skaitļošanas jaudu, nepieciešamību pēc tūlītējas reaģēšanas un korporatīvās datu privātuma aizsardzību.
