- De microarchitectuur definieert hoe een CPU een ISA implementeert en bepaalt de IPC (Instructions Per Cycle), interne parallelisatie en daadwerkelijke efficiëntie, los van frequentie of cachegrootte.
- Ontwerpen zoals AMD Zen en Zen 2 combineren geoptimaliseerde caches, out-of-order execution, SMT en grote vector-eenheden om de prestaties per cyclus en per watt te verbeteren.
- De chiplet- en Infinity Fabric-strategie maakt het mogelijk om het aantal cores in EPYC en Ryzen op te schalen met behoud van beheersbare kosten en zeer concurrerende prestaties.
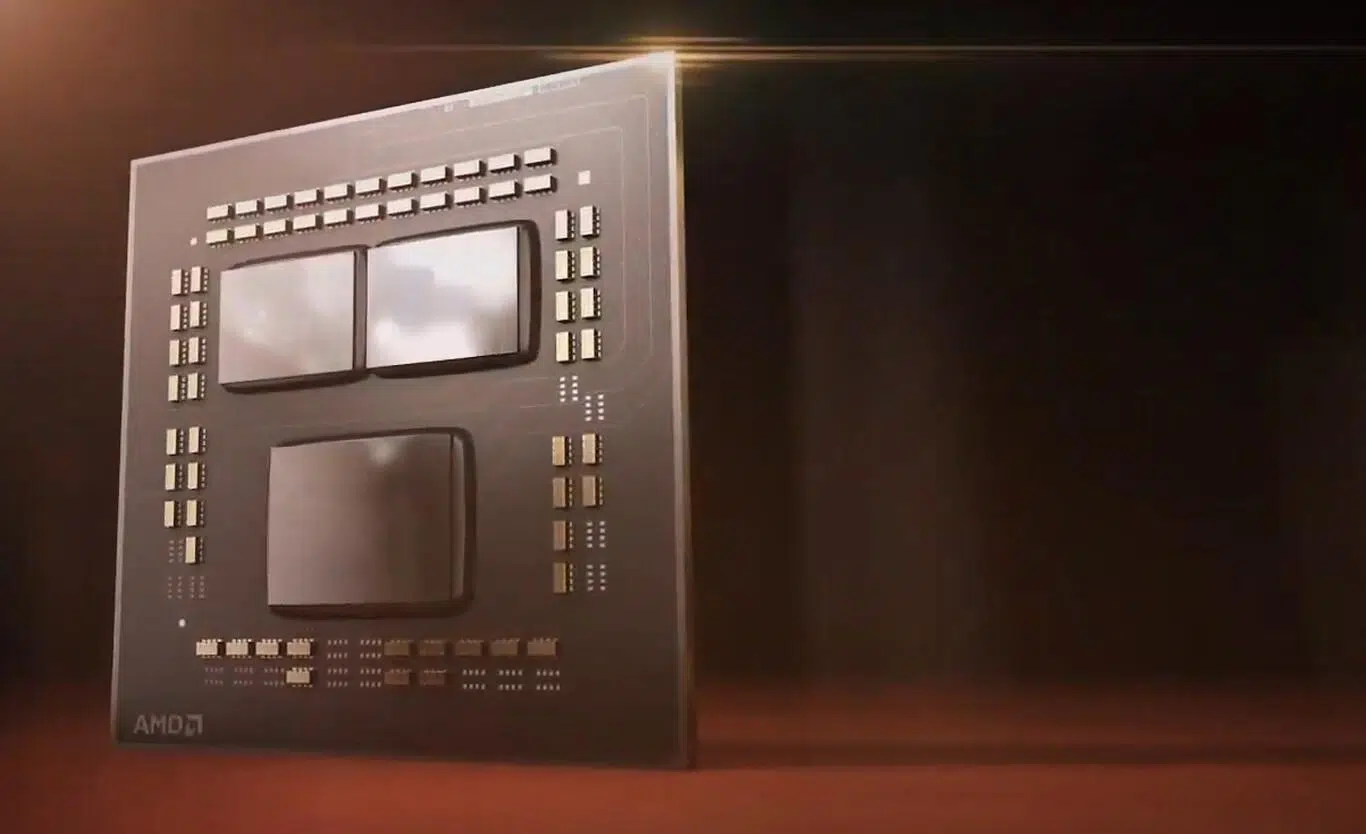
De microarchitectuur van een CPU krijgt vaak minder aandacht dan opvallendere cijfers zoals GHz of MB cache, maar juist in het interne ontwerp van de processor worden de werkelijke prestaties, de efficiëntie en zelfs het type software dat er het beste gebruik van kan maken, bepaald.
Wanneer je technische specificaties leest waarin cores, threads, L3-cache of AVX2 worden genoemd , zie je in feite de concrete gevolgen van een bepaalde microarchitectuur. Inzicht in hoe deze componenten intern zijn georganiseerd, wat een Zen 3 onderscheidt van een Zen 2, of een hybride Intel van een klassieke Ryzen, is essentieel om een verstandige keuze te maken voor je volgende CPU en te begrijpen waarom sommige processors uitblinken in gaming, andere in rendering en weer andere in servertaken.
ISA, macroarchitectuur en microarchitectuur: orde scheppen in de concepten
Voordat we ingaan op de complexiteit van pipelines en predictors, is het nuttig om onderscheid te maken tussen drie vaak door elkaar gehaalde niveaus: systeemmacroarchitectuur, ISA en microarchitectuur . Elk beschrijft een andere laag van de computer.
Enerzijds is er de macroarchitectuur, oftewel het algehele systeemontwerp , dat alles omvat wat je op het moederbord ziet: CPU, geheugencontrollers, bussen, hoofdgeheugen, input/output-chips, opslagcontrollers, eventuele externe accelerators en DMA-logica. Het geeft een overzicht op hoog niveau van hoe de grote hardwarecomponenten met elkaar verbonden zijn en hoe gegevens ertussen stromen.
Daarboven bevindt zich de ISA (Instruction Set Architecture) , de instructieset die de processor begrijpt: de gegevenstypen die hij verwerkt, woordgrootte, aantal en type registers, adresseermodi, instructieformaten, enzovoort. Wanneer je in assembler programmeert met behulp van mnemonics zoals ADD, SUB, MUL , of extensies zoals SSE, AVX of NEON aanroept, communiceer je rechtstreeks met de ISA.
Ten slotte hebben we de microcode, of μISA , die de interne micro-bewerkingen definieert die sommige complexe architecturen (zoals x86) gebruiken om hun CISC-instructies te implementeren. Deze microcode kan via firmware worden bijgewerkt om bugs te verhelpen of ondersteuning voor nieuwe instructies toe te voegen.
Wat is precies de microarchitectuur van een CPU?
De microarchitectuur van de CPU is in wezen de interne blauwdruk die bepaalt hoe ISA-instructies worden uitgevoerd en hoe gegevens binnen de chip worden verplaatst. Twee processors kunnen dezelfde ISA delen (bijvoorbeeld AMD64 in Intel en AMD) en toch radicaal verschillend gedrag en prestaties vertonen als gevolg van – of misschien wel dankzij – hun microarchitectuur.
Dit ontwerp omvat elementen zoals het type besturingseenheid , of er gebruik wordt gemaakt van programmeerbare microcode of vastgelegde logica; de geheugenhiërarchie; de diepte van de pipeline; hoeveel functionele eenheden parallel werken; en of de processor in staat is instructies in een willekeurige volgorde en speculatief uit te voeren.
Daarnaast moet de ontwerper de diepte van de pipeline kiezen : van eenvoudige CPU's zonder pipelining, waarbij elke instructie van begin tot eind wordt verwerkt voordat de volgende begint, tot moderne ontwerpen met veel fasen (ophalen, decoderen, hernoemen, verzenden, uitvoeren, terugschrijven, verwijderen, enz.) die het mogelijk maken dat tientallen instructies tegelijkertijd in behandeling zijn.
Hieraan gerelateerd is het aantal en het type uitvoereenheden : ALU's voor gehele getallen, vermenigvuldigingseenheden, delers, FPU's voor scalaire en vectoriële drijvende-komma getallen, AGU's (Address Generation Units) voor het berekenen van geheugenadressen, sprongeenheden, enzovoort. Als er meerdere eenheden van hetzelfde type zijn, spreken we van superscalaire processors, die in staat zijn om meerdere instructies per cyclus uit te voeren.
Dit vormt de basis voor geavanceerde technieken zoals speculatieve uitvoering , waarbij de CPU anticipeert op de afloop van een vertakking en instructies uit een van de vertakkingen alvast uitvoert. Als de voorspelling correct is, wordt tijd bespaard; als deze onjuist is, wordt het uitgevoerde werk verworpen en de pipeline leeggehaald, met de bijbehorende straf.
De meeste moderne, krachtige CPU's maken ook gebruik van out-of-order (OoO) uitvoering . In plaats van zich strikt aan de programmavolgorde te houden, herschikt de processor intern de instructies en voert eerst die instructies uit waarvan de gegevens gereed zijn. Hierdoor worden onnodige cycli vermeden terwijl andere instructies wachten op geheugen of het resultaat van eerdere bewerkingen.
Om dit alles te laten werken zonder de semantiek van het programma te schenden, wordt registerherbenoeming gebruikt . De compiler ziet een beperkte set logische registers, maar de microarchitectuur vertaalt deze naar een grotere bank fysieke registers, waarbij dynamisch nieuwe bestemmingen worden toegewezen om valse afhankelijkheden te doorbreken en een grotere parallelle verwerking mogelijk te maken.
Ten slotte kan het ontwerp zich richten op het toevoegen van parallellisme op kern- en threadniveau . Dit omvat alles van single-core CPU's tot chips met tientallen of honderden kernen (manycore), multiprocessorsystemen met meerdere sockets die met elkaar verbonden zijn door snelle mesh-netwerken (Infinity Fabric, Intel Mesh, NVLink, enz.) en ondersteuning voor Simultaneous Multithreading (SMT), zodat elke fysieke kern twee of meer logische threads kan verwerken.
Compatibiliteit, ISA- en microarchitectuurfamilies
Omdat een microarchitectuur slechts één specifieke implementatie van een ISA is , kan een enkele ISA in de loop der jaren en bij verschillende fabrikanten tientallen verschillende microarchitecturen hebben. Dit is precies wat er gebeurt met x86-64/AMD64 of ARM.
Als we alleen naar AMD binnen de AMD64 ISA kijken, zien we families die zo divers zijn als K8/Hammer, K10, Bulldozer en de hele Zen-serie (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Ze voeren allemaal dezelfde basisinstructieset uit, maar hun interne organisatie, caches, pipelines en parallelle uitvoeringsmethoden verschillen volledig.
Wanneer we van ISA wisselen, is de sprong in compatibiliteit absoluut. Een ARM A64 -gebaseerde processor (zoals Apple Silicon) kan geen binaire bestanden uitvoeren die gecompileerd zijn voor x86-64, en omgekeerd, tenzij een vertaal- of emulatielaag zoals Rosetta 2, QEMU of iets dergelijks wordt gebruikt, met de bijbehorende prestatievermindering.
Zelfs bij processors die dezelfde ISA delen, is er geen garantie dat ze allemaal dezelfde instructieset of extensies ondersteunen. Een oudere chip mist mogelijk AVX2 of AVX-512, of een ARM SoC implementeert mogelijk slechts een subset van optionele extensies. Daarom kan een binair bestand dat veel gebruikmaakt van AVX-512 mogelijk niet opstarten op een CPU die alleen SSE4 biedt.
Bij het compileren van software is het gebruikelijk om generieke binaire bestanden te genereren voor een specifieke ISA (bijvoorbeeld x86-64 met minimaal SSE2) zonder de specifieke microarchitectuur volledig te benutten, zodat het uitvoerbare bestand op zoveel mogelijk CPU's draait. Door echter te compileren met tuning-vlaggen voor een specifieke microarchitectuur (-march=znver3, -mtune=skylake, enz.) kan de prestatie op die specifieke familie aanzienlijk worden verbeterd, ten koste van de compatibiliteit met andere families.
ISA-licenties en intellectueel eigendom van het ontwerp
Niet alleen programmacode is beschermd door licenties: ISA's en microarchitecturen zijn ook intellectueel eigendom. Niemand mag een x86- of AMD64-ISA legaal klonen zonder licentie, net zoals een eigen CPU-ontwerp niet zonder toestemming gekopieerd mag worden.
Binnen de wereld van ISA's zijn er drie belangrijke benaderingen. Enerzijds zijn er gesloten ISA's , waarbij de eigenaar strikt controleert wie compatibele cores mag implementeren. Het klassieke voorbeeld is IA-32 (x86-32), historisch eigendom van Intel, dat licenties verleende aan AMD, VIA en anderen, niet zonder juridische strijd.
Een vergelijkbare situatie bestaat met AMD64/x86-64 , dat aanvankelijk door AMD werd ontworpen en later via wederzijdse licentieovereenkomsten in licentie werd gegeven aan Intel (dat het EM64T noemde). Andere spelers, zoals Hygon in China, hebben ook licenties verkregen voor specifieke versies (bijvoorbeeld Zen 1 voor de Chinese markt).
Vervolgens hebben we ISA's met flexibele licenties , waarbij de eigenaar zowel ISA-licenties als kant-en-klare IP-cores aanbiedt. ARM, SPARC of OpenPOWER passen hier goed bij: je kunt betalen om Cortex A/M/R of Neoverse te gebruiken zoals ze zijn, of voor een licentie waarmee je je eigen microarchitecturen bovenop de ISA kunt ontwerpen, zoals Apple doet met zijn M1/M2/M3 of Qualcomm met zijn Kryo.
Ten slotte zijn er open-source ISA's , waarmee iedereen compatibele microarchitecturen kan creëren zonder royalty's te betalen voor de ISA (hoewel ze hun eigen implementatie wel kunnen patenteren of afsluiten). RISC-V is hiervan het beste voorbeeld: de ISA valt onder een permissieve BSD-licentie en er zijn opties variërend van volledig open kernels in Verilog of Chisel tot gesloten commerciële ontwerpen.
Naast de ISA is elke specifieke microarchitectuur (een Zen 4-kern, een Cortex X4, een GPU-ontwerp, enz.) een blok gepatenteerd of geregistreerd intellectueel eigendom. Er zijn hier ook open ontwerpen, gepubliceerd als softcores in HDL voor synthese in FPGA's of integratie in aangepaste SoC's.
Een diepere duik in moderne microarchitecturen: de AMD Zen-case
Om te zien hoe dit alles zich vertaalt naar prestaties in de praktijk, is er niets beter dan een specifieke productfamilie te ontleden. AMD heeft zijn bedrijfsmodel drastisch veranderd dankzij Zen en de daaropvolgende iteraties , van het lastige Bulldozer-tijdperk en de oude FX-processors naar een positie waarin het rechtstreeks concurreert met (en soms zelfs Intel overtreft) op de desktop-, server- en laptopmarkt.
Na het mislukken van de AMD Fusion- strategie , herstructureerde het bedrijf en koos het voor een hoogwaardig ontwerp, onder leiding van onder anderen Jim Keller. Het Zen-plan was erop gericht de IPC (instructies per cyclus) ten opzichte van Bulldozer drastisch te verhogen, de prestaties per watt te verbeteren en terrein terug te winnen op het gebied van single-core prestaties, waar Intel jarenlang de leiding had gehad.
Een van de belangrijkste veranderingen was de versterking van de front-end , het gedeelte dat verantwoordelijk is voor het ophalen en voorbereiden van instructies. Zen introduceerde een micro-operation cache die reeds gedecodeerde micro-operaties opslaat, vergelijkbaar met wat sommige Intel-microarchitecturen zoals Conroe deden. Bulldozer miste dit en vertrouwde meer op de klassieke instructiecachehiërarchie, wat een negatieve invloed had op de doorvoer.
De decoder van Zen kan tot vier CISC x86-64-instructies per cyclus vertalen naar RISC-achtige micro-ops. Deze micro-ops worden vervolgens in een wachtrij geplaatst die wordt gevoed door de micro-op-buffer. Deze buffer kan op zijn beurt tot zes micro-ops per cyclus naar de back-end schedulers sturen. Hier begint de out-of-order-uitvoering.
AMD heeft de paden voor gehele getallen en drijvende-komma getallen duidelijk gescheiden . Aan de kant van de gehele getallen worden de ALU's, AGU's en de laad-/opslaglogica gevoed vanuit de micro-ops-wachtrij. Deze logica is in staat om twee laadbewerkingen van 16 bytes en één opslagbewerking van 16 bytes per cyclus uit te voeren vanuit een 32 KB, 8-weg L1D, met een write-back-beleid.
De floating-point- en vectorzijde voeden de FMAC- en AVX-eenheden. Met twee vermenigvuldigingspoorten en twee optelpoorten kan Zen gelijktijdig twee 128-bits FMA-bewerkingen of één 256-bits AVX-bewerking per klokcyclus uitvoeren. Deze parallelle verwerking op instructieniveau is een van de sleutels tot de sterke prestaties bij rekenintensieve taken.
Cachehiërarchie, TLB en geheugenorganisatie in Zen
De geheugenhiërarchie in Zen is georganiseerd in drie cachelagen: een aparte L1 voor instructies en data, een privé L2 per core en een gedeelde L3 . Hoewel de basisstructuur van eerdere microarchitecturen behouden is gebleven, zijn de groottes, associativiteit en het beleid verfijnd.
De L1I (instructiecache) biedt 64 KB per core, met 4 associatieve paden, waardoor het aantal paden per module verdubbelt ten opzichte van Bulldozer en conflicten worden verminderd. De L1D (datacache) is vergroot naar 32 KB, 8 paden en een write-back-beleid, vergeleken met de 16 KB, 4 paden en write-through van Bulldozer, wat de hitrate en de schrijfefficiëntie aanzienlijk verbetert.
De L2- cache is geïmplementeerd met 512 KB per core en 8-wegs, in plaats van de 2 MB 16-wegs gedeelde cache per module van de vorige generatie. De L3- cache biedt daarentegen enkele MB per core met 16-wegs associativiteit en fungeert als het laatste gedeelde niveau voordat de gegevens naar het DRAM worden geschreven.
Tegelijkertijd scheidt Zen de TLB's in ITLB's (voor instructies) en DTLB's (voor data) , elk met meerdere niveaus en honderden entries, allemaal met pariteitsbescherming. Dit reduceert de latentie van de virtuele-naar-fysieke adresvertaling aanzienlijk, wat steeds belangrijker wordt naarmate de geheugengrootte toeneemt.
Wanneer we spreken over een 2-weg, 4-weg of 8-weg cache , beschrijven we de associativiteit ervan, wat nauw samenhangt met het concept van interleaving in het geheugen. Meer associativiteit betekent dat er meer verschillende manieren zijn om een geheugenblok in die cache op te slaan, waardoor conflicten worden verminderd, maar dit gaat ten koste van een iets complexere logica en een lichte toename van de latentie.
Het is ook belangrijk om het verschil tussen write-through en write-back te begrijpen . Bij write-through worden bij elke schrijfbewerking zowel de cache als het hoofdgeheugen tegelijkertijd bijgewerkt, wat de consistentie vereenvoudigt maar het dataverkeer verhoogt. Bij write-back wordt alleen de cache beschreven en wordt de regel gemarkeerd met een 'dirty bit'; het DRAM wordt pas bijgewerkt wanneer die regel wordt verwijderd, wat bandbreedte bespaart en de prestaties verbetert ten koste van een iets complexere logica.
Zen en Zen+: een sprong voorwaarts in CPI en efficiëntie
Zen betekende een zeer significante IPC-sprong voor AMD ten opzichte van Bulldozer , dankzij de combinatie van een betere front-end, een betere branch predictor, meer execution units, SMT in plaats van CMT (elke volledige core verwerkt twee threads, in plaats van een deel van de FPU te delen tussen twee logische cores) en een veel logischer cachehiërarchie.
Naast het ontwerp profiteerde AMD van geavanceerdere productieprocessen met FinFET en kleinere nodes , waardoor een hogere transistordichtheid, een lager stroomverbruik bij dezelfde prestaties en hogere frequenties mogelijk waren, terwijl de TDP ( spanning-frequentiecurve ) redelijk bleef. Deze balans tussen prestaties en watt was cruciaal om de concurrentiepositie in laptops en servers te herwinnen.
De overgang van Bulldozer naar Zen bracht ook langere exit-wachtrijen, grotere instructieplanners, een grotere interne bandbreedte, branch prediction met technieken die zelfs gebaseerd zijn op eenvoudige neurale netwerken, en een SMT die de beschikbare uitvoereenheden beter kan benutten.
In deze context verschijnt Zen+ , wat we kunnen zien als het equivalent van een "tick" in Intels oude Tick-Tock-strategie: hetzelfde basisontwerp als Zen, maar geproduceerd op een verfijnder proces, met verbeterde frequenties, een lichte vermindering van de latentie en interne timingaanpassingen. Het is geen architectonische revolutie, maar eerder een verfijning die zich vertaalt in een paar extra prestatiepunten.
Zen 2: chiplets, volledige AVX2 en diepgaande verfijning
Met Zen 2 verfijnt AMD niet langer alleen het productieproces: het introduceert substantiële veranderingen in de microarchitectuur en lanceert op grote schaal zijn chipletstrategie . In plaats van één grote monolithische chip, verdeelt het bedrijf het ontwerp in verschillende kleinere 7nm compute dies (CCD's) en een aparte 12nm I/O-chip voor geheugen, PCIe en interconnecties.
Deze chiplet-aanpak verbetert de opbrengst per wafer (het is gemakkelijker om kleine, defectvrije chips te produceren), verlaagt de kosten en maakt het eenvoudiger om het aantal cores op te schalen: voeg simpelweg meer CCD's toe om 16, 32 of meer cores te bereiken in EPYC en Threadripper. De keerzijde is een iets complexere interne communicatie, afhankelijk van de Infinity Fabric-interconnect, die AMD generatie na generatie heeft verfijnd.
Qua pure prestaties spreekt AMD van een IPC-verbetering van ongeveer 15% voor Zen 2 ten opzichte van Zen+ bij dezelfde frequentie, en een algehele prestatieverbetering per watt die kan oplopen tot ongeveer 75% ten opzichte van de eerste Zen, wanneer ontwerp- en procesverbeteringen worden gecombineerd.
In de vectorbackend vult Zen 2 het ontbrekende puzzelstukje in: het biedt volledige 256-bit AVX2-ondersteuning in één enkele micro-op , zonder instructies op te splitsen in twee 128-bit bewerkingen zoals het geval was in Zen/Zen+. Dit betekent dat de vector-executie-eenheden nu echt 256-bit zijn en AVX2-workloads op volle snelheid kunnen verwerken met een veel kleinere frequentievermindering dan in andere ontwerpen.
De micro-ops cache wordt ook versterkt en vergroot naar 4K entries (het dubbele van de huidige grootte). Hierbij wordt gebruikgemaakt van de ruimte die vrijkomt door de L1I cache te halveren, terwijl de associativiteit ervan wordt verdubbeld van 4 naar 8 manieren. Interne simulaties brachten AMD tot de conclusie dat een grotere uop cache voor de meeste praktijkworkloads voordeliger is dan een grotere L1I cache.
De L3-cache per core-blok is verdubbeld in capaciteit , wat helpt om fouten op het laatste niveau te verminderen, hoewel de toegangslatentie toeneemt van ongeveer 35 naar 40 cycli. Om dit effect te beperken, verbetert Zen 2 de bandbreedte voor laden en opslaan en verfijnt het het prefetch-beleid.
Een ander belangrijk aspect is de branch predictor. Zen 2 gebruikt een TAGE (TAgged GEometric) predictor met meer dan 7 entries, die gebruik kan maken van histories met variabele lengte en getagde entries. Dit vermindert aliasing tussen verschillende branches en, volgens AMD, het aantal onjuiste voorspellingen met ongeveer 30% ten opzichte van het vorige schema, wat zich direct vertaalt in minder pipeline flushes en een hogere IPC.
Zen 2 Back-end: AGU's, buffers en aangepaste latenties
In de gehele back-end blijft Zen 2 tot zes micro-operaties per cyclus vanuit de herordeningbuffer versturen , die is uitgebreid tot ongeveer 224 items (vergeleken met 192 bij Zen). De planningseenheden zijn verdeeld in vier wachtrijen voor ALU's van elk 16 items en één wachtrij voor AGU's van 28 items.
Het aantal Address Generation Units (AGU's) neemt toe van twee naar drie, hoewel ze niet allemaal identiek zijn: twee ervan kunnen zowel lees- als schrijfbewerkingen afhandelen, terwijl de derde gespecialiseerd is in opslagbewerkingen. Deze verdeling is ontworpen voor typische softwareprofielen, waarbij leesbewerkingen doorgaans frequenter en kritischer zijn dan opslagbewerkingen.
In het floating-point vlak kan de back-end vier micro-operaties per cyclus verwerken voor de 256-bits FMA-vectoreenheden, ondersteund door een fysiek registerbestand met 160 ingangen. De 256-bits laad-/opslagpaden zijn verbeterd om deze eenheden onder zware vectorbelastingen met een constante snelheid te kunnen voeden.
Zen 2 past ook de latentie van bepaalde bewerkingen aan : zo wordt de latentie van drijvende-kommavermenigvuldiging verlaagd van 4 naar 3 cycli, wat helpt bij zeer strakke numerieke rekenlussen. En in het algemeen zijn er een aantal kleine optimalisaties verspreid over de hele pipeline die samen de extra IPC opleveren die zichtbaar is in synthetische benchmarks en praktijktoepassingen.
Wat betreft de interne hiërarchie per coregroep, gebruikt AMD het CCX-concept (Core Complex) : een blok van 4 cores die dezelfde L3-cache delen (16 MB in Zen 2). Deze extra grootte brengt een iets hogere latentie met zich mee, maar verlaagt in ruil daarvoor het foutpercentage, met name in applicaties met grote werksets.
Ter referentie kunnen we de geschatte interne latentiewaarden in herinnering brengen: ongeveer 4 cycli voor L1 , ongeveer 12 voor L2 en ongeveer 40 cycli voor L3. De sleutel is om zoveel mogelijk data in L1/L2 te bewaren en het verkeer naar L3 en DRAM te verminderen , iets waar de microarchitectuur en compilers samen aan werken.
Infinity Fabric: de lijm die gebruikt wordt in chiplets en de impact ervan op de prestaties.
Een component dat niet altijd direct met microarchitectuur wordt geassocieerd, maar essentieel is in Zen 2 en latere versies, is Infinity Fabric . Deze eigen bus fungeert als een communicatie-"snelweg" tussen CCX'en, CCD's, de I/O-chip, het geheugen en, in het algemeen, tussen alle blokken van de SoC.
Infinity Fabric is een evolutie van HyperTransport , de hogesnelheidsbus die AMD jaren geleden introduceerde en die ook werd gebruikt door derden zoals NVIDIA, Cisco, Sun en andere leden van het consortium. IF erft de filosofie van schaalbare point-to-point-verbindingen, maar aangepast aan de behoeften van moderne SoC's en CPU-GPU-interconnectie.
In Zen 2 introduceert AMD IF2 , met ondersteuning voor PCIe 4.0 en een interne 512-bits bus tussen CCX'en, het dubbele van de eerste versie. Dit resulteert in een effectievere bandbreedte en een efficiëntieverbetering die AMD schat op ongeveer 27% ten opzichte van IF1, waardoor het prestatieverlies door het schakelen tussen chiplets wordt beperkt.
Bovendien is de Infinity Fabric-klok gedeeltelijk losgekoppeld van de DRAM-klok , waardoor het hoofdgeheugen in bepaalde scenario's naar hogere frequenties kan opschalen zonder dat de IF per se gelijke tred hoeft te houden. Dit biedt meer mogelijkheden voor fijnafstelling voor enthousiastelingen en systeemontwerpers.
Bij serverprocessors zoals EPYC , met vier of meer compute-chiplets, maakt Infinity Fabric het mogelijk om alle chips met elkaar te verbinden via vrijwel complete topologieën (180º rotaties, directe verbindingen, enz.), waardoor bandbreedtes tussen de chips worden bereikt die gemakkelijk meer dan 150 GB/s bidirectioneel kunnen bedragen, afhankelijk van de snelheid van het gebruikte DDR-geheugen.
De combinatie van een robuuste microarchitectuur in elke core , een schaalbaar ontwerp met behulp van chiplets en voldoende snelle interconnecties stelt AMD in staat om CPU's met 32, 64 of meer cores te assembleren die uitstekende prestaties leveren bij sterk parallelle workloads, terwijl ze tegelijkertijd een concurrerende IPC per thread behouden.
Uiteindelijk vertellen de cijfers over GHz en het aantal cores slechts een deel van het verhaal wanneer je processors vergelijkt in gamingbenchmarks, 3D-rendering, grootschalige compilatie of wetenschappelijke simulaties. Wat echt het verschil maakt, is hoe de microarchitectuur de interne uitvoering aanstuurt , hoe elke klokcyclus wordt benut of verspild, en welke afwegingen de fabrikant heeft gemaakt tussen latentie, bandbreedte, stroomverbruik en complexiteit.

Index
- 1 ISA, macroarchitectuur en microarchitectuur: orde scheppen in de concepten
- 2 Wat is precies de microarchitectuur van een CPU?
- 3 Compatibiliteit, ISA- en microarchitectuurfamilies
- 4 ISA-licenties en intellectueel eigendom van het ontwerp
- 5 Een diepere duik in moderne microarchitecturen: de AMD Zen-case
- 6 Cachehiërarchie, TLB en geheugenorganisatie in Zen
- 7 Zen en Zen+: een sprong voorwaarts in CPI en efficiëntie
- 8 Zen 2: chiplets, volledige AVX2 en diepgaande verfijning
- 9 Zen 2 Back-end: AGU's, buffers en aangepaste latenties
- 10 Infinity Fabric: de lijm die gebruikt wordt in chiplets en de impact ervan op de prestaties.