- Realtime monitoring van netwerkverkeer maakt het mogelijk om storingen te voorspellen, de prestaties te verbeteren en de beveiliging van de IT-infrastructuur te versterken.
- Open source tools zoals Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS of Observium bieden geavanceerde functies zonder licentiekosten.
- De combinatie van dataverzamelaars, tijdreeksdatabases en visualisatielagen zoals Grafana en Graphite creëert zeer flexibele en schaalbare oplossingen.
- Het definiëren van vereisten, het toepassen van best practices en het uitvoeren van een proof of concept zijn essentieel voor het kiezen en implementeren van het meest geschikte monitoringplatform.
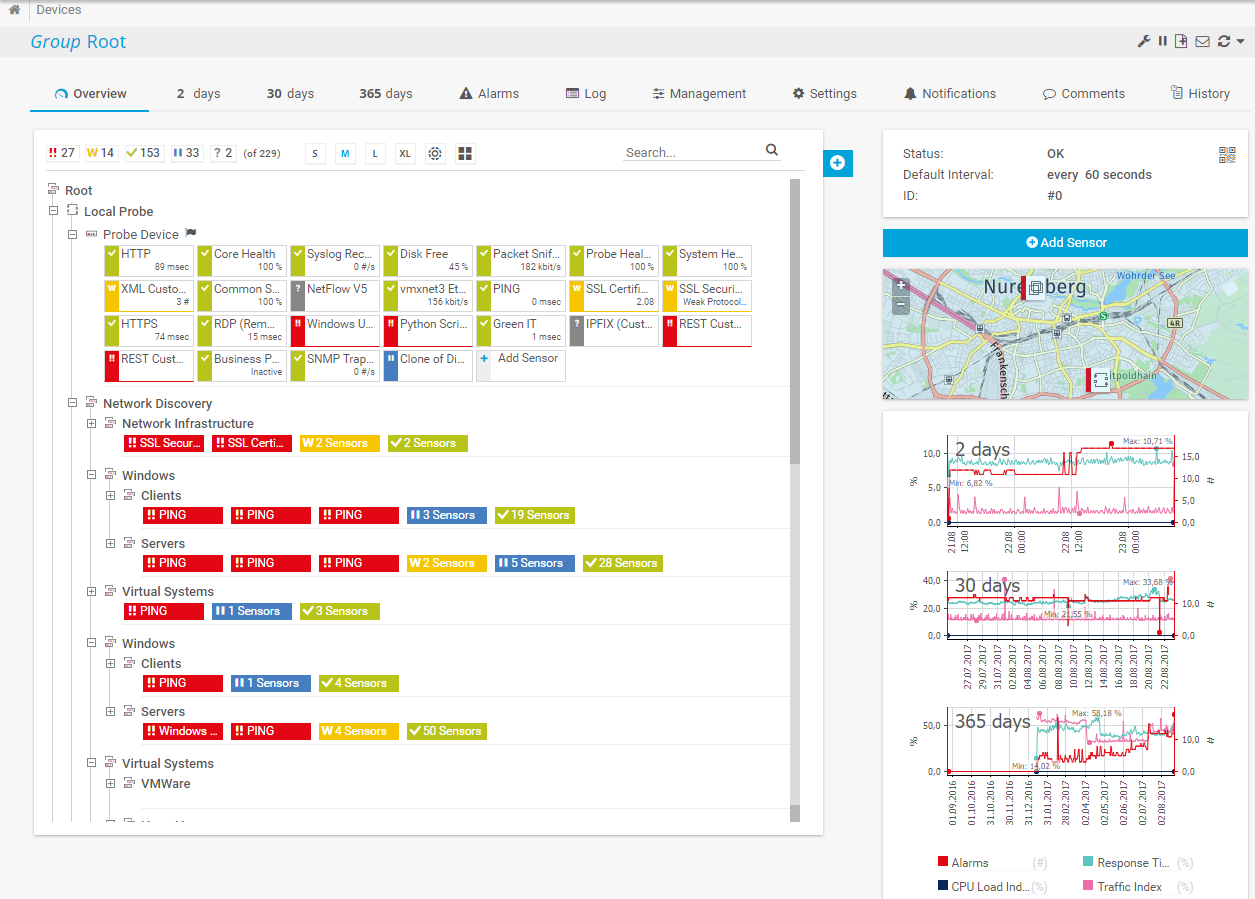
Wanneer het netwerk van een bedrijf trager wordt, de wifi-verbinding wegvalt of een cruciale server op het slechtst mogelijke moment crasht, is simpelweg "de router herstarten en hopen op het beste" niet meer voldoende. Tegenwoordig is het essentieel om open-source tools voor netwerkverkeersmonitoring te hebben waarmee je in realtime kunt zien wat er gebeurt, problemen kunt voorspellen en kostbare downtime kunt voorkomen.
Als je in de IT of netwerken werkt, of ooit technisch leider bent geweest binnen je bedrijf, heb je waarschijnlijk wel eens gehoord van oplossingen zoals PRTG of SolarWinds… en de bijbehorende licenties. Het goede nieuws is dat er een zeer volwassen ecosysteem van open-sourceplatformen bestaat voor het monitoren van apparaten, services en netwerkverkeer (routers, switches, wifi-toegangspunten, servers, containers, publieke clouds en nog veel meer) zonder exorbitante kosten en met ongelooflijke flexibiliteit.
Wat is realtime monitoring van netwerkverkeer en waarom is het zo belangrijk?
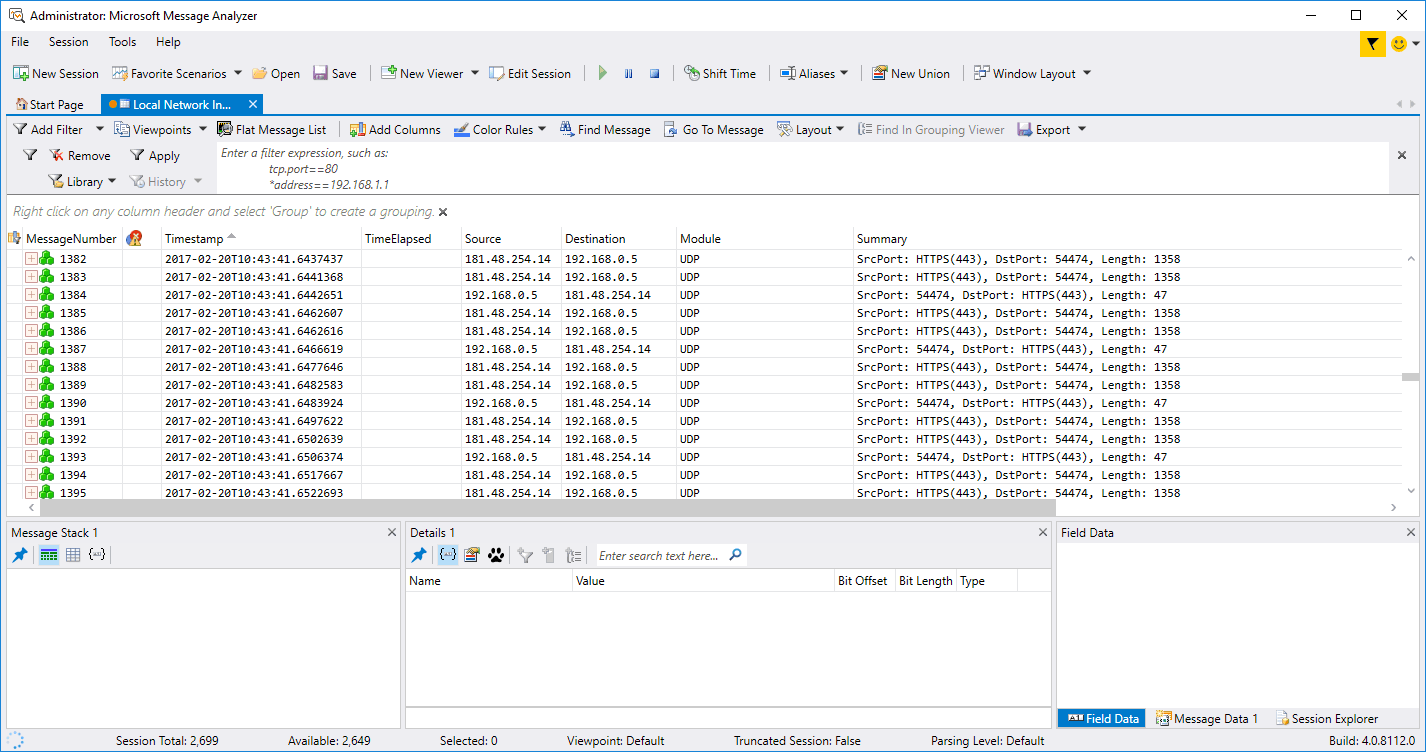
Wanneer we spreken over realtime netwerkmonitoring, bedoelen we de continue bewaking van de status, prestaties en beveiliging van de IT- en communicatie-infrastructuur , waarbij incidenten worden gedetecteerd zodra ze zich voordoen. De software verzamelt en analyseert continu meetgegevens van apparaten, systemen en applicaties, zodat het IT-team kan reageren voordat het probleem de bedrijfsvoering beïnvloedt.
Dit soort oplossingen maakt gebruik van protocollen zoals SNMP, NetFlow/sFlow, ICMP , API's en specifieke agents om gegevens te verzamelen van routers, switches, firewalls, access points, fysieke en virtuele servers, containers, cloudservices, webapplicaties, databases en vrijwel elk element dat deel uitmaakt van de infrastructuur.
Het hoofddoel is om volledig inzicht te krijgen in het verkeer, het bandbreedtegebruik, de beschikbaarheid en de status van elk onderdeel . Dit maakt het mogelijk om knelpunten , aanvallen, hardwarestoringen of serviceoverbelastingen te detecteren voordat ze leiden tot uitval, wijdverspreide vertragingen of gegevensverlies.
Naast realtime data bieden veel tools de mogelijkheid om historische meetwaarden op te slaan voor trendanalyses , capaciteitsplanning, verificatie van SLA/OLA-naleving, beveiligingsaudits en ondersteuning bij investeringsbeslissingen in nieuwe apparatuur of verbindingen.
Belangrijkste toepassingen en voordelen van realtime monitoring
Een van de grootste voordelen is het preventieve onderhoud van de IT- en netwerkinfrastructuur . Door continue metingen van CPU, geheugen, temperatuur, status van de voeding, interfacefouten en pakketverlies kunnen vroege tekenen van storingen worden opgespoord voordat een ernstige storing of serviceuitval optreedt.
Vroegtijdige incidentrespons is een andere belangrijke pijler. Monitoringplatforms genereren aanpasbare waarschuwingen (e-mail, sms, Slack, Teams, webhooks, enz.) wanneer een waarde een drempel overschrijdt, een service niet meer reageert of een verdacht verkeerspatroon verschijnt. Dit vermindert de downtime en de impact van beveiligingsincidenten of prestatieproblemen aanzienlijk.
In de dagelijkse bedrijfsvoering draagt monitoring bij aan het optimaliseren van de algehele prestaties van netwerken, servers en applicaties. Inzicht in welke verbindingen overbelast zijn, welke services de meeste resources verbruiken of welke tijdzones piekbelastingen veroorzaken, helpt bij het aanpassen van configuraties, het balanceren van de belasting, het herdefiniëren van QoS-beleid en, in het algemeen, het behalen van betere prestaties met de geïnstalleerde technologie.
Een ander steeds belangrijker aspect is de naleving van regelgeving. Een goed monitoringsysteem vergemakkelijkt toegangscontrole, het traceren van gevoelige gegevens en het detecteren van ongeautoriseerde toegang . Het systeem levert logboeken en statistieken die nuttig zijn voor audits en om aan te tonen dat aan wettelijke of contractuele eisen wordt voldaan.
Vanuit een zakelijk perspectief fungeren deze oplossingen ten slotte als hulpmiddelen voor besluitvorming : periodieke rapporten, managementdashboards, historische analyses van incidenten en beschikbaarheid, vergelijkingen tussen locaties of cloudproviders... dit alles helpt bij het rechtvaardigen van investeringen, het onderhandelen met derden en het prioriteren van IT-projecten.
Specifieke voordelen van open-source monitoringsoftware
Het eerste duidelijke voordeel van open-source tools is hun kosteneffectiviteit: er zijn geen gesloten licenties of hoge kosten per apparaat zoals bij veel commerciële platforms. Dit betekent niet dat alles gratis is (er zijn altijd kosten voor infrastructuur, ondersteuning en training), maar de besparing op licenties maakt ruimte vrij om te investeren in andere cruciale gebieden.
De tweede grote troef is de steun en innovatie vanuit de community . Projecten zoals Nagios, Zabbix, Prometheus, LibreNMS en Netdata hebben zeer actieve communities die plugins, integraties, dashboards en voortdurende verbeteringen ontwikkelen, en die bovendien snel bugs verhelpen en kwetsbaarheden dichten.
Het onderscheidt zich ook door de transparantie en betrouwbaarheid van de code : als open-source software kan iedereen controleren hoe gegevens worden verwerkt en opgeslagen, de systeembeveiliging beoordelen en de broncode aanpassen aan specifieke behoeften. Dit verkleint het risico op verborgen achterdeuren en maakt het gemakkelijker om te voldoen aan interne beveiligingsrichtlijnen.
Een ander belangrijk punt is het vermijden van vendor lock-in. Met open oplossingen is het gemakkelijker om tussen tools te migreren of ze te combineren (bijvoorbeeld Prometheus voor applicatiemetrieken, Zabbix voor netwerkapparaten en Grafana als een uniforme visualisatielaag), zonder levenslang vast te zitten aan de roadmap van één enkel bedrijf.
Het is vanzelfsprekend dat open-source tools doorgaans een zekere mate van technische vaardigheid vereisen voor installatie, configuratie en onderhoud , maar in ruil daarvoor bieden ze flexibiliteit en kracht die zich kunnen meten met veel commerciële oplossingen, met name in omgevingen waar maatwerk en integratie met bestaande systemen belangrijk zijn.
De beste open-source monitoringtools voor netwerken en infrastructuur
Er bestaan tientallen volwaardige projecten gericht op het monitoren van netwerken, servers, applicaties en cloudomgevingen. Hieronder vindt u een overzicht van de meest relevante open-source tools voor netwerkverkeer en -observatie , gebaseerd op diverse technische analyses en gespecialiseerde vergelijkingen.
Een klassiek voorbeeld is Nagios Core , een zeer robuuste monitoring- en alerting-engine. Het vormt de basis voor meerdere Nagios-projecten en regelt het plannen van controles, het verwerken van resultaten, het beheren van gebeurtenissen en het genereren van alerts. De modulaire architectuur maakt het mogelijk om de functionaliteit uit te breiden via aangepaste API's en plug-ins, en het ecosysteem is enorm, met integraties voor vrijwel elk type apparaat of service.
Een andere gigant in de open-sourcewereld is Zabbix , dat zich sterk richt op het monitoren van grootschalige IT-infrastructuren. Het is met name krachtig voor het verzamelen en analyseren van netwerkapparaatstatistieken (bandbreedtegebruik, interfacestatus, verbindingen, pakketverlies, temperatuur, CPU, geheugen, enz.), zowel via SNMP als met behulp van eigen agents. Gebruikers kunnen drempelwaarden, escalatiestromen voor waarschuwingen, schema's, notificatiekanalen en zeer gedetailleerde gebeurtenislogica definiëren.
Op het gebied van cloud-native applicaties en tijdreeksdata onderscheidt Prometheus zich . Deze oplossing maakt gebruik van een dimensionaal datamodel, geïdentificeerd door metrische namen en sleutel-waardeparen, en benut de PromQL-querytaal om grafieken, tabellen, waarschuwingsregels en complexe query's te creëren. De data wordt efficiënt opgeslagen in het geheugen en op de lokale schijf, waardoor individuele instanties zeer autonoom zijn, en de integratie met Grafana voor visualisatie verloopt naadloos.
Voor wie op zoek is naar een lichtgewicht oplossing gericht op zeer korte realtime-tijden en minimale latentie, is Netdata een zeer interessante optie. Het installeert zich als een agent op elke Linux-server of -apparaat, verzamelt systeem- en applicatiestatistieken, slaat de gegevens op de node zelf op (zonder op korte termijn afhankelijk te zijn van externe databases) en biedt geautomatiseerde dashboards met zeer gedetailleerde prestatievisualisaties, waarbij zelfs machine learning-modellen worden gebruikt om afwijkingen te detecteren.
Gespecialiseerde tools voor netwerk- en verkeersvisualisatie.
Naast algemene platformen zijn er open-source tools die specifiek gericht zijn op het monitoren van netwerkverkeer en het weergeven van prestatiegrafieken . Deze zijn vooral handig wanneer de focus ligt op het bekijken van bandbreedte, datastromen en de status van de verbinding.
Een van de populairste is Cacti , dat zich richt op het maken van netwerkgrafieken en het beheren van fouten voor operationele monitoring. Het gebruikt RRDTool om gegevens op te slaan en grafieken te genereren, biedt sjablonen om apparaatregistratie te automatiseren en ondersteunt meerdere methoden voor gegevensverzameling. De plug-ins (THold, SysLog, MacTrack, en andere) maken drempelwaarden, syslog-integratie, MAC-adresregistratie en realtime apparaatmonitoring mogelijk.
Een ander zeer krachtig platform is OpenNMS Horizon , dat wordt beschouwd als een van de eerste volledig open-source oplossingen voor netwerkservicemonitoring op bedrijfsniveau. Het ondersteunt de monitoring van lokale en gedistribueerde netwerken en biedt inventarisatie, foutbeheer, dataverzameling op afstand, alarmcorrelatie, monitoring van bedrijfsservices en verkeersmonitoring. Alles wordt beheerd via een intuïtieve webinterface met aanpasbare dashboards.
Op vergelijkbare wijze positioneert Icinga zich als een moderne evolutie van het Nagios-model, met een verfijnde webinterface en een sterke focus op netwerkmonitoring, interfaceprestaties, bandbreedtegebruik, fouten, CPU- en geheugenbelasting en hardwarestatus. Icinga ondersteunt SNMP-controles, leverancierspecifieke statistieken en het ontvangen van SNMP-traps, en integreert met Logstash om gebeurtenissen van meerdere apparaten te beheren.
Voor wie een zeer gedetailleerd overzicht van netwerkapparaten, interfaces en verkeer nodig heeft, zijn projecten zoals LibreNMS en Observium bijzonder nuttig. Beide maken veelvuldig gebruik van SNMP en discovery-protocollen (CDP, LLDP, OSPF, BGP, ARP, enz.) om het netwerk automatisch te ontdekken, kaarten te genereren en prestatiegegevens weer te geven met overzichtelijke grafieken , configureerbare drempelwaarden en flexibele waarschuwingssystemen.
Geavanceerde visualisatie met Grafana en Graphite
Bij veel complexe implementaties is de laag voor het verzamelen van meetgegevens gescheiden van de visualisatielaag. Twee belangrijke projecten in deze aanpak zijn Grafana en Graphite , beide open source en veelvuldig gebruikt in bedrijfsomgevingen.
Grafana is een platformonafhankelijke tool met plug-ins, ontworpen voor het creëren van volledig gepersonaliseerde dashboards voor datavisualisatie. Het stelt je in staat om meerdere databronnen (Prometheus, Graphite, InfluxDB, MySQL, cloudproviders, enz.) te koppelen en statistieken weer te geven in histogrammen, geografische kaarten, heatmaps, lijngrafieken, tabellen en vele andere soorten visualisaties. Grafana ondersteunt realtime annotaties, dynamische dashboards en het definiëren van waarschuwingen met notificaties naar verschillende kanalen.
Graphite is gericht op het vastleggen en visualiseren van tijdreeksgegevens. Het kan worden geïmplementeerd op eenvoudige hardware of in de cloud en is ideaal voor het monitoren van de prestaties van websites, bedrijfsdiensten, servers en netwerkgegevens . Veel teams kiezen voor op Graphite gebaseerde beheerde services (zoals MetricFire) die geclusterde opslag, datalabeling, extra integraties en multichannel-waarschuwingen toevoegen, terwijl ze nog steeds de kracht van Graphite en vaak Grafana voor de front-end benutten.
Bij een typische implementatie sturen netwerksystemen en servers meetgegevens naar Graphite of een compatibele collector (bijvoorbeeld met behulp van protocollen zoals StatsD), waarna dashboards in Grafana worden gebouwd om een uniform overzicht te bieden van de status van de gehele infrastructuur: van verkeer op elke interface tot querylatentie of CPU-gebruik per service.
Andere relevante open-source monitoringoplossingen
Het ecosysteem voor open-source monitoring is zeer breed en dekt specifieke behoeften zoals automatische detectie, procesmonitoring, observatiepipelines of het verzamelen van meetgegevens uit zeer heterogene omgevingen.
Checkmk is bijvoorbeeld een zeer schaalbaar platform dat geschikt is voor het monitoren van alles, van kleine omgevingen tot grote ondernemingen. Het omvat geavanceerd agentbeheer, automatische netwerkdetectie, interactieve visualisaties, krachtige waarschuwingssystemen, SLA-rapportage, log- en gebeurtenisanalyse en API's om de functionaliteit uit te breiden. Het wordt aangeboden in verschillende edities (gratis RAW, Enterprise, Cloud en MSP), aangepast aan verschillende groottes en servicemodellen.
M/Monit is gericht op het bewaken en zelfherstellen van Unix- en Linux-systemen. Het monitort processen, CPU- en geheugengebruik en netwerkinterfaces, en kan automatisch reageren op fouten door corrigerende acties uit te voeren. Het stelt u ook in staat om het opstarten van services te bewaken, bestanden en mappen te scannen op ongeautoriseerde wijzigingen en netwerkverbindingen met lokale of externe servers te controleren.
Op het gebied van netwerktopologie en -metriekanalyse onderscheidt Pandora FMS zich als een alles-in-één oplossing met monitoring van netwerk, gebruikerservaring, cloud, servers en applicaties, inventarisatie, logbeheer en aanpasbare dashboards. Het kan automatisch netwerkinterfaces detecteren, kaarten maken, realtime statistieken over knelpunten weergeven en uitgebreide rapporten leveren.
Voor moderne microservices en multi-cloudarchitecturen fungeert Sensu als een soort gecentraliseerde observatiepipeline die verschillende monitoringtools verenigt. Het biedt health checks, aangepaste prestatiemetingen, logbeheer, beheer van netwerkproblemen en multichannel-waarschuwingen met deduplicatie. Bovendien ondersteunt het zelfherstel door services opnieuw op te starten of aangepaste scripts uit te voeren wanneer het problemen detecteert.
Agenten, verzamelaars en hulpmiddelen
Naast de grote platforms zijn er ook kleinere tools waarvan de belangrijkste functie is om meetgegevens van systemen, sensoren en applicaties te verzamelen en naar databases of centrale monitoringsystemen te sturen.
Een uitstekend voorbeeld is Telegraf , een op Go gebaseerde agent zonder externe afhankelijkheden, die kan werken via een uitgebreid plugin-systeem. Met meer dan 300 input/output-plugins kan Telegraf metrics en events uit diverse technologiestacks extraheren en de data naar systemen zoals InfluxDB, Graphite, OpenTSDB, Datadog, Librato en andere sturen. De in-memory buffers zorgen ervoor dat metrics niet verloren gaan, zelfs als de hoofdbackend tijdelijk niet beschikbaar is.
Een ander belangrijk element in veel architecturen is het gebruik van specifieke exporters en collectors (bijvoorbeeld in het Prometheus-ecosysteem, met exporters voor databases, webservers, wachtrijsystemen, enz.), waarmee metrics in een standaardformaat beschikbaar kunnen worden gesteld zonder dat elke applicatie opnieuw hoeft te worden geschreven.
Door agents zoals Telegraf, gespecialiseerde exporttools en tijdreeks- en visualisatieplatformen te combineren, is het mogelijk zeer complete oplossingen te bouwen voor het monitoren van netwerken, servers, applicaties en clouds , volledig gebaseerd op open source software of met minimale commerciële componenten wanneer officiële ondersteuning gewenst is.
Deze modulaire aanpak heeft als voordeel dat elke organisatie alleen de onderdelen kan selecteren die ze nodig heeft , deze kan integreren met haar bestaande systemen (ticketing, CMDB, SIEM, enz.) en de architectuur kan laten evolueren naarmate de omgeving groeit of verandert in de richting van containers, Kubernetes of serverloze services.
Hoe kies je de beste open-source tool voor netwerkmonitoring?
Voordat je de eerste populaire tool installeert, is het belangrijk om duidelijk te definiëren wat je wilt monitoren : alleen het fysieke netwerk (routers, switches, access points), of ook servers, virtuele machines, containers, applicaties, of zelfs de gebruikerservaring en cloudservices? Deze prioritering stelt je in staat om het aanbod te beperken en oplossingen te kiezen die goed aansluiten bij je primaire gebruiksscenario.
Het is belangrijk om de belangrijkste functionaliteiten te bepalen die u nodig hebt: rapportages, waarschuwingen, datavisualisatie, opslag van historische gegevens, integratie met systemen van derden, API's en ondersteuning voor specifieke protocollen (SNMP, NetFlow, WMI, cloud-API's, enz.). Prometheus is bijvoorbeeld ideaal wanneer aangepaste metrics en complexe waarschuwingsregels vereist zijn; Cacti blinkt uit in het weergeven van grafieken van netwerkverkeer; en Checkmk biedt interactieve visualisatie en uitgebreide SLA-rapporten.
Gebruiksgemak en configuratie zijn ook belangrijke factoren. Tools zoals Zabbix, Netdata of Checkmk bieden doorgaans gebruiksvriendelijke installatiewizards en dashboards, terwijl zeer flexibele oplossingen mogelijk meer initiële configuratie vereisen. Het is raadzaam om de netwerkdetectie-interface, het aanmaken van hosts en services en de waarschuwingsconfiguratie te testen voordat u een beslissing neemt.
Wat betreft beveiliging is het essentieel dat het platform encryptie, sterke authenticatie en op rollen gebaseerde toegangscontrole ondersteunt . Sommige platforms, zoals OpenNMS, Icinga of Prometheus, bieden de mogelijkheid om geavanceerde modules of configuraties toe te voegen om de beveiliging te versterken, de toegang tot gegevens te segmenteren en te voldoen aan interne of wettelijke normen. Daarnaast is het raadzaam dit aan te vullen met best practices voor geavanceerde firewallconfiguratie op servers.
Tot slot is het ten zeerste aan te raden een proof of concept (POC) uit te voeren met 2 of 3 finalisten , deze te implementeren in een gecontroleerde omgeving, een representatieve subset van de infrastructuur te monitoren en de prestaties, het gebruiksgemak, de kwaliteit van de waarschuwingen en de integratiemogelijkheden met bestaande tools (ticketsystemen, CI/CD, berichtenverkeer, enz.) te evalueren.
Beste werkwijzen voor effectieve netwerkmonitoring
Zodra het platform is gekozen, hangt het succes grotendeels af van hoe de implementatie is ontworpen. Een cruciale eerste stap is het documenteren en in kaart brengen van het netwerk : welke apparaten aanwezig zijn, waar ze zich bevinden, welke verbindingen ze gebruiken, welke kritieke services ze ondersteunen en welke afhankelijkheden er tussen hen bestaan. Dit maakt het gemakkelijker om te bepalen wat en hoe er gemonitord moet worden. Voor een beter begrip van netwerktopologieën en -typen, zie Computernetwerken: typen en voorbeelden.
Het is raadzaam om een of meer standaard communicatieprotocollen te kiezen voor apparaten die informatie naar de tool sturen: SNMP voor netwerkapparatuur, agents voor servers, Prometheus exporters voor specifieke services, syslog voor gebeurtenissen, enzovoort. Hoe homogener de aanpak, hoe gemakkelijker het onderhoud op de lange termijn zal zijn.
Het is ook belangrijk om basiswaarden vast te stellen : normale waarden voor latentie, bandbreedte, CPU, geheugen, gelijktijdige verbindingen, enz. Dit maakt het mogelijk om realistische drempelwaarden in te stellen en afwijkingen nauwkeuriger te detecteren, waardoor zowel valse alarmen als gemiste meldingen van echte incidenten worden voorkomen.
Het opzetten van overzichtelijke, rolspecifieke dashboards (24/7-operaties, netwerk, systemen, beheer, enz.) helpt de diagnosetijd te verkorten. Een NOC heeft overzichten en realtime waarschuwingen nodig; een netwerkbeheerder gedetailleerde interfaces, fouten en wachtrijen; en een CIO beschikbaarheid en SLA's voor kritieke services.
Tot slot is het essentieel om een escalatiebeleid voor meldingen vast te stellen : wie ontvangt welk type melding, via welk kanaal en met welke prioriteit; wat er buiten werktijd gebeurt; wat als een groot incident wordt beschouwd; en hoe de reactie tussen teams wordt gecoördineerd. Zelfs de beste tools ter wereld verliezen hun effectiviteit als niemand reageert op meldingen of als er geen duidelijk actieplan is.
Rekening houdend met al deze factoren, bieden open-source oplossingen voor netwerkverkeersmonitoring de mogelijkheid om uiterst robuuste omgevingen te bouwen, met end-to-end zichtbaarheid, beslissingsondersteuning en een solide basis voor het verbeteren van de beveiliging, beschikbaarheid en prestaties van elke infrastructuur, van een klein bedrijf tot een grote gedistribueerde onderneming.