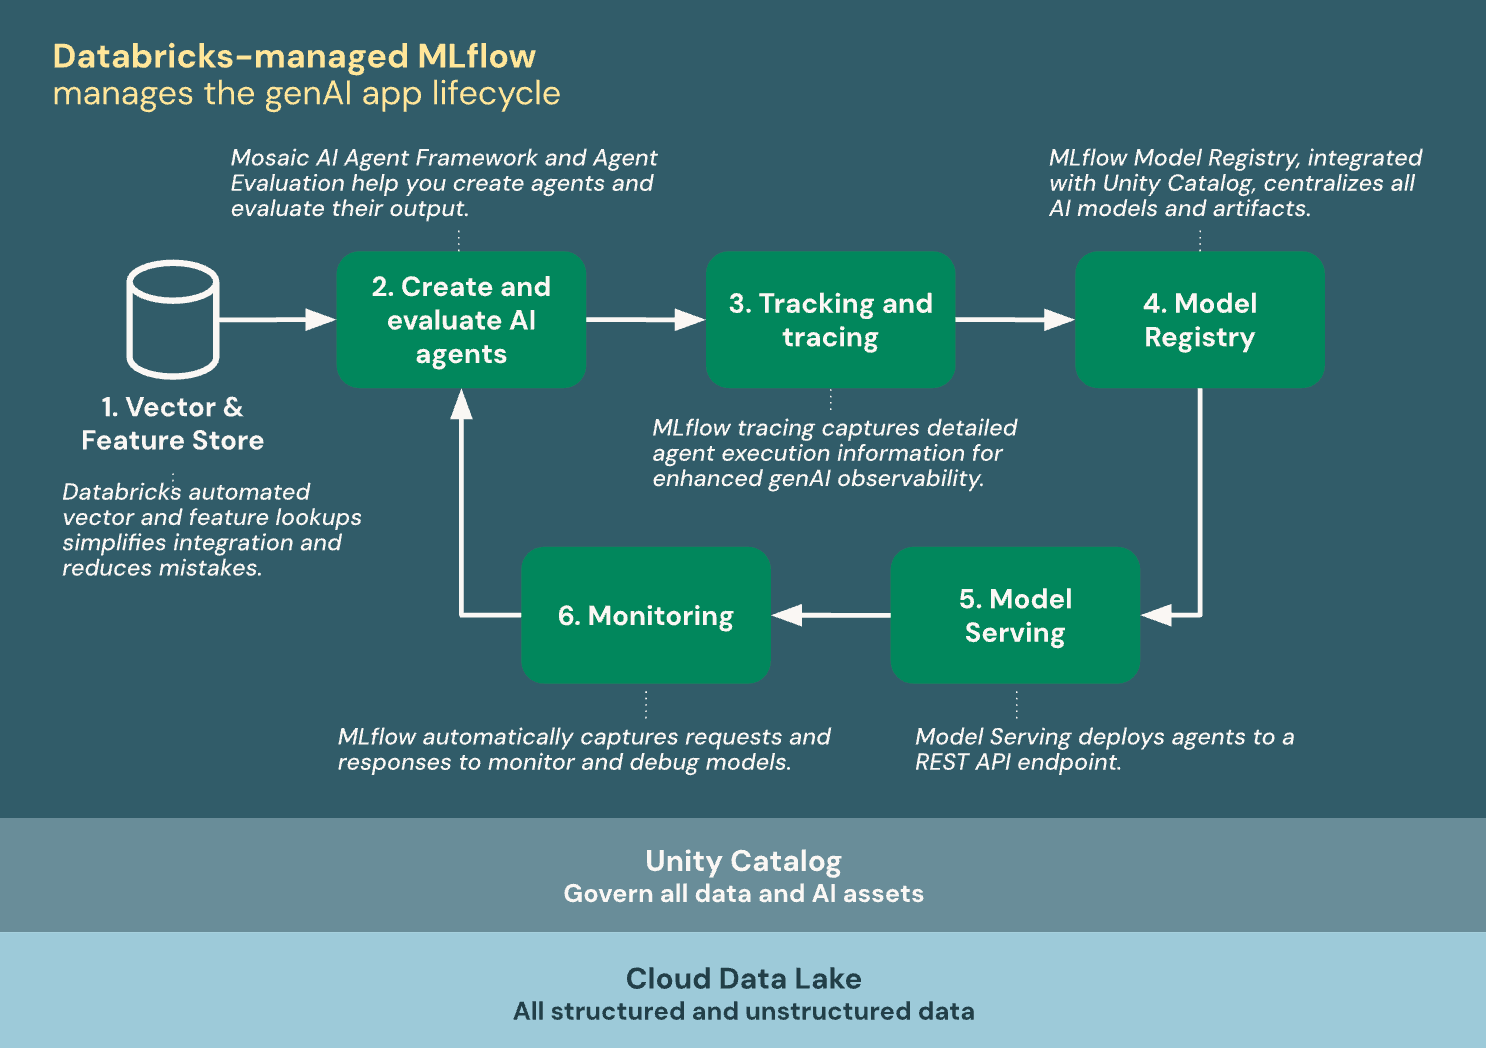
- Agent Bricks, AI Playground i MLflow obejmują wszystkie etapy, od prototypu po wdrożenie, a zarządzanie odbywa się w Unity Catalog.
- ResponsesAgent oferuje strumieniowanie, obsługę wielu agentów i bogate śledzenie zintegrowane z MLflow i AI Gateway.
- Wdrażanie za pomocą metody deploy() tworzy bezpieczne punkty końcowe ze śledzeniem i przeglądaniem w czasie rzeczywistym.

Tworzenie agentów AI w Databricks nie jest już wyłączną domeną ultratechnicznych profili: dzięki wizualnym środowiskom takim jak AI Playground , automatyzacji z Agent Bricks i frameworkom MLflow możesz teraz przejść od pomysłu do prototypu i od prototypu do produkcji, nie gubiąc się w tym procesie. W tym przewodniku podsumowujemy wszystko, czego potrzebujesz do tworzenia, ewaluacji i wdrażania agentów, którzy wywołują narzędzia, wysyłają zapytania do danych i integrują się z zarządzaniem katalogiem Unity.
Oprócz zgłębienia podejścia no-code i programowania w Pythonie, dowiesz się, jak tworzyć pakiety agentów za pomocą MLflow (ChatAgent i ResponsesAgent) , rejestrować zasoby w katalogu, włączać monitorowanie w czasie rzeczywistym i skalować za pomocą Model Serving. Dołączamy również przykładową aplikację zbudowaną w React i FastAPI , która pozwoli Ci bezproblemowo zintegrować agenta z korporacyjnym interfejsem internetowym.
Opcje tworzenia agentów w Databricks
Jeśli priorytetem jest dla Ciebie szybkość i prostota, Agent Bricks oferuje zautomatyzowany przepływ pracy do tworzenia wysokiej jakości systemów agentowych dostosowanych do domeny. Wystarczy określić przypadek użycia i połączyć dane z katalogu Unity ; platforma generuje warianty agentów, optymalizuje je poprzez ocenę i umożliwia ich udoskonalanie, a wszystko to z wbudowanymi funkcjami zarządzania i bezpieczeństwa.
Gdy potrzebujesz precyzyjnej kontroli i chcesz ponownie wykorzystać znane biblioteki, podejście oparte na kodzie łączy Mosaic AI Agent Framework i MLflow . Dzięki Pythonowi możesz definiować logikę agenta, włączać wywołania narzędzi, prowadzić szczegółowe śledzenie, a ostatecznie pakować i wdrażać w środowisku produkcyjnym za pomocą ekosystemu Databricks.
Jeśli korzystasz już z frameworków innych firm, dostępne jest natywne wsparcie dla LangGraph/ LangChain , LlamaIndex lub niestandardowych implementacji Pythona. Dzięki sygnaturom modeli i interfejsom agentów MLflow możesz je zintegrować z funkcjami ewaluacji i monitorowania bez konieczności przepisywania kodu od podstaw.
Chcesz błyskawicznie tworzyć prototypy? Z AI Playground wybierasz model i maszynę wirtualną, dodajesz narzędzia do LLM za pośrednictwem interfejsu low-code i czatujesz, aby je zweryfikować. Następnie eksportujesz agenta do kodu gotowego do produkcji i kontynuujesz standardowy cykl rozwoju.
Podpisy modeli i zgodność z funkcjami platformy
Usługa Azure Databricks używa sygnatur modelu MLflow do opisu schematu wejściowego i wyjściowego agentów. Funkcje produktu, takie jak AI Playground czy ocena, wymagają, aby agent był zgodny z jednym z obsługiwanych sygnatur, aby zapewnić interoperacyjność.
Jeśli zastosujesz się do zalecanego podejścia podczas tworzenia agenta, MLflow automatycznie wywnioskuje zgodny podpis bez żadnych dodatkowych kroków. W przeciwnym razie sprawdź, czy Twoja implementacja jest zgodna z jednym z podpisów w starszym schemacie dla danych wejściowych i wyjściowych agenta, aby uniknąć niespodzianek podczas integracji z narzędziami Databricks.
Szybki samouczek: Pierwszy agent z platformą agentów AI Mosaic
Celem jest stworzenie agenta, który rozumuje za pomocą LLM prowadzony w Databricks i móc uruchamiać narzędzia, na przykład wbudowaną funkcję system.ai.python_exec z katalogu Unity, aby uruchomić kod Pythona. Dodatkowo włączymy śledzenie za pomocą MLflow do kontroli śladów i diagnostyki.
Podstawowe wymagania dotyczące obszaru roboczego: włącz funkcje agenta i posiadaj dostęp do Model ServingW środowisku wykonawczym zainstaluj pakiety takie jak: mlflow, databricks-openai i agent pakujący (databricks-agent o databricks-agents(w zależności od przewodnika, którego używasz i wersji) i uruchom ponownie Pythona, aby załadować zależności.
Zdefiniuj połączenie z usługą modelu za pomocą udostępnianego przez nią klienta OpenAI Klient obszaru roboczego, aktywny mlflow.openai.autolog() do automatycznej aparatury pomiarowej i rejestruje dostępne narzędzia. Wśród nich, system.ai.python_exec Działa jako bezstanowy interpreter języka Python i umożliwia LLM wykonywanie obliczeń lub manipulowanie danymi podczas dialogu.
Z funkcją taką jak run_agent(), wysyłasz monit użytkownika do punktu końcowego czatu (Na przykład model taki jak «databricks-claude-3-7-sonet«i zarządzać możliwymi wzywa narzędzia zwracanie wiadomości asystenta i odpowiedzi narzędzi w formie spójnej listy.
Aby przetestować, uruchom zapytanie wymagające kodu (np. obliczenia setnej liczby Fibonacciego ) i przejrzyj zarówno dane wyjściowe kreatora, jak i ślady MLflow zarejestrowane w powiązanym notatniku lub eksperymencie. Pozwoli to na dopracowanie orkiestracji przed spakowaniem.
Spakowane z MLflow i wdrożone w Model Serving
Zalecanym sposobem przygotowania agenta do produkcji jest wdrożenie interfejsu Agent czatu MLflowPotrzebujesz metody predict() który akceptuje wiadomości, wywołuje logikę agenta i zwraca Odpowiedź agenta czatu z listą wiadomości (w tym wiadomości pośrednie związane z narzędziami, jeśli ma to zastosowanie).
Aby ułatwić obsługę, skonsoliduj cały kod w jednym pliku Pythona (na przykład używając %%writefile quickstart_agent.py (jeśli pracujesz na laptopie). W ostatniej części zadzwoń mlflow.models.set_model() przekazując instancję swojej klasy (np. QuickstartAgent) w celu ustalenia punkt wejścia wnioskowanie.
Zarejestruj agenta w Katalog Unity z mlflow.pyfunc.log_model, włącznie z zasoby które będą potrzebne w produkcji: punkt końcowy modelu LLM (np. DatabricksServingEndpoint) i funkcje katalogowe, które agent będzie wywoływał (np. DatabricksFunction z system.ai.python_execW ten sposób Databricks może Konfiguruj uwierzytelnianie dla tych zasobów podczas wdrażania.
Na koniec użyj API agenta, aby rozmieścić modelu do punktu końcowego usługi: from databricks import agents y agents.deploy(model_name, model_version)Po uruchomieniu punktu końcowego będziesz mógł Czat z AI PlaygroundPodziel się tym z zainteresowanymi stronami i zacznij zbierać opinie.
Jeśli chcesz nadal się doskonalić, Databricks oferuje przewodniki dotyczące pomiaru jakości agentów , tworzenia agentów z funkcją wyszukiwania (RAG) na podstawie niestrukturyzowanych danych i kontrolowania konwersacji wieloetapowych, a także alternatywy z LangGraph, czystym Pythonem lub OpenAI.
ResponsesAgent: Nowoczesny interfejs dla agentów produkcyjnych
Chociaż Agent czatu Działa dobrze, MLflow poleca to dzisiaj Agent odpowiedzi Dla poważnych agentów. Ten interfejs jest zgodny ze schematem Responses z OpenAI i umożliwia integrację agentów z dowolne ramy z możliwościami Databricks (rejestracja, śledzenie, ocena, wdrażanie i obserwowalność) bez żadnych problemów.
Główne zalety: natywne wsparcie dla Sistemas wieloagentowy, tryb wyjścia Streaming, pełna historia wiadomości i wywołań narzędzi, potwierdzenie wywołań narzędzi i trwałe narzędzia. Ponadto oferuje interfejsy typowane W Pythonie automatyczne wnioskowanie podpisów, automatyczne śledzenie predict y predict_stream i ulepszone tabele wnioskowania za pośrednictwem Brama AI.
Wymagania instalacyjne dla tego podejścia: databricks-agents 1.2.0 +, mlflow 3.1.3 + y Pythona 3.10+ (używając Serverless lub Databricks Runtime 13.3 LTS+). Databricks zaleca również następujące pakiety: Most AI do typowych integracji.
Przydatne integracje: databricks-openai (Otwarta AI), databricks-langchain (LangChain/LangGraph), databricks-dspy (DSPy) i databricks-ai-bridge (Agenci w czystym Pythonie). Za pomocą tych elementów możesz zbudować wszystko, od prostych agentów po złożone rurociągi z odzyskiwaniem i wybieraniem narzędzi.
Jeśli masz już wbudowanego agenta, umieść go w klasie dziedziczącej po mlflow.pyfunc.ResponsesAgent. Wdrożyć predict aby przekonwertować wejścia i wyjścia na Schemat agenta odpowiedziDo strumieniowania polegaj na predict_streamemitujące delty i wydarzenie końcowe response.output_item.done Proszę dodać pełną odpowiedź.
W przypadku błędów przesyłania strumieniowego Mosaic AI propaguje błąd wraz z ostatnim tokenem w databricks_output.errorTwój klient powinien uchwycić i wyświetlić go prawidłowo, poprawiając doświadczenie oczyszczenia.
Systemy odzyskiwania, niestandardowe dane wejściowe i możliwość śledzenia
Wielu agentów korzysta recyklerzy dla RAG-ów na indeksach wektorowych. Jeśli zakresy pobierania ujawniają inny schemat, możesz go zmapować za pomocą mlflow.models.set_retriever_schemadeklarując primary_key, text_column, doc_uri i inne kolumny. W ten sposób AI Playground pokaże Linki do źródeł odzyskane i ocena będzie miała zastosowanie wskaźniki trafności automatycznie.
W przypadkach, gdy Twój agent wymaga dodatkowych informacji (na przykład: typ_klienta o identyfikator sesji), używa custom_inputs i zwraca metadane w custom_outputs co nie powinno zanieczyszczać historii czatu. Zarówno AI Playground, jak i aplikacja do recenzji pozwalają na wprowadzenie niestandardowe_dane_wejściowe z interfejsu użytkownika.
Wdrażanie za pomocą metody „deploy(), wymagania i zautomatyzowane działania”
Aby opublikować agenta w usłudze Mosaic AI Model Serving, użyj funkcji deploy() API Pythona. W MLflow 3 zainstaluj mlflow >= 3.1.3 y databricks-agents >= 1.1.0 (jeśli wdrażasz poza notebookami). W MLflow 2.x wartości minimalne ulegają zmianie (na przykład mlflow >= 2.13.1 y databricks-agents >= 0.12.0Upewniać się Zarejestruj agenta w katalogu Unity przed wdrożeniem.
Dzwonić do deploy() zbuduj skalowalny punkt końcowy z automatyczne równoważenie, skonfiguruj bezpieczne uwierzytelnianie w przypadku zasobów Databricks (indeksy wektorowe, funkcje katalogowe) —sprawdzanie uprawnień właściciela — i aktywowanie przejrzyj aplikację do współpracy z interesariuszami.
Umożliwia również monitorowanie w czasie rzeczywistym w MLflow (ze śladami w aktywnym eksperymencie i tabelach wnioskowania). W MLflow 3 można skonfigurować monitorowanie produkcji z automatyczną oceną jakości; żądania REST i komentarze są rejestrowane w tabelach wnioskowania (z wykorzystaniem nowoczesnych interfejsów API do sprzężenia zwrotnego).
Aby dostosować, przekaż argumenty do deploy() jako scale_to_zero_enabled=TrueObniżanie kosztów po przestoju kosztem większego opóźnienia przy pierwszym żądaniu. Dodatkowo dostępne są narzędzia do lista, pobieranie i usuwanie wdrożenia poprzez API agenta.
Dobre praktyki dotyczące wzorców stanu, konfiguracji i wykonywania
Modelowanie jest rozproszone: unikaj lokalne pamięci podręczne i zakłada, że różne odpowiedzi mogą odpowiadać różnym zwrotom akcji w rozmowie. Rekonstruuje stan z słownik ResponsesAgentRequest w każdym predict i zaprojektować państwo tak, aby było bezpieczny dla wątków.
Inicjuje stan w predict a nie w konstruktorze agenta, ponieważ pojedyncza replika mogłaby obsługiwać konwersacje różnych użytkowników. Zapobiega to wycieki informacji i konfliktów współbieżności w środowiskach o wysokiej przepustowości.
Sparametryzuj zachowanie agenta za pomocą ModelConfig (słownik lub YAML). Zdefiniuj na przykład: model_serving_endpointParametry LLM i szablony komunikatów; załaduj tę konfigurację do środowiska programistycznego i przenieś ją do środowiska produkcyjnego bez dotykania kodu.
Unikaj wprowadzania pętli zdarzeń lub ramek asynchronicznych na serwerze agenta: Databricks obsługuje współbieżność wewnętrznie . Używaj kodu synchronicznego lub wywołań zwrotnych; w przeciwnym razie mogą wystąpić błędy, takie jak „Ta pętla zdarzeń jest już uruchomiona” i nieregularne działanie.
Agent Bricks: automatyzacja „bez kodu” przyspieszająca tworzenie wartości
Rozwiązanie Agent Bricks, wprowadzone w 2025 roku, oferuje płynny proces tworzenia agentów , który nie wymaga kodowania . Wprowadzasz zadanie w języku naturalnym, łączysz dane, a platforma wybiera modele, generuje dane syntetyczne , ocenia i udoskonala proces, aż do dostarczenia agenta gotowego do produkcji z zarządzaniem katalogiem Unity.
Do jego zalet należą kompleksowa automatyzacja , skalowalność w Databricks — z punktami końcowymi, które mogą skalować się do zera po 3 dniach bezczynności —, analiza wykorzystania i kosztów w Lakehouse oraz gotowe typy agentów (ekstrahowanie informacji, niestandardowy LLM , asystent wiedzy i nadzorca wielu agentów na potrzeby złożonej orkiestracji).
Do ograniczeń należy zaliczyć fakt, że wygenerowanego kodu nie można obecnie pobrać , co ogranicza możliwości głębokiej personalizacji, a katalog szablonów jest skierowany do organizacji, które są już zintegrowane z Lakehouse i Unity Catalog. Niektórzy użytkownicy uważają również, że wskaźniki kosztów są mało szczegółowe .
Przykłady: agenci wieloagentowi i agenci stanowi
W oficjalnej dokumentacji znajdziesz notatniki z OpenAI (proste wywołania czatu i narzędzi, zarówno dla modeli hostowanych w Databricks, jak i OpenAI), LangGraph (wywołanie narzędzi) i DSPy (wywołanie narzędzi w jednym kroku). Stanowią one doskonałą podstawę do rozszerzania funkcjonalności o niestandardowe narzędzia i oceny jakości.
Aby koordynować pracę wielu specjalistów, można skonfigurować systemy kooperacyjne za pomocą narzędzi takich jak Genie. A jeśli interesuje Cię pamięć konwersacji, dostępna jest obsługa agentów stanowych, które umożliwiają tworzenie punktów kontrolnych i utrwalanie wątków czatu.
W oficjalnej dokumentacji znajdziesz notatniki z OpenAI (proste wywołania czatu i narzędzi, zarówno dla modeli hostowanych w Databricks, jak i OpenAI), LangGraph (wywołanie narzędzi) i DSPy (wywołanie narzędzi w jednym kroku). Stanowią one doskonałą podstawę do rozszerzania funkcjonalności o niestandardowe narzędzia i oceny jakości.
Aplikacje w Databricks: interfejs użytkownika z React i zapleczem w FastAPI
Aplikacje Databricks zapewniają solidną platformę do dostarczania rozbudowanych interfejsów bez konieczności konfigurowania zewnętrznej infrastruktury. Integrują się natywnie z Databricks SQL, Unity Catalog , Model Serving i Jobs, a także dziedziczą zabezpieczenia i kontrolę zgodności platformy.
Bardzo praktycznym rozwiązaniem jest stworzenie front-endu z React (obsługującego streaming, renderowanie wiadomości i UX w Markdown) oraz back-endu z FastAPI , który działa jako pomost do punktu końcowego agenta. Back-end kieruje żądanie użytkownika do usługi modelu i zwraca ustrukturyzowaną odpowiedź klientowi.
W FastAPI kolejność montażu podaplikacji ma znaczenie: app.mount("/api", api_app) kieruje trasami API (na przykład, /api/chat) I app.mount("/", ui_app) Obsługuje statyczne pliki z kompilacji React w katalogu głównym. Ten schemat utrzymuje przejrzystość tras i oddziela interfejs użytkownika od punktów końcowych.
Skonfiguruj zmienne środowiskowe (np. SERVING_ENDPOINT_NAME lub pełną nazwę kwalifikowaną modelu agenta w Unity Catalog) z definicji aplikacji w Databricks. Skompiluj front-end (npm run build), synchronizuje pliki, deklaruje zależności (requirements.txt) i zaczyna się od Gunicorn + Uvicorn pracownicy ASGI.
Przypadek rzeczywisty: chatbot dla operacji produkcyjnych
W scenariuszach zarządzania operacjami produkcyjnymi (MOM) chatbot Databricks może pomagać kierownikom produkcji w analizie wąskich gardeł , śledzeniu zapasów i generowaniu raportów. Funkcje są udostępniane jako narzędzia w katalogu Unity (za pośrednictwem SQL lub Pythona), a agent wywołuje je w zależności od kontekstu.
Przykłady: funkcja identify_bottleneck_station Uruchamia zapytania w Databricks SQL w celu wykrycia etapu powodującego największe opóźnienia; kolejny, check_inventory_levelsZwraca stan zapasów w czasie rzeczywistym. Agent może również wysyłać e-maile, tworzyć raporty i przeprowadzać analizę nastrojów, wszystko to zorganizowano za pomocą narzędzi.
Wdrożenie punktu końcowego Model Serving działa jak standardowe zaplecze . Aplikacja React korzysta z tego punktu końcowego, wyświetlając odpowiedzi w czasie rzeczywistym, zapewniając dopracowany interfejs użytkownika i obsługując strumieniowe przesyłanie tokenów po włączeniu tej funkcji w ResponsesAgent.
Migracja z ChatCompletions i kompatybilność
Jeśli Twój starszy agent korzysta z interfejsu API ChatCompletions firmy OpenAI , możesz przeprowadzić migrację do ResponsesAgent z kontenerem, który tłumaczy wiadomości przychodzące/wychodzące i opcjonalnie mapuje delty strumieniowania na ResponsesAgentStreamEvent . Modernizuje to telemetrię i obserwowalność bez przepisywania głównej logiki.
Do wyświetlania i zarządzania wdrożeniami, API agenta umożliwia wyświetlanie istniejących wdrożeń, pobieranie konkretnych wdrożeń (według nazwy i wersji) oraz usuwanie niepotrzebnych punktów końcowych. Pamiętaj, aby zarządzać poświadczeniami zasobów zewnętrznych za pomocą zmiennych środowiskowych i kluczy tajnych.
Databricks oferuje kompleksową ścieżkę: od koncepcji z AI Playground lub automatyzacji z Agent Bricks, przez tworzenie kodu (Mosaic AI, MLflow, LangGraph, DSPy), po pakowanie, rejestrację w katalogu Unity , wdrożenie z funkcją „deploy()” i monitorowanie produkcji. Dzięki najlepszym praktykom, takim jak odpowiednie podpisy modeli , bezpieczny stan w środowiskach rozproszonych i sparametryzowana konfiguracja, możesz dostarczać niezawodnych, zarządzanych agentów gotowych do integracji z aplikacjami internetowymi na platformie.
