- LiteRT zastępuje TensorFlow Lite jako uniwersalna platforma Google do uruchamiania sztucznej inteligencji na urządzeniach mobilnych, stacjonarnych i urządzeniach IoT.
- Optymalizuje wnioskowanie poprzez użycie NPU, GPU i CPU, osiągając wzrost prędkości nawet 100-krotnie w porównaniu z tradycyjnymi CPU.
- LiteRT-LM specjalizuje się w koordynacji modeli LLM i modeli generatywnych, takich jak Gemma, usprawniając zarządzanie pamięcią i kontekstem lokalnym.
- Zapewnia pełną zgodność z PyTorch, JAX i TensorFlow, umożliwiając bezproblemową konwersję modeli do formatu .tflite.

Generatywna sztuczna inteligencja robi niesamowity krok naprzód i nie polega już tylko na wysyłaniu danych do chmury i oczekiwaniu na odpowiedź. Teraz majstersztykiem jest uruchamianie wszystkiego bezpośrednio na urządzeniu , niezależnie od tego, czy jest to telefon komórkowy, czy środowisko brzegowe, dzięki czemu korzystanie z niego jest natychmiastowe, a przede wszystkim prywatność danych nie jest zależna od zewnętrznych serwerów.
W tym kontekście pojawia się LiteRT, nowy standard Google'a, który ma zastąpić weterana TensorFlow Lite. Nie jest to prosta poprawka, ale uniwersalna infrastruktura zaprojektowana, aby umożliwić programistom wdrażanie zaawansowanych modeli AI na dowolnej platformie, od smartwatcha po komputer z systemem Windows, maksymalizując wykorzystanie dostępnego sprzętu.

Czym jest LiteRT i dlaczego zmienia zasady gry?
LiteRT jest zasadniczo następcą TensorFlow Lite i został stworzony, aby sprostać wyzwaniom fragmentacji sprzętu. Podczas gdy tradycyjne uczenie maszynowe koncentrowało się na prostych zadaniach, takich jak rozpoznawanie obrazu, GenAI wymaga znacznie bardziej agresywnego zarządzania zasobami . Ta platforma umożliwia powtarzalne i wydajne wnioskowanie, niezależnie od tego, czy urządzenie działa na systemie Android, iOS, macOS, Linux, czy nawet jest aplikacją internetową.
Dla osób budujących startupy lub rozwijających produkty technologiczne to całkowita zmiana paradygmatu. Dzięki lokalnemu uruchamianiu modeli, opóźnienia ulegają drastycznej redukcji , a cykliczne koszty związane z zewnętrznymi interfejsami API zostają wyeliminowane, co pozwala aplikacjom działać idealnie nawet bez połączenia z internetem.
Silnik przyspieszający: moc procesora CPU, GPU i NPU

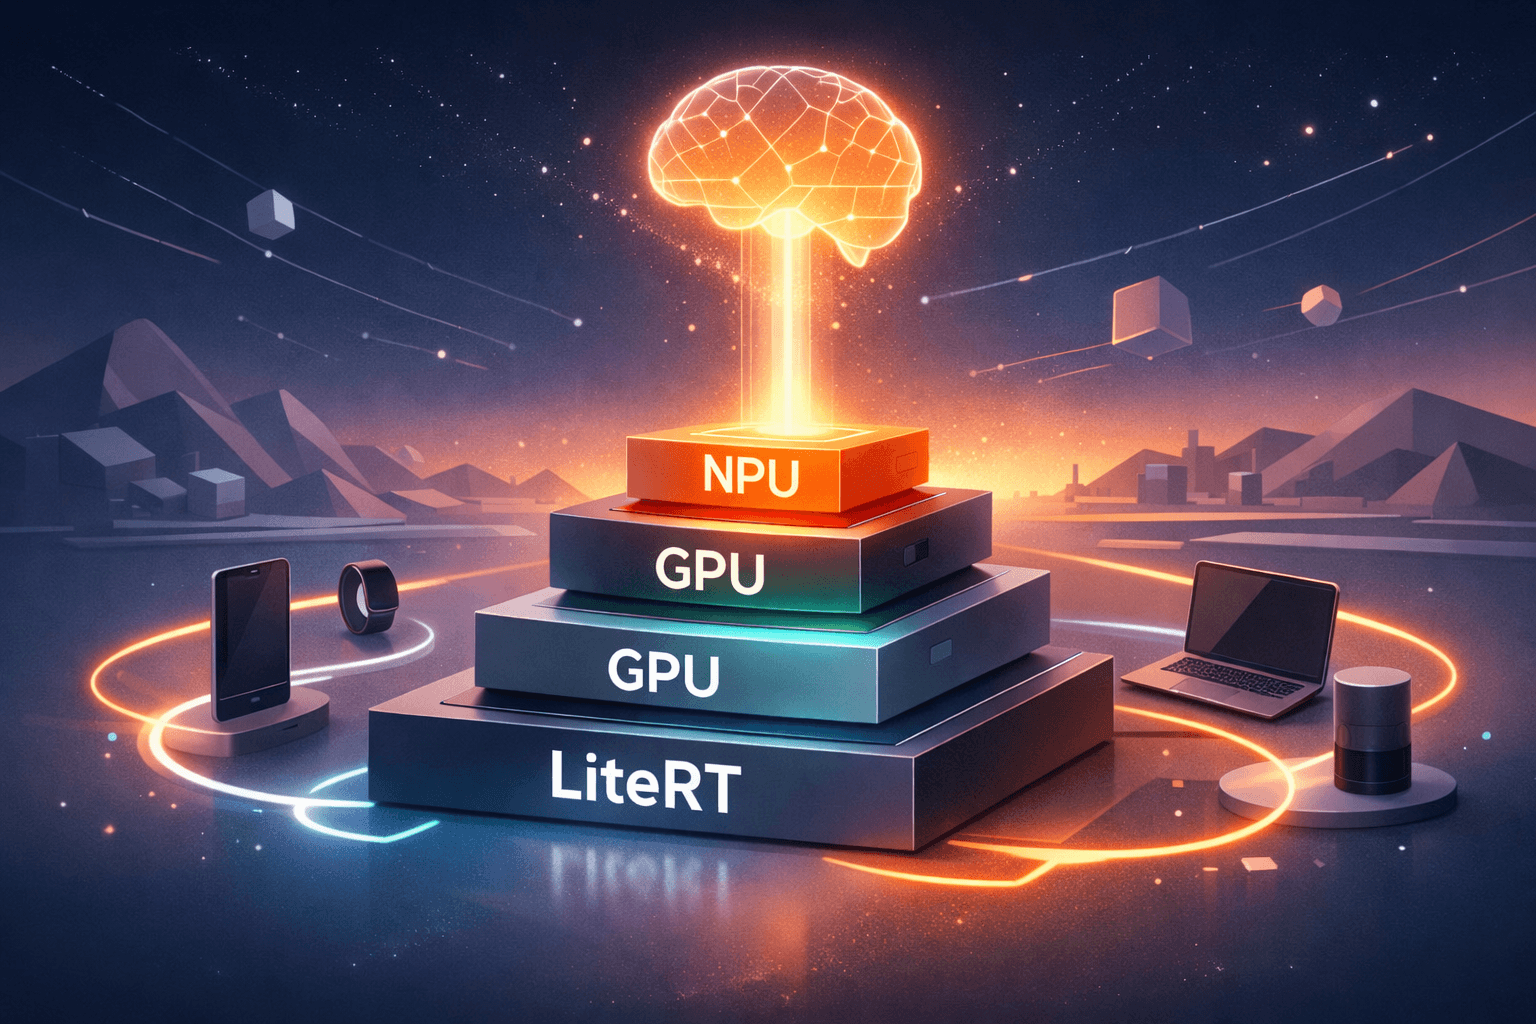
Prawdziwą siłą LiteRT jest jego zdolność do wyciśnięcia ostatniej kropli wydajności z każdego układu. Dzięki silnikowi o nazwie ML Drift system może zarządzać akceleracją GPU za pomocą różnych interfejsów API, takich jak Metal, OpenCL, OpenGL i WebGPU. Co więcej, na Androidzie środowisko uruchomieniowe jest na tyle inteligentne, że automatycznie priorytetyzuje OpenCL, jeśli jest dostępne, a OpenGL wykorzystuje tylko jako rozwiązanie zapasowe.
Ale to, czym LiteRT naprawdę się wyróżnia, to jego NPU (jednostka przetwarzania neuronowego). Dzięki współpracy z Qualcomm, akcelerator QNN umożliwia zwiększenie szybkości nawet 100 razy szybciej niż procesor CPU i 10 razy szybciej niż GPU w niektórych scenariuszach. To przekształca sztuczną inteligencję z powolnego eksperymentu w realne narzędzie produkcyjne.
LiteRT-LM: Orkiestracja generatywnej sztucznej inteligencji i LLM
Kiedy mówimy o dużych modelach językowych (LLM), sprawy się komplikują, ponieważ nie są to proste modele, a raczej złożone potoki. Właśnie tutaj pojawia się LiteRT-LM – specjalistyczna warstwa orkiestracji, która efektywnie zarządza pamięcią, buforami i kontekstem. To ta sama technologia, która napędza Gemini Nano na Pixel Watch i Chrome.

Aby ułatwić życie programistom, Google dodało generatywne API LiteRT Torch. Narzędzie to umożliwia łatwą konwersję modeli opartych na PyTorch, umożliwiając ultraszybkie działanie otwartych modeli, takich jak Gemma , na urządzeniu. W rzeczywistych testach porównawczych LiteRT udowodnił , że przewyższa llama.cpp pod względem szybkości wstępnego wypełniania i dekodowania, lepiej wykorzystując możliwości sprzętowe.
Innowacje techniczne: kopiowanie bez użycia kopii i wykonywanie asynchroniczne
Jednym z częstych wąskich gardeł w mobilnej sztucznej inteligencji jest przepływ danych między procesorem a akceleratorem. LiteRT rozwiązuje ten problem dzięki zarządzaniu buforem bez kopii , które zapobiega niepotrzebnemu duplikowaniu danych w pamięci. Model odczytuje informacje bezpośrednio z miejsca, w którym się znajdują, co przyspiesza zadania takie jak segmentacja w tle nawet dwukrotnie.
Co więcej, nowe API CompiledModel umożliwia asynchroniczne uruchamianie wnioskowania. Oznacza to, że aplikacja nie zawiesza się podczas przetwarzania danych przez sztuczną inteligencję, co poprawia płynność interfejsu użytkownika. System analizuje sprzęt w czasie rzeczywistym i wybiera najlepszy akcelerator, nie wymagając od programisty pisania osobnego kodu dla każdego układu.
Elastyczność ram i strategiczne wdrażanie
Najlepsze jest to, że nie zmusza Cię do korzystania tylko z jednego języka. LiteRT jest kompatybilny z PyTorch, JAX i TensorFlow . Jeśli masz już skonfigurowany potok treningowy, nie musisz go pozbywać się; możesz przekonwertować swoje modele do formatu .tflite i wdrożyć je w dowolnym obsługiwanym systemie operacyjnym.
Wdrożenie tego rozwiązania przez firmy wymaga jasnej strategii. Sam model nie wystarczy; należy go połączyć z tworzeniem oprogramowania na zamówienie i infrastrukturą chmury obliczeniowej, aby w razie potrzeby umożliwić skalowanie sztucznej inteligencji. Co więcej, przy przenoszeniu sztucznej inteligencji na urządzenie, cyberbezpieczeństwo staje się kluczowe , ponieważ kluczowe jest zapewnienie, że poufne informacje nigdy nie opuszczą sprzętu użytkownika.
Wdrożenie tego standardu umożliwia tworzenie autonomicznych agentów reagujących w czasie rzeczywistym , zmniejszając zależność od drogich serwerów. Organizacje, które zintegrują lokalne wnioskowanie już dziś, zyskają znaczącą przewagę konkurencyjną pod względem kosztów, prywatności i szybkości reakcji w porównaniu z tymi, które nadal polegają wyłącznie na chmurze.

Wskaźnik