- Monitorizarea traficului de rețea în timp real permite anticiparea defecțiunilor, îmbunătățirea performanței și consolidarea securității infrastructurii IT.
- Instrumentele open source precum Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS sau Observium oferă funcții avansate fără costuri de licență.
- Combinația dintre colectoarele de metrici, bazele de date cu serii temporale și straturile de vizualizare precum Grafana și Graphite creează soluții extrem de flexibile și scalabile.
- Definirea cerințelor, aplicarea celor mai bune practici și efectuarea unei dovezi de concept sunt esențiale pentru alegerea și implementarea celei mai potrivite platforme de monitorizare.
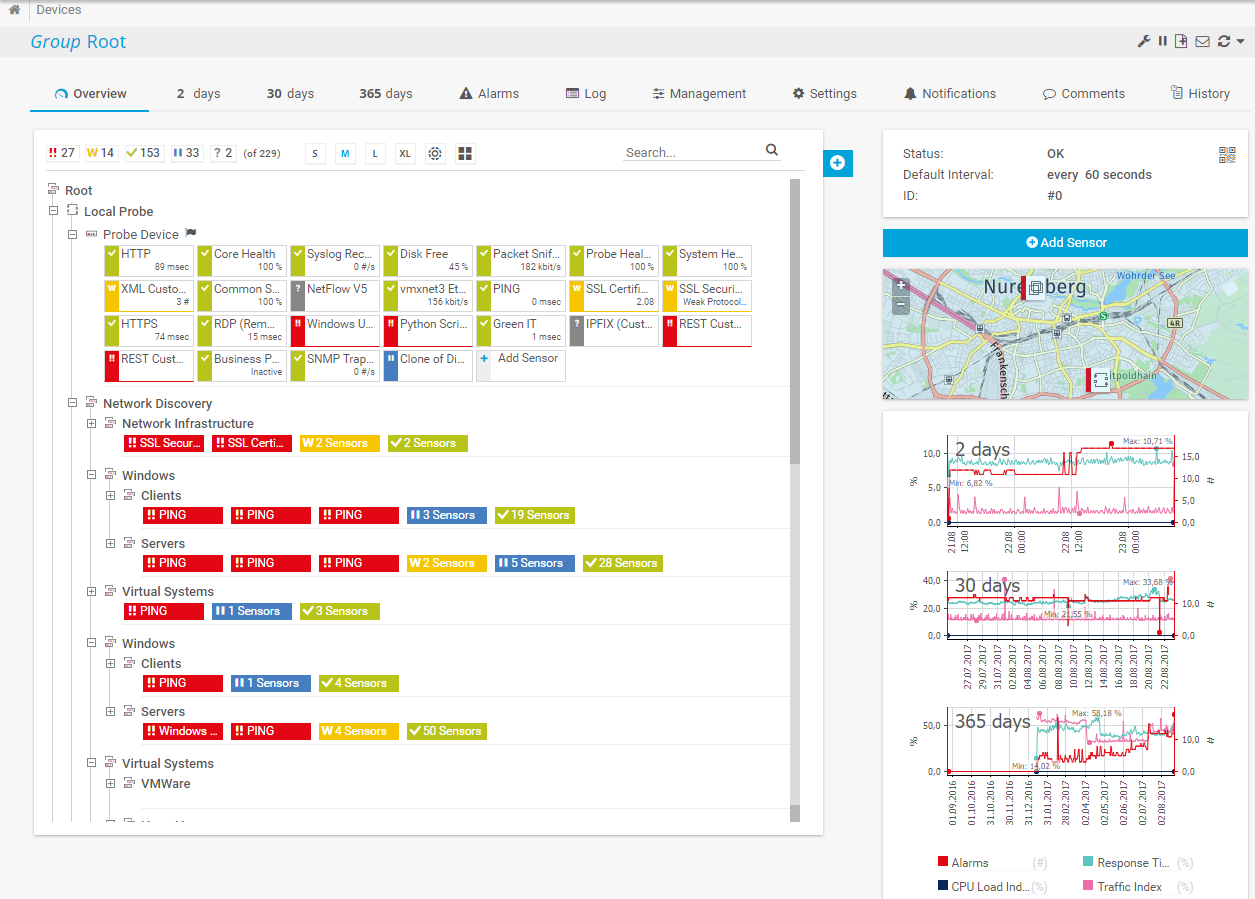
Când rețeaua unei companii începe să încetinească, Wi-Fi-ul se întrerupe sau un server critic se blochează în cel mai nepotrivit moment posibil, simpla „repornire a routerului și ținerea pumnelor” nu mai este suficientă. Astăzi, este esențial să existe instrumente open-source de monitorizare a traficului de rețea care să permită observarea în timp real a problemelor, anticiparea problemelor și evitarea perioadelor de nefuncționare costisitoare.
Dacă lucrezi în IT, în rețele sau ai fost vreodată lider tehnic în compania ta, probabil ai auzit de soluții precum PRTG sau SolarWinds... și licențele lor. Vestea bună este că există un ecosistem foarte matur de platforme open-source pentru monitorizarea dispozitivelor, serviciilor și traficului de rețea (routere, switch-uri, puncte de acces Wi-Fi, servere, containere, cloud public și multe altele) fără taxe exorbitante și cu o flexibilitate incredibilă.
Ce este monitorizarea traficului de rețea în timp real și de ce este atât de importantă?
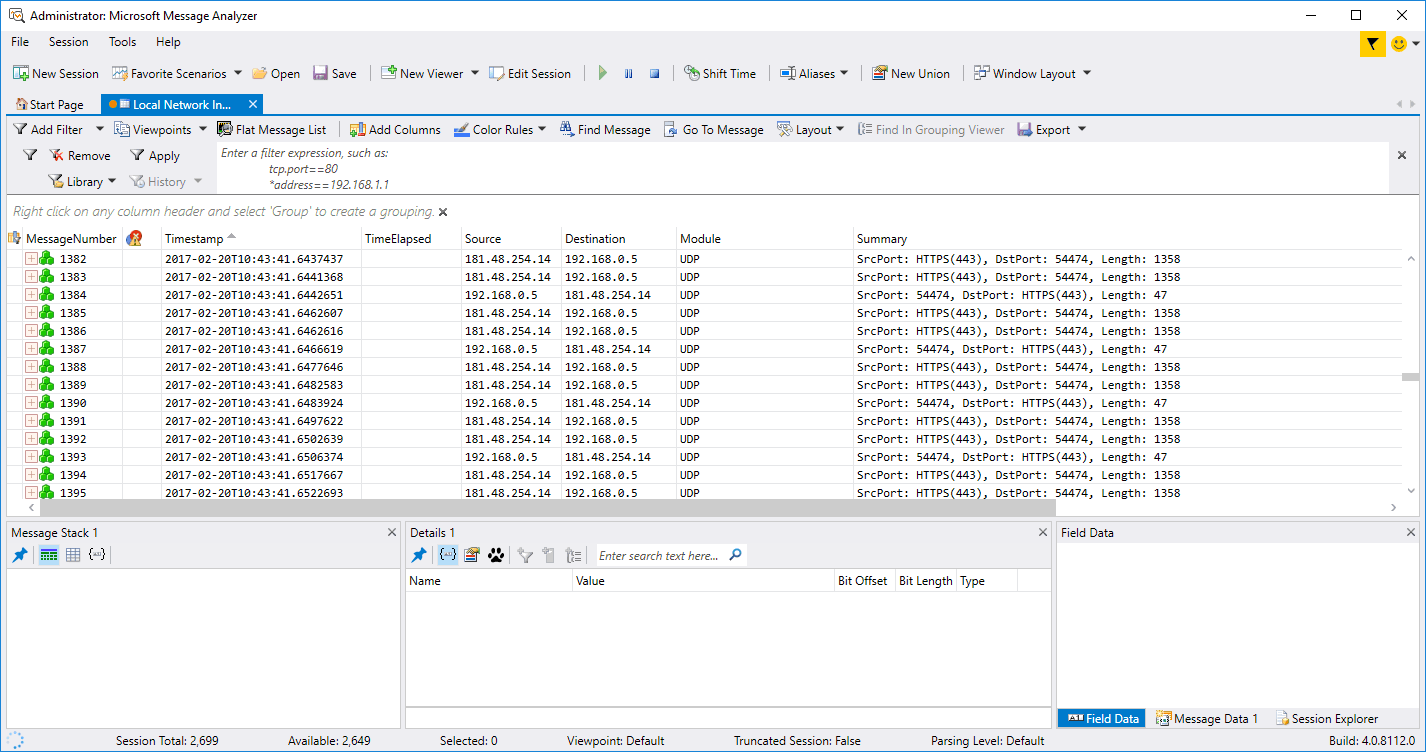
Când vorbim despre monitorizarea rețelei în timp real, ne referim la supravegherea continuă a stării, performanței și securității infrastructurii IT și de comunicații , detectând incidentele în momentul în care acestea apar. Software-ul colectează și analizează constant indicatori de la dispozitive, sisteme și aplicații, astfel încât echipa IT să poată reacționa înainte ca problema să afecteze afacerea.
Aceste tipuri de soluții se bazează pe protocoale precum SNMP, NetFlow/sFlow, ICMP , API-uri și agenți specifici pentru a colecta date de la routere, switch-uri, firewall-uri, puncte de acces, servere fizice și virtuale, containere, servicii cloud, aplicații web, baze de date și practic orice element care face parte din infrastructură.
Obiectivul principal este de a avea o vizibilitate completă asupra traficului, utilizării lățimii de bandă, disponibilității și stării de funcționare a fiecărei componente . Acest lucru permite detectarea blocajelor , atacurilor, defecțiunilor hardware sau supraîncărcărilor de servicii înainte ca acestea să ducă la întreruperi, lentoarea generalizată sau pierderi de date.
Pe lângă datele în timp real, multe instrumente vă permit să stocați valori istorice pentru analiza tendințelor , planificarea capacității, verificarea conformității SLA/OLA, auditarea securității și asistență pentru deciziile de investiții în echipamente sau legături noi.
Principalele utilizări și beneficii ale monitorizării în timp real
Unul dintre cele mai mari beneficii este mentenanța preventivă a infrastructurii IT și de rețea . Deținerea unor valori continue privind procesorul, memoria, temperatura, starea sursei de alimentare, erorile de interfață și pierderea de pachete ajută la detectarea timpurie a semnelor de defecțiune înainte de a apărea o defecțiune gravă sau o întrerupere a serviciului.
Răspunsul timpuriu la incidente este un alt pilon cheie. Platformele de monitorizare generează alerte personalizabile (e-mail, SMS, Slack, Teams, webhook-uri etc.) atunci când o valoare depășește un prag, un serviciu nu răspunde sau apare un model de trafic suspect. Acest lucru reduce dramatic timpul de nefuncționare și impactul incidentelor de securitate sau al defecțiunilor de performanță.
În operațiunile zilnice, monitorizarea contribuie la optimizarea performanței generale a rețelelor, serverelor și aplicațiilor. Posibilitatea de a vedea ce legături sunt congestionate, ce servicii consumă cele mai multe resurse sau ce fusuri orare cauzează vârfuri de sarcină ajută la ajustarea configurațiilor, echilibrarea sarcinilor, redefinirea politicilor QoS și, în general, la obținerea unei performanțe mai bune de la tehnologia instalată.
Un alt aspect din ce în ce mai important este conformitatea cu reglementările. Un sistem de monitorizare bun facilitează controlul accesului, urmărirea datelor sensibile și detectarea accesului neautorizat , furnizând jurnale și valori utile pentru audituri și pentru demonstrarea conformității cu cerințele de reglementare sau contractuale.
În cele din urmă, dintr-o perspectivă de business, aceste soluții devin instrumente de asistență decizională : rapoarte periodice, tablouri de bord executive, analize istorice ale incidentelor și disponibilității, comparații între locații sau furnizori de cloud… toate acestea ajută la justificarea investițiilor, negocierea cu terți și prioritizarea proiectelor IT.
Avantajele specifice ale software-ului de monitorizare open-source
Primul avantaj evident al instrumentelor open-source este rentabilitatea lor: nu există licențe închise sau costuri agresive per dispozitiv, precum cele întâlnite pe multe platforme comerciale. Aceasta nu înseamnă că totul este gratuit (există întotdeauna costuri de infrastructură, asistență și instruire), dar economiile la licențe eliberează spațiu pentru investiții în alte domenii critice.
Al doilea punct forte major este sprijinul comunității și inovația . Proiecte precum Nagios, Zabbix, Prometheus, LibreNMS și Netdata au comunități foarte active care dezvoltă pluginuri, integrări, tablouri de bord și îmbunătățiri constante, precum și remedierea rapidă a erorilor și închiderea vulnerabilităților.
De asemenea, se remarcă prin transparența și fiabilitatea codului său : fiind software open-source, oricine poate audita modul în care datele sunt procesate și stocate, poate revizui securitatea sistemului și poate adapta codul sursă la nevoi specifice. Acest lucru reduce riscul apariției unor backdoor-uri ascunse și facilitează respectarea politicilor de securitate interne.
Un alt punct cheie este evitarea dependenței de un singur furnizor. Cu soluții deschise, este mai ușor să migri între instrumente sau să le combini (de exemplu, folosind Prometheus pentru metricile aplicațiilor, Zabbix pentru dispozitivele de rețea și Grafana ca strat de vizualizare unificat), fără a fi legați de foaia de parcurs a unei singure companii pe viață.
Evident, instrumentele open-source necesită de obicei un anumit nivel de competențe tehnice pentru instalare, configurare și întreținere , dar în schimb oferă flexibilitate și putere care concurează direct cu multe soluții comerciale, în special în mediile în care personalizarea și integrarea cu sistemele existente sunt apreciate.
Instrumente de monitorizare open-source de top pentru rețele și infrastructură
Există zeci de proiecte mature axate pe monitorizarea rețelelor, serverelor, aplicațiilor și mediilor cloud. Mai jos este o prezentare generală a celor mai relevante instrumente open-source pentru traficul de rețea și observabilitate , bazată pe diverse analize tehnice și comparații specializate.
Unul dintre exemplele clasice este Nagios Core , un motor de monitorizare și alertare extrem de robust. Acesta servește drept fundație pentru mai multe proiecte Nagios și se ocupă de programarea verificărilor, procesarea rezultatelor, gestionarea evenimentelor și generarea de alerte. Arhitectura sa modulară permite extinderea capabilităților prin API-uri și plugin-uri personalizate, iar ecosistemul său este vast, cu integrări pentru aproape orice tip de dispozitiv sau serviciu.
Un alt gigant din lumea open-source este Zabbix , care se concentrează în mare măsură pe monitorizarea infrastructurilor IT la scară largă. Este deosebit de puternic pentru colectarea și analizarea indicatorilor de performanță ai dispozitivelor de rețea (utilizarea lățimii de bandă, starea interfeței, legăturile, pierderea de pachete, temperatura, procesorul, memoria etc.), fie prin SNMP, fie cu proprii agenți. Permite utilizatorilor să definească praguri, fluxuri de escaladare a alertelor, programări, canale de notificare și o logică de evenimente extrem de granulară.
În domeniul aplicațiilor cloud-native și al datelor din serii temporale, Prometheus iese în evidență . Această soluție utilizează un model de date dimensional, identificat prin nume de metrici și etichete cheie-valoare și valorifică limbajul de interogare PromQL pentru a crea diagrame, tabele, reguli de alertă și interogări complexe. Datele sale sunt stocate eficient în memorie și pe discul local, ceea ce face ca instanțele individuale să fie extrem de autonome și se integrează perfect cu Grafana pentru vizualizare.
Pentru cei care caută o soluție ușoară, axată pe timpi reali foarte scurți și latență minimă, Netdata este o opțiune foarte interesantă. Se instalează ca agent pe fiecare server sau dispozitiv Linux, colectează metrici de sistem și aplicație, stochează datele chiar pe nod (fără a se baza pe baze de date externe pe termen scurt) și oferă tablouri de bord automate cu vizualizări ale performanței extrem de detaliate, utilizând chiar și modele de învățare automată pentru a detecta anomalii.
Instrumente specializate pentru vizualizarea rețelelor și a traficului
Dincolo de platformele de uz general, există instrumente open-source care vizează direct monitorizarea traficului de rețea și graficele de performanță , utile în special atunci când accentul se pune pe vizualizarea lățimii de bandă, a fluxurilor și a stării de sănătate a legăturilor.
Unul dintre cele mai populare este Cacti , care se concentrează pe crearea de grafice de rețea și gestionarea erorilor pentru monitorizarea operațională. Folosește RRDTool pentru a stoca date și a genera grafice, oferă șabloane pentru automatizarea înregistrării dispozitivelor și acceptă multiple metode de achiziție de date. Pluginurile sale (THold, SysLog, MacTrack, printre altele) permit stabilirea de praguri, integrarea syslog, urmărirea adreselor MAC și monitorizarea dispozitivelor în timp real.
O altă platformă foarte puternică este OpenNMS Horizon , considerată una dintre primele soluții complet open-source de monitorizare a serviciilor de rețea la nivel de întreprindere. Aceasta suportă monitorizarea rețelelor locale și distribuite, oferind inventar, gestionarea defecțiunilor, colectarea de date la distanță, corelarea alarmelor, monitorizarea serviciilor de business și monitorizarea traficului. Totul este gestionat printr-o interfață web intuitivă cu tablouri de bord personalizabile.
În mod similar, Icinga se poziționează ca o evoluție modernă a modelului Nagios, cu o interfață web rafinată și un accent puternic pe monitorizarea rețelei, performanța interfeței, utilizarea lățimii de bandă, erori, încărcarea CPU și a memoriei și starea hardware-ului. Icinga acceptă verificări SNMP, metrici specifice furnizorului și recepționarea capcanelor SNMP, integrându-se cu Logstash pentru a gestiona evenimentele de pe mai multe dispozitive.
Pentru cei care au nevoie de o imagine foarte detaliată a dispozitivelor de rețea, a interfețelor și a traficului, proiecte precum LibreNMS și Observium sunt deosebit de utile. Ambele se bazează în mare măsură pe SNMP și protocoale de descoperire (CDP, LLDP, OSPF, BGP, ARP etc.) pentru a descoperi automat rețeaua, a genera hărți și a prezenta indicatori de performanță cu grafice clare , praguri configurabile și sisteme de alertare flexibile.
Vizualizare avansată cu Grafana și Graphite
În multe implementări complexe, stratul de colectare a indicatorilor este separat de stratul de vizualizare. Două proiecte cheie în această abordare sunt Grafana și Graphite , ambele open source și utilizate pe scară largă în mediile enterprise.
Grafana este un instrument multiplatformă, cu plugin-uri, conceput pentru a crea tablouri de bord de vizualizare a datelor complet personalizate. Acesta vă permite să conectați mai multe surse de date (Prometheus, Graphite, InfluxDB, MySQL, furnizori de cloud etc.) și să afișați valori în histograme, hărți geografice, hărți termice, grafice liniare, tabele și multe alte tipuri de vizualizări. Acceptă adnotări în timp real, tablouri de bord dinamice și definirea alertelor cu notificări către diverse canale.
Graphite se concentrează pe capturarea și reprezentarea grafică a indicatorilor de serie temporală. Poate fi implementat pe hardware simplu sau în cloud și este ideal pentru monitorizarea performanței site-urilor web, a serviciilor enterprise, a serverelor și a indicatorilor de rețea . Multe echipe optează pentru servicii gestionate bazate pe Graphite (cum ar fi MetricFire) care adaugă stocare în cluster, etichetare a datelor, integrări suplimentare și alerte multicanal, valorificând în același timp puterea Graphite și adesea a Grafana pentru front-end.
Într-o implementare tipică, sistemele de rețea și serverele trimit metrici către Graphite sau către un colector compatibil (de exemplu, folosind protocoale precum StatsD), iar apoi tablourile de bord sunt construite în Grafana pentru a oferi o imagine unificată a stării întregii infrastructuri: de la traficul pe fiecare interfață până la latența interogărilor sau utilizarea CPU per serviciu.
Alte soluții relevante de monitorizare open-source
Ecosistemul de monitorizare open source este foarte vast și acoperă nevoi specifice, cum ar fi descoperirea automată, monitorizarea proceselor, conductele de observabilitate sau colectarea de metrici din medii foarte eterogene.
De exemplu, Checkmk este o platformă extrem de scalabilă, capabilă să monitorizeze totul, de la medii mici la întreprinderi mari. Include management avansat al agenților, descoperire automată a rețelei, vizualizări interactive, sisteme puternice de alertă, raportare SLA, analiză a jurnalelor și evenimentelor și API-uri pentru a-i extinde funcționalitatea. Este oferită în diferite ediții (RAW gratuit, Enterprise, Cloud și MSP), adaptându-se la diverse dimensiuni și modele de servicii.
M/Monit se concentrează pe monitorizarea și repararea automată a sistemelor Unix și Linux. Monitorizează procesele, utilizarea procesorului și a memoriei, precum și interfețele de rețea și poate reacționa automat la erori prin efectuarea de acțiuni corective. De asemenea, vă permite să monitorizați pornirea serviciilor, să scanați fișiere și directoare pentru modificări neautorizate și să verificați conexiunile de rețea la servere locale sau la distanță.
În domeniul topologiei rețelei și al analizei metricilor, Pandora FMS se remarcă ca o soluție all-in-one, oferind monitorizare a rețelei, UX, cloud, serverelor și aplicațiilor, inventar, gestionare a jurnalelor și tablouri de bord personalizabile. Poate detecta automat interfețele de rețea, poate crea hărți, poate afișa statistici în timp real privind blocajele și poate oferi rapoarte complete.
Pentru microserviciile moderne și arhitecturile multi-cloud, Sensu acționează ca un fel de conductă centralizată de observabilitate care unifică diverse instrumente de monitorizare. Oferă verificări ale stării de funcționare, indicatori de performanță personalizati, gestionarea jurnalelor, gestionarea problemelor de rețea și alerte multi-canal cu deduplicare. În plus, acceptă auto-repararea prin executarea de reporniri de servicii sau scripturi personalizate atunci când detectează probleme.
Agenți, colectori și instrumente auxiliare
Pe lângă platformele mari, există instrumente mai ușoare a căror funcție principală este de a colecta și trimite metrici de la sisteme, senzori și aplicații către baze de date sau sisteme principale de monitorizare.
Un exemplu excelent este Telegraf , un agent bazat pe Go, fără dependențe externe, capabil să funcționeze printr-un sistem vast de plugin-uri. Cu peste 300 de plugin-uri de intrare/ieșire, Telegraf poate extrage metrici și evenimente din diverse stive tehnologice și poate trimite datele către sisteme precum InfluxDB, Graphite, OpenTSDB, Datadog, Librato și altele. Buffer-urile sale în memorie asigură că metricile nu se pierd chiar dacă backend-ul principal este temporar nefuncțional.
Un alt element important în multe arhitecturi este utilizarea unor exportatori și colectori specifici (de exemplu, în ecosistemul Prometheus, cu exportatori pentru baze de date, servere web, sisteme de așteptare etc.), care permit expunerea metricilor într-un format standard fără a fi nevoie să rescrieți fiecare aplicație.
Prin combinarea agenților precum Telegraf, a exportatorilor specializați și a platformelor de vizualizare și serii temporale, este posibil să se construiască soluții foarte complete pentru monitorizarea rețelelor, serverelor, aplicațiilor și cloud-ului , bazate complet pe software gratuit sau cu componente comerciale minime atunci când se dorește suport oficial.
Această abordare modulară are avantajul că fiecare organizație poate selecta doar elementele de care are nevoie , le poate integra cu sistemele sale existente (ticketing, CMDB, SIEM etc.) și poate evolua arhitectura pe măsură ce mediul crește sau se schimbă către containere, Kubernetes sau servicii serverless.
Cum să alegi cel mai bun instrument open-source de monitorizare a rețelei
Înainte de a instala primul instrument popular, este important să definiți clar ce doriți să monitorizați : doar rețeaua fizică (routere, switch-uri, puncte de acces), sau și servere, mașini virtuale, containere, aplicații sau chiar experiența utilizatorului și serviciile cloud. Această prioritizare vă permite să restrângeți gama de opțiuni și să alegeți soluții care se potrivesc bine cazului dvs. de utilizare principal.
Este important să evaluați funcționalitățile cheie de care aveți nevoie: rapoarte, alerte, vizualizare a datelor, stocare istorică a datelor, integrare cu sisteme terțe, API-uri și suport pentru protocoale specifice (SNMP, NetFlow, WMI, API-uri în cloud etc.). De exemplu, Prometheus este ideal atunci când sunt necesare metrici personalizate și reguli complexe de alertare; Cacti excelează la afișarea graficelor de trafic de rețea; iar Checkmk oferă vizualizare interactivă și rapoarte SLA complete.
Ușurința în utilizare și configurare este un alt factor cheie. Instrumente precum Zabbix, Netdata sau Checkmk oferă de obicei asistenți de configurare și tablouri de bord ușor de utilizat, în timp ce soluțiile extrem de flexibile pot necesita o configurare inițială mai complexă. Este recomandabil să testați interfața de descoperire a rețelei, crearea gazdei și a serviciilor și configurarea alertelor înainte de a lua o decizie.
În ceea ce privește securitatea, este esențial ca platforma să accepte criptare, autentificare puternică și controlul accesului bazat pe roluri . Unele, cum ar fi OpenNMS, Icinga sau Prometheus, permit adăugarea de module sau configurații avansate pentru a consolida securitatea, a segmenta accesul la date și a respecta standardele interne sau de reglementare; în plus, este recomandabil să se completeze acest lucru cu cele mai bune practici pentru configurarea avansată a firewall-ului pe servere.
În cele din urmă, este recomandat să se efectueze o demonstrație de concept (POC) cu 2 sau 3 instrumente finaliste , să se implementeze acestea într-un mediu controlat, să se monitorizeze un subset reprezentativ al infrastructurii și să se evalueze performanța, ușurința în utilizare, calitatea alertelor și capacitatea de integrare cu instrumentele existente (sisteme de tichete, CI/CD, mesagerie etc.).
Cele mai bune practici pentru monitorizarea eficientă a rețelei
Odată ce platforma este aleasă, succesul depinde în mare măsură de modul în care este proiectată implementarea. Un prim pas crucial este documentarea și cartografierea rețelei : ce dispozitive sunt prezente, unde sunt amplasate, ce legături utilizează, ce servicii critice suportă și ce dependențe există între ele. Acest lucru va facilita definirea a ceea ce și cum trebuie monitorizat. Pentru a înțelege mai bine topologiile și tipurile de rețea, consultați Rețele de calculatoare: tipuri și exemple.
Este recomandabil să alegeți unul sau mai multe protocoale standard de comunicație pentru ca dispozitivele să trimită informații către instrument: SNMP pentru echipamente de rețea, agenți pentru servere, exportatori Prometheus pentru servicii specifice, syslog pentru evenimente etc. Cu cât abordarea este mai omogenă, cu atât va fi mai ușor de întreținut pe termen lung.
De asemenea, este important să se definească comportamentele de referință : valori normale pentru latență, lățime de bandă, CPU, memorie, conexiuni simultane etc. Acest lucru permite configurarea unor praguri realiste și o detectare mai precisă a anomaliilor, evitând atât alarmele false, cât și alertele ratate pentru incidente reale.
Configurarea tablourilor de bord clare, specifice fiecărui rol (operațiuni 24/7, rețea, sisteme, management etc.) ajută la reducerea timpului de diagnosticare. Un NOC va avea nevoie de vizualizări rezumative și alerte în timp real; un administrator de rețea, interfețe detaliate, erori și cozi; și un CIO, disponibilitate și SLA-uri pentru serviciile critice.
În cele din urmă, este esențial să se definească o politică de escaladare a alertelor : cine primește ce tip de alertă, prin ce canal și cu ce prioritate; ce se face în afara orelor de program; ce constituie un incident major; și cum este coordonat răspunsul între echipe. Chiar și cele mai bune instrumente din lume își pierd eficacitatea dacă nimeni nu răspunde la alerte sau dacă nu există un plan de acțiune clar.
Luând în considerare toate aceste aspecte, soluțiile open-source de monitorizare a traficului de rețea vă permit să construiți medii super-robuste, cu vizibilitate end-to-end, suport decizional și o bază solidă pentru îmbunătățirea securității, disponibilității și performanței oricărei infrastructuri, de la o întreprindere mică la o corporație distribuită mare.