- Mikroarhitektura določa, kako CPU implementira ISA, in določa njegov IPC, notranji vzporedni proces in dejansko učinkovitost, ki presegajo frekvenco ali velikost predpomnilnika.
- Zasnove, kot sta AMD Zen in Zen 2, združujejo optimizirane predpomnilnike, izvajanje izven vrstnega reda, SMT in velike vektorske enote za povečanje zmogljivosti na cikel in na vat.
- Strategija čipov in Infinity Fabric omogoča povečanje števila jeder v EPYC in Ryzen, hkrati pa ohranja nadzorovane stroške in zelo konkurenčno zmogljivost.
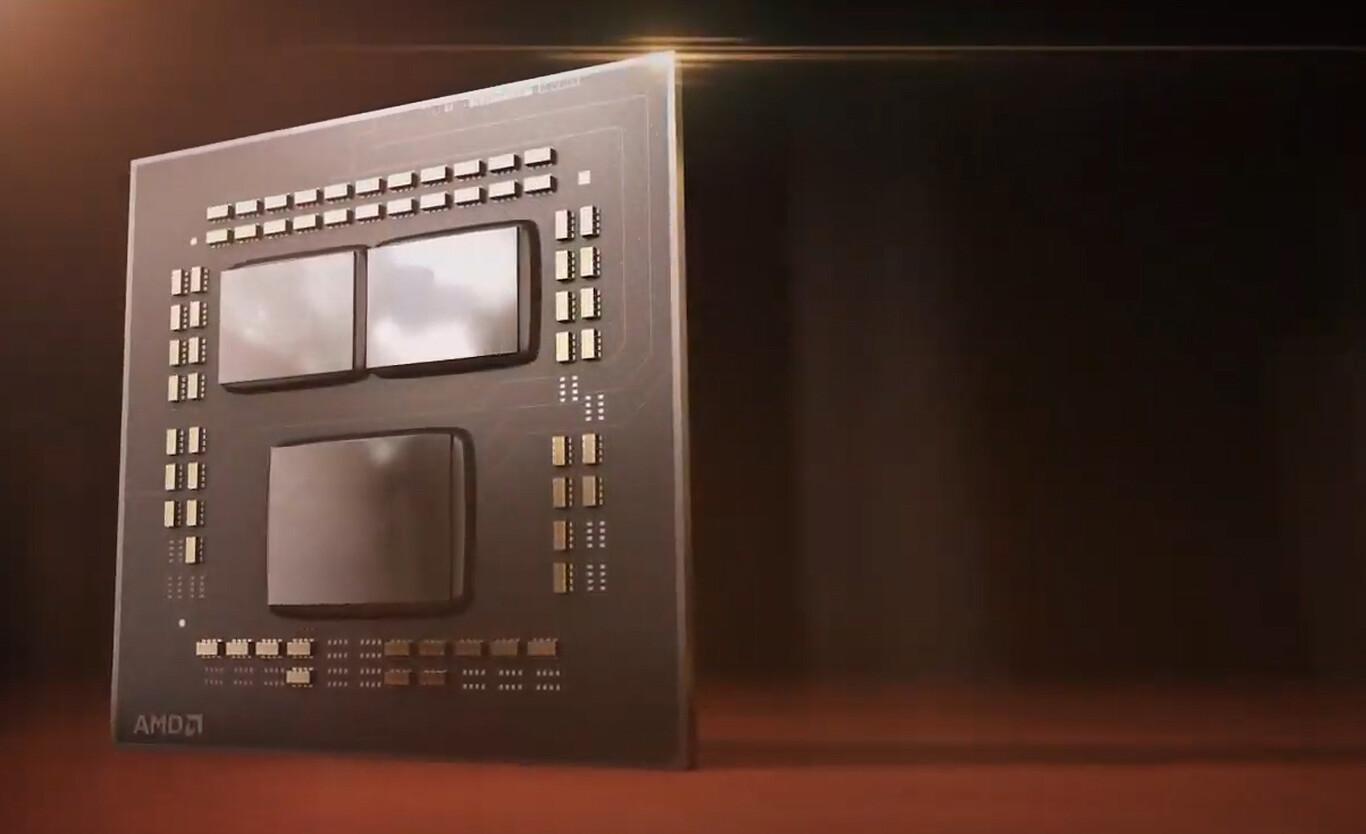
Mikroarhitektura procesorja pogosto odstopa od bolj vpadljivih številk, kot sta GHz ali MB predpomnilnika, vendar se prav tam, v notranji zasnovi procesorja, odloča o večini njegove dejanske zmogljivosti, učinkovitosti in celo o tem, katera vrsta programske opreme jo lahko najbolje izkoristi.
Ko berete tehnične specifikacije, ki omenjajo jedra, niti, predpomnilnik L3 ali AVX2 , dejansko vidite konkretne posledice določene mikroarhitekture. Razumevanje notranje organiziranosti teh komponent, kaj loči Zen 3 od Zen 2 ali hibridni Intel od klasičnega Ryzena, je ključnega pomena za pametno izbiro naslednjega procesorja in poznavanje, zakaj nekateri blestijo v igranju iger, drugi v upodabljanju in spet tretji v strežniških nalogah.
ISA, makroarhitektura in mikroarhitektura: urejanje konceptov
Preden se poglobimo v kompleksnost cevovodov in napovedovalcev, je koristno razlikovati med tremi pogosto enačenimi ravnmi: sistemsko makroarhitekturo, ISA in mikroarhitekturo . Vsaka opisuje drugačno plast računalnika.
Po eni strani je tu makroarhitektura oziroma celotna zasnova sistema , ki zajema vse, kar vidite na matični plošči: procesor, krmilnike pomnilnika, vodila, glavni pomnilnik, vhodno/izhodne čipe, krmilnike pomnilnika, morebitne zunanje pospeševalnike in logiko DMA. Gre za sliko na visoki ravni, kako se velike strojne komponente povezujejo in kako se podatki pretakajo med njimi.
Nad tem je ISA (Instruction Set Architecture) , ki je nabor ukazov, ki jih procesor razume: vrste podatkov, ki jih obdeluje, velikost besed, število in vrsto registrov, načine naslavljanja, formate ukazov itd. Ko programirate v zbirnem jeziku z uporabo mnemonik, kot so ADD, SUB, MUL , ali kličete razširitve, kot so SSE, AVX ali NEON, komunicirate neposredno z ISA.
Končno imamo še mikrokodo ali μISA , ki definira notranje mikrooperacije, ki jih nekatere kompleksne arhitekture (kot je x86) uporabljajo za izvajanje svojih CISC ukazov. To mikrokodo je mogoče posodobiti prek vdelane programske opreme, da se odpravijo napake ali doda podpora za nove ukaze.
Kaj točno je mikroarhitektura procesorja?
Mikroarhitektura procesorja je v bistvu notranji načrt, ki določa, kako se izvajajo ukazi ISA in kako se podatki premikajo znotraj čipa. Dva procesorja si lahko delita isti ISA (na primer AMD64 pri Intelu in AMD-ju) in imata kljub temu radikalno različno delovanje in zmogljivost zaradi – ali morda prav zaradi – svoje mikroarhitekture.
Ta zasnova vključuje elemente, kot so vrsta krmilne enote , ali se uporablja programabilna mikrokoda ali strojno vgrajena logika; hierarhija pomnilnika; globina cevovoda; koliko funkcionalnih enot deluje vzporedno; in ali je procesor sposoben izvajati ukaze v napačnem vrstnem redu in špekulativno.
Poleg tega mora oblikovalec izbrati globino cevovoda : od preprostih procesorjev brez cevovoda, kjer se vsak ukaz obdela od začetka do konca, preden se začne naslednji, do sodobnih zasnov z mnogimi fazami (pridobivanje, dekodiranje, preimenovanje, odprema, izvajanje, zapisovanje nazaj, umik ...), ki omogočajo, da se hkrati izvaja na ducate ukazov.
S tem je povezano število in vrsta izvedbenih enot : ALU za cela števila, enote za množenje, delilniki, FPU za skalarna in vektorska števila s plavajočo vejico, AGU (enote za generiranje naslovov) za izračun pomnilniških naslovov, enote za skok itd. Če je več enot iste vrste, govorimo o superskalarnih procesorjih, ki so sposobni izdati več ukazov na cikel.
To je osnova za napredne tehnike, kot je špekulativno izvajanje , kjer CPU predvidi razrešitev veje in vnaprej izvede navodila iz ene od vej. Če je napoved pravilna, se prihrani čas; če ne uspe, se opravljeno delo zavrže in cevovod se izprazni, kar ima za posledico ustrezno kazen.
Večina sodobnih visokozmogljivih procesorjev uporablja tudi izvajanje zunaj vrstnega reda (OoO) . Namesto da bi se strogo držal vrstnega reda programa, procesor notranje prerazporedi ukaze in najprej izvede tiste, katerih podatki so pripravljeni, s čimer se izogne ciklom mirovanja, medtem ko drugi čakajo na pomnilnik ali rezultat prejšnjih operacij.
Da bi vse to delovalo brez kršitve semantike programa, se uporablja preimenovanje registrov . Prevajalnik vidi omejen nabor logičnih registrov, vendar jih mikroarhitektura pretvori v večjo banko fizičnih registrov in dinamično dodeli nove cilje, da prekine lažne odvisnosti in omogoči večjo vzporednost.
Končno se lahko zasnova osredotoči na dodajanje vzporednosti na ravni jedra in niti . To vključuje vse od enojedrnih procesorjev do čipov z več deset ali stotinami jeder (mnogojedrov), večprocesorskih sistemov z več vtičnicami, ki so med seboj povezane z visokohitrostnimi mrežnimi omrežji (Infinity Fabric, Intel Mesh, NVLink itd.), in podporo za sočasno večnitnost (SMT), tako da lahko vsako fizično jedro obravnava dve ali več logičnih niti.
Združljivost, ISA in družine mikroarhitektur
Ker je mikroarhitektura le ena specifična implementacija ISA , ima lahko en sam ISA skozi leta in pri različnih proizvajalcih na desetine različnih mikroarhitektur. Prav to se dogaja pri x86-64/AMD64 ali ARM.
Če pogledamo samo AMD znotraj AMD64 ISA, najdemo tako raznolike družine, kot so K8/Hammer, K10, Bulldozer in celotna serija Zen (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Vsi izvajajo isti osnovni nabor ukazov, vendar so njihova notranja organizacija, predpomnilniki, cevovodi in pristopi vzporednega izvajanja popolnoma različni.
Ko zamenjamo ISA-je, je preskok v združljivosti absoluten. Procesor, ki temelji na ARM A64 (kot je Apple Silicon), ne more zagnati binarnih datotek, prevedenih za x86-64, in obratno, razen če se uporablja prevajalska ali emulacijska plast, kot je Rosetta 2, QEMU ali podobno, kar ima za posledico ustrezne stroške zmogljivosti.
Tudi med procesorji, ki si delijo ISA, ni zagotovila, da vsi podpirajo isti nabor ukazov ali razširitve. Starejši čip morda nima AVX2 ali AVX-512 ali pa ARM SoC morda izvaja le podmnožico neobveznih razširitev. Zato se binarna datoteka, ki močno uporablja AVX-512, morda ne bo zagnala na procesorju, ki ponuja samo SSE4.
Pri prevajanju programske opreme je običajna praksa ustvarjanje generičnih binarnih datotek za določen ISA (na primer x86-64 z vsaj SSE2), ne da bi se v celoti izkoristila določena mikroarhitektura, tako da se izvedljiva datoteka izvaja na čim več procesorjih. Če pa prevedete z nastavitvami za določeno mikroarhitekturo (-march=znver3, -mtune=skylake itd.), lahko znatno izboljšate zmogljivost na tej določeni družini, vendar za ceno izgube združljivosti z drugimi.
Licence ISA in intelektualna lastnina zasnove
Programska koda ni zaščitena le z licencami: ISA-ji in mikroarhitekture so prav tako intelektualna lastnina. Nihče ne more zakonito klonirati x86 ali AMD64 ISA-ja brez licence, tako kot lastniške zasnove CPU-ja ni mogoče kopirati brez dovoljenja.
Na področju ISA obstajajo trije glavni pristopi. Po eni strani obstajajo zaprti ISA , kjer lastnik strogo nadzoruje, kdo lahko implementira združljiva jedra. Klasični primer je IA-32 (x86-32), ki je bil v preteklosti v lasti Intela, ki je licence podeljeval podjetjem AMD, VIA in drugim, ne brez pravnih bitk.
Podobna situacija obstaja z AMD64/x86-64 , ki ga je sprva zasnoval AMD in ga je kasneje licenciral Intel (ki ga je poimenoval EM64T) prek sporazumov o navzkrižnem licenciranju. Tudi drugi akterji, kot je Hygon na Kitajskem, so pridobili licence za določene različice (na primer Zen 1 za kitajski trg).
Potem imamo ISA s prilagodljivim licenciranjem , kjer lastnik ponuja tako licence ISA kot tudi IP jedra, pripravljena za integracijo. Tukaj so primerni ARM, SPARC ali OpenPOWER: lahko plačate za uporabo Cortex A/M/R ali Neoverse, kot je, ali za licenco, ki vam omogoča oblikovanje lastnih mikroarhitektur na vrhu ISA, kot to počne Apple s svojimi M1/M2/M3 ali Qualcomm s svojim Kryo.
Končno obstajajo odprtokodni ISA-ji , kjer lahko kdorkoli ustvari združljive mikroarhitekture, ne da bi plačal avtorske honorarje za ISA (čeprav lahko patentira ali zapre svojo implementacijo). RISC-V je najboljši primer: ISA je pod permisivno licenco BSD in obstajajo možnosti, od popolnoma odprtih jeder v Verilogu ali Chiselu do zaprtih komercialnih zasnov.
Poleg ISA je vsaka specifična mikroarhitektura (jedro Zen 4, Cortex X4, zasnova grafičnega procesorja itd.) blok patentirane ali registrirane intelektualne lastnine. Tukaj so tudi odprte zasnove, objavljene kot mehka jedra na HDL za sintezo v FPGA ali integracijo v SoC-je po meri.
Poglobljen pogled v sodobne mikroarhitekture: primer AMD Zen
Da bi videli, kako se vse to prevede v dejansko zmogljivost, ni nič boljšega kot analizirati določeno družino izdelkov. AMD je zaradi Zena in njegovih zaporednih iteracij dramatično preoblikoval svoje poslovanje , prešel iz težavne dobe Bulldozerja in starih procesorjev FX v neposreden konkurenec (in včasih celo prehitevanje) Intela na trgih namiznih, strežniških in prenosnih računalnikov.
Po neuspehu strategije AMD Fusion se je podjetje prestrukturiralo in se odločilo za visokozmogljivo zasnovo, ki jo je med drugim vodil Jim Keller. Načrt Zen je bil namenjen agresivnemu povečanju IPC (števila navodil na cikel) v primerjavi z Bulldozerjem, izboljšanju zmogljivosti na vat in ponovni vzpostavitvi prednosti pri enojedrni zmogljivosti, kjer je Intel že leta vodil.
Ena ključnih sprememb je bila okrepitev sprednjega dela , dela, odgovornega za pridobivanje in pripravo navodil. Zen je uvedel predpomnilnik mikrooperacij , ki shranjuje že dekodirane mikrooperacije, podobno kot nekatere Intelove mikroarhitekture, kot je Conroe. Bulldozerju tega ni bilo in se je bolj zanašal na klasično hierarhijo predpomnilnika navodil, kar je negativno vplivalo na njegovo prepustnost.
Zen-ov dekoder lahko prevede do štiri ukaze CISC x86-64 na cikel v mikrooperacije, podobne RISC-u. Te mikrooperacije se nato postavijo v čakalno vrsto, ki jo napaja medpomnilnik mikrooperacij, ki lahko nato pošlje do šest mikrooperacij na cikel razporejevalnikom v ozadju. Tu se začne izvajanje izven vrstnega reda.
AMD je jasno ločil poti med celoštevilskimi in plavajočimi vejicami . Na strani celoštevilskih podatkov se ALU-ji, AGU-ji in logika nalaganja/shranjevanja napajajo iz čakalne vrste mikrooperacij. Ta logika je zmožna izvesti dve 16-bajtni nalaganji in eno 16-bajtno shranjevanje na cikel iz 32 KB, 8-smernega L1D s politiko povratnega zapisovanja.
Stran s plavajočo vejico in vektorska stran napajata enoti FMAC in AVX. Z dvema priključkoma za množenje in dvema priključkoma za seštevanje lahko Zen hkrati izvede dve 128-bitni operaciji FMA ali eno 256-bitno operacijo AVX na taktni cikel. Ta vzporednost na ravni ukazov je eden od ključev do njegove visoke zmogljivosti pri računsko intenzivnih obremenitvah.
Hierarhija predpomnilnika, TLB in organizacija pomnilnika v Zenu
Hierarhija pomnilnika v Zen je organizirana v tri ravni predpomnilnika: ločen L1 za navodila in podatke, zasebni L2 na jedro in deljeni L3 . Čeprav podeduje osnovno strukturo prejšnjih mikroarhitektur, so bile velikosti, asociativnost in pravilniki izpopolnjeni.
L1I (predpomnilnik ukazov) ponuja 64 KB na jedro s 4 asociativnimi potmi, kar v primerjavi z Bulldozerjem podvoji število poti na modul in zmanjša konflikte. L1D (predpomnilnik podatkov) je v primerjavi s 16 KB, 4 potmi in možnostjo zapisovanja pri Bulldozerju povečan na 32 KB, 8 poti in politiko zapisovanja nazaj, kar znatno izboljša tako hitrost zadetkov kot učinkovitost zapisovanja.
Predpomnilnik L2 je implementiran s 512 KB na jedro in 8-smernim delovanjem, namesto 2 MB 16-smernega deljenja na modul prejšnje generacije. Predpomnilnik L3 pa ponuja več MB na jedro s 16-smerno asociativnostjo in deluje kot zadnja deljena raven pred prehodom v DRAM.
Vzporedno Zen loči TLB-je na ITLB-je (za navodila) in DTLB-je (za podatke) , vsak z več nivoji in stotinami vnosov, vsi z zaščito paritete. To znatno zmanjša zakasnitev prevajanja virtualnih v fizične naslove, ki postaja vse bolj kritična z naraščanjem velikosti pomnilnika.
Ko govorimo o tem, ali je predpomnilnik dvosmerni, štirismerni ali osemsmerni , opisujemo njegovo asociativnost, ki je tesno povezana z idejo prepletanja v pomnilniku. Večja asociativnost pomeni več različnih načinov shranjevanja bloka pomnilnika v tem predpomnilniku, kar zmanjšuje konflikte, vendar za ceno nekoliko bolj kompleksne logike in rahlega povečanja latence.
Pomembno je tudi razumeti razliko med zapisovanjem skozi in zapisovanjem nazaj . Pri zapisovanju skozi vsako zapisovanje hkrati posodobi predpomnilnik in glavni pomnilnik, kar poenostavi doslednost , vendar poveča promet. Pri zapisovanju nazaj se zapiše samo predpomnilnik, vrstica pa je označena z umazanim bitom; DRAM se posodobi le, ko je ta vrstica izbrisana, kar prihrani pasovno širino in izboljša zmogljivost na račun nekoliko bolj zapletene logike.
Zen in Zen+: skok v CPI in učinkovitosti
Zen je za AMD predstavljal zelo pomemben preskok v IPC v primerjavi z Bulldozerjem , zahvaljujoč kombinaciji boljšega sprednjega dela, boljšega napovedovalnika vej, več izvedbenih enot, SMT namesto CMT (vsako polno jedro obravnava dve niti, namesto da bi si del FPU delilo med dvema logičnima jedroma) in veliko bolj smiselne hierarhije predpomnilnika.
Poleg zasnove je AMD izkoristil prednosti naprednejših proizvodnih procesov s FinFET-om in manjšimi vozlišči , ki omogočajo večjo gostoto tranzistorjev, manjšo porabo energije pri enaki zmogljivosti in višje frekvence ob hkratnem ohranjanju razumnega TDP-ja ( krivulje napetosti in frekvence ). To ravnovesje zmogljivosti na vat je bilo ključnega pomena za ponovno pridobitev konkurenčnosti na trgu prenosnikov in strežnikov.
Prehod iz Bulldozerja na Zen je prinesel tudi daljše čakalne vrste za umik, večje razporejevalnike ukazov, večjo notranjo pasovno širino, napovedovanje vej s tehnikami, ki temeljijo celo na preprostih nevronskih mrežah, in SMT, ki je sposoben bolje stisniti razpoložljive izvedbene enote.
V tem kontekstu se pojavi Zen+ , ki bi ga lahko razumeli kot ekvivalent "kljukice" v Intelovi stari strategiji Tik-Tok: enaka osnovna zasnova kot Zen, vendar izdelana na bolj izpopolnjenem vozlišču, z izboljšavami frekvence, rahlim zmanjšanjem zakasnitve in prilagoditvami notranjega časa. Ne gre za arhitekturno revolucijo, temveč za izboljšavo, ki se prevede v nekaj dodatnih točk zmogljivosti.
Zen 2: čipi, polni AVX2 in globoka izpopolnitev
Z Zen 2 AMD ne le izpopolnjuje procesa: uvaja bistvene spremembe mikroarhitekture in množično lansira svojo strategijo čipov . Namesto enega samega velikega monolitnega čipa deli zasnovo na več manjših 7nm računskih čipov (CCD) in ločen 12nm V/I čip, ki obvladuje pomnilnik, PCIe in medsebojne povezave.
Ta pristop s čipi izboljša izkoristek na rezino (lažje je izdelati majhne, brezhibne čipe), zmanjša stroške in olajša skaliranje števila jeder: preprosto dodajte več CCD-jev, da dosežete 16, 32 ali več jeder v EPYC in Threadripper. Kompromis je nekoliko bolj zapletena notranja komunikacija, odvisna od medsebojne povezave Infinity Fabric, ki jo AMD izpopolnjuje iz generacije v generacijo.
Kar zadeva surovo zmogljivost, AMD govori o približno +15 % IPC za Zen 2 v primerjavi z Zen+ pri isti frekvenci in o splošnem izboljšanju zmogljivosti na vat, ki lahko znaša približno +75 % v primerjavi s prvim Zenom, če združimo izboljšave zasnove in procesa.
V vektorskem ozadju Zen 2 vzame manjkajoči del: ponuja polno 256-bitno podporo za AVX2 v eni sami mikrooperaciji , brez delitve navodil na dve 128-bitni operaciji, kot je bilo to v primeru Zen/Zen+. To pomeni, da so vektorske izvedbene enote zdaj resnično 256-bitne in lahko obdelujejo delovne obremenitve AVX2 s polno hitrostjo z veliko manjšo frekvenčno kaznijo kot v drugih zasnovah.
Prav tako se krepi predpomnilnik mikro operacij, ki se povečuje na 4K vnosov (podvojitev njegove velikosti), s čimer se izkorišča del prostora, ki se sprosti s prepolovitvijo predpomnilnika L1I, vendar se njegova asociativnost podvoji s 4 na 8 načinov. Notranje simulacije so AMD pripeljale do zaključka, da je za večino resničnih delovnih obremenitev večji predpomnilnik UOP ugodnejši od večjega predpomnilnika L1I.
Predpomnilnik L3 na jedrni blok se podvoji v zmogljivosti , kar pomaga zmanjšati napake zadnje ravni, čeprav se zakasnitev dostopa poveča s približno 35 na 40 ciklov. Za ublažitev tega učinka Zen 2 izboljša pasovno širino nalaganja in shranjevanja ter izboljša politiko prednalaganja.
Drug pomemben vidik je napovedovalec vej. Zen 2 uporablja napovedovalec TAGE (TAgged GEometric) z več kot 7 vnosi, ki lahko izkoristi zgodovino spremenljive dolžine in označene vnose. To zmanjšuje aliasing med različnimi vejami in po navedbah AMD zmanjša število napačnih napovedi za približno 30 % v primerjavi s prejšnjo shemo, kar se neposredno prevede v manj praznjenj cevovoda in višji IPC.
Zen 2 Back-end: AGU-ji, medpomnilniki in prilagojene latence
V celotnem zaledju Zen 2 še naprej pošilja do šest mikrooperacij na cikel iz medpomnilnika za prerazporejanje, ki je razširjen na približno 224 vnosov (v primerjavi z Zenovimi 192). Enote za razporejanje so razdeljene v štiri čakalne vrste za ALU s po 16 vnosi in eno čakalno vrsto za AGU z 28 vnosi.
Število enot za generiranje naslovov (AGU) se poveča z dveh na tri, čeprav niso vse enake: dve lahko obvladujeta tako nalaganje kot pisanje, tretja pa je specializirana za operacije shranjevanja. Ta porazdelitev je zasnovana za tipične profile programske opreme, kjer so nalaganja običajno pogostejša in kritičnejša kot operacije shranjevanja.
V ravnini s plavajočo vejico lahko zaledni sistem sprejme štiri mikrooperacije na cikel v svoje 256-bitne vektorske enote FMA, ki jih podpira fizična registrska datoteka s 160 vnosi. 256-bitne poti nalaganja/shranjevanja so bile izboljšane za nalaganje teh enot s stalno hitrostjo pri velikih vektorskih obremenitvah.
Zen 2 prilagaja tudi latence nekaterih operacij : na primer, množenje s plavajočo vejico zmanjša latenco s 4 na 3 cikle, kar pomaga pri zelo tesnih numeričnih računskih zankah. In na splošno obstaja niz majhnih optimizacij, razporejenih po celotnem cevovodu, ki se seštevajo v tisti dodatni IPC, ki ga vidimo v sintetičnih primerjalnih testih in resničnih aplikacijah.
Kar zadeva notranjo hierarhijo po skupinah jeder, AMD uporablja koncept CCX (Core Complex) : blok štirih jeder, ki si delijo isti predpomnilnik L3 (16 MB v Zen 2). Ta dodatna velikost pomeni nekoliko večjo latenco, vendar posledično zmanjša stopnjo napak, zlasti v aplikacijah z velikimi delovnimi sklopi.
Za referenco si lahko ogledamo približne vrednosti notranje latence: približno 4 cikle za L1 , približno 12 za L2 in približno 40 ciklov za L3. Ključno je, da se čim več podatkov ohrani v L1/L2 in zmanjša promet do L3 in DRAM-a , kar si mikroarhitektura in prevajalniki prizadevajo doseči skupaj.
Infinity Fabric: lepilo, uporabljeno v čipletih, in njegov vpliv na delovanje
Ena komponenta, ki ni vedno povezana z mikroarhitekturo, vendar je ključna v Zen 2 in novejših različicah, je Infinity Fabric . To lastniško vodilo deluje kot komunikacijska "avtocesta" med CCX-ji, CCD-ji, vhodno/izhodnim čipom, pomnilnikom in na splošno med vsemi bloki SoC-ja.
Infinity Fabric je razvoj HyperTransporta , visokohitrostnega vodila, ki ga je AMD uvedel pred leti in so ga uporabljale tudi tretje osebe, kot so NVIDIA, Cisco, Sun in drugi člani konzorcija. IF podeduje filozofijo skalabilnih povezav od točke do točke, vendar je prilagojen potrebam sodobnih SoC-jev in medsebojnega povezovanja CPU-jev in GPU-jev.
V Zen 2 AMD uvaja IF2 s podporo za PCIe 4.0 in 512-bitnim notranjim vodilom med CCX-i, kar je dvakrat več kot pri prvi različici. To se odraža v učinkovitejši pasovni širini in izboljšanju učinkovitosti, ki ga AMD ocenjuje na približno 27 % v primerjavi z IF1, kar pomaga ublažiti izgubo zmogljivosti zaradi preklapljanja med čipi.
Poleg tega je takt Infinity Fabric delno ločen od takta DRAM , kar omogoča, da se glavni pomnilnik v določenih scenarijih prilagodi višjim frekvencam, ne da bi nujno silil medfrekvenco, da sledi tempu, kar ponuja več prostora za fino nastavitev za navdušence in sistemske oblikovalce.
V strežniških procesorjih, kot je EPYC , s štirimi ali več računskimi čipi, Infinity Fabric omogoča povezavo vseh čipov skupaj s skoraj popolnimi topologijami (180-stopinjske rotacije, neposredne povezave itd.), s čimer se doseže pasovna širina med čipi, ki lahko zlahka preseže 150 GB/s dvosmerno, odvisno od hitrosti uporabljenega DDR.
Kombinacija robustne mikroarhitekture v vsakem jedru , skalabilne zasnove z uporabo čipov in dovolj hitrih medsebojnih povezav omogoča podjetju AMD, da sestavlja procesorje z 32, 64 ali več jedri z izjemno zmogljivostjo pri zelo vzporednih delovnih obremenitvah, hkrati pa ohranja konkurenčen IPC na nit.
Navsezadnje, ko primerjate procesorje v igralnih merilih, 3D-upodabljanju, obsežnem kompiliranju ali znanstveni simulaciji, podatki o GHz in številu jeder povedo le del zgodbe. Kar resnično naredi razliko, je to, kako mikroarhitektura orkestrira notranje izvajanje , kako izkorišča ali zapravlja vsak taktni cikel in kakšne kompromise je proizvajalec naredil med zakasnitvijo, pasovno širino, porabo energije in kompleksnostjo.

Kazalo
- 1 ISA, makroarhitektura in mikroarhitektura: urejanje konceptov
- 2 Kaj točno je mikroarhitektura procesorja?
- 3 Združljivost, ISA in družine mikroarhitektur
- 4 Licence ISA in intelektualna lastnina zasnove
- 5 Poglobljen pogled v sodobne mikroarhitekture: primer AMD Zen
- 6 Hierarhija predpomnilnika, TLB in organizacija pomnilnika v Zenu
- 7 Zen in Zen+: skok v CPI in učinkovitosti
- 8 Zen 2: čipi, polni AVX2 in globoka izpopolnitev
- 9 Zen 2 Back-end: AGU-ji, medpomnilniki in prilagojene latence
- 10 Infinity Fabric: lepilo, uporabljeno v čipletih, in njegov vpliv na delovanje