- Cevi v Linuxu omogočajo povezovanje procesov z uporabo stdout in stdin, s podporo jedra in orodji, kot so tee, xargs in cpio, za kompleksne tokove.
- Učinkovit cevovod CI/CD v Linuxu se zanaša na dobro zasnovo odra, intenzivno uporabo predpomnilnikov, nespremenljive artefakte in vzporedno testiranje.
- Optimizacija Linux strežnika (CPU, RAM, V/I, Docker) in izvajalcev Jenkins, GitHub Actions ali GitLab Runner je ključna za skrajšanje časov.
- Integracija varnosti, opazovalnosti in nadzora stroškov v cevovod zagotavlja zanesljive, sledljive in trajnostne uvedbe v produkcijskih okoljih.
Optimizacija cevovodov v Linuxu Ne gre samo za veriženje ukazov s simbolom |Za vsem tem se skriva cel svet optimizacija delovanjaZasnova poteka dela, CI/CD, varnost in optimizacija operacijskega sistema so ključnega pomena za razliko med počasnim in nestabilnim cevovodom ter tistim, ki deluje, je zanesljiv in poceni za vzdrževanje. Če delate s strežniki Linux, pa naj gre za avtomatizacijo opravil v terminalu ali izvajanje cevovodov za neprekinjeno integracijo, vam razumevanje teh podrobnosti prihrani veliko časa in glavobolov.
V tem članku bomo združili dve dopolnjujoči se perspektivi: na eni strani Klasična uporaba cevnih napeljav v ukazni vrstici Linuxa (cevi, preusmeritve, ukazi kot tee, xargs o cpio); na drugi strani pa Optimizacija cevovoda CI/CD na strežnikih LinuxTo vključuje predpomnjenje, vzporedno testiranje, uglaševanje Dockerja, varnost dobavne verige in napredne metrike delovnega toka. Vse je razloženo v španščini (iz Španije) z jasnimi primeri in zelo praktičnim pristopom.
Kaj je cevovod in kako se cevi prilegajo Linuxu?
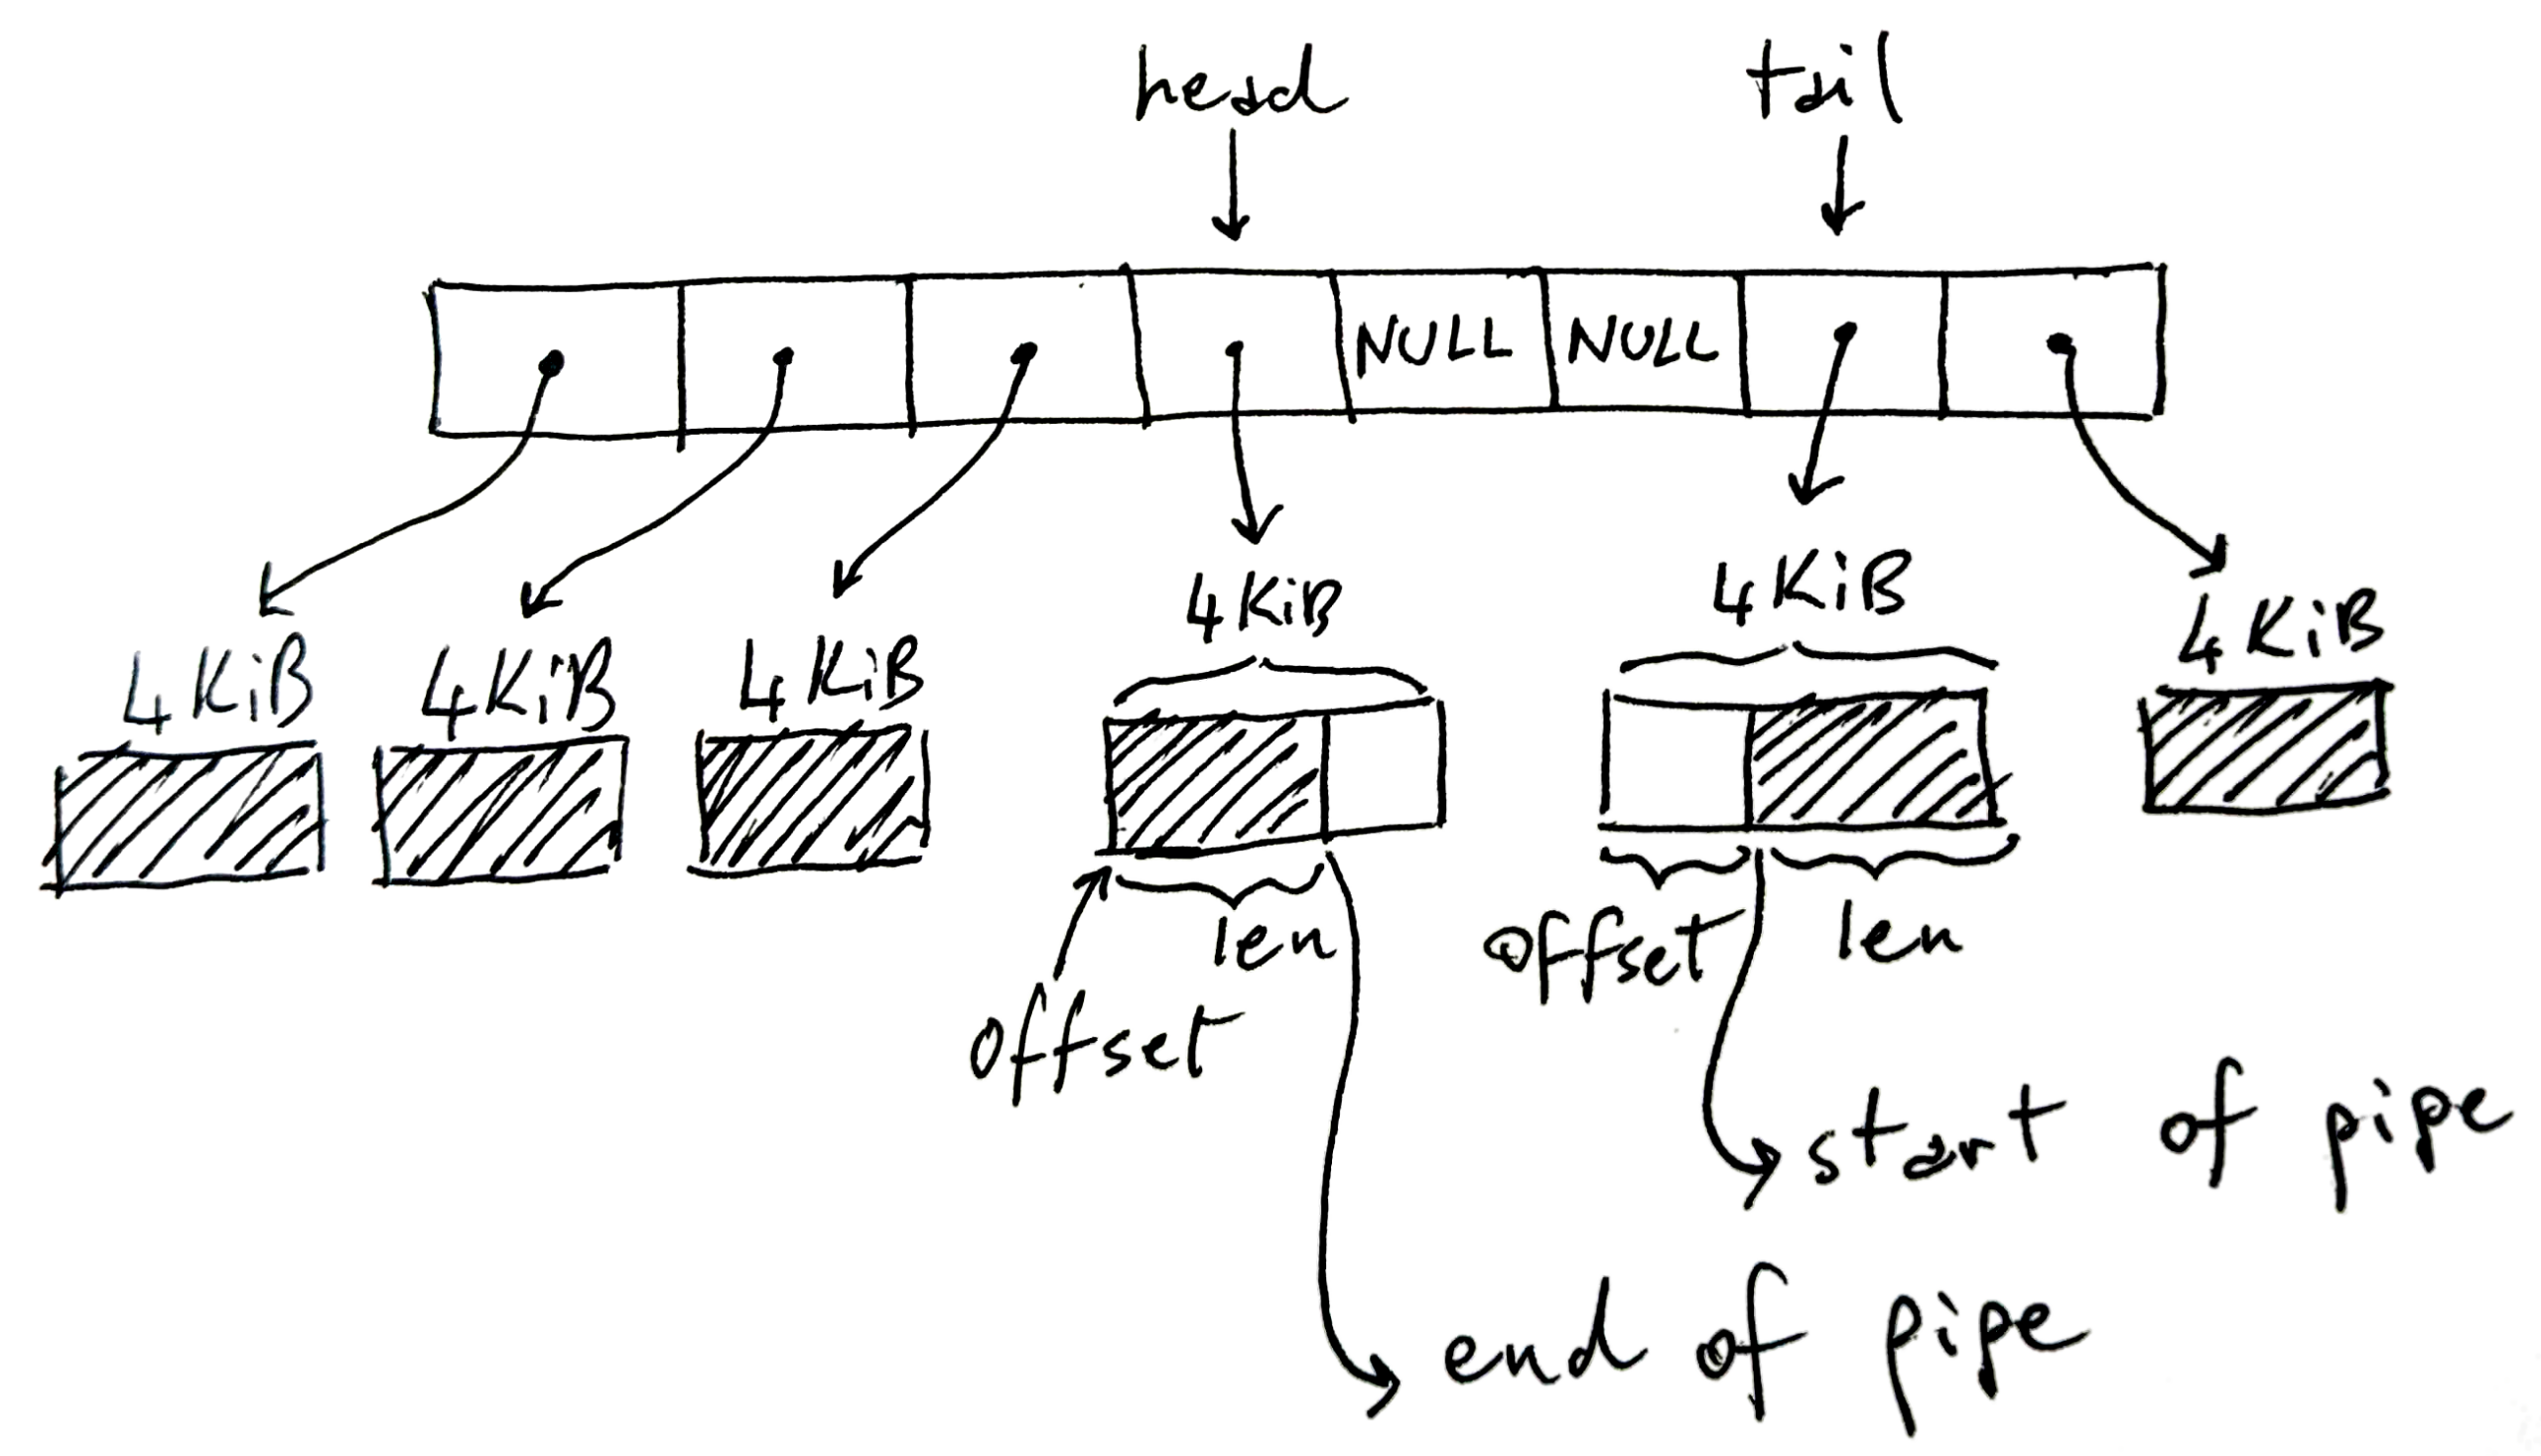
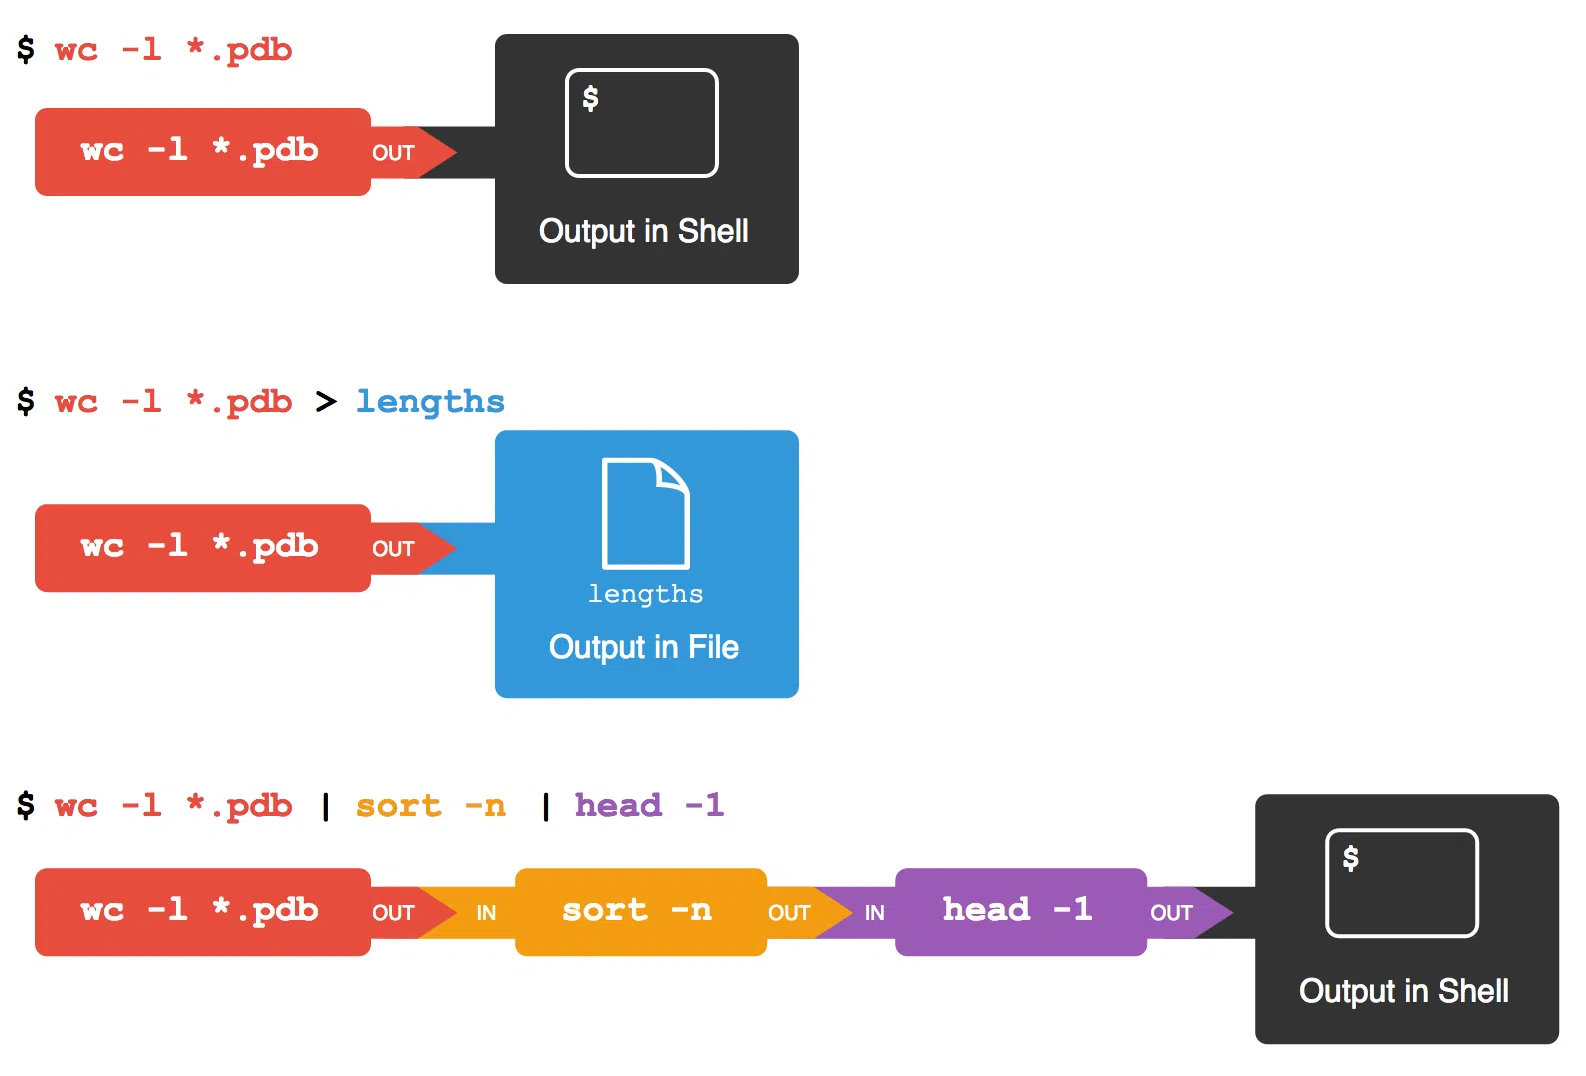
Izraz cevovod izhaja iz ideje o cevi : toku podatkov, ki potuje od ene točke do druge. V računalništvu, še posebej v Linuxu, je cev mehanizem, ki omogoča, da standardni izhod enega procesa postane standardni vhod drugega. Z drugimi besedami, izhod enega ukaza se samodejno prenese v naslednjega, ne da bi šel skozi vmesne datoteke.
V sistemih, podobnih Unixu, obstajata dve glavni vrsti cevi . Po eni strani obstajajo anonimne ali neimenovane cevi , ki jih je mogoče uporabljati le med tesno povezanimi procesi (na primer starševskim in podrejenim procesom). Po drugi strani pa obstajajo poimenovane cevi , znane tudi kot FIFO (First In – First Out), ki omogočajo komunikacijo med procesi, ki niso neposredno povezani in so lahko celo na različnih računalnikih, povezanih v omrežje.
Anonimne cevi običajno zagotavljajo enosmerno komunikacijo : en proces piše, drugi pa bere. Nasprotno pa imenovane cevi omogočajo dvosmerno komunikacijo , če so tako zasnovane, na primer tako, da odprejo FIFO v načinu branja/pisanja z obeh koncev. Pogosto se uporabljajo za koordinacijo procesov demonov, skriptov ali storitev, ki si morajo medsebojno prenašati podatke brez blokiranja.
Na ravni izvedbe je podpora za cevovode v jedro linuxne v lupini. Interpretator ukazov (bash, zsh itd.) preprosto ustvari cevovod s sistemskimi klici, kot je pipe() y fork()preusmerite deskriptorje datotek in nato zaženite vsak program. Pravo magijo blokiranja procesov, upravljanja medpomnilnika in širjenja podatkov med proizvajalcem in potrošnikom obravnava sistemsko jedro.
Razumevanje stdin, stdout in pretoka podatkov
Za učinkovito delo s cevovodi je ključnega pomena razumeti, kaj so stdin, stdout in stderr . To niso abstraktni pojmi: vsak proces v Linuxu se začne s tremi odprtimi deskriptorji datotek, ki kažejo na specifične vire, ki jih upravlja jedro.
stdin (deskriptor 0) in stdout (deskriptor 1) si lahko predstavljamo kot bajtna toka, povezana z nečim: to je lahko terminal, datoteka, omrežna vtičnica ali cev. Nista zgolj medpomnilnika; gre za sklice na objekte jedra ( strukture tipa datoteke ), ki so nato povezani z inodi, vtičnicami ali notranjimi strukturami cevi.
Vsak proces ima svoje deskriptorje, tako da vsak ukaz v cevovodu Svoj stdin in stdout si ogleduje neodvisno. V vrstici, kot je ls | grep txt | wc -lje ls pisati v cev, grep Bere iz ene cevi in piše v drugo, in wc Beri od zadnjega. Uporabniku se zdi kot en sam niz, vendar so interno več združenih medpomnilnikov jedrapri čemer se vsak proces blokira in nadaljuje glede na razpoložljivi prostor ali podatke.
Ko prvi proces ustvari podatke hitreje, kot jih drugi porabi, se medpomnilnik cevi napolni. Na tej točki se naslednji zapisi vrnejo in blokirajo proces pošiljanja, dokler proces, ki jih porabi ... preberite dovolj informacij in sprosti prostor. To preprečuje, da bi pomnilnik ušel izpod nadzora; podatki se ne kopičijo v nedogled, razen če uporabljate neblokirajoče V/I ali posebne signale. Na primer v primeru, kot je dd if=/dev/sda | gzip -9in gzip stisne počasneje, dd prisiljen je čakati.
Zaradi tega mehanizma povratnega tlaka so cevovodi precej stabilni, tudi če obstajajo neravnovesja v zmogljivosti med stopnjami, kar se nato odraža tudi v zasnovi cevovodov CI/CD , kjer počasne stopnje postanejo ozko grlo, ki ga je treba meriti in optimizirati.
Praktična uporaba cevi v terminalu Linux
V vsakodnevni uporabi se cevovodi uporabljajo za veriženje ukazov v eni vrstici in postopno preoblikovanje podatkov. Namesto da bi zagnali ukaz, si ogledali izhod, ga kopirali in prilepili v drug ukaz, lahko zgradite majhne, zelo prilagodljive "tovarne podatkov" v navadnem besedilu.
Tipičen primer v okoljih Unix je kombiniranje ukaza fortune, ki prikazuje naključne citate, z cowsayki izpiše "govorečo" kravo. Z uporabo cevke, Fortunein odhod postane Cowsayjevo sporočilovse v enem samem ukazu. Gre za igriv primer, ki pa odlično ponazarja idejo povezovanja preprostih orodij za bolj kompleksne naloge.
Druga klasika je pošiljanje rezultata ls a wc za štetje vrstic, besed in znakov. Nekaj takega kot ls | wc Omogoča vam hiter pregled števila elementov na seznamu. Lepota je v tem, da za vse ne potrebujete enega samega programa, ampak ... Rešitve ustvarjate z majhnimi, dobro zasnovanimi pripomočki..
Zelo pogosto je tudi veriženje cat, sort y more (ali drug stranilnik) za razvrščanje besedilne datoteke in nato brskanje po njej stran za stranjo. Z uporabo cevovoda se vsebina prenaša iz enega ukaza v drugega, ne da bi se shranila v eksplicitne začasne datoteke, kar močno poenostavi skriptanje in skrbniška opravila.
V praktičnih primerih, kot je obdelava seznamov študentov in ocen v ločenih datotekah, lahko uporabite paste za združevanje stolpcev, cut da izberete samo polja, ki vas zanimajo, in verižne cevne povezave za filtriranje, razvrščanje ali preoblikovanje vsega v eni sami vrstici skripte lupine. Ta vzorec razdelite velik problem na preproste ukaze, kombinirane s cevmi To je bistvo Unixove filozofije.
Napredni ukazi za kar najboljši izkoristek cevi: tee, xargs in cpio
Ko v Linuxu začnete resnično avtomatizirati stvari, postanejo cevi še močnejše zaradi nekaterih ključnih orodij. Med njimi so: tee, xargs y cpioki zelo dobro dopolnjujejo standardni pretok podatkov.
Ukaz tee Deluje kot črka "T" v vodovodni cevi: bere iz stdin, zapisuje v stdout in isti izhod kopira v eno ali več datotek. Idealen je, kadar želite ogled izhoda na zaslonu in hkrati shranjevanje le-tega da ga pregledate pozneje ali obdelate na drugi stopnji. Z možnostjo -a Podatke doda na konec datoteke, namesto da jih prepiše.
Seznam lahko na primer razvrstite z sortpošljite rezultat na tee shraniti ga v dnevnik in ga hkrati posredovati more da ga oštevilčite. Na ta način imate v enem samem cevovodu razvrščanje, shranjevanje na disk in priročen ogled brez ponavljanja postopka razvrščanja.
Ukaz xargs To je še en temeljni del, ko gre za cevi. Njegova funkcija je, da sprejme podatke, ki prispejo prek stdin (običajno seznam elementov), in jih pretvori v argumente za drug ukaz. Še posebej je uporaben, ko se program sesuje, ker prejme preveč parametrov hkrati ali ko želite razdeli delo na serije z možnostjo -n, kar omejuje število argumentov, ki se posredujejo na izvedbo.
Na primer s ls | xargs -n 4 Seznam datotek razdelite v skupine po štiri in izvedete ukaz target (privzeto echo(ali tistega, ki ga določite) večkrat. Na ta način lahko zgradite cevovode, kot je »predogled, kaj bom izbrisal«, tako da združite ls, xargs y echo rm preden se dejansko izvede brisanje.
Bodite previdni pri zapletenih vnosih: poti s presledki ali posebnimi znaki lahko prekine privzeto vedenje xargsV teh primerih se običajno uporablja v kombinaciji z find in možnost -print0, ki ločuje elemente z ničelnim znakom, skupaj z xargs -0 tako da oba konca uporabljata isto robustno ločilo.
Končno, cpio To je manj znan ukaz kot tarVendar je neverjetno prilagodljiv za delo s tokovi datotek prek cevovodov. Za razliko od tar je od začetka zasnovan za delovanje z preusmeritve in cevi: prejme seznam datotek prek stdin (običajno generiranega z find) in ustvari ali porabi datoteke tipa "paket" brez lastne kompresije, ki jih nato lahko stisnete z gzip ali podobno.
Glavni načini cpio dovoli ustvarjanje datotek (-o), kopiranje dreves imenikov (-p) ali izvleči vsebino (-i(pogosto imenovano »kopiranje«). Možnosti, kot so -u prepisati, -m za ohranitev časovnih žigov ali -d poustvarjanje strukture imenikov omogoča podroben nadzor nad tem, kaj se kopira in kako, še posebej uporabno v kompleksnih skriptih, kjer tar ne uspe.
Načrtovanje in optimizacija CI/CD cevovodov na Linux strežnikih
Poleg tradicionalne ukazne vrstice je koncept cevovoda postal temeljni v svetu neprekinjene integracije in neprekinjenega dostavljanja (CI/CD) . Na strežniku Linux je cevovod CI/CD avtomatizirano zaporedje korakov: pridobivanje kode, namestitev odvisnosti, prevajanje, izvajanje testov, pakiranje artefaktov in uvajanje.
Linux je za to še posebej primeren, saj izstopa po svoji hitrosti, stabilnosti in ekosistemu orodij za avtomatizacijo . Platforme, kot so Jenkins, GitHub Actions in GitLab CI, se za dosledno izvajanje cevovodov zanašajo na izvajalce Linuxa (fizične stroje, virtualne stroje ali vsebnike).
Optimizacija teh cevovodov ne pomeni le, da jih "delujejo", temveč da delujejo s čim manj trenja. To pomeni skrajšanje časov prevzema, zmanjšanje ponavljajočih se namestitev odvisnosti, optimizacijo slik Dockerja , da se izognemo nepotrebnim ponovnim izgradnjam, ponovno uporabo že ustvarjenih artefaktov ter ohranjanje varnosti in preglednosti okolja.
Osnovna dobra praksa je strukturiranje cevovoda v dobro opredeljene faze: gradnja, testiranje in uvajanje . V idealnem primeru bi morali prevesti samo enkrat, ustvariti artefakt (binarno datoteko, paket, sliko Dockerja), ki se vzporedno testira v različnih različicah (na primer v različnih jezikovnih različicah), nato pa isti artefakt namestiti v pripravljalna in produkcijska okolja brez ponovnega prevajanja.
Delo z nespremenljivimi artefakti, shranjenimi v repozitorijih (S3, Nexus, Artifactory, registri vsebnikov ali paketi, vdelani v GitLab/GitHub), poenostavlja revidiranje, omogoča hitro vračanje različic in zmanjšuje verjetnost, da »deluje na mojem računalniku, ne pa tudi v produkciji«.
Predpogoji: distribucija, uporabniki CI in utrjevanje strežnika
Preden se tu in tam ujamemo v milisekundno optimizacijo, je pomembno, da na strežniku Linux vzpostavimo stabilne temelje , ki bodo delovali kot izvajalec CI/CD. To se začne z izbiro distribucije in minimalne varnostne konfiguracije.
Najbolj smiseln pristop je običajno standardizacija na distribuciji LTS ali stabilni distribuciji , ki jo ekipa pozna: Ubuntu LTS, Debian Stable ali alternative za podjetja, kot sta AlmaLinux ali Rocky Linux. Če so vsi izvajalci na isti različici, se prepreči nepričakovano vedenje, ki ga povzročajo različne knjižnice ali jedra med opravili.
Drugo priporočilo je, da konfigurirate namenski uporabnik za CI, brez root pravic, s sudo, ki je zelo omejen le na bistvene ukaze (na primer systemctl o docker (če je res potrebno). Ta uporabnik se mora overiti s ključi SSH, tako za dostop do strežnika kot za interakcijo z repozitoriji Git ali drugimi oddaljenimi računalniki.
Na sistemski ravni je priporočljivo vzdrževati strežnik posodobljeno in minimalno ojačanoTo vključuje uporabo varnostnih posodobitev, konfiguriranje omejevalnega požarnega zidu (na primer z UFW: zavračanje vsega dohodnega prometa, razen tistega, ki je potreben, in dovoljevanje odhodnega prometa) in omogočanje orodij, kot so fail2ban za zaustavitev napadov z grobo silo na SSH in prilagoditev nekaterih omrežnih in jedrnih parametrov prek sysctl za izboljšanje zanesljivosti in zmogljivosti.
Na primer, običajno je zvišati mejo obvesti da preprečite, da bi sistemi za gradnjo, ki spremljajo veliko datotek, zmanjkalo virov, in prilagodite parameter vm.swappiness da bi bilo jedro bolj konzervativno pri uporabi swap-a, kar je še posebej pomembno, kadar opravila CI hkrati porabijo veliko pomnilnika.
Predpomnilniki, Docker in paralelizacija: vzvodi zmogljivosti v CI/CD
Če pogledate, kam gre čas dejansko v povprečnem cevovodu, boste videli, da se velik del izgubi pri nameščanju odvisnosti in ponovni izgradnji slik Docker . Reševanje tega je običajno učinkovitejše od optimizacije testne kode za nekaj milisekund.
Prva vzvod je predpomnjenje odvisnosti . Skoraj vsi upravitelji odvisnosti (pip, npm, Maven, Gradle, moduli Go itd.) uporabljajo lokalne imenike predpomnilnika. Na trajnem strežniku Linux lahko te imenike delite med opravili ali jih namestite na trajni nosilec. Na ta način pri vsakem izvajanju ni treba ponovno prenesti polovice interneta.
Za Docker omogočite Komplet za gradnjo in dobro strukturirati Dockerfile To pomeni prelomnico. Če namestite odvisnosti takoj za kopiranjem datoteke z zahtevami in pred preostalo kodo, zagotovite, da se plasti ponovno uporabijo, dokler različice teh odvisnosti ostanejo nespremenjene. Poleg tega je mogoče v sami gradnji nastaviti posebne predpomnilnike za pip, npm itd.
Drugi pomemben vzvod je vzporedno izvajanje testovŠtevilni ogrodji izvorno podpirajo sočasnost: pytest z -n autoOrodja Java, kot sta Surefire in Jest v JavaScriptu z --maxWorkersitd. Razdelitev paketa po modulih, mapah ali celo po predvidenem času in njegova porazdelitev med več delavcev omogoča skrajšanje trajanja testne faze za 2- do 5-krat, ne da bi se spremenila ena sama poslovna linija.
Končno je tu še vprašanje artefaktov in uvajanja . Namesto ponovnega prevajanja iste slike za pripravo, predprodukcijo in produkcijo je učinkovit pristop enkratna izdelava, shranjevanje rezultata v repozitorij in označevanje glede na okolje uvajanja. To zmanjša porabo procesorja, se izogne nedoslednostim in znatno pospeši dolge cevovode.
Optimizacija Jenkinsa, GitHub Actions in GitLab Runnerja v Linuxu
Vsak sistem CI ima svoje posebnosti, vendar imajo vsi koristi od istih osnovnih idej pri delovanju v Linuxu. Ključno je običajno uporaba kratkotrajnih in čistih izvajalcev , vzdrževanje ustrezno velikega trajnega predpomnilnika in nadzor sočasnosti.
V Jenkinsu je običajna praksa uporaba lahkih, začasnih agentov (kot so Dockerjevi kontejnerji ali podi v Kubernetes ali druge rešitve za orkestracijo kontejnerjev ) za izvajanje opravil, pri čemer je glavno vozlišče čim bolj preprosto. Te agente je mogoče konfigurirati kot sistemske storitve na strežnikih Linux, registrirati se pri krmilniku in se samodejno zagnati, ko se računalnik zažene.
Za dejanja GitHub z lastno gostovanimi izvajalci je priporočljivo, da jih namestite v Virtualni stroji Linux s hitrimi SSD-jiČe želite ustvariti velik imenik predpomnilnika, namenjen dejanjem (jezikovne odvisnosti, predpomnilniki gradnje itd.), omejite število sočasnih opravil, da se izognete preobremenitvi procesorja in diska. Izkoristite uradno dejanje predpomnjenja s potmi, kot je ~/.cache/pip, ~/.npm o ~/.m2 To naredi ogromno razliko v času.
V GitLab Runnerju je izbira med izvajalcem lupine in Dockerjem odvisna od želenega ravnovesja med zmogljivostjo in izolacijo. Izvajalec lupine je hitrejši, ker se izvaja neposredno na gostitelju, vendar izvajalec Docker ponuja čista in ponovljiva okolja. Konfigurirate lahko tudi skupno predpomnjenje (lokalno ali na S3) in prilagodite največje število sočasnih opravil, da izkoristite strojno opremo, ne da bi jo preobremenili.
V vseh teh primerih je ključnega pomena imeti skupne nosilce podatkov za predpomnjenje odvisnosti, hkrati pa preprečevati, da bi delovni prostori med gradnjami postali neredni. Kratkoročni stroji ali vsebniki, ki se ustvarjajo in uničujejo z vsakim cevovodom ali skupino cevovodov, močno zmanjšajo težave »včeraj je delovalo, danes pa ne več«, ki jih povzročajo ostanki prejšnjih gradnjah.
Zmogljivost strežnika Linux: CPU, pomnilnik, V/I in Docker
Ne glede na to, kako optimizirani so vaši skripti, če strežnik Linux, na katerem se izvaja cevovod, ni pravilno dimenzioniran, boste naleteli na neskončne čakalne vrste in počasna opravila. Tipična, razumna konfiguracija za stroj srednjega razreda je 4–8 virtualnih procesorjev in 8–16 GB RAM-a , s SSD pomnilnikom (idealno NVMe) in nekaj izmenjalnim prostorom (2–4 GB) za obvladovanje največjih obremenitev brez agresivnega ustavljanja procesov.
Pomemben je tudi datotečni sistem. Uporabite ext4 ali XFS z možnostjo noatime Na nosilcih podatkov, kjer prevajate ali zapisujete dnevnike, zmanjšajte nepotreben V/I. Poleg tega priklop tmpfs za začasne datoteke ali kratkotrajne artefakte (na primer /mnt/ci-tmp) pospeši intenzivne operacije in prepreči, da bi se disk med opravili napolnil s preostalimi datotekami.
Kar zadeva Docker, je higiena demonov ključnega pomena. Varno in redno odstranjevanje neuporabljenih slik in nosilcev podatkov ob hkratnem ohranjanju aktivnih osnovnih slik pomaga nadzor prostora na disku in časov zagonaUkazi, kot so docker system prune Z ustreznimi časovnimi filtri omogočajo čiščenje brez preobremenitve nedavno uporabljenih virov.
Če vaša nepovezana arhitektura uporablja veliko vsebnikov, lahko uporabite tudi zrcalne registre , da se izognete nenehnemu prenašanju z interneta, uporabite BuildKit za sočasnost in predpomnjenje plasti ter celo konfigurirate afinitete CPU-ja (nize CPU-ja) ali namenska vozlišča za najzahtevnejše izvajalce, s čimer preprečite motnje med sosednjimi delovnimi obremenitvami. Poleg tega vam razumevanje mikroarhitekture CPU-ja pomaga pri boljši dimenzioniranju virov za intenzivne delovne obremenitve nepovezane arhitekture.
Varnost v razvoju (DevSecOps) in uvajanje v Linuxu
Hiter, a nevaren cevovod je tempirana bomba. Integracija varnosti v sam cevovod in varnost Dockerjevega vsebnika je zdaj standardna v vsaki strategiji DevSecOps, Linux pa za to ponuja veliko orodij.
Najprej je treba s skrivnostmi in poverilnicami ravnati zelo skrbno . Nikoli ne smejo biti shranjene v kodi ali v konfiguracijskih datotekah z različicami. Namesto tega so shranjene v upraviteljih skrivnosti (maskirane spremenljivke GitLab, šifrirane skrivnosti GitHub, trezor HashiCorp itd.) in vbrizgane le med izvajanjem opravila, ki jih potrebuje, pri čemer se po možnosti uporabljajo kratkotrajni žetoni.
Druga pomembna plast je generiranje SBOM-ov (seznamov programske opreme) in podpisovanje artefaktov. Orodja, kot sta Syft ali CycloneDX, omogočajo seznam vseh komponent, ki sestavljajo sliko ali binarno datoteko, medtem ko Cosign ali druge preverljive rešitve za podpisovanje zagotavljajo, da se namestijo le artefakti, ki so šli skozi cevovod in so bili potrjeni.
Kar zadeva omrežje in dostop, je priporočljivo segmentirati omrežja za neomejeno infrastrukturo in produkcijska omrežja , uvesti stroge požarne zidove, beležiti dnevnike izvajanja in redno menjati poverilnice. Kjer se uporablja SSH, je bolje uporabljati potrdila ali ključe z datumi poteka veljavnosti namesto statičnih gesel.
Pri uvajanju v Linuxu strategije, kot so Blue/Green, rolling in canary, močno zmanjšajo vpliv napak pri uvajanju. Če aplikacijo zaženete kot storitev systemd, pred njo namestite Nginx ali HAProxy in nadzorujete promet med različicami s preverjanji zdravja, lahko dosežete praktično nič izpadov med posodobitvami.
Na primer, pri ponovnem nalaganju Nginxa in ponovnem zagonu storitev s systemd z uporabo signalov za mehko zaustavitev (kot je SIGTERMZ razumnimi čakalnimi časi lahko izpraznite aktivne povezave, preden se postopek ustavi, s čimer ohranite uporabniško izkušnjo nedotaknjeno, medtem ko v ozadju preklapljate med različicami.
Opazljivost, metrike in stroški v Linux cevovodih
Ko so vaši cevovodi zagnani in delujejo, je naslednji korak njihovo merjenje in razumevanje, kam gresta čas in viri . Ni dovolj vedeti, ali je delovni tok uspešen ali ne; spremljati morate trajanje posamezne faze, čas čakalne vrste, stopnjo uspešnosti, pogostost uvajanja, stopnjo zadetkov v predpomnilniku in tako naprej.
Sistemske metrike se običajno izvažajo z uporabo node_exporterCentralizirajte dnevnike z rešitvami, kot sta ELK ali Loki, in vse vizualizirajte na nadzornih ploščah Grafana. Na ta način lahko na primer zaznate, ali se je trajanje faze testiranja v zadnjem tednu podaljšalo za 30 % ali ali opravila predolgo čakajo na razpoložljivega izvajalca; spremljanje omrežnega prometa Odprtokodna orodja dopolnjujejo to prepoznavnost.
Prav tako je mogoče instrumentirati sam cevovod, na primer v GitHub Actions ali GitLab CI, da za programsko merjenje števila uspešnih izvedb, časa trajanja posameznega izvajanja in splošnega stanjaSkript, ki pokliče API ponudnika, izračuna skupno število zagonov, število uspešnih zagonov, število neuspelih zagonov, stopnjo uspešnosti in povprečno trajanje ter vse shrani v datoteko JSON (kot je pipeline-metrics.json) vam omogoča integracijo teh meritev v poročila ali nadzorne plošče.
S temi informacijami se lahko odločite o velikosti in številu izvajalcev : včasih je bolje imeti več majhnih izvajalcev kot nekaj zelo velikih, da se skrajšajo čakalni časi. Samodejna skalabilnost – na primer samodejno skaliranje v oblaku ali dinamični bazeni vozlišč Kubernetes – pomaga absorbirati največjo aktivnost čez dan in zmanjšati premalo izkoriščene vire ponoči.
Te prakse ne le izboljšajo izkušnjo ekipe, temveč pomagajo tudi pri prilagajanju stroškov infrastrukture z nadzorom porabe procesorja, pomnilnika in zlasti prostora za shranjevanje, ki se ponavadi močno poveča s slikami in predpomnilniki, če se ne čistijo redno in načrtovano.
Obvladovanje klasičnih ukaznih vrstic in sodobnih cevovodov CI/CD v Linuxu ponuja zmogljivo kombinacijo: avtomatizirate lahko vse, od preprostih nalog filtriranja besedila do kompleksnih, vzdržnih, varnih in hitrih cevovodov za gradnjo, testiranje in uvajanje. Razumevanje pretoka informacij med procesi, predpomnjenja odvisnosti, uglaševanja strežnikov ter integracije metrik in varnosti vam omogoča, da zgradite delovne tokove, ki se prilagajajo vaši ekipi in projektom, ne da bi pri tem postali stalna ozka grla.
