- Monitorimi i trafikut të rrjetit në kohë reale lejon parashikimin e dështimeve, përmirësimin e performancës dhe forcimin e sigurisë së infrastrukturës së IT-së.
- Mjetet me burim të hapur si Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS ose Observium ofrojnë veçori të përparuara pa kosto licence.
- Kombinimi i mbledhësve të metrikave, bazave të të dhënave të serive kohore dhe shtresave të vizualizimit si Grafana dhe Graphite krijon zgjidhje shumë fleksibile dhe të shkallëzueshme.
- Përcaktimi i kërkesave, zbatimi i praktikave më të mira dhe kryerja e një prove të konceptit janë çelësi për zgjedhjen dhe vendosjen e platformës më të përshtatshme të monitorimit.
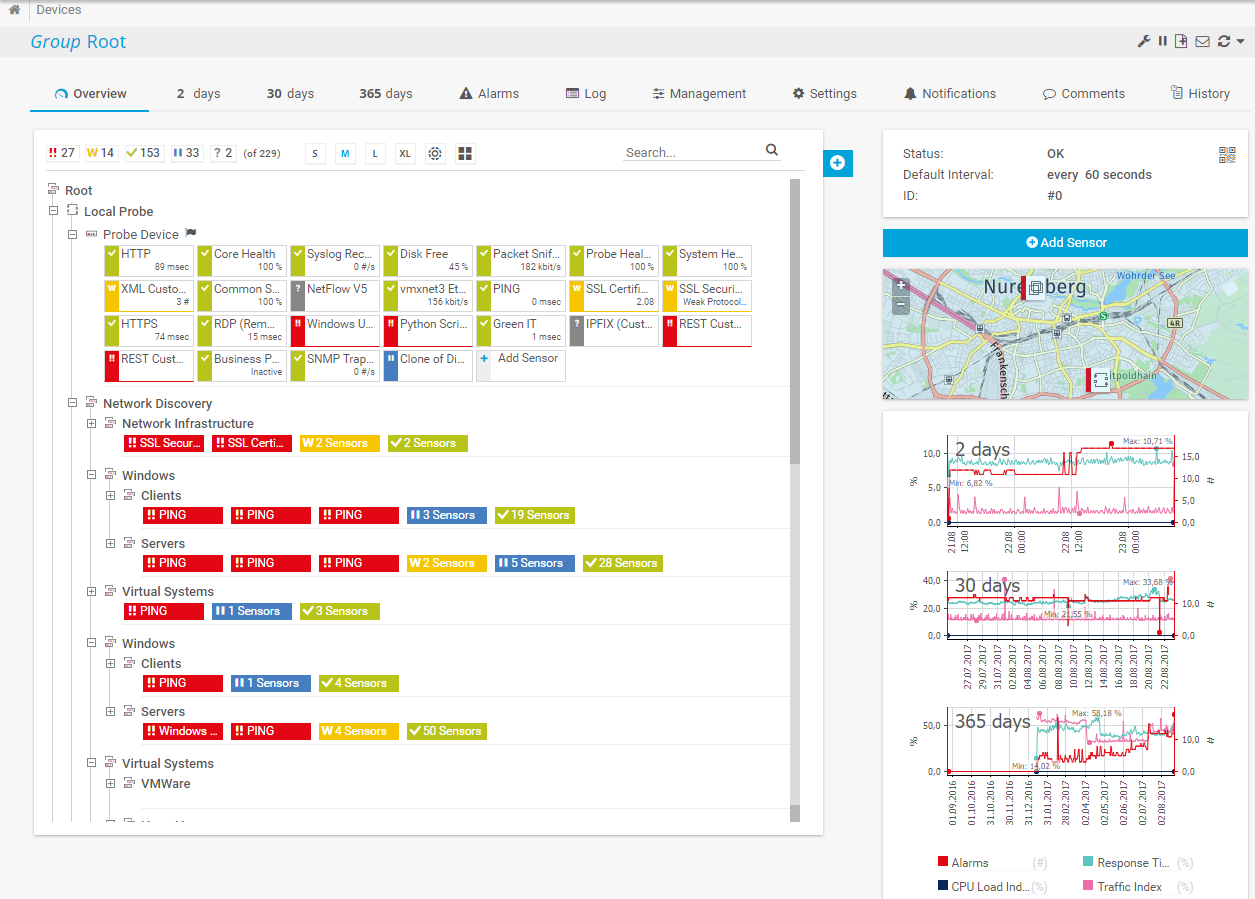
Kur rrjeti i një kompanie fillon të ngadalësohet, Wi-Fi bie ose një server kritik rrëzohet në momentin më të keq të mundshëm, thjesht "rinisja e ruterit dhe kryqëzimi i gishtave" nuk mjafton më. Sot, është thelbësore të kesh mjete monitorimi të trafikut të rrjetit me burim të hapur që të lejojnë të shohësh se çfarë po ndodh në kohë reale, të parashikosh problemet dhe të shmangësh ndërprerjet e kushtueshme.
Nëse punoni në IT, rrjetëzim, ose keni qenë ndonjëherë udhëheqës teknik në kompaninë tuaj, ndoshta keni dëgjuar për zgjidhje si PRTG ose SolarWinds… dhe licencat e tyre. Lajmi i mirë është se ekziston një ekosistem shumë i zhvilluar platformash me burim të hapur për monitorimin e pajisjeve, shërbimeve dhe trafikut të rrjetit (routerë, switch-e, pika aksesi Wi-Fi, serverë, kontejnerë, re publike dhe shumë më tepër) pa tarifa të tepruara dhe me fleksibilitet të jashtëzakonshëm.
Çfarë është monitorimi i trafikut të rrjetit në kohë reale dhe pse është kaq i rëndësishëm?
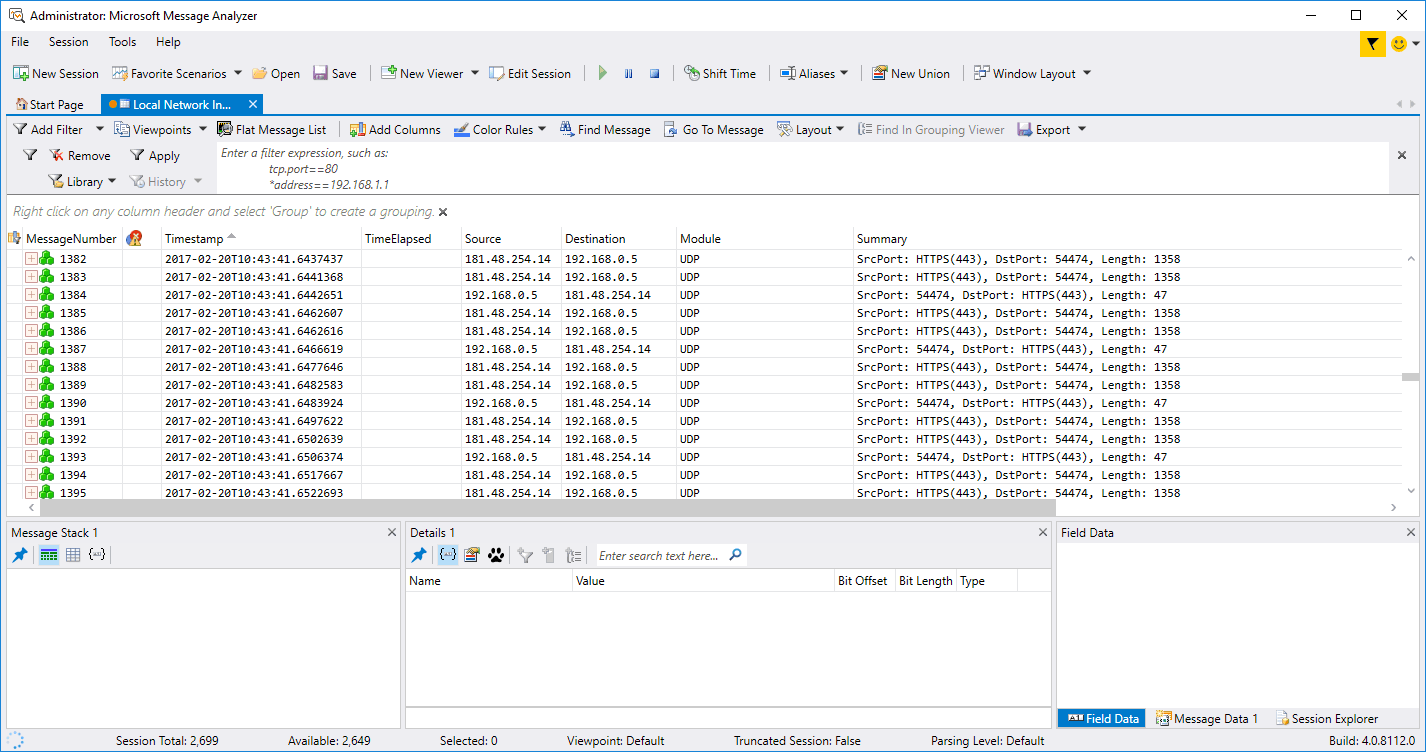
Kur flasim për monitorimin e rrjetit në kohë reale, i referohemi mbikëqyrjes së vazhdueshme të statusit, performancës dhe sigurisë së infrastrukturës së IT-së dhe komunikimit , duke zbuluar incidentet në momentin që ato ndodhin. Softueri mbledh dhe analizon vazhdimisht metrika nga pajisjet, sistemet dhe aplikacionet në mënyrë që ekipi i IT-së të mund të reagojë përpara se problemi të ndikojë në biznes.
Këto lloje zgjidhjesh mbështeten në protokolle të tilla si SNMP, NetFlow/sFlow, ICMP , API dhe agjentë specifikë për të mbledhur të dhëna nga routerë, switch-e, firewall-e, pikat e aksesit, serverët fizikë dhe virtualë, kontejnerët, shërbimet cloud, aplikacionet web, bazat e të dhënave dhe praktikisht çdo element që është pjesë e infrastrukturës.
Objektivi kryesor është të ketë dukshmëri të plotë mbi trafikun, përdorimin e bandwidth-it, disponueshmërinë dhe gjendjen e secilit komponent . Kjo lejon zbulimin e bllokimeve , sulmeve, dështimeve të harduerit ose mbingarkesave të shërbimit përpara se ato të rezultojnë në ndërprerje, ngadalësi të përhapur ose humbje të të dhënave.
Përveç të dhënave të drejtpërdrejta, shumë mjete ju lejojnë të ruani metrika historike për analizën e trendeve , planifikimin e kapaciteteve, verifikimin e përputhshmërisë SLA/OLA, auditimin e sigurisë dhe mbështetjen për vendimet e investimeve në pajisje ose lidhje të reja.
Përdorimet dhe përfitimet kryesore të monitorimit në kohë reale
Një nga përfitimet më të mëdha është mirëmbajtja parandaluese e infrastrukturës së IT-së dhe rrjetit . Të kesh metrika të vazhdueshme mbi CPU-në, memorien, temperaturën, statusin e furnizimit me energji, gabimet e ndërfaqes dhe humbjen e paketave ndihmon në zbulimin e shenjave të hershme të dështimit përpara se të ndodhë një avari serioze ose ndërprerje e shërbimit.
Përgjigja e hershme ndaj incidenteve është një tjetër shtyllë kyçe. Platformat e monitorimit gjenerojnë alarme të personalizueshme (email, SMS, Slack, Teams, webhooks, etj.) kur një vlerë tejkalon një prag, një shërbim bëhet i papërgjegjshëm ose shfaqet një model i dyshimtë trafiku. Kjo zvogëlon ndjeshëm kohën e ndërprerjes dhe ndikimin e incidenteve të sigurisë ose dështimeve të performancës.
Në operacionet e përditshme, monitorimi kontribuon në optimizimin e performancës së përgjithshme të rrjeteve, serverave dhe aplikacioneve. Të qenit në gjendje të shohësh se cilat lidhje janë të mbingarkuara, cilat shërbime po konsumojnë më shumë burime ose cilat zona kohore po shkaktojnë ngarkesa maksimale ndihmon në rregullimin e konfigurimeve, balancimin e ngarkesave, ripërcaktimin e politikave QoS dhe, në përgjithësi, në marrjen e një performance më të mirë nga teknologjia e instaluar.
Një aspekt tjetër gjithnjë e më i rëndësishëm është përputhshmëria rregullatore. Një sistem i mirë monitorimi lehtëson kontrollin e aksesit, gjurmimin e të dhënave të ndjeshme dhe zbulimin e aksesit të paautorizuar , duke ofruar regjistra dhe metrika të dobishme për auditime dhe për të demonstruar përputhshmërinë me kërkesat rregullatore ose kontraktuale.
Së fundmi, nga një perspektivë biznesi, këto zgjidhje bëhen mjete mbështetëse të vendimmarrjes : raporte periodike, panele ekzekutive, analiza historike e incidenteve dhe disponueshmërisë, krahasime midis faqeve ose ofruesve të shërbimeve cloud… e gjithë kjo ndihmon për të justifikuar investimet, për të negociuar me palët e treta dhe për të përcaktuar përparësitë e projekteve të IT-së.
Avantazhet specifike të softuerit të monitorimit me burim të hapur
Avantazhi i parë i dukshëm i mjeteve me burim të hapur është efektiviteti i tyre në kosto: nuk ka licenca të mbyllura ose kosto agresive për pajisje si ato që gjenden në shumë platforma komerciale. Kjo nuk do të thotë që gjithçka është falas (gjithmonë ka kosto infrastrukture, mbështetjeje dhe trajnimi), por kursimet në licenca lirojnë hapësirë për të investuar në fusha të tjera kritike.
Pika e dytë e fortë është mbështetja dhe inovacioni i komunitetit . Projekte si Nagios, Zabbix, Prometheus, LibreNMS dhe Netdata kanë komunitete shumë aktive që zhvillojnë plugin-e, integrime, panele kontrolli dhe përmirësime të vazhdueshme, si dhe rregullojnë shpejt gabimet dhe mbyllin dobësitë.
Gjithashtu, dallohet për transparencën dhe besueshmërinë e kodit të tij : si softuer me burim të hapur, kushdo mund të auditojë se si përpunohen dhe ruhen të dhënat, të rishikojë sigurinë e sistemit dhe ta përshtatë kodin burimor sipas nevojave specifike. Kjo zvogëlon rrezikun e "backdoors" të fshehura dhe e bën më të lehtë përmbushjen e politikave të sigurisë së brendshme.
Një pikë tjetër kyçe është shmangia e bllokimit nga shitësit. Me zgjidhje të hapura, është më e lehtë të migrohet midis mjeteve ose të kombinohen ato (për shembull, duke përdorur Prometheus për metrika aplikacionesh, Zabbix për pajisjet e rrjetit dhe Grafana si një shtresë të unifikuar vizualizimi), pa u lidhur me planin e jetës së një kompanie të vetme.
Natyrisht, mjetet me burim të hapur zakonisht kërkojnë një nivel të caktuar aftësish teknike për instalimin, konfigurimin dhe mirëmbajtjen , por në këmbim ato ofrojnë fleksibilitet dhe fuqi që konkurrojnë kokë më kokë me shumë zgjidhje komerciale, veçanërisht në mjediset ku vlerësohet përshtatja dhe integrimi me sistemet ekzistuese.
Mjetet kryesore të monitorimit me burim të hapur për rrjetet dhe infrastrukturën
Ekzistojnë dhjetëra projekte të pjekura të fokusuara në monitorimin e rrjeteve, serverave, aplikacioneve dhe mjediseve cloud. Më poshtë është një përmbledhje e mjeteve më të rëndësishme me burim të hapur për trafikun e rrjetit dhe vëzhgueshmërinë , bazuar në analiza të ndryshme teknike dhe krahasime të specializuara.
Një nga shembujt klasikë është Nagios Core , një motor monitorimi dhe alarmimi shumë i fuqishëm. Ai shërben si bazë për shumë projekte Nagios dhe merret me kontrollet e planifikimit, përpunimin e rezultateve, menaxhimin e ngjarjeve dhe gjenerimin e alarmeve. Arkitektura e tij modulare lejon zgjerimin e aftësive përmes API-ve dhe shtojcave të personalizuara, dhe ekosistemi i tij është i gjerë, me integrime për pothuajse çdo lloj pajisjeje ose shërbimi.
Një tjetër gjigant në botën e burimit të hapur është Zabbix , i cili është shumë i fokusuar në monitorimin e infrastrukturave të IT-së në shkallë të gjerë. Është veçanërisht i fuqishëm për mbledhjen dhe analizimin e metrikave të pajisjeve të rrjetit (përdorimi i gjerësisë së brezit, statusi i ndërfaqes, lidhjet, humbja e paketave, temperatura, CPU, memoria, etj.), qoftë përmes SNMP ose me agjentët e vet. Ai u lejon përdoruesve të përcaktojnë pragje, rrjedha të përshkallëzimit të alarmeve, orare, kanale njoftimesh dhe logjikë ngjarjesh shumë të detajuar.
Në sferën e aplikacioneve të bazuara në cloud dhe të dhënave të serive kohore, Prometheus dallohet . Kjo zgjidhje përdor një model të dhënash dimensionale, të identifikuar nga emrat metrikë dhe etiketat çelës-vlerë, dhe shfrytëzon gjuhën e pyetjeve PromQL për të krijuar grafikë, tabela, rregulla alarmi dhe pyetje komplekse. Të dhënat e saj ruhen në mënyrë efikase në memorie dhe disk lokal, duke i bërë instancat individuale shumë autonome, dhe integrohet pa probleme me Grafana për vizualizim.
Për ata që kërkojnë një zgjidhje të lehtë të fokusuar në kohë reale shumë të shkurtër dhe vonesë minimale, Netdata është një opsion shumë interesant. Instalohet si agjent në çdo server ose pajisje Linux, mbledh metrika të sistemit dhe aplikacionit, ruan të dhënat në vetë nyjen (pa u mbështetur në bazat e të dhënave të jashtme në afat të shkurtër) dhe ofron panele të automatizuara me vizualizime shumë të detajuara të performancës, madje duke përdorur modele të të mësuarit automatik për të zbuluar anomalitë.
Mjete të specializuara për rrjetet dhe vizualizimin e trafikut
Përtej platformave me qëllim të përgjithshëm, ekzistojnë mjete me burim të hapur që synojnë drejtpërdrejt monitorimin e trafikut të rrjetit dhe grafikët e performancës , veçanërisht të dobishëm kur fokusi është në shikimin e gjerësisë së brezit, rrjedhave dhe shëndetit të lidhjeve.
Një nga më të njohurit është Cacti , i cili përqendrohet në krijimin e grafikëve të rrjetit dhe menaxhimin e defekteve për monitorimin operacional. Ai përdor RRDTool për të ruajtur të dhëna dhe për të gjeneruar grafikë, ofron shabllone për të automatizuar regjistrimin e pajisjeve dhe mbështet metoda të shumta të mbledhjes së të dhënave. Shtojcat e tij (THold, SysLog, MacTrack, ndër të tjera) lejojnë pragje, integrimin e syslog, gjurmimin e adresës MAC dhe monitorimin e pajisjeve në kohë reale.
Një platformë tjetër shumë e fuqishme është OpenNMS Horizon , e cila konsiderohet si një nga zgjidhjet e para të monitorimit të shërbimeve të rrjetit në nivel ndërmarrjeje, plotësisht me burim të hapur. Ajo mbështet monitorimin e rrjeteve lokale dhe të shpërndara, duke ofruar inventar, menaxhim të defekteve, mbledhje të të dhënave në distancë, korrelacion alarmi, monitorim të shërbimeve të biznesit dhe monitorim të trafikut. Gjithçka menaxhohet përmes një ndërfaqeje intuitive në internet me panele të personalizueshme.
Në një mënyrë të ngjashme, Icinga pozicionohet si një evolucion modern i modelit Nagios, me një ndërfaqe web të rafinuar dhe një fokus të fortë në monitorimin e rrjetit, performancën e ndërfaqes, përdorimin e bandwidth-it, gabimet, ngarkesën e CPU-së dhe memories, si dhe shëndetin e harduerit. Icinga mbështet kontrollet SNMP, metrikat specifike të shitësit dhe pritjen e kurtheve SNMP, duke u integruar me Logstash për të menaxhuar ngjarjet nga pajisje të shumta.
Për ata që kanë nevojë për një pamje shumë të detajuar të pajisjeve të rrjetit, ndërfaqeve dhe trafikut, projekte si LibreNMS dhe Observium janë veçanërisht të dobishme. Të dyja mbështeten shumë në SNMP dhe protokollet e zbulimit (CDP, LLDP, OSPF, BGP, ARP, etj.) për të zbuluar automatikisht rrjetin, për të gjeneruar harta dhe për të paraqitur metrika të performancës me grafikë të qartë , pragje të konfigurueshme dhe sisteme fleksibile alarmi.
Vizualizim i avancuar me Grafana dhe Grafit
Në shumë implementime komplekse, shtresa e mbledhjes së metrikave është e ndarë nga shtresa e vizualizimit. Dy projekte kryesore në këtë qasje janë Grafana dhe Graphite , të dyja me burim të hapur dhe të përdorura gjerësisht në mjediset e ndërmarrjeve.
Grafana është një mjet ndërplatformor, i mundësuar nga plugin-e, i projektuar për të krijuar panele të vizualizimit të të dhënave plotësisht të personalizuara. Ai ju lejon të lidhni burime të shumta të të dhënave (Prometheus, Graphite, InfluxDB, MySQL, ofrues të cloud-it, etj.) dhe të shfaqni metrika në histograme, harta gjeografike, harta të nxehtësisë, grafikë vijash, tabela dhe shumë lloje të tjera vizualizimesh. Ai mbështet shënime në kohë reale, panele dinamike dhe përcaktimin e alarmeve me njoftime në kanale të ndryshme.
Graphite përqendrohet në kapjen dhe paraqitjen grafike të metrikave të serive kohore. Mund të vendoset në harduer të thjeshtë ose në cloud dhe është ideal për monitorimin e performancës së faqeve të internetit, shërbimeve të ndërmarrjeve, serverëve dhe metrikave të rrjetit . Shumë ekipe zgjedhin shërbime të menaxhuara të bazuara në Graphite (siç është MetricFire) që shtojnë ruajtje të grupuar, etiketim të të dhënave, integrime shtesë dhe njoftime shumëkanalëshe, ndërsa ende shfrytëzojnë fuqinë e Graphite dhe shpesh Grafana për pjesën e përparme.
Në një vendosje tipike, sistemet e rrjetit dhe serverët dërgojnë metrika te Graphite ose një koleksionist i pajtueshëm (p.sh., duke përdorur protokolle të tilla si StatsD), dhe më pas panelet ndërtohen në Grafana për të ofruar një pamje të unifikuar të gjendjes së të gjithë infrastrukturës: nga trafiku në secilën ndërfaqe deri te vonesa e pyetjeve ose përdorimi i CPU-së për shërbim.
Zgjidhje të tjera të rëndësishme të monitorimit me burim të hapur
Ekosistemi i monitorimit me burim të hapur është shumë i gjerë dhe mbulon nevoja specifike siç janë zbulimi automatik, monitorimi i proceseve, kanalet e vëzhgueshmërisë ose mbledhja e metrikave nga mjedise shumë heterogjene.
Për shembull, Checkmk është një platformë shumë e shkallëzueshme e aftë të monitorojë gjithçka, nga mjediset e vogla deri te ndërmarrjet e mëdha. Ajo përfshin menaxhim të avancuar të agjentëve, zbulim automatik të rrjetit, vizualizime interaktive, sisteme të fuqishme alarmi, raportim SLA, analizë të regjistrave dhe ngjarjeve, si dhe API për të zgjeruar funksionalitetin e saj. Ofrohet në botime të ndryshme (RAW falas, Enterprise, Cloud dhe MSP), duke u përshtatur me madhësi dhe modele shërbimesh të ndryshme.
M/Monit përqendrohet në monitorimin dhe vetë-riparimin e sistemeve Unix dhe Linux. Ai monitoron proceset, përdorimin e CPU-së dhe memories, si dhe ndërfaqet e rrjetit, dhe mund të reagojë automatikisht ndaj gabimeve duke kryer veprime korrigjuese. Gjithashtu ju lejon të monitoroni nisjen e shërbimit, të skanoni skedarët dhe drejtoritë për ndryshime të paautorizuara dhe të kontrolloni lidhjet e rrjetit me serverët lokalë ose të largët.
Në fushën e topologjisë së rrjetit dhe analizës së metrikave, Pandora FMS shquhet si një zgjidhje gjithëpërfshirëse, duke ofruar monitorim të rrjetit, UX, cloud, server dhe aplikacionesh, inventar, menaxhim të regjistrave dhe panele të personalizueshme. Mund të zbulojë automatikisht ndërfaqet e rrjetit, të krijojë harta, të shfaqë statistika në kohë reale mbi bllokimet dhe të ofrojë raporte gjithëpërfshirëse.
Për mikroserviset moderne dhe arkitekturat me shumë re, Sensu vepron si një lloj kanali i vëzhgimit të centralizuar që unifikon mjete të ndryshme monitorimi. Ofron kontrolle shëndetësore, metrika të performancës së personalizuar, menaxhim të regjistrave, menaxhim të problemeve të rrjetit dhe njoftime shumëkanalëshe me deduplikim. Për më tepër, mbështet vetë-shërimin duke ekzekutuar rinisje të shërbimit ose skripte të personalizuara kur zbulon probleme.
Agjentë, mbledhës dhe mjete ndihmëse
Përveç platformave të mëdha, ekzistojnë mjete më të lehta, funksioni kryesor i të cilave është mbledhja dhe dërgimi i metrikave nga sistemet, sensorët dhe aplikacionet në bazat e të dhënave ose sistemet kryesore të monitorimit.
Një shembull kryesor është Telegraf , një agjent i bazuar në Go pa varësi të jashtme, i aftë të funksionojë përmes një sistemi të gjerë plugin-esh. Me mbi 300 plugin-e hyrëse/dalëse, Telegraf mund të nxjerrë metrika dhe ngjarje nga pirgje të ndryshme teknologjike dhe t'i dërgojë të dhënat në sisteme të tilla si InfluxDB, Graphite, OpenTSDB, Datadog, Librato dhe të tjera. Memoria e tij e integruar siguron që metrikat të mos humbasin edhe nëse backend-i kryesor është përkohësisht jashtë funksionit.
Një element tjetër i rëndësishëm në shumë arkitektura është përdorimi i eksportuesve dhe mbledhësve specifikë (për shembull, në ekosistemin Prometheus, me eksportues për bazat e të dhënave, serverët web, sistemet e radhës, etj.), të cilët lejojnë që metrikat të ekspozohen në një format standard pa pasur nevojë të rishkruhet çdo aplikacion.
Duke kombinuar agjentë të tillë si Telegraf, eksportues të specializuar dhe platforma vizualizimi dhe serish kohore, është e mundur të ndërtohen zgjidhje shumë të plota për monitorimin e rrjeteve, serverave, aplikacioneve dhe cloud-eve , të bazuara plotësisht në softuer falas ose me komponentë minimalë komercialë kur dëshirohet mbështetje zyrtare.
Kjo qasje modulare ka avantazhin se çdo organizatë mund të zgjedhë vetëm pjesët që i nevojiten , t'i integrojë ato me sistemet e saj ekzistuese (bileta, CMDB, SIEM, etj.) dhe të evoluojë arkitekturën ndërsa mjedisi rritet ose ndryshon drejt kontejnerëve, Kubernetes ose shërbimeve pa server.
Si të zgjidhni mjetin më të mirë të monitorimit të rrjetit me burim të hapur
Para instalimit të mjetit të parë të njohur, është e rëndësishme të përcaktoni qartë se çfarë doni të monitoroni : vetëm rrjetin fizik (routerët, switch-et, pikat e aksesit), apo edhe serverët, makinat virtuale, kontejnerët, aplikacionet, apo edhe përvojën e përdoruesit dhe shërbimet cloud. Ky përcaktim përparësish ju lejon të kufizoni gamën e opsioneve dhe të zgjidhni zgjidhje që përshtaten mirë me rastin tuaj kryesor të përdorimit.
Është e rëndësishme të vlerësoni funksionalitetet kryesore që ju nevojiten: raportet, alarmet, vizualizimi i të dhënave, ruajtja e të dhënave historike, integrimi me sisteme të palëve të treta, API-të dhe mbështetja për protokolle specifike (SNMP, NetFlow, WMI, API-të e cloud-it, etj.). Për shembull, Prometheus është ideal kur kërkohen metrika të personalizuara dhe rregulla komplekse alarmi; Cacti shkëlqen në shfaqjen e grafikëve të trafikut të rrjetit; dhe Checkmk ofron vizualizim interaktiv dhe raporte gjithëpërfshirëse SLA.
Lehtësia e përdorimit dhe konfigurimit është një faktor tjetër kyç. Mjete si Zabbix, Netdata ose Checkmk zakonisht ofrojnë asistent konfigurimi dhe panele kontrolli miqësore për përdoruesit, ndërsa zgjidhjet shumë fleksibile mund të kërkojnë më shumë konfigurim fillestar. Këshillohet të testoni ndërfaqen e zbulimit të rrjetit, krijimin e hostit dhe shërbimit, si dhe konfigurimin e alarmeve përpara se të merrni një vendim.
Për sa i përket sigurisë, është thelbësore që platforma të mbështesë enkriptimin, autentifikimin e fortë dhe kontrollin e aksesit të bazuar në role . Disa, të tilla si OpenNMS, Icinga ose Prometheus, lejojnë shtimin e moduleve ose konfigurimeve të avancuara për të forcuar sigurinë, për të segmentuar aksesin në të dhëna dhe për t'u pajtuar me standardet e brendshme ose rregullatore; për më tepër, këshillohet që kjo të plotësohet me praktikat më të mira për konfigurimin e avancuar të firewall-it në servera.
Së fundmi, rekomandohet fuqimisht të kryhet një provë koncepti (POC) me 2 ose 3 mjete finaliste , t'i vendosni ato në një mjedis të kontrolluar, të monitorohet një nëngrup përfaqësues i infrastrukturës dhe të vlerësohet performanca, lehtësia e përdorimit, cilësia e alarmeve dhe aftësia e integrimit me mjetet ekzistuese (sistemet e biletave, CI/CD, mesazhet, etj.).
Praktikat më të mira për monitorim efektiv të rrjetit
Pasi të zgjidhet platforma, suksesi varet kryesisht nga mënyra se si është projektuar vendosja. Një hap i parë thelbësor është dokumentimi dhe hartëzimi i rrjetit : cilat pajisje janë të pranishme, ku ndodhen, cilat lidhje përdorin, cilat shërbime kritike mbështesin dhe cilat varësi ekzistojnë midis tyre. Kjo do ta bëjë më të lehtë përcaktimin e asaj që dhe si të monitorohet. Për të kuptuar më mirë topologjitë dhe llojet e rrjetit, shihni Rrjetet Kompjuterike: Llojet dhe Shembuj.
Këshillohet të zgjidhni një ose më shumë protokolle standarde komunikimi për pajisjet që dërgojnë informacion në mjet: SNMP për pajisjet e rrjetit, agjentë për serverat, eksportues Prometheus për shërbime specifike, syslog për ngjarjet, etj. Sa më homogjene të jetë qasja, aq më e lehtë do të jetë mirëmbajtja e saj në planin afatgjatë.
Është gjithashtu e rëndësishme të përcaktohen sjelljet bazë : vlerat normale për vonesën, gjerësinë e brezit, CPU-në, memorien, lidhjet e njëkohshme, etj. Kjo lejon konfigurimin e pragjeve realiste dhe zbulimin më të saktë të anomalive, duke shmangur si alarmet e rreme ashtu edhe alarmet e humbura për incidente reale.
Vendosja e paneleve të qarta dhe specifike për rolet (operacione 24/7, rrjet, sisteme, menaxhim, etj.) ndihmon në zvogëlimin e kohës së diagnostikimit. Një NOC do të ketë nevojë për pamje përmbledhëse dhe njoftime në kohë reale; një administrator rrjeti, ndërfaqe të detajuara, gabime dhe radhë; dhe një CIO, disponueshmëri dhe SLA për shërbimet kritike.
Së fundmi, është thelbësore të përcaktohet një politikë për përshkallëzimin e alarmeve : kush merr çfarë lloj alarmi, nëpërmjet cilit kanal dhe me çfarë prioriteti; çfarë bëhet jashtë orarit të punës; çfarë përbën një incident të madh; dhe si koordinohet reagimi midis ekipeve. Edhe mjetet më të mira në botë humbasin efektivitetin nëse askush nuk u përgjigjet alarmeve ose nëse nuk ka një plan të qartë veprimi.
Duke marrë në konsideratë të gjitha këto pjesë, zgjidhjet me burim të hapur për monitorimin e trafikut të rrjetit ju lejojnë të ndërtoni mjedise super të fuqishme, me dukshmëri nga fillimi në fund, mbështetje për vendimmarrje dhe një themel të fortë për përmirësimin e sigurisë, disponueshmërisë dhe performancës së çdo infrastrukture, nga një biznes i vogël deri te një korporatë e madhe e shpërndarë.