- Grundläggande skillnad mellan modellträningsfasen och inferensfasen för att generera kommersiellt värde.
- Analys av driftsättningsarkitekturer: från centraliserad molnbehandling till edge computing (Edge AI).
- Utvärdering av de tekniska hårdvarukraven, särskilt vikten av VRAM i GPU:er för modellkörning.
- Optimeringsstrategier som kvantisering och användning av små språkmodeller (SLM) för att förbättra den operativa effektiviteten.

När vi pratar om artificiell intelligens föreställer sig de flesta massiva inlärningsprocesser och superdatorer som bearbetar biljoner datapunkter. Det finns dock en del av processen där den verkliga magin för företag sker: inferens. I grund och botten är det när AI slutar lära sig och börjar arbeta, och tillämpar allt den har lärt sig för att lösa verkliga problem och fatta beslut baserade på data den aldrig sett förut.
I dagens läge har företag gått bortom att se AI som ett laboratorieexperiment och har gjort det till en grundläggande del av sin dagliga verksamhet. Det handlar inte längre bara om att skapa den mest kraftfulla modellen, utan om hur man kör den på ett tillförlitligt, säkert och framför allt lönsamt, genom att flytta arbetsbelastningen från teori till aktiv produktion i hybridmiljöer.

Träning kontra inferens: De är inte samma sak
För att undvika förvirring är det viktigt att tydligt skilja mellan dessa två steg. Utbildning är som skolåren för AI; det är en intensiv process där modellen analyserar historisk data och etiketter för att hitta mönster. Kraftfulla hårdvaruacceleratorer som GPU:er eller TPU:er används i stora datacenter , och svarstid är inte prioriterad, eftersom processen kan ta dagar eller veckor.
Inferens, å andra sidan, är det slutgiltiga testet som tillämpas i realtid. Det är exekveringsprocessen där modellen tar emot indata (ett foto, text eller sensoravläsning) och returnerar ett omedelbart resultat. I denna fas blir latensen avgörande och effektivitet är nyckeln. Medan träning lägger grunden, är inferens det som genererar direkt ekonomiskt värde för organisationen.
Implementeringsstrategier: Moln, lokalt och Edge
Det finns inget enskilt sätt att utföra inferens. Beroende på hur brådskande och mängden data är, väljer företag mellan flera metoder. Batchinferens är idealisk för massiva, icke-brådskande uppgifter, såsom finansiell analys över natten eller storskalig dokumentkategorisering, där data bearbetas i molnet och resultaten returneras senare.

Sedan har vi realtidsinferens , avgörande för chatbotar eller system för bedrägeriupptäckt, där svaret måste komma fram inom millisekunder. Även om molnet fortfarande är det dominerande alternativet på grund av dess skalbarhet, börjar det visa sina begränsningar på grund av nätverkslatens och höga bandbreddskostnader vid hantering av terabyte data.
Det är här kantinferens, eller Edge AI, kommer in i bilden . Genom att bearbeta data direkt på enheten (en IoT-sensor, en robot eller en smartphone) uppnås extremt låg latens och betydligt större integritet, eftersom känslig information inte behöver resa till en fjärrserver. Detta är avgörande inom sektorer där en fördröjning på millisekunder kan vara kritisk, såsom autonom körning eller telekirurgi.
Växtinferens och Industri 4.0
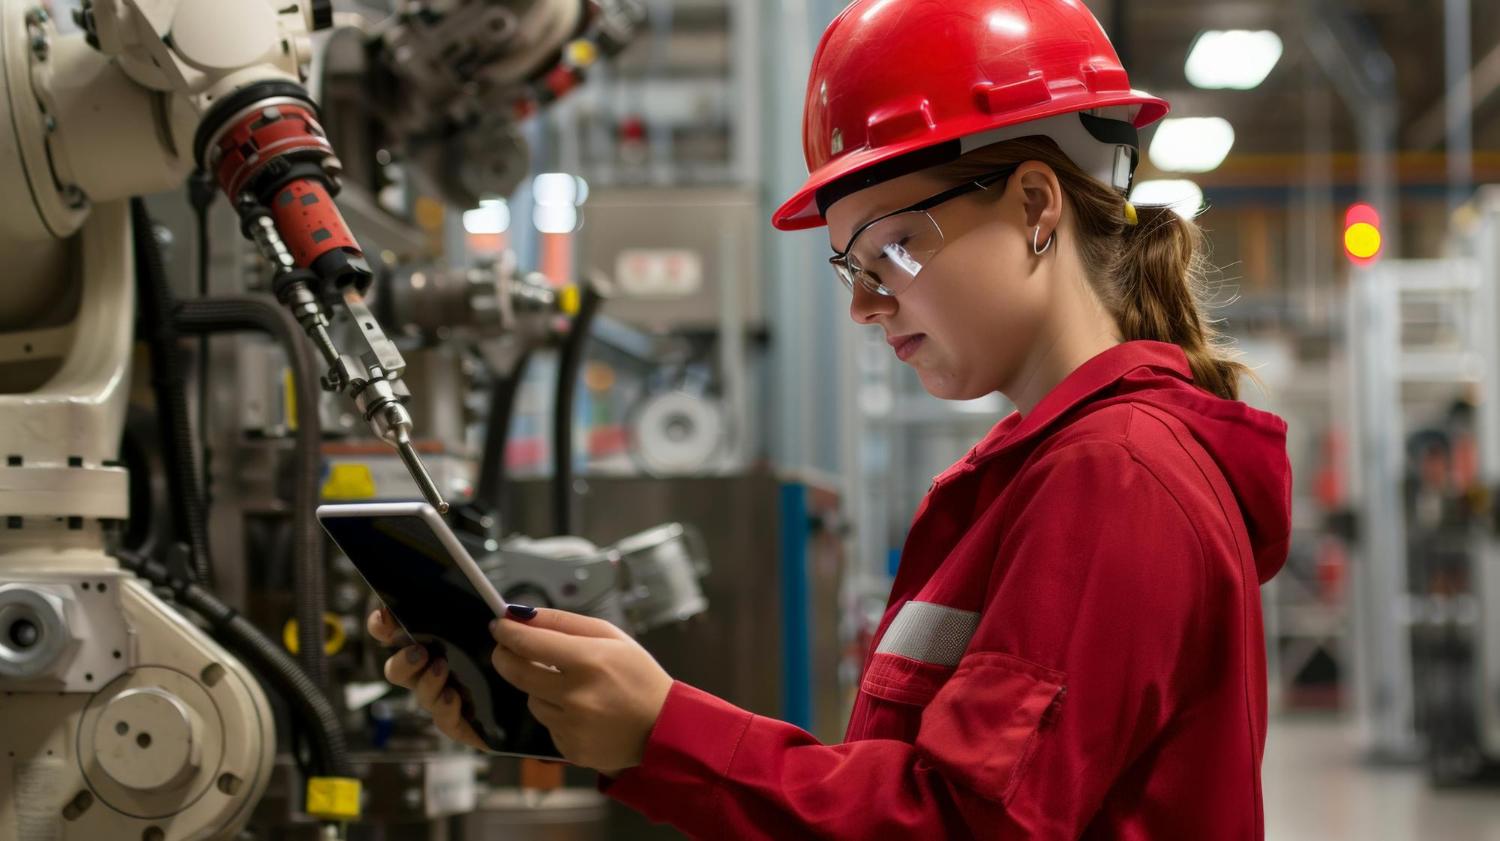
Inom tillverkningssektorn är inferensteknik en riktig pärla. Den gör det möjligt för maskiner att fatta intelligenta beslut direkt utan att vara beroende av en internetanslutning. Detta leder till kvalitetskontroll i realtid , där defekta delar upptäcks på monteringslinjen innan de blir en onödig kostnad.

Dessutom utgör det grunden för prediktivt underhåll . AI-modeller analyserar utrustningens tillstånd i realtid och ger tidiga varningar innan något går sönder, vilket förhindrar produktionsstopp som skulle kosta tusentals euro. Inom livsmedels- och elektronikindustrin säkerställer detta att slutprodukten alltid uppfyller de strängaste kvalitetsstandarderna.
Tekniska krav och modelloptimering
Om ett företag bestämmer sig för att köra inferens lokalt är hårdvaran avgörande. Grafikkort är viktiga på grund av sin parallella arkitektur. Den mest kritiska faktorn är inte bara rå kraft, utan även VRAM (videominne); om modellen helt och hållet passar i VRAM skjuter svarstiden i höjden. Annars förlitar sig systemet på konventionellt RAM-minne, vilket saktar ner allting avsevärt.
För att få dessa modeller att fungera på begränsade enheter används optimeringstekniker. Kvantisering minskar precisionen hos modellvikterna (till exempel från 32 till 4 bitar), vilket gör filen mycket mindre och snabbare utan att offra för mycket noggrannhet. Å andra sidan tillåter LoRA (Low-Rank Adaptation) att stora modeller anpassas till specifika uppgifter utan att hela modellen behöver tränas om, vilket är mycket billigare och snabbare.

Små språkmodeller (SLM) vinner också mark . Till skillnad från massiva LLM är SLM utformade för att vara effektiva och lätta, vilket gör dem till en perfekt matchning för hårdvara i edge-miljö. För att hantera hårdvarufragmentering används WebAssembly (Wasm) , vilket gör att AI kan köras med nästan native hastighet på vilken enhet som helst, oavsett processor.
Styrnings-, säkerhets- och operativa verktyg
Att flytta AI till produktion innebär att det inte längre bara är ett spel, utan en verksamhetskritisk arbetsbelastning. Många företag verkar redan i hybrid- eller multimolnmiljöer , vilket kräver implementering av strikta routing- och säkerhetskontroller. Styrning fokuserar nu på prompt-, token- och API-lagren, där hantering av säkerhet i AI-utvecklingsmiljöer är avgörande för att förhindra dataläckor.
För de som vill experimentera med lokal inferens finns det några mycket kraftfulla verktyg tillgängliga. LM Studio är ett utmärkt alternativ för användare som letar efter ett enkelt grafiskt gränssnitt och kompatibilitet med Hugging Face-modeller. För utvecklare är Ollama stjärnverktyget, eftersom det är öppen källkod och låter dig använda lokal AI på din dator mycket effektivt via Docker-containrar.

Det finns andra intressanta alternativ som Llama.cpp för brett hårdvarustöd, eller Jan för de som prioriterar en 100 % offline-miljö. Det finns till och med smartphone-appar som PocketPal som ger dig inferens direkt i fickan, vilket visar att artificiell intelligens inte längre nödvändigtvis behöver en superdator för att vara användbar.
Trenden är tydlig: artificiell intelligens rör sig mot en distribuerad modell. Framtiden ligger inte i en enda, centraliserad hjärna i molnet, utan i ett intelligent inferensnätverk spritt över datacenter och lokala enheter. Denna hybridarkitektur möjliggör en balans mellan datorkraft, behovet av omedelbara svar och skyddet av företagsdataintegritet.
