- Microsoft Fabric centraliserar data, styrning, AI och realtidsanalys på OneLake och enhetliga funktioner.
- Plattformen stärker styrning, säkerhet och kostnadseffektivitet genom Purview, OneLake-säkerhet, DLP, DSPM och integration med Azure Cost Management.
- Data Factory, Dataflow Gen2 och migreringsverktyg gör det enkelt att flytta befintliga arbetsbelastningar och orkestrera komplexa pipelines.
- Copilot, dataagenter, MCP och nya arbetsbelastningar som Fabric IQ och Real-Time Intelligence driver avancerade AI- och automatiseringsscenarier.
Om du har arbetat med data i Microsofts ekosystem ett tag har du säkert sett att Microsoft Fabric har blivit det centrala navet för modern analys och förenat allt som tidigare var utspritt över Power BI, Azure Synapse, Data Factory och andra tjänster till en enda plattform. I den här artikeln ska vi ta en grundlig och detaljerad titt på de senaste funktionerna, färdplanen och de praktiska konsekvenserna av Fabric för analys, styrning, AI och realtidsanalys.
Tanken är att du, när du har läst klart, har en tydlig bild av vad Microsoft Fabric erbjuder idag, vart det är på väg och hur det påverkar din organisations dataarkitektur: styrningsfunktioner med Purview, automatisering med API:er och Git, nya AI-funktioner, realtidsinformation, säkerhet i OneLake, migreringar, prestanda och mycket mer.
Microsoft Fabric och molnimplementeringsramverket: styrning, kostnader och automatisering
Inom Cloud Adoption Framework (CAF) har Microsoft publicerat en serie guider för att anpassa designen av Microsoft Fabric till designpelarna för landningszoner . Den senaste delen i serien behandlar tre nyckelområden: styrning, kapacitetsoptimering och automatisering/DevOps.
På styrningssidan exponeras kapacitetskostnader för Fabric via Azure Cost Management . Detta möjliggör inbyggd integration av F-kapacitetsförbrukning (och andra SKU:er) i Azures kostnadsinstrumentpaneler, aviseringar och utgiftsanalyser. Det handlar inte bara om att se fakturan: du kan korsreferera denna information med taggar, prenumerationer eller resursgrupper för att förstå vem som spenderar vad och varför.
Fabrics tekniska arkitektur och affärsmodell gör det möjligt för kunder att noggrant kontrollera kapacitetsförbrukningen för att optimera driftskostnaderna . I praktiken innebär detta flera olika mekanismer:
- Skalning av kapacitet Föka eller minska kapaciteten baserat på förutsägbara toppar, såsom försäljningskampanjer, bokföringsdeadlines eller stora databelastningar.
- Pausa och återuppta funktionerFabric-administratörer kan pausa en F-kapacitet när den inte behövs (till exempel över natten eller på helger i icke-kritiska miljöer) för att minska beräkningskostnaderna.
- ÖverspänningsskyddTvå parametrar på kapacitetsnivå styr hur bakgrundsjobb hanteras för att förhindra att de överbelastar miljön: Tröskelvärde för bakgrundsavvisning och Tröskelvärde för bakgrundsåterställning.
- KapacitetsreservationerDet är möjligt att reservera kapacitet under definierade perioder för att få rabatter, förutsatt att den förväntade förbrukningen planeras noggrant.
Inom området datastyrning förlitar sig Fabric på Microsoft Purview som sin centrala komponent för katalogisering, härkomst och klassificering . Purview låter användare tillämpa känslighetsetiketter, visa härkomst över källor, transformationer och konsumtion, certifiera datatillgångar och driva datakvalitetskampanjer, allt samtidigt som Fabric-element (Lakehouse, Warehouse, KQL, Power BI, etc.) integreras.
Komponenten "Plattformautomation och DevOps" fokuserar främst på Git-integration, distributionspipelines och REST API:er . Fabric-arbetsytor kan länkas till Git-repositories, vilket gör det möjligt för flera utvecklare att samarbeta i samma data engineering-, data science- eller realtidsanalysprojekt utan överlappande arbete.
Git- och Deployment Pipelines möjliggör orkestrering av utvecklings-, test- och produktionslivscykler på ett kontrollerat sätt : innehållsmarknadsföring, ändringsspårning, artefaktsynkronisering och versionshantering. Sedan mars 2025 har dessa pipelines stödt (i generellt eller förhandsgranskningstillstånd) ett brett utbud av elementtyper, inklusive triggers, dashboards, dataflöden, datapipelines, datamarts, lakehouses, datalager, KQL, anteckningsböcker, paginerade rapporter, organisationsapplikationer med mera.
Parallellt exponerar Fabric en mycket bred uppsättning REST API: er för att automatisera nästan alla administrativa eller distributionsuppgifter: skapande av arbetsytor och mappar, massmigrering av objekt, hantering av anslutningar och gateways, extrahering av definitioner, aktivering av pipelines eller anteckningsböcker, bland annat.
Viktiga uppdateringar inom analys, AI och styrning för Microsoft Fabric
Utvecklingen av Fabric präglas av ett stort antal förhandsvisningsfunktioner och nya möjligheter som berör praktiskt taget alla delar av plattformen . Dessa grupperas och diskuteras nedan på ett strukturerat sätt för att visa deras fulla omfattning.
AI-funktioner i datalager och multimodala funktioner
Inom relationsdata integrerar Fabric Data Warehouse AI-funktioner direkt i T-SQL (förhandsvisning). Detta möjliggör:
- Klassificera eller kategorisera text.
- Analysera känslor.
- Extrahera strukturerad information från fritext.
- Översätt text mellan språk.
- Korrekt grammatik.
Målet är att eliminera behovet av att lämna SQL-kontexten för att berika data med AI . Dessa funktioner kombineras med bredare multimodalt stöd i Fabrics AI-funktioner, som nu kan bearbeta bilder (JPG/JPEG, PNG, GIF, WebP), PDF-filer och vanliga textformat, samt inmatning av filsökvägar.
Verktyg som aifunc.load för att mata in mappar i tabeller med prompt- och schemaalternativ, aifunc.list_file_paths för att gå igenom filsökvägar och ai.infer_schema för att härleda scheman kompatibla med ai.extract ingår . Allt detta gör att du kan transformera och berika data utan att bygga komplexa pipelines från grunden.
OneLake, Delta, Apache Iceberg och multiplattformsåtkomst
På lagringslagret förblir OneLake den enhetliga sjön där hela Fabric finns. En av de största förbättringarna är möjligheten att exponera Delta Lake-tabeller som Apache Iceberg-tabeller utan att flytta eller duplicera data, så att Iceberg-kompatibla motorer direkt kan läsa vad som finns i OneLake.
Dessutom stöder OneLake nu Apache Iceberg-data som skrivs direkt av Snowflake och konsumeras i Fabric via kopieringsfri åtkomst . Denna strategi stärker interoperabiliteten: Fabric är inte avsett att vara en silo, utan snarare en datahubb som andra motorer kan utnyttja utan att duplicera lagring.
I samma anda stöder OneLake genvägar till Azure Blob Storage , OneDrive och SharePoint, och utökar säkerheten med åtkomstroller, säkerhet på mapp-, rad- och kolumnnivå, samt en säkerhetsmodell som tredje part kan respektera tack vare utökningen av den auktoriserade motormodellen.
En särskilt relevant funktion är federeringen av OneLake-katalogen med Azure Databricks, vilket möjliggör åtkomst utan kopiering från Unity Catalog till OneLake-tabeller . På så sätt förblir OneLake källan till sanningen, men Databricks kan fråga data direkt och synkronisera endast metadata.
SQL Database on Fabric: prestanda, säkerhet och virtualisering
Fabrics SQL-databas får sina egna funktioner: ALTER DATABASE SET-alternativ , stöd för sortering och fulltextindexering i förhandsgranskning. När det gäller databasens prestanda och kostnad finns det flera förbättringar:
- Automatisk indexkomprimering för att minska lagring, I/O och förbättra frågetider utan att behöva schemalägga underhållsjobb.
- Maximal gräns för virtuella kärnor för att kontrollera användningen av datorresurser (4 eller 32 virtuella kärnor), utformade för att förhindra att en arbetsbelastning förbrukar för mycket i delad kapacitet.
- Anpassade SQL-pooler som ger arbetsyteadministratörer detaljerad kontroll över resursallokering och frågeroutning efter applikationsnamn.
Datavirtualisering är också aktiverat i SQL-databasen , vilket möjliggör frågor om extern data som lagras i OneLake med T-SQL, och sammankoppling av filer i vanliga format med lokala relationstabeller med hjälp av kopplingar, utan att behöva importera data fysiskt.
När det gäller säkerhet stöder SQL-databasen Private Link på klientnivå (förhandsversion) , vilket gör det enklare att kanalisera datatrafik privat och på ett kontrollerat sätt, och integrera med Fabrics övergripande säkra nätverkskonfiguration.
Realtidsinformation, Eventhouse, Eventstream och Activator
Modulen Realtidsintelligens (RTI) har blivit en av Fabrics viktigaste differentieringsfaktorer. Eventhouse och Eventstream arbetar tillsammans för att inhämta, bearbeta och utlösa händelser i realtid från alla typer av källor, och Activator orkestrerar de åtgärder som utlöses under vissa förhållanden.
Bland de kraftfullaste nya funktionerna är:
- Avvikelsedetektering utan kod med automatiskt modellval, enkelt gränssnitt och flexibla aviseringar.
- Affärshändelser, som fångar viktiga affärsmoment som genereras från användardatafunktioner och anteckningsböcker, och låter dig aktivera aviseringar, anpassad logik, flöden, AI-modeller eller Spark-jobb.
- Integrering av aktivator-användardatafunktionerså att funktioner som skapats i Fabric kan bearbeta händelser från vilken källa som helst, inklusive interna händelser från själva plattformen och från OneLake.
- Möjlighet att bearbeta händelser med SQL (SQL-operator i Eventstream), vilket möjliggör transformation av realtidsflöden med känd SQL-syntax.
Relevanta kopplingar läggs till, till exempel Cribl (för logg- och telemetriinmatning från flera källor), en koppling med Solace PubSub+ och stöd för strömning över privata nätverk via Azure Virtual Network, VPN, ExpressRoute eller privata slutpunkter.
För datascheman och kontrakt introducerar Eventstream ett schemaregister som definierar och validerar händelsescheman för mer robusta pipelines, och stöd för Confluent Schema Registry för att ansluta till Kafka i Confluent Cloud samtidigt som befintliga kontrakt respekteras.
Copilot- och AI-funktioner över hela plattformen
Copilot i Fabric är nu tillgängligt globalt, med stöd för Power BI, Data Factory, Data Science & Data Engineering och KQL-frågeskrivning . Dessutom har specifika funktioner lagts till:
- Copilot för Dataflow Gen2 (Modern Get Data), vilket hjälper till att ta in och omvandla data med instruktioner på naturligt språk.
- Copilot för datalager (chatt), tillgänglig från en knapp i menyfliksområdet för att påskynda lagerhanteringsuppgifter via dialogruta.
- Copilot för SQL-analysslutpunkt, som genererar och optimerar SQL-frågor från affärsbeskrivningar.
- Copilot på bärbara datorer med kunskap om arbetsytans kontext, Lakehouse, anteckningsbokens struktur och exekveringsmiljö, kunna generera flerstegskod, refaktorera, sammanfatta komplexa anteckningsböcker och diagnostisera fel med alternativet "Fix with Copilot".
- Inline-autokomplettering (inline-kodkomplettering) och Notebook Copilot inline-kodkomplettering (förhandsvisning), för att skriva Python snabbare och med färre fel.
Dessutom utökas AI-teknikbasen med integrerade förbyggda Foundry Tools (Azure OpenAI, Azure Language, Azure Translator), OpenAI-plugins för Eventhouse (ai_embed_text och ai_chat_completion), och en serie agenter och dataagenter som gör det möjligt för andra applikationer, inklusive Copilot Studio, att arbeta med Fabric-data på ett orkestrerat sätt.
Fabric Data Agents, MCP och utvecklarverktyg
Fabric introducerar dataagenter som kan orkestrera dataåtkomst och verktyg för AI-agenter, med ett Python SDK och direkt integration med Microsoft Copilot Studio. Detta gör det enkelt att bygga konversationsassistenter som arbetar med företagsdata som styrs i Fabric.
Parallellt blir Model Context Protocol (MCP) en nyckelkomponent i integrationen mellan AI-agenter och Fabric-tjänster. Det finns dedikerade MCP-servrar för Activator och Eventhouse, och en utvecklingsorienterad Fabric MCP som:
- Det låter AI-assistenter generera kod och innehåll för Fabric-artiklar.
- Den integreras med utvecklingsverktyg som VS Code och GitHub Codespaces.
- Den presenterar verktyg för konsultation och agerande utifrån realtidsdata i Eventhouse.
För utvecklarens dagliga arbete finns det flera delar att lyfta fram, inklusive utvecklingsmiljön : MSSQL -tillägget för VS Code med stöd för Fabrics SQL-databas , Microsoft ADO.NET-drivrutinen och ODBC-drivrutinen för Fabric Data Engineering (anslutning till Spark SQL via Livy), och en Spark-anslutning för SQL-databaser som förenklar autentiserad åtkomst från Spark till SQL-databaser i Azure och Fabric.
Fabric CLI ingår också , tillgänglig som en integrerad uppgift i Azure DevOps, vilket gör att du kan automatisera hanteringen av arbetsytor, objekt och distributioner utan att manuellt installera externa verktyg.
Data Factory, datamigreringar och orkestrering i Fabric
Fabrics dataintegrationslager bygger på Data Factory och Dataflow Gen2, som får funktioner för att göra orkestrering smartare, mer automatiserbar och med enklare migreringar från befintliga plattformar.
Dataflow Gen2: prestanda, offentliga API:er och diagnostik
I Dataflow Gen2 hittar vi flera funktioner i förhandsvisningen:
- Avancerad redigering av målfrågor för att justera logiken vid destinationen direkt från själva redigeringsmiljön.
- Partitionerad beräkningvilket gör att delar av dataflödet kan köras parallellt, vilket minskar den totala utvärderingstiden.
- Ladda ner diagnostik på exekveringsnivå, med strukturerade loggpaket för prestandaanalys och incidentlösning.
- Offentliga API:er för att programmatiskt skapa, uppdatera, ta bort, schemalägga och övervaka dataflöden.
- Offentliga parametrar med CI/CD-stödvilket möjliggör uppdatering av dataflöden genom att skicka värden från pipelines eller andra källor.
- Nyligen publicerade uppgifter för snabb åtkomst till senast använda objekt i Power Query-menyfliksområdet och i Modern Hämta data.
Allt detta kompletteras av möjligheten att programmatiskt utvärdera Power Query via REST , vilket öppnar dörren för att köra M-skript som en del av automatiserade processer, integrera dem med Spark, pipelines eller externa verktyg, och dra nytta av Power Query-kopplingar.
Data Factory: adaptiv prestanda, anslutning och dbt
I den mer "klassiska" delen av integrationen introducerar Data Factory inom Fabric:
- Adaptiv prestandajustering för kopieringsaktivitet, som intelligent justerar prestandaparametrar enligt konfiguration och körningskontext.
- Ändra stöd för datainsamling (CDC) i kopieringsjobb, för att endast replikera ändringar (infogningar, uppdateringar, borttagningar) kontinuerligt.
- Lokala gateways med manuell uppgraderingsmöjlighet hanteras från Fabric-portalen, API:et eller skript.
- senaste anslutningen, vilket lägger till egenskaper för senaste användning till anslutningar för att underlätta granskning och livscykelhantering.
- infödd dbt-jobb, vilket möjliggör körning av dbt-projekt inom Fabric med integrerad orkestrering, testning, dokumentation och styrning.
- Anropa SSIS-paketaktivitet i pipelines, för att köra SSIS-paket från själva orkestreringen i Fabric.
Användarupplevelsen förbättras också med en SharePoint Site Picker som eliminerar behovet av att skriva in URL:er manuellt, och med MCP-stöd för Data Factory, vilket gör det möjligt för AI-assistenter att skapa och distribuera Dataflow Gen2 helt enkelt från instruktioner i naturligt språk.
Verktyg för datamigrering och replikering
Microsoft marknadsför starkt migreringen till Fabric genom flera specifika verktyg:
- Utvärdering av tygmigrering för Data Factory, som analyserar förberedelsen av ADF-pipelines och migrerar de som stöds till en Fabric-arbetsyta med anslutningsmappning.
- Migreringsassistent för datalagersom nu kan ansluta direkt till källlagret för att flytta det till Fabric Data Warehouse.
- Migreringsassistent för SQL-databas, som syftar till att migrera lokala SQL Server-arbetsbelastningar, med schemaimport via DACPAC, inkompatibilitetsdetektering och rekommendationer.
När det gäller replikering ges stöd för spegling från olika operativa källor (Azure Database for MySQL, Google BigQuery, SQL Server, etc.) till Fabric, med möjlighet att kontrollera vilka tabeller som replikeras, starta om speglingsprocesser via REST och, när det gäller Databricks, mappa Unity Catalog-policyer till OneLake-säkerhet.
Dessutom ingår en replikeringskoppling från Lakehouse som använder Delta Change Data Feed , vilket exponerar ändringar från Lakehouse Delta-tabeller till kompatibla destinationer utan att behöva uppfinna hjulet på nytt med hembryggda CDC-lösningar.
Säkerhet, avancerad styrning och övervakning i Fabric
En av de största problemen för alla analysplattformar är hur man säkrar data, styr användningen och övervakar resursförbrukningen . Fabric mognar snabbt inom dessa områden.
Säkerhet och dataskydd på OneLake
OneLake lägger till en komplett säkerhetsmodell för dataåtkomst med:
- Dataåtkomstroller för Lakehouse med konfigurerbara behörigheter från ett mappbaserat säkerhetsgränssnitt.
- Säkerhetsstöd för genvägar så att tredje part kan respektera de definierade policyerna.
- OneLake API för dataåtkomstsäkerhet, vilket möjliggör automatiserad behörighetshantering.
- Utökning av modellen till externa motorer (OneLake-säkerhetsauktorisering för tredje part).
Parallellt utökas skyddet med DLP som begränsar åtkomst till all strukturerad data i OneLake (SQL, KQL, lager) och DSPM för AI introduceras för Fabric Copilots och dataagenter , vilket övervakar AI-interaktioner för känslig information och riskabla beteenden, med integration med Purview Audit och eDiscovery.
I identitetsplanet visas funktioner som objektassocierade identiteter (t.ex. Lakehouse och Eventstream) via REST API:er, vilket eliminerar ägarberoendet för vissa operationer och autentiseringen av OneDrive- och SharePoint-genvägar via arbetsyta eller tjänstens huvudpersonidentiteter.
Centraliserad styrning och OneLake-katalog
Datastyrningsupplevelsen förbättras med en ny centraliserad instrumentpanel i OneLake-katalogen , där dataägare kan se en aggregerad vy över de objekt de har skapat, få rekommendationer för styrningsåtgärder och få tillgång till alla tillgängliga verktyg för att förbättra säkerhet och efterlevnad.
Dessutom aktiveras ett OneLake-katalogsöknings-API tillsammans med ett MCP-verktyg, vilket gör det möjligt att upptäcka objekt i hela Fabric-miljön från kod eller AI-agenter, i ett enda anrop, med respekt för katalogbehörigheter och metadata.
Övervakning av kapacitet, förbrukning och arbete
Tyg ger flera lager av observerbarhet:
- Övervakning av arbetsyta, vilket skapar en databas i Fabric där loggar och mätvärden från flera objekt konsolideras (inklusive kopieringsjobb med detaljerad övervakning).
- Arbetsyteövervakning för kopieringsjobbmed mätvärden som genomströmning, datavolym, felkoder och tider, allt inriktat på centraliserad analys.
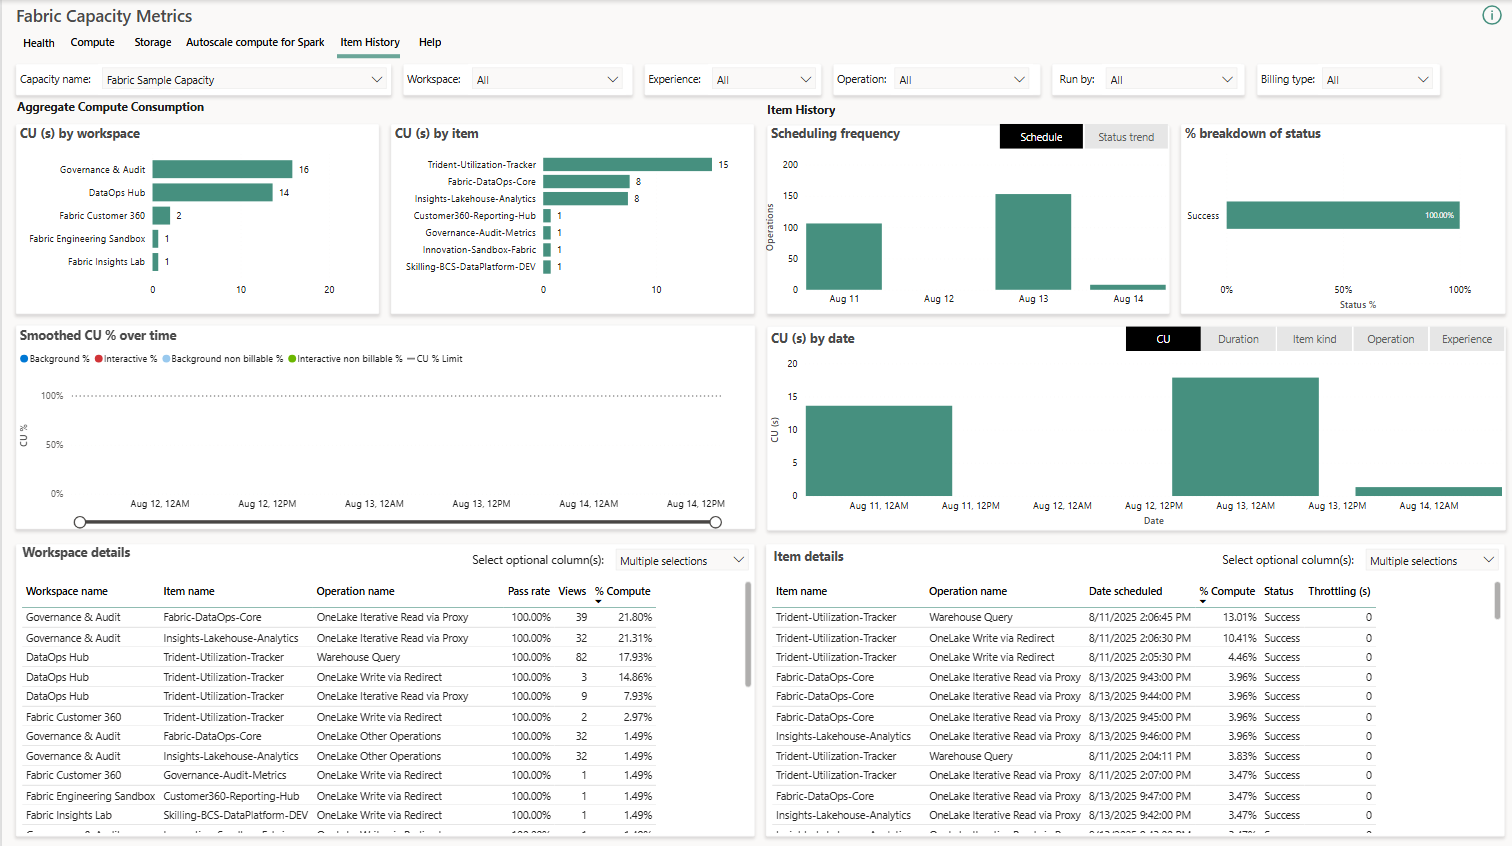
- Artikelhistorik vid tillämpning av kapacitetsmått, med 30-dagarsvyer av CU-förbrukning för varje objekt, filtrerbar efter arbetsyta och typ.
- Överspänningsskydd på arbetsplatsnivåvilket gör det möjligt att ställa in förbrukningsgränser per arbetsyta i ett rullande 24-timmarsfönster, automatiskt blockera de som överskrider dem och markera arbetsytor som "verksamhetskritiska" för att undanta dem från begränsningar.
Som komplement till detta släpps en första uppsättning Fabric Admin API:er , fokuserade på att upptäcka arbetsytor, objekt och användaråtkomstdetaljer, underlätta dynamiska inventeringar och regelbundna åtkomstkontroller.
Affärsmodellering, planering och nya arbetsbelastningar
Utöver det tekniska lagret introducerar Microsoft nya affärsinriktade arbetsbelastningar utöver Fabric. En av de mest anmärkningsvärda är Fabric IQ, som syftar till att förena affärssemantik, data och modeller för intelligenta agenter som fattar beslut baserat på en helhetssyn på organisationen.
Inom Fabric IQ visas följande:
- Ontologi (förhandsvisning), en typ av objekt där entiteter, relationer, egenskaper och begränsningar definieras enligt företagets affärsspråk.
- Plan (förhandsvisning), en kodfri plattform för planering, rapportering, analys, integration och samarbetsbaserad hantering.
Inom realtidsintelligens framträder även den digitala tvillingbyggaren , en produkt specialiserad på att modellera digitala tvillingar baserat på realtidsdata, med syftet att optimera fysiska operationer, övervaka tillstånd och simulera scenarier.
Å andra sidan introduceras Fabric IQ-arbetsbelastningen som en separat arbetsbelastning, och supportverktyg för styrning och semantisk anpassning fortsätter att expandera, vilket sluter cirkeln mellan datamodeller, affärslogik och AI/analysapplikationer.
Förbättringar av prestanda, användarupplevelse och produktivitet
För att avsluta granskningen är det värt att lyfta fram en rad övergripande förbättringar som inte alltid hamnar i rubrikerna, men som i hög grad påverkar teamens dagliga verksamhet .
I avsnittet om Spark och distribuerad databehandling introducerar Fabric:
- Fabric Runtime 2.0 (förhandsvisning) med Apache Spark 4.0, Delta Lake 4.0, Java 21, Scala 2.13 och Python 3.12 på Azure Linux 3.0.
- Jämförelseverktyg för Spark-apparvilket låter dig välja och jämföra upp till fyra Spark-körningar parallellt.
- Gnistdiagnostisk emitter, som samlar in loggar, mätvärden och händelser från Spark-program och skickar dem till destinationer som Event Hubs, lagring eller Log Analytics.
- JobInsight-diagnostikbibliotek, ett bibliotek för att analysera slutförda Spark-körningar via API:er (frågor, jobb, steg, uppgifter, körningar, händelseloggar).
I lagerlagret läggs dataklustring till för att förbättra prestanda och minska åtkomstkostnader, IDENTITY-kolumner för surrogatnycklar samt versionskontroll och CI/CD-stöd genom SQL Database-projekt i VS Code (lagerkällkodskontroll).
Användarupplevelsen på Fabric-portalen utvecklas också med flikar och en objektutforskare , vilket gör det möjligt för användare att öppna flera objekt samtidigt och snabbt växla mellan dem. Detta, tillsammans med förbättringar som Lakehouses automatiska bindning i Git och verktygssviten för Lakehouse-underhåll (underhållsaktiviteter och uppdatering av SQL-slutpunkten), bidrar till en mer användarvänlig och smidig plattform.
Slutligen kompletterar funktioner som massimport/export av objektdefinitioner (för migreringar, mallar och säkerhetskopior av metadata), REST för mappar, parameterstöd i objektaktiveringar från Activator och laddning av OneLake-data till Excel med en integrerad katalog, ett ekosystem som börjar täcka praktiskt taget alla vanliga behov hos ett modernt datateam.
Med hela denna uppsättning funktioner – från centraliserad styrning, detaljerad säkerhet och intelligent orkestrering, till AI inbäddad i SQL, realtidsanalys, digitala tvillingar och MCP-agenter – etablerar sig Microsoft Fabric som en komplett dataplattform där nyckeln inte längre bara är att lagra och visualisera data, utan att styra, automatisera och utnyttja AI för att driva varje del av datalivscykeln . Detta gör det möjligt för organisationer att utveckla sina arkitekturer gradvis, migrera befintliga system och möjliggöra nya lösningar mycket snabbare än med traditionella metoder.