- Pipes i Linux låter dig kedja samman processer genom att koppla ihop stdout och stdin, med kärnstöd och verktyg som tee, xargs och cpio för komplexa flöden.
- En effektiv CI/CD-pipeline i Linux är beroende av god scendesign, intensiv användning av cacher, oföränderliga artefakter och parallell testning.
- Att optimera Linux-servern (CPU, RAM, I/O, Docker) och Jenkins, GitHub Actions eller GitLab Runner-exekutorerna är nyckeln till att minska tiderna.
- Att integrera säkerhet, observerbarhet och kostnadskontroll i pipelinen säkerställer tillförlitliga, spårbara och hållbara implementeringar i produktionsmiljöer.
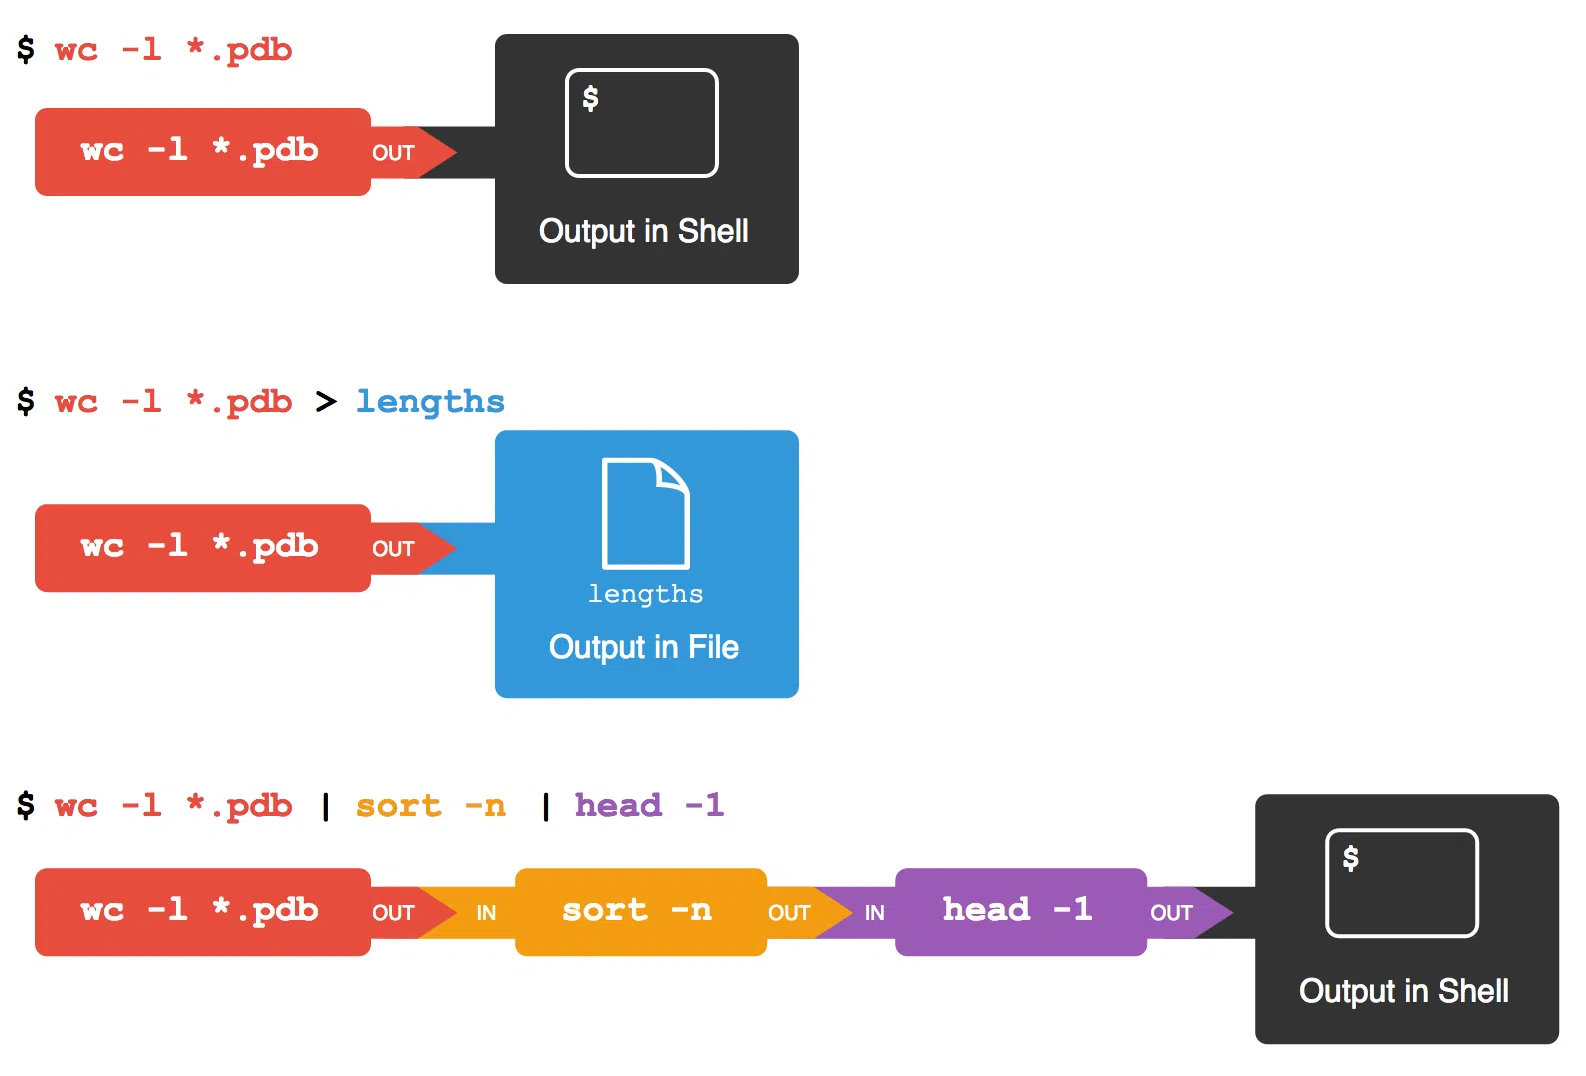
Optimera pipelines i Linux Det handlar inte bara om att kedja ihop kommandon med symbolen |Bakom allt detta finns en hel värld av prestandaoptimeringArbetsflödesdesign, CI/CD, säkerhet och justering av operativsystem gör hela skillnaden mellan en långsam, instabil pipeline och en som fungerar, är tillförlitlig och billig att underhålla. Om du arbetar med Linux-servrar, oavsett om du automatiserar uppgifter i terminalen eller kör pipelines för kontinuerlig integration, sparar du mycket tid och huvudvärk genom att förstå dessa detaljer.
I den här artikeln kommer vi att kombinera två kompletterande perspektiv: å ena sidan, Klassisk användning av pipes i Linux-kommandoraden (pipes, omdirigeringar, kommandon som tee, xargs o cpio); å andra sidan CI/CD-pipelineoptimering på Linux-servrarDetta inkluderar cachning, testparallellisering, Docker-justering, leveranskedjesäkerhet och avancerade arbetsflödesmätvärden. Allt förklaras på spanska (från Spanien), med tydliga exempel och en mycket praktisk metod.
Vad är en pipeline och hur passar pipes in i Linux?
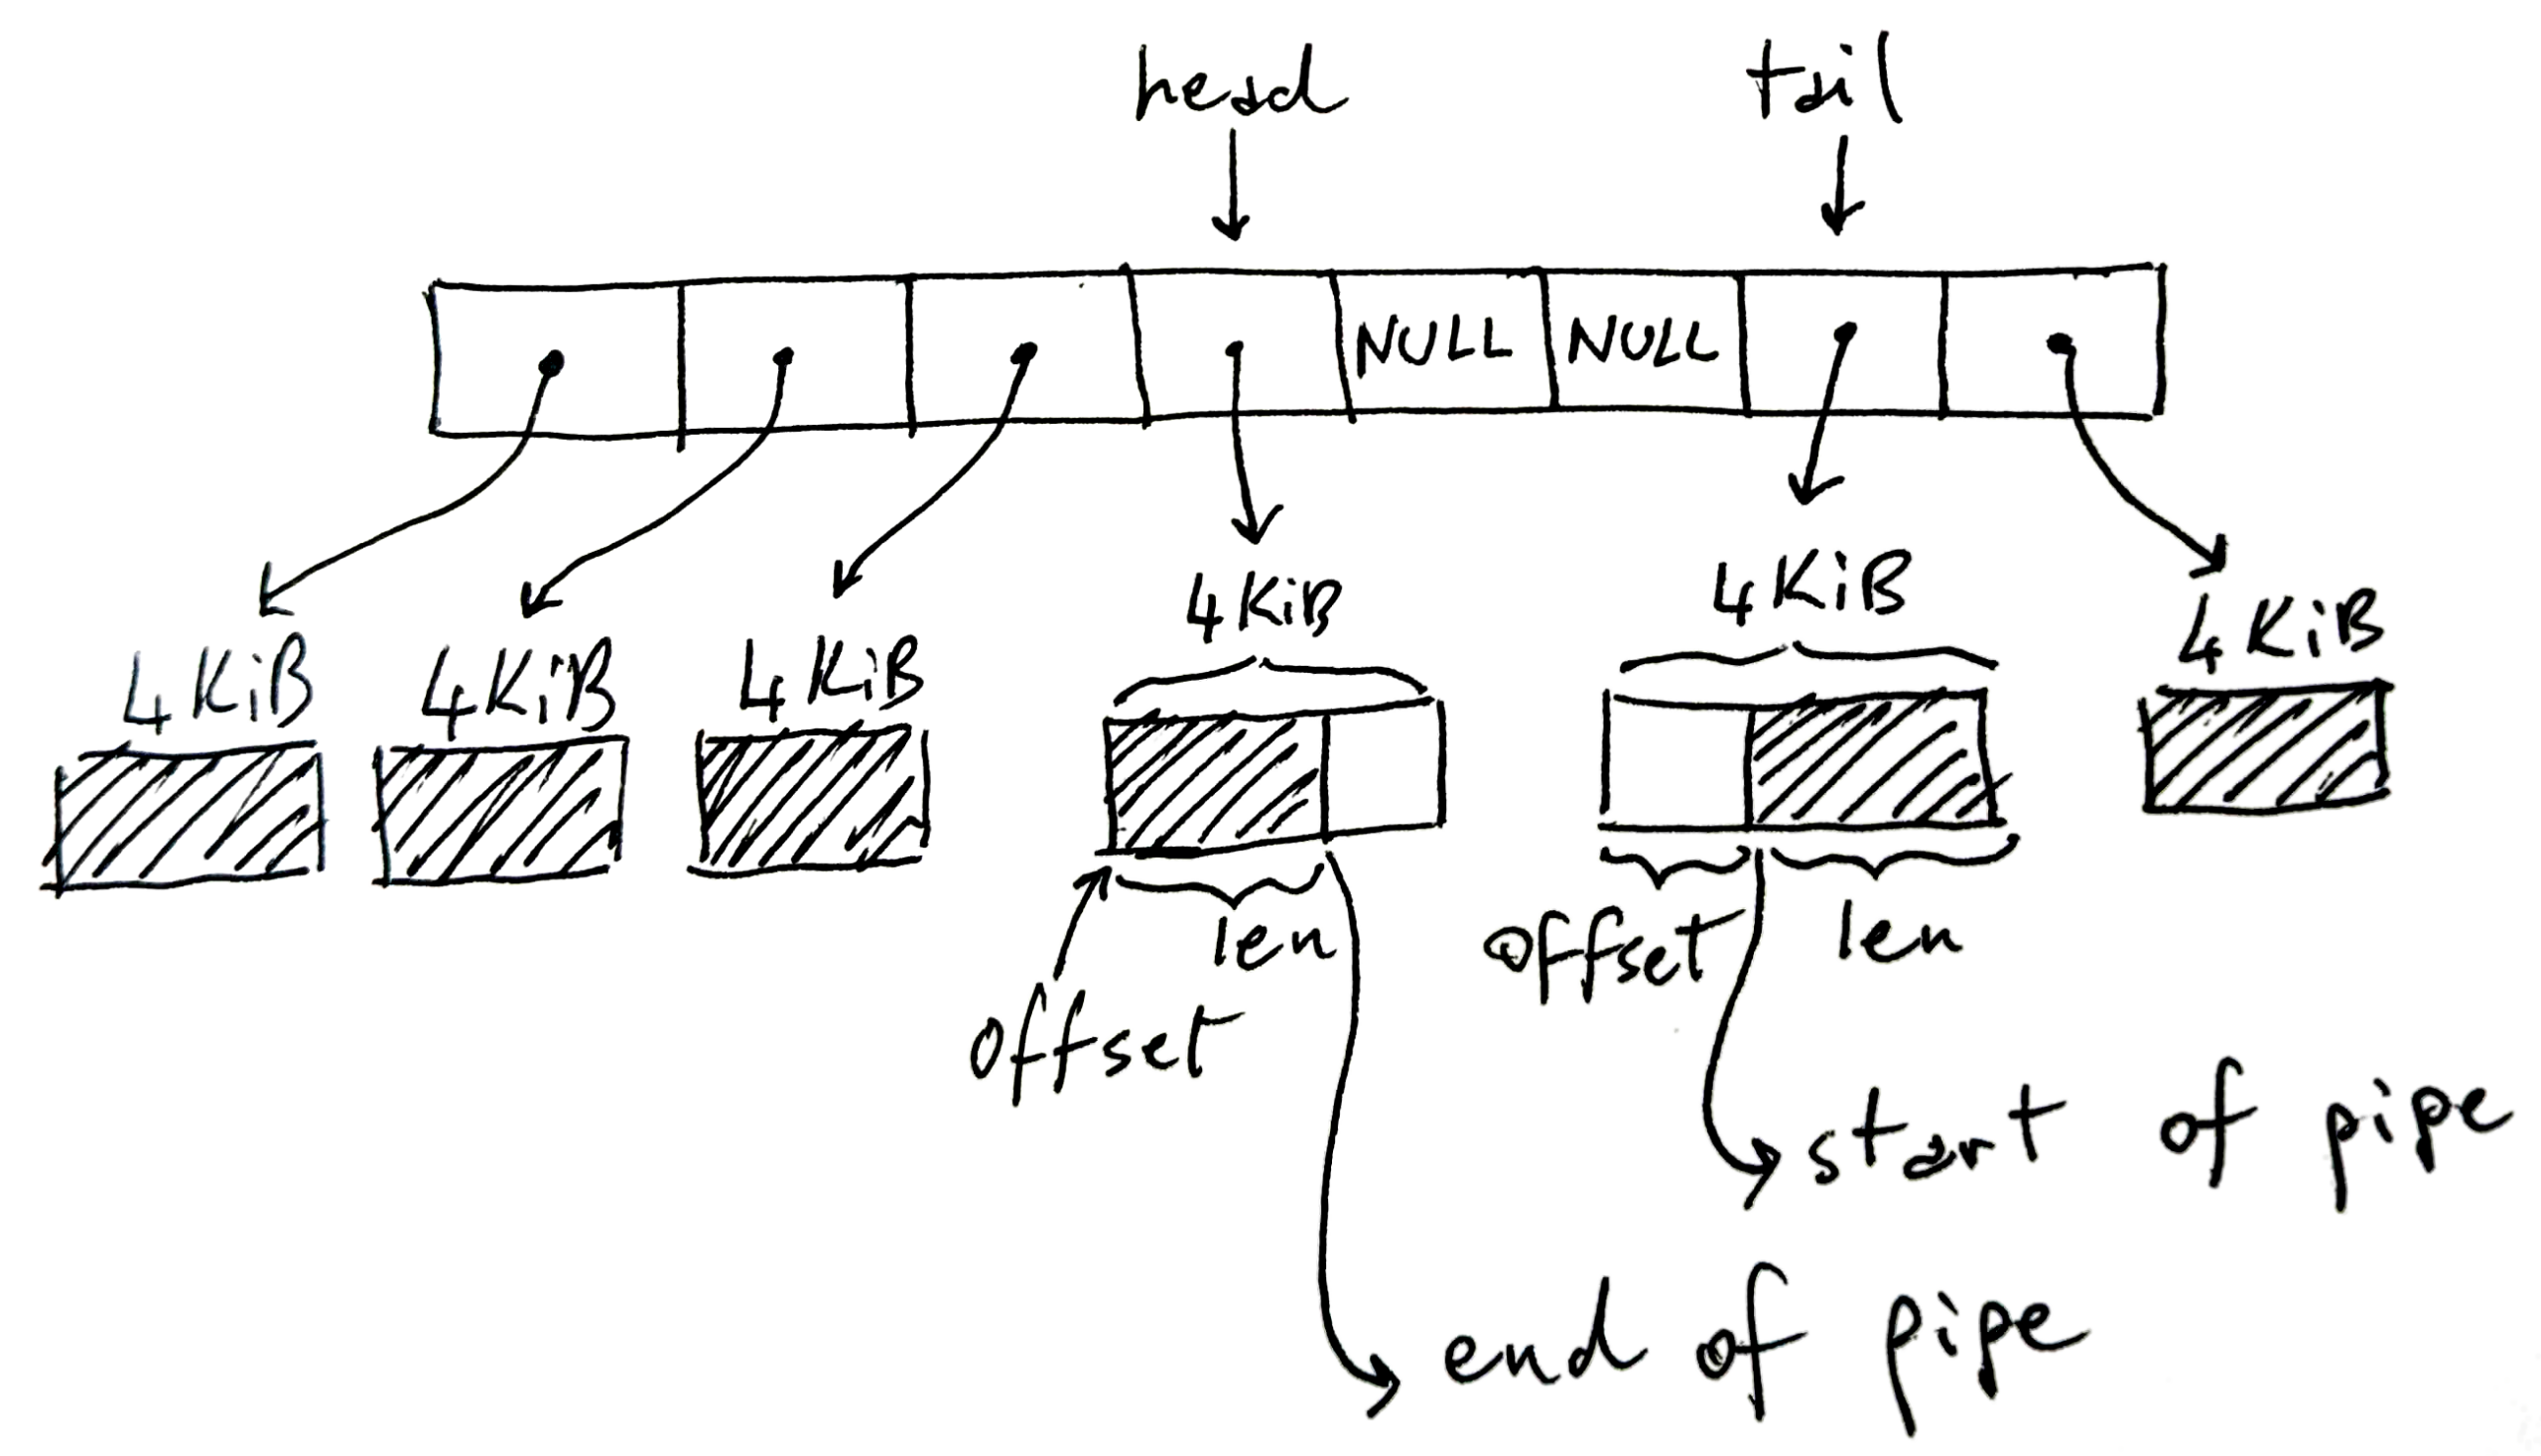
Termen pipeline kommer från idén om en pipe : ett dataflöde som färdas från en punkt till en annan. Inom databehandling, och specifikt i Linux, är en pipe en mekanism som gör att standardutgången från en process kan bli standardingången för en annan. Med andra ord matas utdata från ett kommando automatiskt in i nästa utan att passera genom mellanliggande filer.
I Unix-liknande system finns det två huvudtyper av pipes ( eller "pipes "). Å ena sidan finns det anonyma eller namnlösa pipes , som bara kan användas mellan närbesläktade processer (till exempel förälder och barn). Å andra sidan finns det namngivna pipes , även kända som FIFO (First In – First Out), som möjliggör kommunikation mellan processer som inte är direkt relaterade och till och med kan finnas på olika maskiner anslutna till ett nätverk.
Anonyma pipes erbjuder vanligtvis enkelriktad kommunikation : en process skriver och den andra läser. Däremot möjliggör namngivna pipes dubbelriktad kommunikation om de är utformade på det sättet, till exempel genom att öppna FIFO i läs-/skrivläge från båda ändar. De används ofta för att koordinera daemonprocesser, skript eller tjänster som behöver skicka data till varandra utan att blockera.
På implementeringsnivån finns stöd för pipelines i Linux-kärnainte i skalet. Kommandotolken (bash, zsh, etc.) skapar helt enkelt pipelinen genom systemanrop som pipe() y fork()omdirigera filbeskrivningarna och starta sedan varje program. Den verkliga magin i hur processer blockeras, hur bufferten hanteras och hur data sprids mellan producent och konsument hanteras av systemkärnan.
Förstå stdin, stdout och dataflöde
För att arbeta effektivt med pipelines är det avgörande att förstå vad stdin, stdout och stderr är . Dessa är inte abstrakta begrepp: varje process i Linux börjar med tre öppna filbeskrivningar, vilka pekar på specifika resurser som hanteras av kärnan.
stdin (deskriptor 0) och stdout (deskriptor 1) kan ses som byteströmmar kopplade till något: det kan vara en terminal, en fil, en nätverkssocket eller en pipe. De är inte bara buffertar; de är referenser till kärnobjekt ( filtypstrukturer ) som i sin tur är associerade med inoder, sockets eller interna pipestrukturer.
Varje process har sina egna deskriptorer, så att varje kommando i en pipeline Den visar sin stdin och stdout oberoende av varandra. På en rad som ls | grep txt | wc -l, The ls skriva i ett rör, grep Den läser från en pipe och skriver till en annan, och wc Läs från den sista. För användaren visas det som en enda sträng, men internt är de flera sammanfogade kärnbuffertardär varje process blockeras och återupptas beroende på tillgängligt utrymme eller data.
När den första processen producerar data snabbare än den andra förbrukar den, fylls pipe-bufferten. Vid den tidpunkten återgår efterföljande skrivningar, vilket blockerar sändningsprocessen tills den förbrukande processen... läs tillräckligt med information och frigör utrymme. Detta förhindrar att minnet spårar ur; data ackumuleras inte i all oändlighet om du inte använder icke-blockerande I/O eller speciella signaler. Till exempel, i ett fall som dd if=/dev/sda | gzip -9och gzip komprimeras långsammare, dd han är tvungen att vänta.
Denna mottrycksmekanism gör pipelines ganska stabila även när det finns prestandaobalanser mellan stegen, något som sedan också återspeglas i designen av CI/CD-pipelines , där de långsamma stegen blir flaskhalsen som behöver mätas och optimeras.
Praktisk användning av pipes i Linux-terminalen
I vardagsbruk används pipes för att kedja kommandon på en enda rad och omvandla data steg för steg. Istället för att köra ett kommando, titta på utdata, kopiera det och klistra in det i ett annat kommando, kan man bygga små, mycket flexibla "datafabriker" i klartext.
Ett typiskt exempel i Unix-miljöer är att kombinera kommandot fortune, som visar slumpmässiga citat, med cowsaysom skriver ut en "pratande" ko. När man använder ett rör, Fortunes avfärd blir Cowsays budskapallt i ett enda kommando. Det är ett lekfullt exempel, men det illustrerar perfekt idén att koppla samman enkla verktyg för mer komplexa uppgifter.
En annan klassiker är att skicka resultatet av ls a wc att räkna rader, ord och tecken. Något i stil med ls | wc Det låter dig snabbt se hur många objekt som listas. Det fina är att du inte behöver ett enda program för att göra allt, utan snarare... Du skapar lösningar med små, väl utformade verktyg..
Det är också mycket vanligt att kedja ihop cat, sort y more (eller en annan personsökare) för att sortera en textfil och sedan bläddra igenom den sida för sida. Med en pipe går innehållet från ett kommando till nästa utan att sparas i explicita temporära filer, vilket avsevärt förenklar skript och administrativa uppgifter.
I praktiska fall, som att hantera studentlistor och betyg i separata filer, kan du använda paste att sammanfoga kolumner, cut för att bara välja de fält du är intresserad av och länkade pipes för att filtrera, sortera eller omvandla allt i en enda rad med shellskript. Detta mönster av bryta ner ett stort problem i enkla kommandon kombinerade med pipes Det är kärnan i Unix-filosofin.
Avancerade kommandon för att få ut det mesta av pipes: tee, xargs och cpio
När man börjar automatisera saker på riktigt i Linux blir pipes ännu kraftfullare tack vare några viktiga verktyg. Bland dem är: tee, xargs y cpiovilket kompletterar det vanliga dataflödet mycket väl.
Kommandot tee Den fungerar som ett "T" i ett vattenrör: den läser från stdin, skriver till stdout och kopierar även samma utdata till en eller flera filer. Den är idealisk när du vill visa resultatet på skärmen och spara det samtidigt att granska det senare eller bearbeta det i ett annat skede. Med alternativet -a Den lägger till data i slutet av filen istället för att skriva över den.
Du kan till exempel sortera en lista med sortskicka resultatet till tee att lagra den i en logg och samtidigt skicka den till more för att sidnumrera den. På så sätt har du i en enda pipeline sortering, sparande till disk och bekväm visning utan att upprepa sorteringsprocessen.
Kommandot xargs Det är ytterligare en grundläggande del när det gäller pipes. Dess funktion är att ta det som kommer in via stdin (vanligtvis en lista med element) och konvertera det till argument för ett annat kommando. Det är särskilt användbart när ett program kraschar på grund av att det tar emot för många parametrar samtidigt eller när du vill... dela upp arbetet i omgångar med alternativet -n, vilket begränsar hur många argument som skickas per körning.
Till exempel med ls | xargs -n 4 Du delar upp fillistan i grupper om fyra och kör målkommandot (som standard echo(eller den du anger) flera gånger. På så sätt kan du bygga pipelines som "förhandsgranska vad jag ska ta bort" genom att kombinera ls, xargs y echo rm innan den faktiska rensningen påbörjas.
Var försiktig med komplexa inmatningar: sökvägar med mellanslag eller specialtecken kan bryta standardbeteendet för xargsI dessa fall används det vanligtvis i kombination med find och alternativet -print0, som separerar element med ett null-tecken, tillsammans med xargs -0 så att båda ändar använder samma robusta avgränsare.
Slutligen, cpio Det är ett mindre känt kommando än tarMen den är otroligt flexibel för att arbeta med filströmmar via pipes. Till skillnad från tar är den designad från grunden för att fungera med omdirigeringar och pipestar emot en lista med filer via stdin (vanligtvis genererad med find) och producerar eller konsumerar filer av typen "paket" utan egen komprimering, som du sedan kan komprimera med gzip eller liknande.
De viktigaste lägena för cpio tillåta att skapa filer (-o), kopiera katalogträd (-p) eller extrahera innehåll (-i(ofta kallat ”kopiering”). Alternativ som -u att skriva över, -m för att bevara tidsstämplar eller -d att återskapa katalogstrukturen gör det möjligt att i detalj kontrollera vad som kopieras och hur, särskilt användbart i komplexa skript där tar kommer till korta.
Design och optimering av CI/CD-pipelines på Linux-servrar
Utöver den traditionella kommandoraden har pipeline-konceptet blivit grundläggande i Continuous Integration och Continuous Delivery (CI/CD) . På en Linux-server är en CI/CD-pipeline en automatiserad sekvens av steg: hämta kod, installera beroenden, kompilera, köra tester, paketera artefakter och driftsätta.
Linux är särskilt väl lämpat för detta eftersom det utmärker sig för sin hastighet, stabilitet och ekosystem av automatiseringsverktyg . Plattformar som Jenkins, GitHub Actions och GitLab CI förlitar sig på Linux-exekutorer (fysiska maskiner, virtuella maskiner eller containrar) för att köra pipelines konsekvent.
Att optimera dessa pipelines innebär inte bara att få dem att "fungera", utan att få dem att fungera med så lite friktion som möjligt. Detta innebär att minska utcheckningstider, minimera repetitiva beroendeinstallationer, optimera Docker-avbildningar för att undvika onödiga ombyggnader, återanvända redan genererade artefakter och hålla miljön säker och observerbar.
En grundläggande god praxis är att strukturera pipelinen i väldefinierade steg: bygga, testa och distribuera . Helst bör du kompilera endast en gång, generera en artefakt (binär, paket, Docker-avbildning) som testas parallellt i olika varianter (till exempel olika språkversioner) och sedan distribuera samma artefakt till staging- och produktionsmiljöer utan att kompilera om.
Att arbeta med oföränderliga artefakter lagrade i repositorier (S3, Nexus, Artifactory, containerregister eller paket inbäddade i GitLab/GitHub) förenklar granskning, möjliggör snabba versionsåterställningar och minskar sannolikheten för att "det fungerar på min maskin men inte i produktion".
Förkunskapskrav: distribution, CI-användare och serverhärdning
Innan man fastnar i millisekundoptimering här och där är det viktigt att etablera en stabil grund på Linux-servern som kommer att fungera som CI/CD-exekutor. Detta börjar med att välja distribution och lägsta säkerhetskonfiguration.
Det mest förnuftiga tillvägagångssättet är vanligtvis att standardisera på en LTS- eller stabil distribution som teamet är bekant med: Ubuntu LTS, Debian Stable eller företagsalternativ som AlmaLinux eller Rocky Linux. Att ha alla runers på samma version förhindrar oväntat beteende orsakat av olika bibliotek eller kärnor mellan jobb.
En annan rekommendation är att konfigurera en dedikerad användare för CI, utan root-behörigheter, med sudo mycket begränsat till endast de viktigaste kommandona (till exempel, systemctl o docker (om det verkligen är nödvändigt). Den här användaren måste autentisera sig med SSH-nycklar, både för att komma åt servern och för att interagera med Git-arkiv eller andra fjärrmaskiner.
På systemnivå är det lämpligt att underhålla servern uppdaterad och minimalt förstärktDetta inkluderar att tillämpa säkerhetsuppdateringar, konfigurera en restriktiv brandvägg (till exempel med UFW: neka all inkommande trafik utom vad som är nödvändigt och tillåta utgående trafik) och aktivera verktyg som fail2ban för att stoppa brute-force-attacker på SSH och justera vissa nätverks- och kärnparametrar via sysctl för att förbättra tillförlitlighet och prestanda.
Till exempel är det vanligt att höja gränsen för inotify för att förhindra att byggsystem som övervakar många filer får slut på resurser, och justera parametern vm.swappiness för att göra kärnan mer konservativ när man använder swap, något som är särskilt relevant när CI-jobb förbrukar mycket minne åt gången.
Cacher, Docker och parallellisering: prestandaspakarna i CI/CD
Om du tittar på vart tiden faktiskt går i en genomsnittlig pipeline, ser du att en stor del går förlorad på att installera beroenden och återuppbygga Docker-avbildningar . Att åtgärda detta är oftast mer effektivt än att optimera testkoden med några millisekunder.
Den första spaken är beroendecachelagring . Nästan alla beroendehanterare (pip, npm, Maven, Gradle, Go-moduler, etc.) använder lokala cachekataloger. På en persistent Linux-server kan du dela dessa kataloger mellan jobb eller montera dem på en persistent volym. På så sätt behöver inte varje körning ladda ner halva internet igen.
För Docker, aktivera Byggsats och strukturera väl Dockerfile Detta markerar en vändpunkt. Att placera beroendeinstallationen direkt efter att kravfilen kopierats, och före resten av koden, säkerställer att lagren återanvänds så länge versionerna av dessa beroenden förblir oförändrade. Dessutom kan specifika cacher för pip, npm, etc. konfigureras i själva bygget.
Den andra stora hävstången är parallell testkörningMånga ramverk har inbyggt stöd för samtidighet: pytest med -n autoJava-verktyg som Surefire, Jest i JavaScript med --maxWorkersetc. Att dela upp sviten efter moduler, mappar eller till och med efter beräknad tid och balansera den mellan flera arbetare möjliggör minskningar av testfasens längd med 2 till 5 gånger utan att ändra en enda affärslinje.
Slutligen finns det frågan om artefakter och distribution . Istället för att kompilera om samma avbildning för staging, förproduktion och produktion är det effektivaste tillvägagångssättet att bygga en gång, spara resultatet till ett repository och tagga det enligt distributionsmiljön. Detta minskar CPU-användningen, undviker inkonsekvenser och snabbar upp långa pipelines avsevärt.
Optimera Jenkins, GitHub Actions och GitLab Runner på Linux
Varje CI-system har sina egna särdrag, men de drar alla nytta av samma grundläggande idéer när de körs på Linux. Nyckeln är vanligtvis att använda efemära och rena exekutorer , upprätthålla en väldimensionerad persistent cache och kontrollera samtidighet.
I Jenkins är det vanligt att använda lätta, temporära agenter (som Docker-containrar eller poddar i Kubernetes eller andra containerorkestreringslösningar ) för att köra jobb, samtidigt som huvudnoden hålls så enkel som möjligt. Dessa agenter kan konfigureras som systemd-tjänster på Linux-servrar, registreras hos kontrollenheten och startas automatiskt när maskinen startar.
För GitHub-åtgärder med självhostade runners rekommenderas det att distribuera dem i Virtuella Linux-maskiner med snabba SSD-diskarFör att skapa en stor cachekatalog dedikerad till åtgärder (språkberoenden, byggcacher etc.), begränsa antalet samtidiga jobb för att undvika överbelastning av processorn och disken. Dra nytta av den officiella cacheåtgärden med sökvägar som ~/.cache/pip, ~/.npm o ~/.m2 Det gör en enorm skillnad i tid.
I GitLab Runner beror valet mellan shell-exekutorn och Docker på den balans mellan prestanda och isolering du behöver. Shell-exekutorn är snabbare eftersom den körs direkt på värden, men Docker-exekutorn erbjuder rena och replikerbara miljöer. Du kan också konfigurera delad cachning (lokal eller på S3) och justera det maximala antalet samtidiga jobb för att dra nytta av hårdvaran utan att överbelasta den.
I alla dessa fall är det avgörande att ha delade volymer för beroendecachelagring samtidigt som man förhindrar att arbetsytor blir röriga mellan byggen. Tillfälliga maskiner eller containrar, som skapas och förstörs med varje pipeline eller grupp av pipelines, minskar avsevärt problem med "det fungerade igår, men det gör det inte idag" som orsakas av rester av tidigare byggen.
Linux-serverprestanda: CPU, minne, I/O och Docker
Oavsett hur optimerade dina skript är, om Linux-servern som kör pipelinen inte är korrekt dimensionerad, kommer du att stöta på oändliga köer och långsamma jobb. En typisk, rimlig konfiguration för en mellanstor maskin är 4–8 vCPU:er och 8–16 GB RAM , med SSD-lagring (helst NVMe) och lite swap-utrymme (2–4 GB) för att hantera toppbelastningar utan att aggressivt döda processer.
Filsystemet spelar också roll. ext4 eller XFS med alternativet noatime Minska onödig I/O på volymerna där du kompilerar eller skriver loggar. Dessutom, montera en tmpfs för tillfälliga filer eller kortlivade artefakter (till exempel /mnt/ci-tmp) snabbar upp intensiva operationer och förhindrar att disken fylls med kvarvarande filer mellan jobb.
När det gäller Docker är daemonhygien nyckeln. Att säkert och regelbundet ta bort oanvända avbildningar och volymer, samtidigt som det bibehåller aktiva basavbildningar, hjälper till att kontrollera diskutrymme och starttiderKommandon som docker system prune Med lämpliga tidsfilter möjliggör de rengöring utan att överbelasta nyligen använda resurser.
Om ditt CI är containerintensivt kan du också använda speglade register för att undvika att alltid ladda ner från internet, använda BuildKit för samtidighet och lagercachning, och till och med konfigurera CPU-affiniteter (CPU-uppsättningar) eller dedikerade noder för de mest krävande exekutorerna, vilket förhindrar störningar mellan angränsande arbetsbelastningar. Dessutom hjälper förståelse för CPU-mikroarkitekturen dig att bättre dimensionera resurser för intensiva CI-arbetsbelastningar.
Säkerhet i pipelinen (DevSecOps) och distributioner på Linux
En snabb men osäker pipeline är en tickande tidsbomb. Att integrera säkerhet i själva pipelinen och Docker-containersäkerhet är nu standard i alla DevSecOps-strategier, och Linux erbjuder många verktyg för detta.
Det första man bör göra är att behandla hemligheter och inloggningsuppgifter med största försiktighet . De bör aldrig finnas i koden eller i versionerade konfigurationsfiler. Istället lagras de i hemlighetshanterare (maskerade variabler i GitLab, krypterade hemligheter i GitHub, HashiCorp Vault, etc.) och injiceras endast under körningen av det jobb som behöver dem, med kortlivade tokens när det är möjligt.
Ett annat viktigt lager är genereringen av SBOM (Software Bill of Materials) och signering av artefakter. Verktyg som Syft eller CycloneDX låter dig lista alla komponenter som utgör en avbildning eller binärfil, medan Cosign eller andra verifierbara signeringslösningar säkerställer att endast artefakter som har gått igenom pipelinen och validerats distribueras.
När det gäller nätverk och åtkomst är det lämpligt att segmentera CI- och produktionsnätverk , implementera strikta brandväggar, granska exekveringsloggar och rotera autentiseringsuppgifter regelbundet. Där SSH används är det bättre att använda certifikat eller nycklar med utgångsdatum snarare än statiska lösenord.
Vid driftsättning på Linux minskar strategier som Blue/Green, rolling och canary avsevärt effekten av driftsättningsfel. Att köra applikationen som en systemd-tjänst, placera en Nginx eller HAProxy framför den och kontrollera trafiken mellan versioner med hälsokontroller gör att du uppnår praktiskt taget noll driftstopp under uppdateringar.
Till exempel när du laddar om Nginx och startar om tjänster med systemd med hjälp av mjuka stoppsignaler (t.ex. SIGTERMMed rimliga väntetider kan du tömma aktiva anslutningar innan processen stoppas, vilket bibehåller användarupplevelsen intakt medan du byter version i bakgrunden.
Observerbarhet, mätvärden och kostnader i Linux-pipelines
När dina pipelines är igång är nästa steg att mäta dem och förstå vart tid och resurser går . Det räcker inte att veta om ett arbetsflöde lyckas eller misslyckas; du måste övervaka varaktigheten för varje steg, kötid, framgångsgrad, distributionsfrekvens, cacheträfffrekvens och så vidare.
Det är vanligt att exportera systemmätvärden med hjälp av node_exporterCentralisera loggar med lösningar som ELK eller Loki och visualisera allt i Grafana-dashboards. På så sätt kan du till exempel upptäcka om testfasen har ökat i längd med 30 % den senaste veckan eller om jobben väntar för mycket på en tillgänglig utförare; övervakning av nätverkstrafik Öppen källkodsverktyg kompletterar den synligheten.
Det är också möjligt att instrumentera själva pipelinen, till exempel i GitHub Actions eller GitLab CI, för att att programmatiskt mäta hur många körningar som har lyckats, hur länge varje körning har varat och vad den övergripande statusen ärEtt skript som anropar leverantörens API, beräknar det totala antalet körningar, antalet lyckade körningar, antalet misslyckade körningar, framgångsfrekvensen och den genomsnittliga varaktigheten, och sparar allt i en JSON-fil (som pipeline-metrics.json) låter dig integrera dessa mätvärden i rapporter eller instrumentpaneler.
Med den här informationen kan du fatta beslut om storleken och antalet löpare : ibland är det bättre att ha fler små löpare än några få mycket stora för att minska väntetiderna. Autoskalbarhet – till exempel molnautoskalning eller dynamiska pooler av Kubernetes-noder – hjälper till att absorbera toppaktivitet under dagen och minimera underutnyttjade resurser på natten.
Dessa metoder förbättrar inte bara teamets upplevelse, utan hjälper också till att justera infrastrukturkostnaderna genom att kontrollera CPU-, minnes- och särskilt lagringsförbrukning, vilken tenderar att skjuta i höjden med avbildningar och cacheminne om den inte rensas regelbundet och planerat.
Att behärska både klassiska kommandoradsrör och moderna CI/CD-pipelines i Linux erbjuder en kraftfull kombination: du kan automatisera allt från enkla textfiltreringsuppgifter till komplexa, underhållbara, säkra och snabba bygg-, test- och distributionspipelines. Att förstå hur information flödar mellan processer, hur beroenden cachas, hur servrar justeras och hur mätvärden och säkerhet integreras gör att du kan bygga arbetsflöden som skalas med ditt team och dina projekt utan att bli en konstant flaskhals.
