- Optimering för flera plattformar kombinerar molnbaserad arkitektur, skalbar lagring och moderna protokoll för att säkerställa låg latens.
- Väl optimerade cachningsstrategier, uppgiftsköer och databaser upprätthåller prestandan allt eftersom appen skalas till miljontals användare.
- Ramverk som Flutter eller React Native, tillsammans med bra minne, GPU och resurshantering, möjliggör nästintill native-upplevelser.
- AI driver prediktiv resursallokering, avancerad säkerhet och personalisering, vilket är avgörande för att konkurrera i krävande mobila och webbmiljöer.
Att optimera prestanda över flera plattformar har blivit ett av de hetaste ämnena inom modern mjukvaruutveckling. Användare jämför allt med den nästan omedelbara upplevelsen av AI, förväntar sig svarstider på under en sekund och vill att det ska vara lika smidigt på en budgettelefon, en iPhone Pro, en Android-surfplatta eller webbläsaren på sin kontorsbärbara dator.
I det här sammanhanget räcker det inte längre att bara "få det att fungera"; prestanda har en direkt inverkan på kundlojalitet, konvertering och varumärkesrykte . Från specialiserade företag som Q2BSTUDIO eller ITERAM till lågkodplattformar som Adalo, och inklusive team som arbetar med Flutter, React Native eller webblösningar, har fokus flyttats från att utveckla snabbt till att utveckla snabbt och bra, med skalbara arkitekturer, kontinuerlig övervakning och ett allt kraftfullare lager av artificiell intelligens som assisterar genom hela cykeln.
Plattformsoberoende prestanda: kontext, utmaningar och viktiga mätvärden
Den första förändringen i tankesättet är att förstå att optimering av prestanda över flera plattformar är en ständigt pågående disciplin , inte en sista "justeringsuppgift" innan publicering i butiken. Varje operativsystem, webbläsare och enhetstyp har sina egna regler, men användaren förväntar sig att appen ska kännas lika naturlig i alla miljöer.
Ur ett prestandatekniskt perspektiv är mätvärden som Time to Interactive (TTI), Crash-Free Sessions och Frame Rendering Time av största vikt. Ett rimligt och mycket ambitiöst mål idag är att hålla TTI under 500 ms på 95 % av enheterna, samtidigt som man strävar efter 99,99 % kraschfria sessioner, även när hårdvarumixen inkluderar wearables, enklare telefoner, surfplattor och stationära datorer.
På iOS är prioriteringarna 60fps-animationer, laggfria pekgester och effektiv minnesanvändning . På Android ligger fokus, förutom rå prestanda, på batteritid, variation i skärmstorlek och hårdvaruheterogenitet. På webben är nycklarna till framgångsrika webbapplikationer laddningshastighet, kompatibilitet mellan webbläsare och acceptabel prestanda även på dåliga nätverk.
Allt detta leder till en obekväm men nödvändig fråga: hur uppnår man prestandaparitet över plattformar utan att utvecklingskostnaderna skjuter i höjden? Det är här plattformsoberoende ramverk, molnbaserade arkitekturer, resursoptimering, cachningsstrategier och intelligent användning av AI kommer in i bilden.
Kärnstrategi: arkitektur, lagring och nätverk
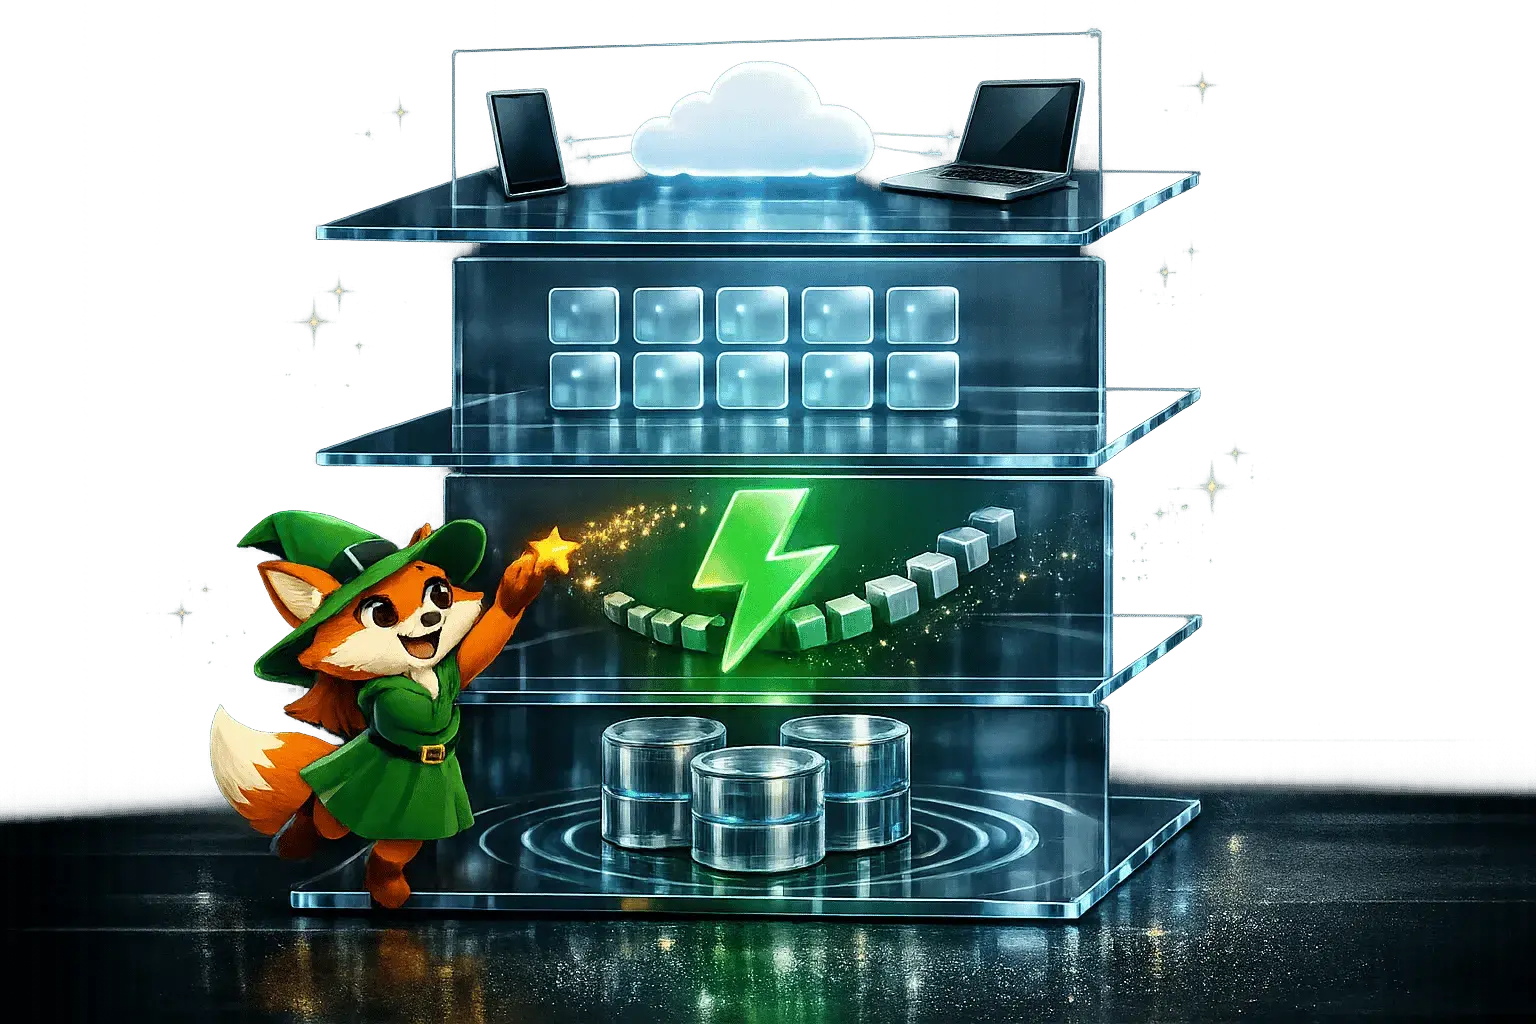
För att en plattformsoberoende app ska kunna skala från hundratals till miljontals användare är data- och nätverksarkitekturen lika viktig som gränssnittskoden. Att bara "använda molnet" räcker inte; du måste designa var data lagras, hur den färdas och vad som cachas på varje enhet.
En mycket vanlig kombination är att använda molnlagring som ryggrad , med hanterade databaser, och förlita sig på högpresterande lokal lagring på varje enhet. Detta balanserar praktiskt taget obegränsad kapacitet på backend med supersnabb åtkomst till kritisk data på klientsidan, vilket gör att appen kan användas även med begränsad anslutning.
Allt eftersom applikationen växer blir en mikrotjänstarkitektur med en "databas per tjänst"-modell allt viktigare . Detta gör att du kan välja den optimala lagringstekniken för varje modul: relationell för betalningar, objektlagring för analyser, nyckelvärdeslagring för sessioner eller konfigurationscacher. Det gör det också enkelt att selektivt skala det som verkligen behöver det utan att krascha resten av systemet.
Parallellt gör den elastiska infrastrukturen (diskar och databaser som möjliggör separat justering av IOPS, dataflöde och kapacitet) det möjligt att hantera trafiktoppar utan överprovisionering året runt. Att kombinera horisontell skalning, elastisk lagring och geografisk datadistribution är nyckeln till att upprätthålla låg latens från alla regioner.
Slutligen utvecklas nätverkslagret mot moderna protokoll: HTTP/3, QUIC och WebTransport möjliggör enkelriktade strömmar, leverans i fel ordning och förbättrad prestanda i miljöer med omfattande telemetri och realtidssynkronisering. Att migrera kritiska dataflöden eller kanaler till dessa tekniker resulterar vanligtvis i betydande minskningar av upplevd latens.
Intelligent resursoptimering: AI, binärfiler och kryptografi
I moderna enheter är processorn inte längre den enda flaskhalsen; batteri, temperatur, minne och nätverkskvalitet påverkar alla användarupplevelsen . Det är här AI börjar spela en ledande roll, med lättviktsmodeller som körs direkt på enheten.
En avancerad metod är prediktiv resursallokering med hjälp av maskininlärningsmodeller på enheten . Dessa modeller tar emot signaler som enhetstyp, operativsystemversion, ledigt RAM-minne, batteritemperatur, användningsmönster och anslutningskvalitet, och justerar dynamiskt appparametrar som videokomprimering, renderingskomplexitet, UI-cachestorlek och synkroniseringsfrekvens.
Dessutom behöver det klassiska problemet med "bloat" i plattformsoberoende ramverk åtgärdas. Kombinationen av aggressiv trädskakning och dynamisk modulinläsning möjliggör mindre binärfiler och förbättrade kallstarter, vilket initialt bara laddar kärnfunktionaliteten och implementerar tunga funktioner på begäran, när användaren faktiskt behöver dem.
En annan viktig utmaning är kryptografisk overhead i en postkvantvärld . Algoritmer som CRYSTALS-Kyber ökar nyckelstorleken och handskakningskostnaden, vilket är märkbart på enheter i mellanklassen. Hybridstrategier som kombinerar klassisk kryptografi för hastighet och PQC för att skydda nyckelmaterial, tillsammans med off-threading av nyckelutbytet, hjälper till att upprätthålla säkerheten utan att bryta TTI (Time-to-Impact Factor).
Allt detta kräver en bredare syn på prestanda: det handlar inte bara om att minska tiden i millisekunder, utan om att designa adaptiva system som reagerar innan användaren ens märker försämringen.
Cachning, köer och databaser: snabbare dataflöde
När lagringsbasen är väl genomtänkt tas nästa steg genom cachningsstrategier och kösystem , vilket verkligen avlastar databaserna och håller front-end igång smidigt.
Minnesbaserad cachning (till exempel med Redis) erbjuder svarstider på under en millisekund och kan hantera hundratusentals eller miljontals förfrågningar per sekund. I praktiken innebär detta att ofta åtkomna data (profiler, konfigurationer, populära listningar etc.) hanteras utan åtkomst till disken, vilket minskar kostnader och svarstider.
I mobilappar och PWA:er gör kombinationen av fjärrcachning och enhetsspecifik lokal cachning hela skillnaden. Service Workers och Cache API låter dig spara HTML, CSS och JavaScript för nästan omedelbar inläsning och grundläggande offline-läge; på mobila enheter fungerar lokala databaser som SQLite eller Realm som ett tillståndslager med aggressiva TTL:er som omvandlar en långsam varmstart till en nästan omedelbar återupptagning.
Kösystem (RabbitMQ, SQS, molnhanterade lösningar etc.) hanterar allt som inte är kritiskt för omedelbar interaktion : generering av stora rapporter, komplexa beräkningar, tredjepartsintegration eller bearbetning av stora filer. Ett typiskt mönster är att lagra filer i bloblagring, returnera en försignerad URL via omdirigering och låta nedladdningen hanteras utanför det huvudsakliga applikationslagret.
På databassidan är klassiska optimeringar fortfarande ovärderliga: korrekt indexering och anslutningspoolning kan minska frågetiderna med över 70 % och förbättra transaktionslatensen med liknande procentsatser. I system som Firebase Realtime Database ökar platta datastrukturer, välplacerade lyssnare och nyckelbaserade frågor istället för underordnade fältfrågor prestandan avsevärt.
Plattformsoberoende front-end: ramverk, användargränssnitt och animationer
Användaren ser bara gränssnittslagret, så en väl genomtänkt frontend-arkitektur är lika viktig som en kraftfull backend . Det är här React Native, Flutter, .NET MAUI, WebAssembly och Progressive Web Apps, bland andra, och till och med ramverk som Lazarus , kommer in i bilden.
React Native kan uppnå nästan native prestanda genom att korrekt hantera den JavaScript-native bryggan , minimera onödig korsfunktionalitet och delegera tungt arbete till native moduler. Komponentoptimering, användning av virtualiserade listor och effektiv tillståndshantering gör hela skillnaden mellan en trög app och en flytande.
Flutter är i en annan liga vad gäller gränssnittsprestanda eftersom kompilerar Dart till nativ kod och målar direkt på arbetsytanDart 3 ger förbättringar inom typning, nullbarhet och AOT-kompilering som minskar omkostnader och förbättrar starttider, samtidigt som intensiv användning av const och oföränderliga objekt minimerar onödiga ombyggnader av widgetar.
Impeller, Flutters nya renderingsmotor, är utformad för att säkerställa mer förutsägbara renderingspipelines, färre hack och bättre GPU-utnyttjande , särskilt på enheter med begränsade grafikresurser. Detta resulterar i jämnare animationer och mer stabil resursförbrukning.
Utöver ramverket finns övergripande principer: undvik överdragning, separera statiska element i lager, prioritera upplevd prestanda och säkerställa tillgänglighet . Skelettgränssnitt, progressiv textinläsning, mikrointeraktioner med animationer och haptisk feedback som maskerar korta väntetider förbättrar den övergripande känslan av hastighet betydligt mer än att minska ett nätverkssamtalslatens med 20 ms.
Minne-, GPU- och heterogen enhetshantering
I ett ekosystem där iPhones med 16 GB RAM samexisterar med kraftigt optimerade Android-enheter med 3 GB, är minnes- och grafikresurshantering en hörnsten för prestanda . En felberäkning här är ett recept för krascher, GPU-frysningar och batteriurladdning.
Plattformsoberoende optimering innebär att förstå hur varje ramverk och plattform hanterar allokering, sophämtning och livscykler . Strategier som periodisk heap-profilering, djup spårning av objekt som behålls efter specifika flöden och att tillämpa skärmgränser hjälper till att upptäcka minnesläckor som inte är omedelbart uppenbara men kan manifestera sig som slumpmässiga pauser efter några veckor.
GPU:n är en annan viktig resurs: att flytta vissa beräkningar (bildbehandling, filter, tunga transformationer) till beräkningsshaders med Metal Compute på iOS eller Vulkan på Android gör att huvudtråden kan dedikeras till användargränssnittet, vilket bibehåller 60 fps även under intensiv drift.
Parallellt minskar optimering av visuella tillgångar minnesförbrukningen och förbättrar laddningstiderna. Genom att använda moderna format (WebP, AVIF), automatiserad generering av flera densiteter för iOS (@1x, @2x, @3x) och Android (mdpi, hdpi, xhdpi, etc.), och vektorgrafik där det är lämpligt, bidrar det till att hålla apparna lätta och skarpa på alla skärmar.
Slutligen måste den enorma mångfalden av hårdvara beaktas. Adaptiva strategier som justerar texturkvalitet, videoupplösning eller animationskomplexitet enligt enhetens kapacitet möjliggör "premium"-upplevelser på avancerade enheter utan att döma andra användare till en outhärdlig app.
Verklig skalbarhet: användningsfall och plattformar med låg kod
När man diskuterar skalning till miljontals användare är det bra att titta på dem som redan har varit där. Slack, till exempel, migrerade från en fragmenterad MySQL till Vitess , och lyckades hantera miljontals frågor per sekund med latenser på bara millisekunder och lösa hot shard-problem. Denna typ av arkitektur, replikerad över flera regioner, visar att backend kan växa utan att bli överbelastad.
På frontend-sidan arbetade Slack med cachning och startoptimering, och lyckades minska starttiderna med mer än hälften och avsevärt förbättra heta starter . Återigen är budskapet tydligt: det handlar inte om en enda mirakulös förändring, utan om många små, välfokuserade beslut.
Airbnb, å sin sida, tog sig an utmaningen att synkronisera tillstånd över flera plattformar med en decentraliserad arkitektur, där varje klient hanterar sitt lokala tillstånd och koordinerar genom ett robust centralt lager. Användningen av strukturerade liggare underlättar systemutveckling utan att enskilda konsumenter störs.
I andra änden av spektrumet har vi plattformar som Adalo, som gör det möjligt för team utan omfattande infrastrukturerfarenhet att bygga webb-, iOS- och Android-applikationer från en enda kodbas , genom att utnyttja en modulär backend som kan bearbeta tiotals miljoner dagliga förfrågningar med hög tillgänglighet. Deras tillvägagångssätt med förutsägbar prissättning och AI-verktyg för att generera skärmar, flöden och datastrukturer accelererar avsevärt tiden till marknaden.
Det viktiga här är att förstå att oavsett om du utvecklar det specialanpassat med Q2BSTUDIO eller ITERAM eller använder lågkod, är de bästa metoderna för prestanda, säkerhet och skalbarhet desamma : cachar, köer, välindexerade databaser, kontinuerlig övervakning och en arkitektur som möjliggör tillväxt utan att behöva göra om allt.
AI, säkerhet och framtiden för plattformsoberoende utveckling
Framöver blir gränsen mellan prestandateknik och artificiell intelligens alltmer suddig. AI genererar inte bara kod; den bestämmer hur och när resurser ska användas , upptäcker avvikande mönster, förutser belastningstoppar och föreslår konfigurationsändringar i realtid.
Kodgenereringsverktyg som GitHub Copilot eller konversationsassistenter accelererar utvecklingen, men den verkligt intressanta punkten ligger i modellerna som körs i själva appen eller vid kanten : de allokerar resurser prediktivt, anpassar upplevelsen efter användarbeteende och justerar dynamiskt innehållskvaliteten efter nätverk eller enhet.
Inom säkerhet stärker kombinationen av Zero Trust, lösenordsfri autentisering (lösenord, biometri) och AI-drivna system för avvikelsedetektering kritiska applikationer som bank, sjukvård och tillverkning. Nyckeln är att integrera säkerhet genom hela livscykeln med hjälp av DevSecOps-metoder, automatisera testning och säkerställa att snabb utveckling inte blir en grogrund för sårbarheter.
Å andra sidan tvingar sammankopplingen med IoT och edge computing optimering till det yttersta: bearbetning av data nära källan, filtrering av irrelevant data innan något skickas till molnet, och upprätthållande av en sömlös upplevelse även med ett ojämnt nätverk. Sektorer som logistik, telemedicin och hemautomation är redan beroende av den här typen av arkitekturer.
Även utvecklarens roll utvecklas: profiler för multiplattformsutvecklare, IT-prestandaspecialister, experter på testautomation och molnbaserade arkitekter efterfrågas alltmer. Nuvarande utbildningar kombinerar native och hybridutveckling, databashantering, säkerhet, automatisering och naturligtvis prestandaoptimering från början till slut.
Hela detta pussel – molnbaserad arkitektur, datahantering, plattformsoberoende användargränssnitt, AI, säkerhet och testning – sammanfaller mot ett enda mål: att bygga applikationer som känns snabba, tillförlitliga och konsekventa på alla enheter , samtidigt som kostnaderna hålls under kontroll och snabb iteration möjliggörs. Att designa från grunden med prestanda, skalbarhet och användarupplevelse i åtanke är det som skiljer applikationer som bara "finns där" från produkter som blir riktmärken på sin marknad.
