- De flesta RAID-systemkatastrofer förvärras av förhastade åtgärder under de första minuterna efter felet.
- Varje RAID-nivå hanterar data och paritet på olika sätt, vilket avgör den faktiska risken och återställningsstrategin.
- Den professionella interventionen kombinerar diskkloning, rekonstruktion av virtuella arrayer och avancerade logiska analystekniker.
- En RAID ersätter inte säkerhetskopior: förebyggande åtgärder och ordnade åtgärder är nyckeln till att spara data.
När ett RAID-system går sönder är de första minuterna kritiska. Under den så kallade "gyllene timmen" efter felet inträffar de flesta mänskliga fel, vilket förvandlar ett återställbart problem till en oåterkallelig katastrof. Att blint byta diskar, ständiga omstarter eller försöka återuppbygga utan att veta vad som är fel är oftast den snabbaste vägen till total dataförlust.
Varför är RAID-återställning så känslig?
I många kritiska incidenter orsakas dataförlust inte av det initiala hårdvarufelet, utan av förhastade åtgärder som vidtagits under den första timmen . Denna period är avgörande: en disk kan ändra position, en initialiseringsprocess kan initieras felaktigt, en ombyggnad kan tvingas fram, eller systemet kan starta från en ofullständig säkerhetskopia på samma lagringsarray, och det som en gång var ett komplext men hanterbart problem blir ett nästan omöjligt pussel.
De vanligaste risksituationerna inkluderar att byta diskar i fel ordning (i RAID 0, 1, 5, 6, 10, etc.), byta ut styrenheten mot en annan modell utan att klona eller dokumentera konfigurationen, tvinga diskar "online" utan att analysera det faktiska tillståndet, initiera fel volymer eller starta ombyggnader som lämnas oavslutade och ytterligare korrumperar arrayens interna struktur.
Särskilt farliga är också säkerhetskopiering och återställning direkt till det skadade systemet , lagringsmigreringar av VMware Storage vMotion-typ med en instabil array och alla operationer som skriver nya RAID-konfigurationsmetadata till diskar med potentiellt återställningsbar information.
En RAID-array är grunden för de flesta fysiska servrar, NAS- och SAN-system, och det är inte alltid tydligt från början att problemet härrör från själva arrayen. Därför är det klokaste att vid tveksamhet att stoppa alla skrivningar till diskarna , dokumentera situationen i detalj och rådfråga dataåterställningsspecialister innan man gör några ytterligare ändringar.
Typiska mänskliga fel och grundläggande god praxis
När ett RAID-system går in i ett degraderat tillstånd, en eller flera diskar går sönder, eller NAS-enheten inte startar, är den instinktiva reaktionen vanligtvis att prova saker "tills något fungerar". Denna metod förvärrar nästan alltid problemet eftersom varje åtgärd lämnar ett spår på diskarna och kan skriva över paritet, metadata eller användardata som fortfarande är intakta.
Bland de vanligaste felen som komplicerar återställning är åtgärder som att konfigurera en ny RAID med samma styrenhet och diskar , sätta in dessa diskar i ett annat lagringskabinett för att "se om den känner igen dem" eller ändra den fysiska ordningen på enhetsfacken. I en hög andel fall skriver dessa åtgärder över den ursprungliga konfigurationen, förstör paritetsränderna och minskar drastiskt chanserna att lyckas.
En annan vanlig dålig praxis är att inte registrera allt som händer. I ett komplext felscenario är det viktigt att logga alla händelser kronologiskt : strömavbrott, systemmeddelanden , diskändringar, återuppbyggnadsförsök, firmwareuppdateringar etc. Denna information hjälper senare specialiserade tekniker att pussla ihop pusslet.
Det är lika viktigt att dokumentera och bevara den exakta positionen för varje disk i arrayen . Att byta diskfack "efter ögat" eller att kassera förmodat döda diskar är vårdslöst: om RAID-enheten behöver monteras ihop igen i ett labb senare kan det göra hela skillnaden att veta vilken disk som satt i vilken plats och ha alla originaldiskar (även de utbytta) tillgängliga.
Som en allmän regel bör följande åtgärder vidtas vid ett RAID-fel: stoppa datorn, konfigurera inte om någonting, håll alla diskar märkta , samla in så mycket information som möjligt om händelsen och, om informationen är viktig, kontakta en professionell återställningstjänst innan du fortsätter experimentet.
Hur proffs går tillväga för att återställa RAID-system
Företag som specialiserar sig på RAID-dataåterställning arbetar med mycket strukturerade procedurer eftersom varje tekniskt beslut måste minimera risken för ytterligare skador . I ett typiskt fall med flera diskar och terabyte data på spel kan varje improviserat steg bli kostsamt.
Ett mycket illustrativt exempel från verkligheten är en RAID-array med tolv diskar och cirka 12 TB data. Säkerhetskopieringen hade inte hanterats korrekt, så den enda gångbara lösningen var att kontakta ett professionellt företag för RAID-dataåterställning . Situationen var brådskande; driften behövde återupptas så snart som möjligt, och arrayen hade redan nått ett kritiskt tillstånd efter att två diskar havererat under en omkonfiguration.
I sådana scenarier börjar specialister vanligtvis med att klona alla fungerande diskar och arbetar alltid med kopior, inte originalen. Samtidigt försöker de reparera, så långt det är möjligt, de fysiskt skadade diskarna, antingen genom laboratorieinterventioner (renrum, utbyte av diskhuvuden, donatorelektronik etc.) eller med avancerade tekniker för partiell läsning.
När det gäller 12 TB-disken var det största problemet att RAID-omkonfigurationen hade påbörjats före det andra felet , så styrenheten hade redan delvis omräknat de nya paritetsvärdena. Den relativa fördelen var att den andra disken misslyckades i processens tidiga skeden, så mycket av den gamla logiska strukturen kunde fortfarande återställas.
Efter att ha återställt en av de skadade diskarna och genererat en komplett kopia, var utmaningen att manuellt rekonstruera arrayens logiska struktur : diskordning, blockstorlek, paritetsfördelning, möjliga förändringar mitt i processen… Detta arbete, som kan ta flera dagars analys, gjorde det möjligt för oss att återställa cirka 90 % av informationen, vilket, med tanke på omständigheterna, anses vara en hög framgångsgrad vid RAID-återställning.
Professionella tjänster: vad de vanligtvis erbjuder och hur de arbetar
Företag som specialiserar sig på RAID-dataåterställning erbjuder vanligtvis snabb, kostnadsfri diagnostik , särskilt för kritiska servrar eller produktions-NAS-enheter. I vissa fall åtar de sig att bedöma problemet inom några timmar, tillhandahålla en genomförbarhetsrapport och en fast prisuppgift, och följa en policy om "ingen återställning, ingen kostnad".
En typisk tjänst börjar när klienten begär en gratis offert för att återställa sin RAID . I denna inledande fas samlas information in om arraytyp (RAID 0, 1, 5, 6, 10, JBOD, etc.), antalet diskar, filsystemet (t.ex. ext4, Btrfs, XFS, HFS+, NTFS…), den inblandade hårdvaran (Synology NAS, QNAP, märkesservrar, SAN-arrayer…) och en detaljerad beskrivning av symtomen och de åtgärder som hittills vidtagits.
När studien har godkänts brukar företaget ordna en gratis upphämtning av utrustningen eller skivorna , med noggranna förpackningsinstruktioner: använd antistatisk eller vadderad emballage, placera enheten i en styv låda med stötdämpande material, förhindra att skivorna rör sig under transport och märk väl med ansökningsnumret.
Tillbaka i labbet utför teknikerna en fysisk och logisk diagnostik av varje disk , skapar bit-för-bit-bilder när det är möjligt, utvärderar sektorernas tillstånd och bestämmer hur RAID-disken ska rekonstrueras virtuellt. Först då presenteras en slutgiltig offert, inklusive den uppskattade andelen återställningsbara data och den ungefärliga handläggningstiden.
Om klienten godkänner det börjar den faktiska återställningsprocessen. Efter att ha stabiliserat hårddiskarna och konfigurerat RAID-systemet i en kontrollerad miljö genererar specialisterna en lista över tillgängliga filer. Fram till denna punkt har klienten vanligtvis inte betalat något . Först om listan är tillfredsställande kopieras data till nya lagringsmedia (en extern hårddisk, en ersättnings-NAS etc.) och skickas tillbaka till klienten, nästan alltid inklusive frakt.
Grunderna: hur en RAID fungerar inuti
Ett RAID-system är, enkelt uttryckt, en uppsättning fysiska diskar som presenteras för operativsystemet som en enda logisk enhet . Nyckeln ligger i hur data distribueras och, potentiellt, pariteten mellan diskarna för att få bättre prestanda, kapacitet, feltolerans eller en kombination av dessa.
RAID-teknik gör det möjligt att distribuera data i ränder eller block som skrivs parallellt över flera diskar, vilket accelererar åtkomsten genom att kombinera överföringar. Dessutom lagras redundant data (paritet) på vissa nivåer för att omberäkna data från en trasig disk utan avbrott i tjänsten, förutsatt att de felgränser som anges i arraydesignen inte överskrids.
En annan viktig fördel är möjligheten att byta diskar under drift på många system. Det innebär att en felaktig disk fysiskt kan tas bort och ersättas utan att servern eller lagringsarrayen stängs av, vilket gör att styrenheten kan rekonstruera den förlorade informationen på den nya disken i bakgrunden medan systemet fortsätter att fungera.
Det finns ingen enskild "perfekt RAID-nivå" som passar alla scenarier. Varje nivå prioriterar en annan balans mellan prestanda, säkerhet och användbar kapacitet . Därför är det avgörande att förstå vilken typ av RAID som är konfigurerad innan man försöker reparera eller återställa.
När något går fel kan RAID-systemet vanligtvis självt rekonstruera data om den planerade feltoleransen uppfylls. Men när flera fysiska, logiska eller mänskliga problem uppstår i följd kan arrayen förlora koherens och bli oförmögen att återställa sig själv, vilket kräver expertingripande.
Vanliga RAID-nivåer och deras egenskaper
Varje RAID-nivå hanterar datadistribution och paritet mellan diskar på olika sätt , vilket resulterar i mycket tydliga skillnader i beteende vid ett fel. Att förstå dessa skillnader hjälper till att bedöma den faktiska risken för ett fel och sannolikheten för en lyckad återställning.
RAID 0, känt för sin höga prestanda, distribuerar data i stripes över minst två diskar utan att lagra någon redundant information. Det innebär att förlusten av en enda disk resulterar i förlust av hela volymen , eftersom delar av varje fil är utspridda över alla enheter. Dess största fördel är hastighet, men ur ett datasäkerhetsperspektiv är det mycket sårbart.
RAID 1, eller spegling, behåller identiska kopior av data på två diskar . Om den ena går sönder fortsätter den andra att fungera sömlöst. Det är enkelt, tillförlitligt och erbjuder bra läshastigheter, även om det offrar användbar kapacitet, eftersom det tillgängliga utrymmet motsvarar det för en enda disk i paret. Vid återställning gör det oftast saker och ting mycket enklare att ha minst en av diskarna intakt.
Det finns också RAID-nivåer som RAID 3 och RAID 4, mindre vanliga idag, som kombinerar datadiskar med en dedikerad paritetsdisk . I RAID 3 är åtkomsten till datadiskarna samtidig, och paritetsdisken blir en potentiell flaskhals, medan RAID 4 tillåter mer oberoende åtkomst till varje datadisk, vilket förbättrar prestandan under vissa arbetsbelastningar.
RAID 5 är förmodligen den mest använda RAID-konfigurationen i server- och NAS-miljöer. Den distribuerar data i stripes över flera diskar och sammanfogar paritetsblock fördelade mellan alla diskar , utan att en enda disk uteslutande dedikeras till den funktionen. Denna konfiguration möjliggör återställning av data på en ersättningsdisk om en fel uppstår, förutsatt att ett andra fel inte inträffar under återställningsprocessen.
RAID 6 tar säkerheten ett steg längre genom att lagra två paritetsblock för varje datauppsättning , vilket gör att den kan motstå samtidiga fel på upp till två diskar utan dataförlust. Det kräver mer diskkapacitet för paritet och mer datorkraft, men erbjuder i gengäld en mycket större felmarginal vid kedjefel, en mycket värdefull funktion i stora arrayer.
Utöver dessa "klassiska" RAID-nivåer finns kombinationer som RAID 10 (spegling + striping), RAID 50 eller 60, och linjära eller JBOD-konfigurationer, där diskar helt enkelt sammanfogas för att bilda en stor volym , utan verklig redundans. I inget av dessa fall ersätter RAID ett väl utformat säkerhetskopieringssystem.
Typiska RAID-systemfel och när återställning blir komplicerad
RAID-system har ett rykte om sig att vara robusta, och med rätta, men de är inte immuna mot problem. I praktiken uppstår fysiska, logiska och mänskliga fel , ofta sammanflätade och leder till utmanande återställningssituationer.
Ur ett logiskt perspektiv är ett av de allvarligaste hindren förlust eller korruption av paritetsränder . När metadata som anger hur data och paritet är fördelade över diskar försämras kan RAID-systemet inte längre regenerera informationen på egen hand, och extern intervention krävs för att lokalisera och återuppbygga dessa ränder manuellt eller halvautomatiskt.
När det gäller hårdvara visar statistik att en liten andel diskar i en given infrastruktur kan få fysiska fel varje år, cirka 2–3 %. I en array med många diskar innebär detta att risken för minst ett fel inte är försumbar. Mekaniska fel, strömavbrott, felaktig firmware, extrema temperaturer eller komponenter av dålig kvalitet är vanliga orsaker till fysiska fel.
Problemen förvärras när ett andra fel inträffar under en ombyggnad, särskilt i RAID 5 eller konfigurationer med många diskar. Om en annan disk börjar uppleva allvarliga fel medan systemet regenererar data från en trasig disk, kan arrayen gå från att vara degraderad till helt oåtkomlig. När fler diskar går sönder än den förväntade toleransen är RAID:s interna logik inte längre tillräcklig och avancerade återställningstekniker måste användas.
Mänskliga fel kompletterar cocktailen: att försena utbytet av en disk som redan gav varningar, ignorera larm från styrenheter, felaktigt stänga av system vid upprepade strömavbrott , installera otillräckliga drivrutiner , tvinga fram kontinuerliga omstarter eller tillämpa underhållsprocedurer utan aktuella säkerhetskopior är metoder som avsevärt ökar risken för dataförlust.
Användning av specialiserad programvara: ett praktiskt exempel med R-Studio
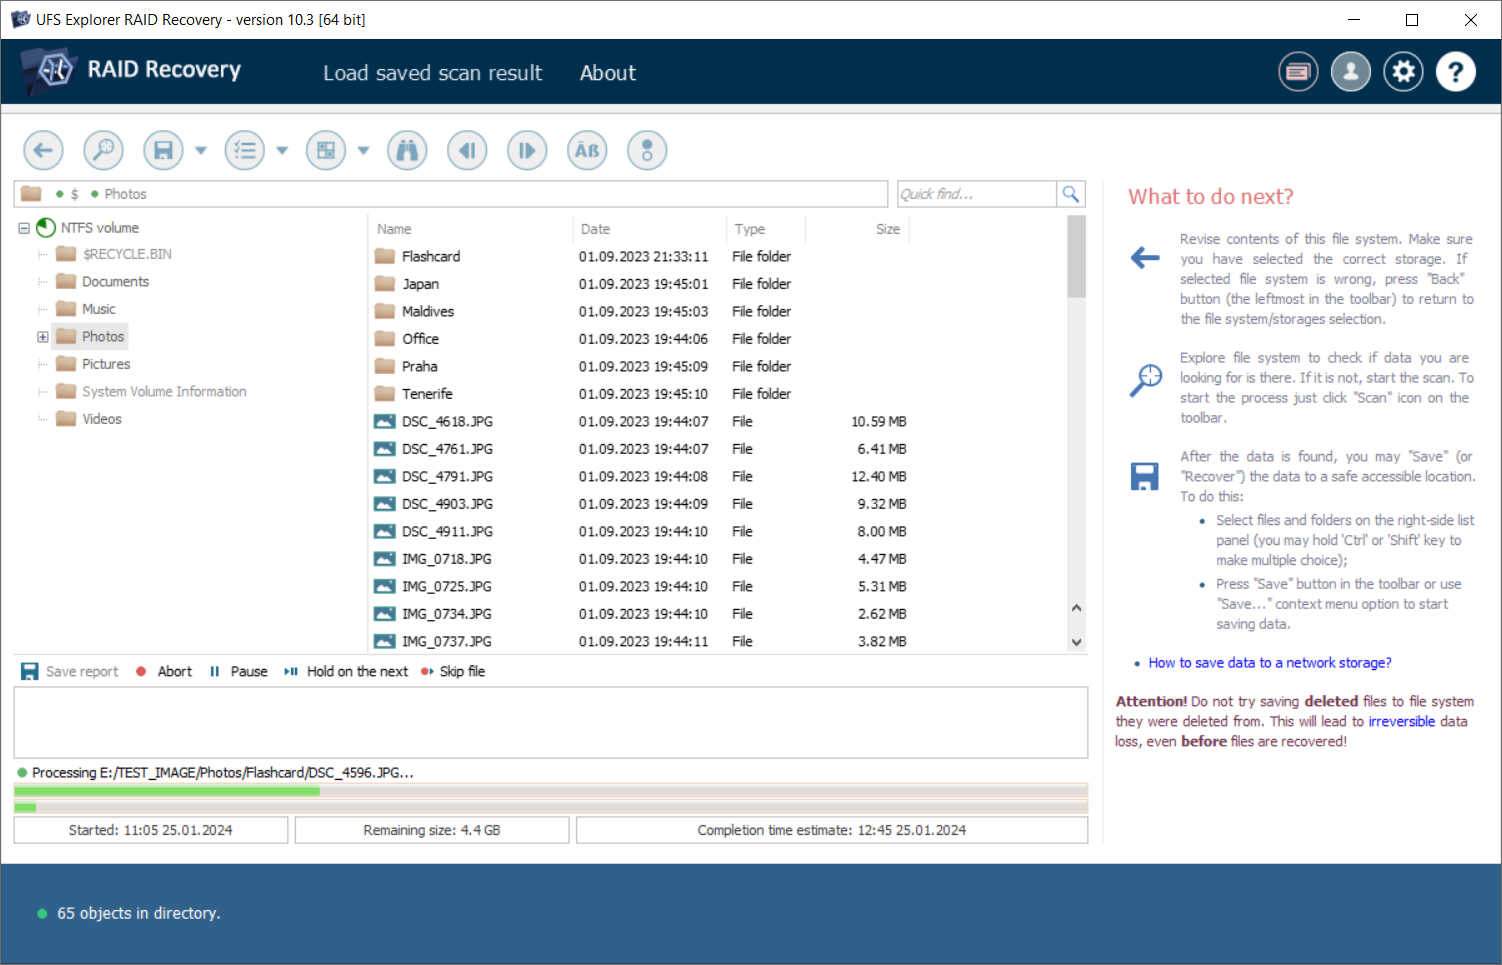
När RAID-systemet inte längre är åtkomligt via den ursprungliga styrenheten är ett av de tekniska alternativen att virtuellt återuppbygga arrayen med hjälp av specialiserad programvara . Verktyg som R-Studio låter dig upptäcka fortfarande konsistenta RAID-enheter som om de vore normala volymer, och i mer allvarliga fall skapa virtuella RAID-enheter från diskar eller diskavbildningar.
Funktionsprincipen innebär att man skapar en virtuell RAID-array baserad på fysiska diskar eller deras avbildningskopior , genom att manuellt ange parametrar som antal diskar, blockstorlek, startoffset, RAID-typ (0, 1, 4, 5, 6, 10, JBOD, ZFS RAIDZ, RAIDZ2, etc.) och diskordning. När programvaran har identifierat ett giltigt filsystem presenteras denna virtuella RAID-array som en navigerbar volym från vilken filer kan listas och återställas.
Till exempel, för en enkel RAID 5-array med tre diskar, 64 KB-block och asynkron vänsterparitet, skulle du helt enkelt välja de tre diskarna i rätt ordning , ange blockstorleken, ställa in lämplig offset och låta verktyget identifiera partitionen. Därifrån kan du öppna volymen, granska mapparna, förhandsgranska filer (särskilt stora) och verifiera att strukturen har monterats korrekt.
I mer komplexa konfigurationer, som en RAID 5 med 4KB-block och ett anpassat paritetsmönster, måste en blockordningstabell definieras manuellt . Detta innebär att man rad för rad anger vilken disk som innehåller varje data- eller paritetsblock, vilket säkerställer att sekvensen är konsekvent. Programvaran varnar dig när den upptäcker inkonsekvenser i denna tabell så att de kan korrigeras innan ändringarna tillämpas.
En viktig försiktighetsåtgärd är att dessa virtuella RAID-enheter är rent logiska objekt i programvaran : de skriver ingenting till de ursprungliga diskarna från vilka de skapades. Detta gör att du kan experimentera med olika parameterkombinationer tills du hittar den som korrekt återuppbygger filsystemet utan att riskera ytterligare skador.
I de fall där en fysisk disk saknas, tillåter vissa verktyg dig att ersätta den med en "saknad disk" eller ett tomt block med utrymme, vilket simulerar beteendet hos en degraderad RAID. Ändå måste alla parametrar vara korrekta för att filåterställning ska vara tillförlitlig; en enda felaktig blockstorlek eller en felberäknad offset kan skada de extraherade filerna, därav vikten av teknisk expertis.
RAID-typer och deras beteende vid dataförlust
Utöver de klassiska RAID-nivåerna stöder dagens RAID-system en mängd olika hybrid- och linjära konfigurationer . Var och en av dem presenterar distinkta utmaningar när det gäller att återställa data efter ett kritiskt fel.
I en RAID 0-array (pure striping) fragmenteras data i små grupper som skrivs sekventiellt till alla diskar i arrayen. Den totala kapaciteten är summan av alla diskar, men det finns ingen redundans av något slag . Om en av diskarna går sönder blir hela volymen oanvändbar, och det enda återställningsalternativet involverar avancerade tekniker som försöker rekonstruera vad som kan göras från de överlevande diskarna.
RAID 1 behåller alltid identiska kopior av all data på varje disk i spegeln . Denna enkelhet är en stor fördel i återställningsprocesser, eftersom om en av diskarna förblir intakt kan dess data nås direkt som om det vore en oberoende disk, eller så kan dess innehåll kopieras till en ny enhet och spegeln återskapas senare.
I RAID-nivåer som RAID 4 och RAID 5, där paritet fördelas olika, är den användbara kapaciteten vanligtvis summan av alla diskar minus kapaciteten hos bara en. Behovet av att matematiskt rekonstruera en disks data från paritet är det som komplicerar återställningen när fel inträffar sekventiellt och fler diskar förloras än vad designen tillåter.
Linjära konfigurationer eller JBOD-konfigurationer (Just a Bunch Of Disks) grupperar flera diskar av samma eller olika storlek för att bilda en enda, större logisk enhet utan att distribuera data parallellt. De erbjuder inga signifikanta prestandaförbättringar eller redundans: om någon disk slutar fungera förloras åtkomsten till hela volymen . Återställning i dessa fall innebär att arbeta på varje disk och manuellt rekonstruera innehållet från de opåverkade segmenten.
Alla dessa scenarier belyser att, oavsett hur avancerad lagringsteknik är, är externa och verifierade säkerhetskopior fortfarande viktiga . RAID minskar eller eliminerar driftstopp vid vissa fel, men det skyddar inte mot oavsiktliga raderingar, logisk korruption, attacker med skadlig kod eller konfigurationsfel som förstör information på filsystemnivå.
Viktiga tips för att minimera risker och skydda dina data
Den första rekommendationen, hur uppenbar den än må verka, är att upprätthålla en regelbunden säkerhetskopieringspolicy som inte förlitar sig på själva RAID-systemet. Detta inkluderar servrar, arbetsstationer, smartphones, NAS-system och alla andra enheter där värdefull data lagras. Endast på detta sätt, i händelse av ett allvarligt fel, kan tjänsten återställas utan att vara beroende av hur framgångsrik en kriminalteknisk återställning blir.
Om en incident ändå inträffar och det inte finns någon användbar säkerhetskopia, är det klokaste att undvika alla försök till en gör-det-själv-reparation utan en tydlig förståelse för stegen och deras potentiella konsekvenser. Innan du kör reparationsverktyg för filsystemet, initierar automatiska ombyggnader eller byter hårddiskar mellan fack, är det lämpligt att rådgöra med specialister på dataåterställning och förklara situationen för dem i detalj.
Det är också viktigt att vara uppmärksam på tidiga tecken på fel : diskar som börjar visa omallokerade sektorer, styrenheter som genererar varningar, systemloggar med I/O-varningar, lagringsarrayer som markerar en array som degraderad... Att ignorera dessa symtom på grund av lathet eller rädsla för att stoppa tjänsten är vanligtvis upptakten till ett mycket allvarligare och mer kostsamt fel.
Slutligen, när informationen är värdefull, är det värt att i förväg identifiera en pålitlig leverantör av dataåterställning . När det är dags förkortar en direkt kontakt svarstiderna, ger dig möjlighet att få exakta instruktioner från början och ökar sannolikheten för att återställa så mycket data som möjligt.
Erfarenheten från otaliga fall visar att kombinationen av en lämplig RAID-design, pålitliga säkerhetskopior, en lugn reaktion på fel och specialiststöd vid behov är det som verkligen gör skillnaden mellan en kontrollerad skrämsel och en katastrofal dataförlust.