- Ang VibeVoice ay isang modelo ng Microsoft TTS na may kakayahang lumikha ng mahaba, makahulugan, at multi-speaker na audio, na mainam para sa mga podcast at audiobook.
- Pinagsasama ng arkitektura nito ang mga speech tokenizer, isang malaking modelo ng wika, at diffusion upang makamit ang natural na mga boses kahit sa mga audio recording na hanggang 90 minuto ang haba.
- Pinapayagan nito ang halos real-time na mga tugon na may kaunting mga pagkakaiba-iba, ngunit nangangailangan ng responsableng paggamit dahil sa mga panganib ng voice cloning at deepfake.
- Ito ay inilabas bilang isang open source research framework, bagama't pansamantalang nilimitahan ng Microsoft ang repository dahil sa mga pangamba tungkol sa maling paggamit.

Ang pagdating ng VibeVoice ng Microsoft ay lubos na nagbabago sa paraan ng paglikha ng mga podcast at mahahabang audio content gamit ang artificial intelligence. Ang open-source na modelong TTS (text-to-speech) na ito ay hindi lamang nakakabuo ng mga hyper-realistic na boses, kundi nagbibigay-daan din sa paggawa ng mga pag-uusap na may maraming speaker at mga tagal na maaaring umabot ng hanggang 90 minuto nang walang awkward na pagbawas o pagbaba sa kalidad.
Ang layunin ng VibeVoice ay magbigay sa sinuman ng isang virtual recording booth na may kakayahang propesyonal na gumawa ng mga podcast, audiobook, o mga naratibo mula sa isang computer. Ang kailangan mo lang ay isang script at ilang pangunahing teknikal na kaalaman upang maitayo ang modelo, at ang AI na ang bahala sa iba pa: intonasyon, pagiging natural, mga pagbabago ng boses, at pagpapatuloy sa buong audio.
Ano ang VibeVoice at bakit ito napakahalaga para sa mga podcast?
Ang modelo ay batay sa teknolohiyang TTS (Text-to-Speech), ibig sabihin ay direkta nitong binabago ang teksto tungo sa pagsasalita , ngunit may antas ng kahusayan at nuance na halos kapareho ng pagsasalita ng tao. Ang VibeVoice ay unang inilabas sa mga bersyon na may mga parameter na 1.5B at 7B , na idinisenyo upang balansehin ang kalidad at ang kakayahang makabuo ng mahahabang audio stream nang walang labis na pagkonsumo ng mapagkukunan.
Isa sa mga pinakamalaking kalakasan nito ay ang kakayahang patuloy na mag-record ng hanggang 90 minutong audio , na nagpapanatili ng pagkakapare-pareho ng boses at intonasyon sa kabuuan. Ginagawa nitong lalong kapaki-pakinabang ito para sa mga buong podcast, mga kabanata ng audiobook, o mahahabang episode ng nilalamang pang-edukasyon kung saan dati ay kinakailangan ang maraming sesyon ng pagre-record gamit ang mga voice actor na tao.
Bukod pa rito, ang VibeVoice ay dinisenyo upang humawak ng hanggang apat na magkakaibang boses sa isang audio recording , na nagbibigay-daan sa mga kunwang panayam, mga talakayan sa panel, mga diyalogo sa pagitan ng mga karakter, o mga episode na isinalaysay ng iba't ibang voice actor. Ang kakayahang ito na may maraming speaker ay susi upang gawing mas dynamic at nakakaengganyo ang mga podcast na pinapagana ng AI.
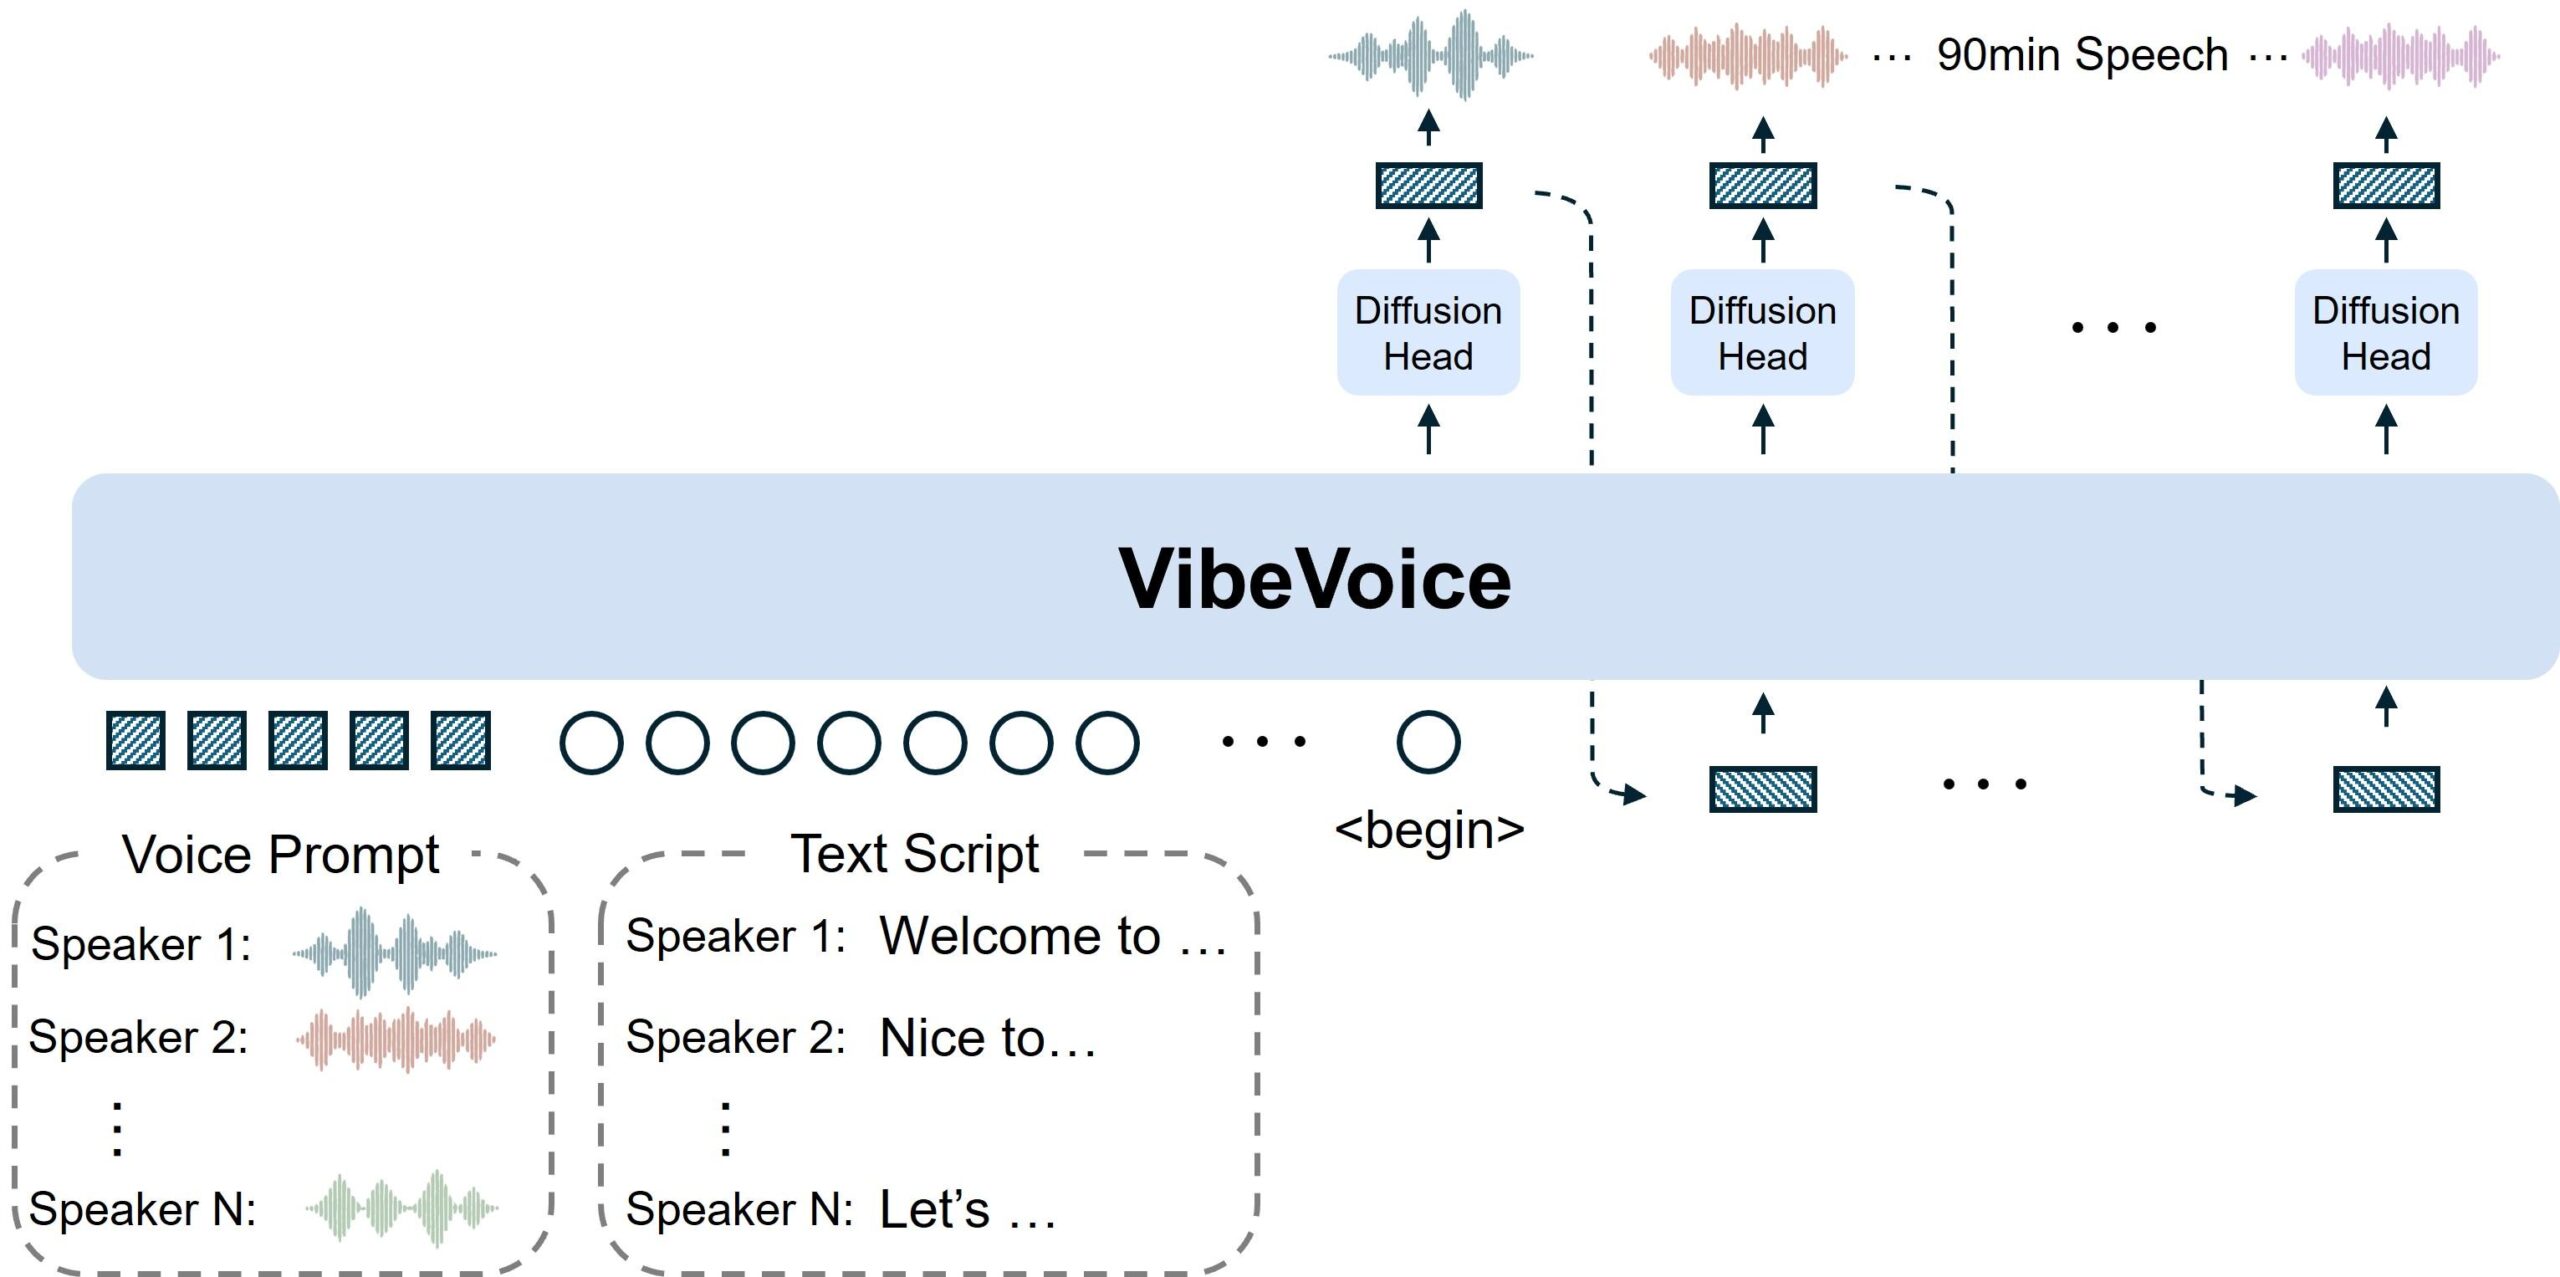
Paano gumagana ang VibeVoice: advanced speech synthesis at mababang latency
Bukod sa nakakaakit na headline, ang nagpapatangi sa VibeVoice ay ang teknikal na arkitektura nito na idinisenyo para sa mahahabang audio recording at mga pag-uusap . Pinagsasama ng Microsoft ang ilang bahagi upang gawing natural ang tunog ng boses, umangkop sa teksto, at mabuo nang direkta o halos real-time.
Gumagamit ang sistema ng mga tuloy-tuloy na acoustic at semantic speech tokenizer na gumagana sa napakababang frequency, humigit-kumulang 7,5 Hz. Nangangahulugan ito na pinapaikli nito ang impormasyong audio sa mas kaunting "hakbang" bawat segundo kaysa sa ibang mga modelo, na pinapanatili ang katapatan ng tunog habang makabuluhang binabawasan ang gastos sa pagkalkula kapag nagtatrabaho sa mahahabang sequence.
Bukod sa naka-compress na representasyong ito, isang malaking modelo ng wika (LLM) ang ginagamit, na siyang responsable sa pagbibigay-kahulugan sa nilalaman ng iskrip, sa daloy ng usapan, at kung sino ang nagsasalita sa anumang oras. Sa ganitong paraan, nauunawaan nito kung ito ay isang tanong, isang sagot, isang ironic na komento, o isang pagbabago ng paksa, at inaangkop ang output ng boses nang naaayon.
Panghuli, isang diffusion head ang ginagamit upang muling buuin ang mga de-kalidad na detalye ng acoustic: timbre, tekstura ng boses, banayad na paghinga, at iba pang mga nuances. Tinitiyak ng kombinasyong LLM + diffusion na ito na ang nagreresultang audio ay pare-pareho, nagpapahayag, at kaaya-ayang pakinggan sa mahabang panahon.
Kasabay nito, inilunsad ng Microsoft ang isang partikular na variant na tinatawag na VibeVoice-Realtime-0.5B , na idinisenyo para sa napakabilis na mga tugon: ang modelong ito ay maaaring magsimulang maglabas ng boses humigit-kumulang 300 milliseconds pagkatapos matanggap ang teksto. Ibig sabihin, halos real time, mainam para sa mga voice agent, conversational assistant, o mga application kung saan dapat minimal ang latency.
Mga magagamit na bersyon: mga modelo, mga parameter at mga inirerekomendang gamit
Sa loob ng VibeVoice ecosystem, maraming bersyon ang ipinakilala na may iba't ibang laki at oryentasyon ng modelo , na idinisenyo para sa parehong mahahabang audio at mga interactive na aplikasyon.
Sa isang banda, mayroon tayong mga pangunahing variant na may mga parameter na 1.5B at 7B , na idinisenyo upang pangasiwaan ang malawak na nilalaman tulad ng mga kumpletong podcast, kunwaring programa sa radyo, mga kabanata ng audiobook, o mga kurso sa audio. Ang mas mataas na bilang ng mga parameter ay nagbibigay-daan para sa mas malaking kapasidad na makuha ang mga nuances at pamahalaan ang mga kumplikadong diyalogo, bagama't pinapataas din nito ang mga pangangailangan sa hardware.
Sa kabilang banda, inuuna ng bersyong VibeVoice-Realtime-0.5B ang bilis ng pagtugon kaysa sa laki ng modelo. Bagama't mayroon lamang itong 0,5B na mga parameter , isang katamtamang halaga kumpara sa mga higanteng tunog tulad ng ChatGPT o Gemini, ito mismo ang nagbibigay-daan dito upang makabuo ng hanggang 90 minuto ng tuluy-tuloy na audio habang pinapanatili ang malinaw na boses at matatag na intonasyon.
Ang real-time variant na ito ay lalong kaakit-akit para sa mga voice agent, chatbot, virtual assistant , at anumang application kung saan inaasahan ng user na ang AI ay agad na tutugon gamit ang boses sa halip na text lamang. Dahil sa mga latency na malapit sa 300 ms, ang karanasan ay halos kapareho ng pakikipag-usap sa isang tao sa kabilang linya.
Sa lahat ng pagkakataon, ang modelo ay inilaan para sa paggamit mula sa mga lokal o pananaliksik na kapaligiran , dahil sa simula ay nagpasya ang Microsoft na ilabas ito bilang isang open source na proyekto, na maa-access mula sa GitHub at mga platform tulad ng Hugging Face, na ginagawang madali para sa komunidad na subukan ito, iakma ito, at bumuo ng mga tool sa ibabaw nito.
Mga praktikal na aplikasyon: kung paano gumawa ng podcast gamit ang VibeVoice
Isa sa mga pangunahing aplikasyon ng VibeVoice ay walang dudang ang paglikha ng mga podcast nang hindi nangangailangan ng mga voice actor na tao . Para sa sinumang may mga ideya, script, o nakasulat na nilalaman, ngunit hindi nangangahas na humarap sa mikropono, ang modelong ito ay nagbubukas ng isang malaking pagkakataon.
Ang pangkalahatang daloy ng trabaho para sa paggawa ng podcast gamit ang VibeVoice ay karaniwang kinabibilangan ng paghahanda ng isang mahusay na istrukturang iskrip : panimula, mga bloke ng nilalaman, mga potensyal na panayam (totoo o kathang-isip), mga transisyon, at pagtatapos. Kung mas malinaw ang teksto, mas mahusay na makukuha ng modelo ang mga pagbabago sa tono, mga paghinto, at ang mga papel ng bawat "tao" sa pag-uusap.
Pagkatapos, gamit ang mga tool na binuo batay sa modelo (mga script, graphical interface, o mga integrasyon sa iba pang app), ang bawat bahagi ng teksto ay itinatalaga sa isa sa mga available na speaker . Halimbawa, maaari nating gamitin ang isang boses para sa presenter, isa pa para sa isang paulit-ulit na bisita, isa pa para sa mga tanong na binasa mula sa audience, at pang-apat para sa mga informational note o mga sponsored segment.
Ang modelo ay bumubuo ng tuluy-tuloy na audio habang nirerespeto ang pagkakasunud-sunod ng script, mga transisyon ng boses, at ang ritmo ng pag-uusap. Mula roon, maaaring pinuhin ang resulta sa isang tradisyonal na audio editor, pagdaragdag ng musika sa background, mga sound effect, mga transisyon, o paggawa ng maliliit na pagsasaayos sa volume at equalization.
Dahil sa kakayahang makabuo ng hanggang 90 minutong nilalaman nang hindi nawawala ang pagkakaugnay-ugnay (coherence) , makakalikha tayo ng isang kumpletong episode nang sabay-sabay: hindi na kailangang mag-record nang paunti-unti o mag-alala tungkol sa pagkapagod ng boses, mga pagkakamali sa diksyon, o ingay sa background, isang bagay na palaging nakakasakit ng ulo kapag nasa isang pisikal na booth.
Pag-clone ng boses gamit ang AI at pag-personalize ng boses
Isa sa mga pinaka-sensitibo ngunit makapangyarihang pagsulong sa teknolohiyang ito ay ang "voice cloning" o AI-powered voice cloning . Kabilang dito ang mga pamamaraan ng synthesis batay sa deep learning na nagbibigay-daan sa pagkopya ng timbre, mga pattern ng pagsasalita, at mga nuances ng isang partikular na boses.
Sa pagsasagawa, sinusuri ng mga sistemang ito ang mga natatanging katangian ng target na boses, tulad ng timbre, mga pormante, ritmo ng pagsasalita, at mga prosodikong padron (mga paghinto, mga impit, intonasyon ng tanong, atbp.). Sa pamamagitan lamang ng ilang segundo ng sample, nagagawa nilang bumuo ng isang sintetikong boses na halos kapareho ng orihinal.
Sa kaso ng VibeVoice, nabanggit na posibleng makamit ang mga tumpak na simulation sa loob lamang ng 10 segundo ng orihinal na audio , na mahusay na nakukuha ang emosyonal na epekto at tekstura ng boses. Para sa isang podcast, nagbubukas ito ng mga posibilidad tulad ng pagpapanatili ng "boses ng tatak" kahit na tumigil na sa pagre-record ang totoong tao, o paglikha ng mga paulit-ulit na karakter na may pare-parehong pagkakakilanlan sa boses.
Gayunpaman, ang kakayahang ito ay may kaakibat na napakalubhang etikal na panganib at ang pangangailangan para sa pagtuklas ng sintetikong audio :
Dahil dito, binibigyang-diin ng Microsoft na ang VibeVoice ay inilalabas sa loob ng balangkas ng pananaliksik at may malinaw na mga babala: hindi ito dapat gamitin para sa pagnanakaw ng pagkakakilanlan, pandaraya, manipulasyon, o mga kampanya ng disinformation. Ang responsableng paggamit ay isang mahalagang bahagi ng buong ecosystem na ito.
Mga kalamangan para sa mga tagalikha ng nilalaman at maliliit na proyekto
Gamit ang isang kompyuter na kayang patakbuhin ang modelo at kaunting oras para magsulat ng mga script, posibleng gawing propesyonal na audio ang mahahabang teksto sa loob lamang ng ilang minuto. Nalalapat ito sa mga nakapagbibigay-kaalamang podcast, mga news bulletin, mga kathang-isip na kuwento, mga serialized na nobela, o maging sa mga naisalaysay na teknikal na manwal.
Malaking tulong din ito sa pag-recycle ng mga umiiral nang nakasulat na nilalaman : ang mga artikulo sa blog, newsletter, thread sa social media o mga ulat ay maaaring gawing mga audio episode na magpapalawak sa abot ng mensahe at mag-aalok ng mas maginhawang paraan para sa mga mas gustong makinig kaysa magbasa.
Isa pang bentahe ay ang pagkakapare-pareho ng kalidad sa paglipas ng panahon . Bagama't maaaring baguhin ng isang taong voice actor ang kanilang enerhiya, intonasyon, o kalinawan depende sa araw, pinapanatili ng AI ang isang pare-parehong antas, na nagpapadali sa serial production: maraming episode na naitala sa isang take ang magpapanatili ng parehong presensya at istilo ng boses.
Sa larangan ng edukasyon, ang VibeVoice ay perpektong akma para sa mga kurso sa audio, mga gabay na babasahin, at mga materyales na madaling ma-access para sa mga taong may kapansanan sa paningin o sa mga mas gustong matuto sa pamamagitan ng pakikinig habang gumagawa ng iba pang mga gawain. Ang kakayahang lumikha ng mga pasalitang bersyon ng mga aralin o mahahabang dokumento ay nag-aalok ng maraming posibilidad.
Mga panganib, limitasyon, at desisyon ng Microsoft patungkol sa repositoryo
Ang kabilang panig naman ng barya ay ang AI na may kakayahang gayahin ang mga boses ng tao at makabuo ng makatotohanang pananalita ay nagdudulot ng malubhang alalahanin sa etika at seguridad. Totoo ang panganib ng malisyosong paggamit, at lalong nalalaman ito ng mga pangunahing kumpanya ng teknolohiya.
Sa mismong teksto ng paglulunsad, tahasang sinabi ng Microsoft na ang VibeVoice ay hindi dapat gamitin para sa mga deepfake, pagnanakaw ng pagkakakilanlan, o mga ilegal na aktibidad . Direktang ipinagbabawal din nito ang paggamit nito sa mga konteksto ng disinformation o pandaraya, dahil ang antas ng realismo nito ay madaling makalinlang sa mga walang kamalay-malay na tagapakinig.
Bagama't lubos na nakakakumbinsi ang boses na nalilikha nito, itinuturo ng mga tagalikha ng modelo na hindi pa rin nito nakukuha ang lahat ng mga detalye ng isang tunay na boses ng tao : ang mga paghinga, mga maliliit na pagkakaiba-iba ng emosyon, ilang natural na paghinto, at mga pagbabago sa ritmo ay mas mayaman pa rin sa isang tao kaysa sa AI. Ang "kawalang-kasakdalan" na ito ay maaaring makatulong, sa isang bahagi, upang matukoy na tayo ay nakikitungo sa isang sintetikong boses, ngunit ang linya ay lalong nagiging malabo.
Kasunod ng paglabas ng proyekto bilang isang open-source research framework , nakakita ang Microsoft ng mga pagkakataon kung saan ginagamit ang modelo sa mga paraang hindi naaayon sa orihinal nitong layunin at mga prinsipyo ng responsableng paggamit. Bilang tugon, inanunsyo ng kumpanya na napilitan itong pansamantalang i-disable ang repository hanggang sa matiyak nito na hindi na maaaring mangyari ang mga paggamit na ito na hindi sakop ng saklaw.
Binibigyang-diin ng pahayag na ang responsableng paggamit ng AI ay isang pangunahing prinsipyo para sa Microsoft , at mas gusto nilang huminto at suriin ito kaysa magpanatili ng isang tool na maaaring magdulot ng malubhang pang-aabuso. Gayunpaman, ang dokumentasyon, mga demo, at mga teknikal na materyales ay nagsilbi nang inspirasyon sa komunidad at patuloy na isulong ang larangan ng speech synthesis.
Iba pang mga aplikasyon bukod sa podcasting
Bagama't pangunahing nakatuon ang atensyon ng media sa mga podcast, nagbubukas ang VibeVoice ng malawak na hanay ng mga gamit sa mundo ng AI-generated audio. Marami sa mga ito ay akma rin sa mga digital na nilalaman at mga estratehiya sa automation.
Isa sa mga pinakahalatang halimbawa ay ang mga audiobook at mga kuwentong isinalaysay , kung saan napakahalaga ang pagkakaroon ng mga nagpapahayag na boses na kayang makaagaw ng atensyon sa loob ng sampung minuto. Ang kakayahan ng multi-speaker ay nagbibigay-daan sa bawat karakter na magkaroon ng sarili nilang boses, na lubos na nagpapabuti sa karanasan sa pakikinig kumpara sa iisang tagapagsalaysay.
Sa larangan ng mga voice agent at conversational assistant, mainam ang real-time na bersyon ng VibeVoice . Ang isang bot na tumutugon nang may 300 ms na pagkaantala lamang ay mas natural kaysa sa isang bot na tumatagal ng ilang segundo para magsalita, na ginagawang mas maayos ang pakikipag-ugnayan sa customer service, chatbot, o voice interface.
Isa pang lubhang kawili-wiling larangan ay ang awtomatikong nilalaman : ang mga buod ng balita, mga update sa merkado, mga pana-panahong ulat o maging ang mga pagbasa at abiso sa email ay maaaring mabuo nang walang interbensyon ng tao, na nagpapanatili ng isang tinig na naaayon sa imahe ng tatak.
Panghuli, mayroong mas maraming eksperimental na aplikasyon, tulad ng paglikha ng mga kathang-isip na diyalogo, kunwang mga panayam, o mga programang pang-aliw na nilikha nang buo sa pamamagitan ng AI . Dito, ang mga modelo ng wika para sa pagsulat ng iskrip ay pinagsama sa VibeVoice para sa voice acting, na nagresulta sa mga format na kamakailan ay tila science fiction.
Kung titingnan ang buong sitwasyon, ang VibeVoice ay namumukod-tangi bilang isang mahalagang manlalaro sa bagong alon ng AI-generated audio , na may kakayahang pagsamahin ang mga natural na boses, mga pag-uusap na binubuo ng maraming kalahok, napakahabang audio clip, at halos agarang mga tugon. Kung gagamitin nang responsable at sa loob ng itinakdang etikal na mga hangganan, maaari itong maging isang napakalakas na tool para sa sinumang naghahangad na maglunsad o magpalawak ng isang podcast, gumawa ng mga audiobook, o magdagdag ng mga propesyonal na voiceover sa kanilang mga digital na proyekto nang hindi palaging umaasa sa isang tradisyonal na recording studio.

Talatuntunan
- 1 Ano ang VibeVoice at bakit ito napakahalaga para sa mga podcast?
- 2 Paano gumagana ang VibeVoice: advanced speech synthesis at mababang latency
- 3 Mga magagamit na bersyon: mga modelo, mga parameter at mga inirerekomendang gamit
- 4 Mga praktikal na aplikasyon: kung paano gumawa ng podcast gamit ang VibeVoice
- 5 Pag-clone ng boses gamit ang AI at pag-personalize ng boses
- 6 Mga kalamangan para sa mga tagalikha ng nilalaman at maliliit na proyekto
- 7 Mga panganib, limitasyon, at desisyon ng Microsoft patungkol sa repositoryo
- 8 Iba pang mga aplikasyon bukod sa podcasting