- Канали в Linux дозволяють об'єднувати процеси разом, поєднуючи stdout та stdin, з підтримкою ядра та такими інструментами, як tee, xargs та cpio для складних потоків.
- Ефективний конвеєр CI/CD у Linux залежить від гарного дизайну сцени, інтенсивного використання кешів, незмінних артефактів та паралельного тестування.
- Оптимізація Linux-сервера (процесор, оперативна пам'ять, введення/виведення, Docker) та виконавців Jenkins, GitHub Actions або GitLab Runner є ключем до скорочення часу.
- Інтеграція безпеки, спостережуваності та контролю витрат у конвеєр забезпечує надійне, відстежуване та стійке розгортання у виробничих середовищах.
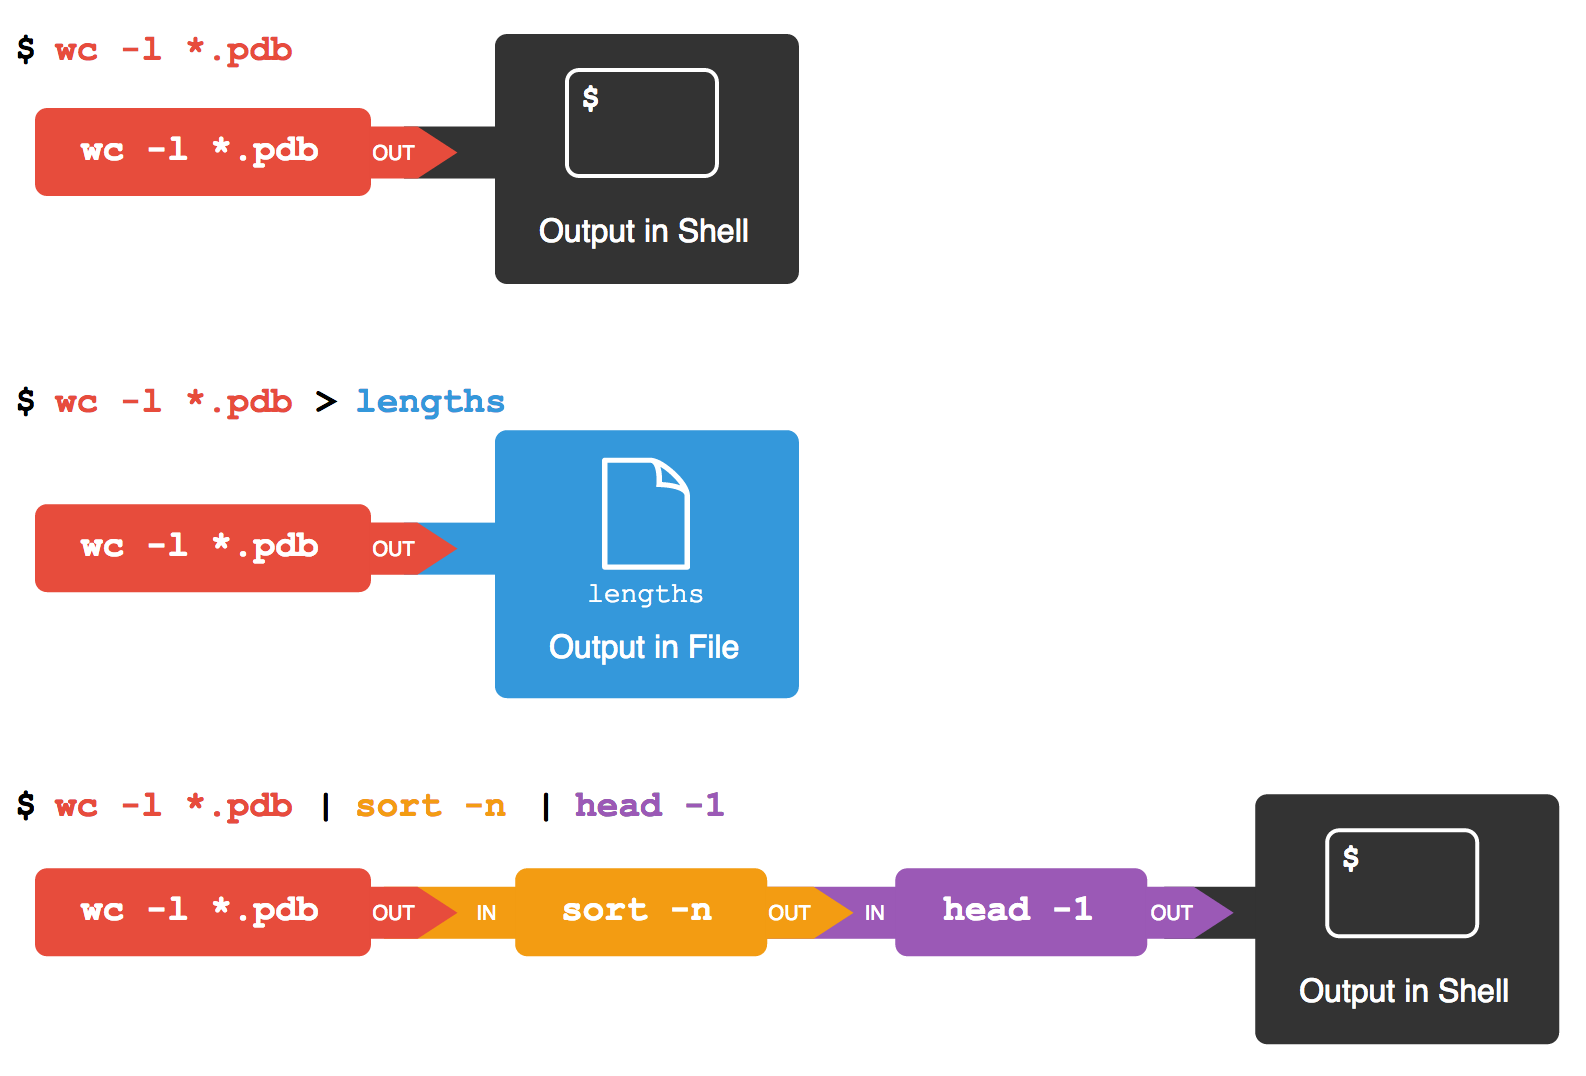
Оптимізація конвеєрів у Linux Йдеться не лише про ланцюжок команд за допомогою символу |За всім цим криється цілий світ оптимізація продуктивностіПроектування робочого процесу, неперервна інтеграція/комп'ютерна інтеграція, безпека та налаштування операційної системи – це вся різниця між повільним, нестабільним конвеєром та тим, який працює безперебійно, надійний та недорогий в обслуговуванні. Якщо ви працюєте з серверами Linux, незалежно від того, чи автоматизуєте завдання в терміналі, чи запускаєте конвеєри безперервної інтеграції, розуміння цих деталей заощадить вам багато часу та зменшить головний біль.
У цій статті ми збираємося поєднати дві взаємодоповнюючі перспективи: з одного боку, Класичне використання каналів (pipes) у командному рядку Linux (канали, перенаправлення, команди типу tee, xargs o cpio); з іншого, в Оптимізація конвеєра CI/CD на серверах LinuxЦе включає кешування, паралелізацію тестів, налаштування Docker, безпеку ланцюга поставок та розширені метрики робочого процесу. Все це пояснюється іспанською мовою (з Іспанії) з чіткими прикладами та дуже практичним підходом.
Що таке конвеєр і як конвеєри вписуються в Linux?
Термін «конвеєр» походить від ідеї каналу : потоку даних, який передається з однієї точки в іншу. В обчислювальній техніці, а саме в Linux, канал — це механізм, який дозволяє стандартному виводу одного процесу стати стандартним вводом іншого. Іншими словами, вивід однієї команди автоматично передається в наступну, не проходячи через проміжні файли.
У Unix-подібних системах існують два основних типи каналів . З одного боку, є анонімні або безіменні канали , які можна використовувати лише між тісно пов'язаними процесами (наприклад, батьківським та дочірнім). З іншого боку, є іменовані канали , також відомі як FIFO (First In – First Out), які дозволяють зв'язок між процесами, які безпосередньо не пов'язані між собою і навіть можуть знаходитися на різних машинах, підключених до мережі.
Анонімні канали зазвичай забезпечують односпрямований зв'язок : один процес записує, а інший читає. На відміну від цього, іменовані канали дозволяють двонаправлений зв'язок , якщо вони спроектовані таким чином, наприклад, відкриваючи FIFO в режимі читання/запису з обох кінців. Вони широко використовуються для координації процесів демонів, скриптів або служб, яким потрібно передавати дані один одному без блокування.
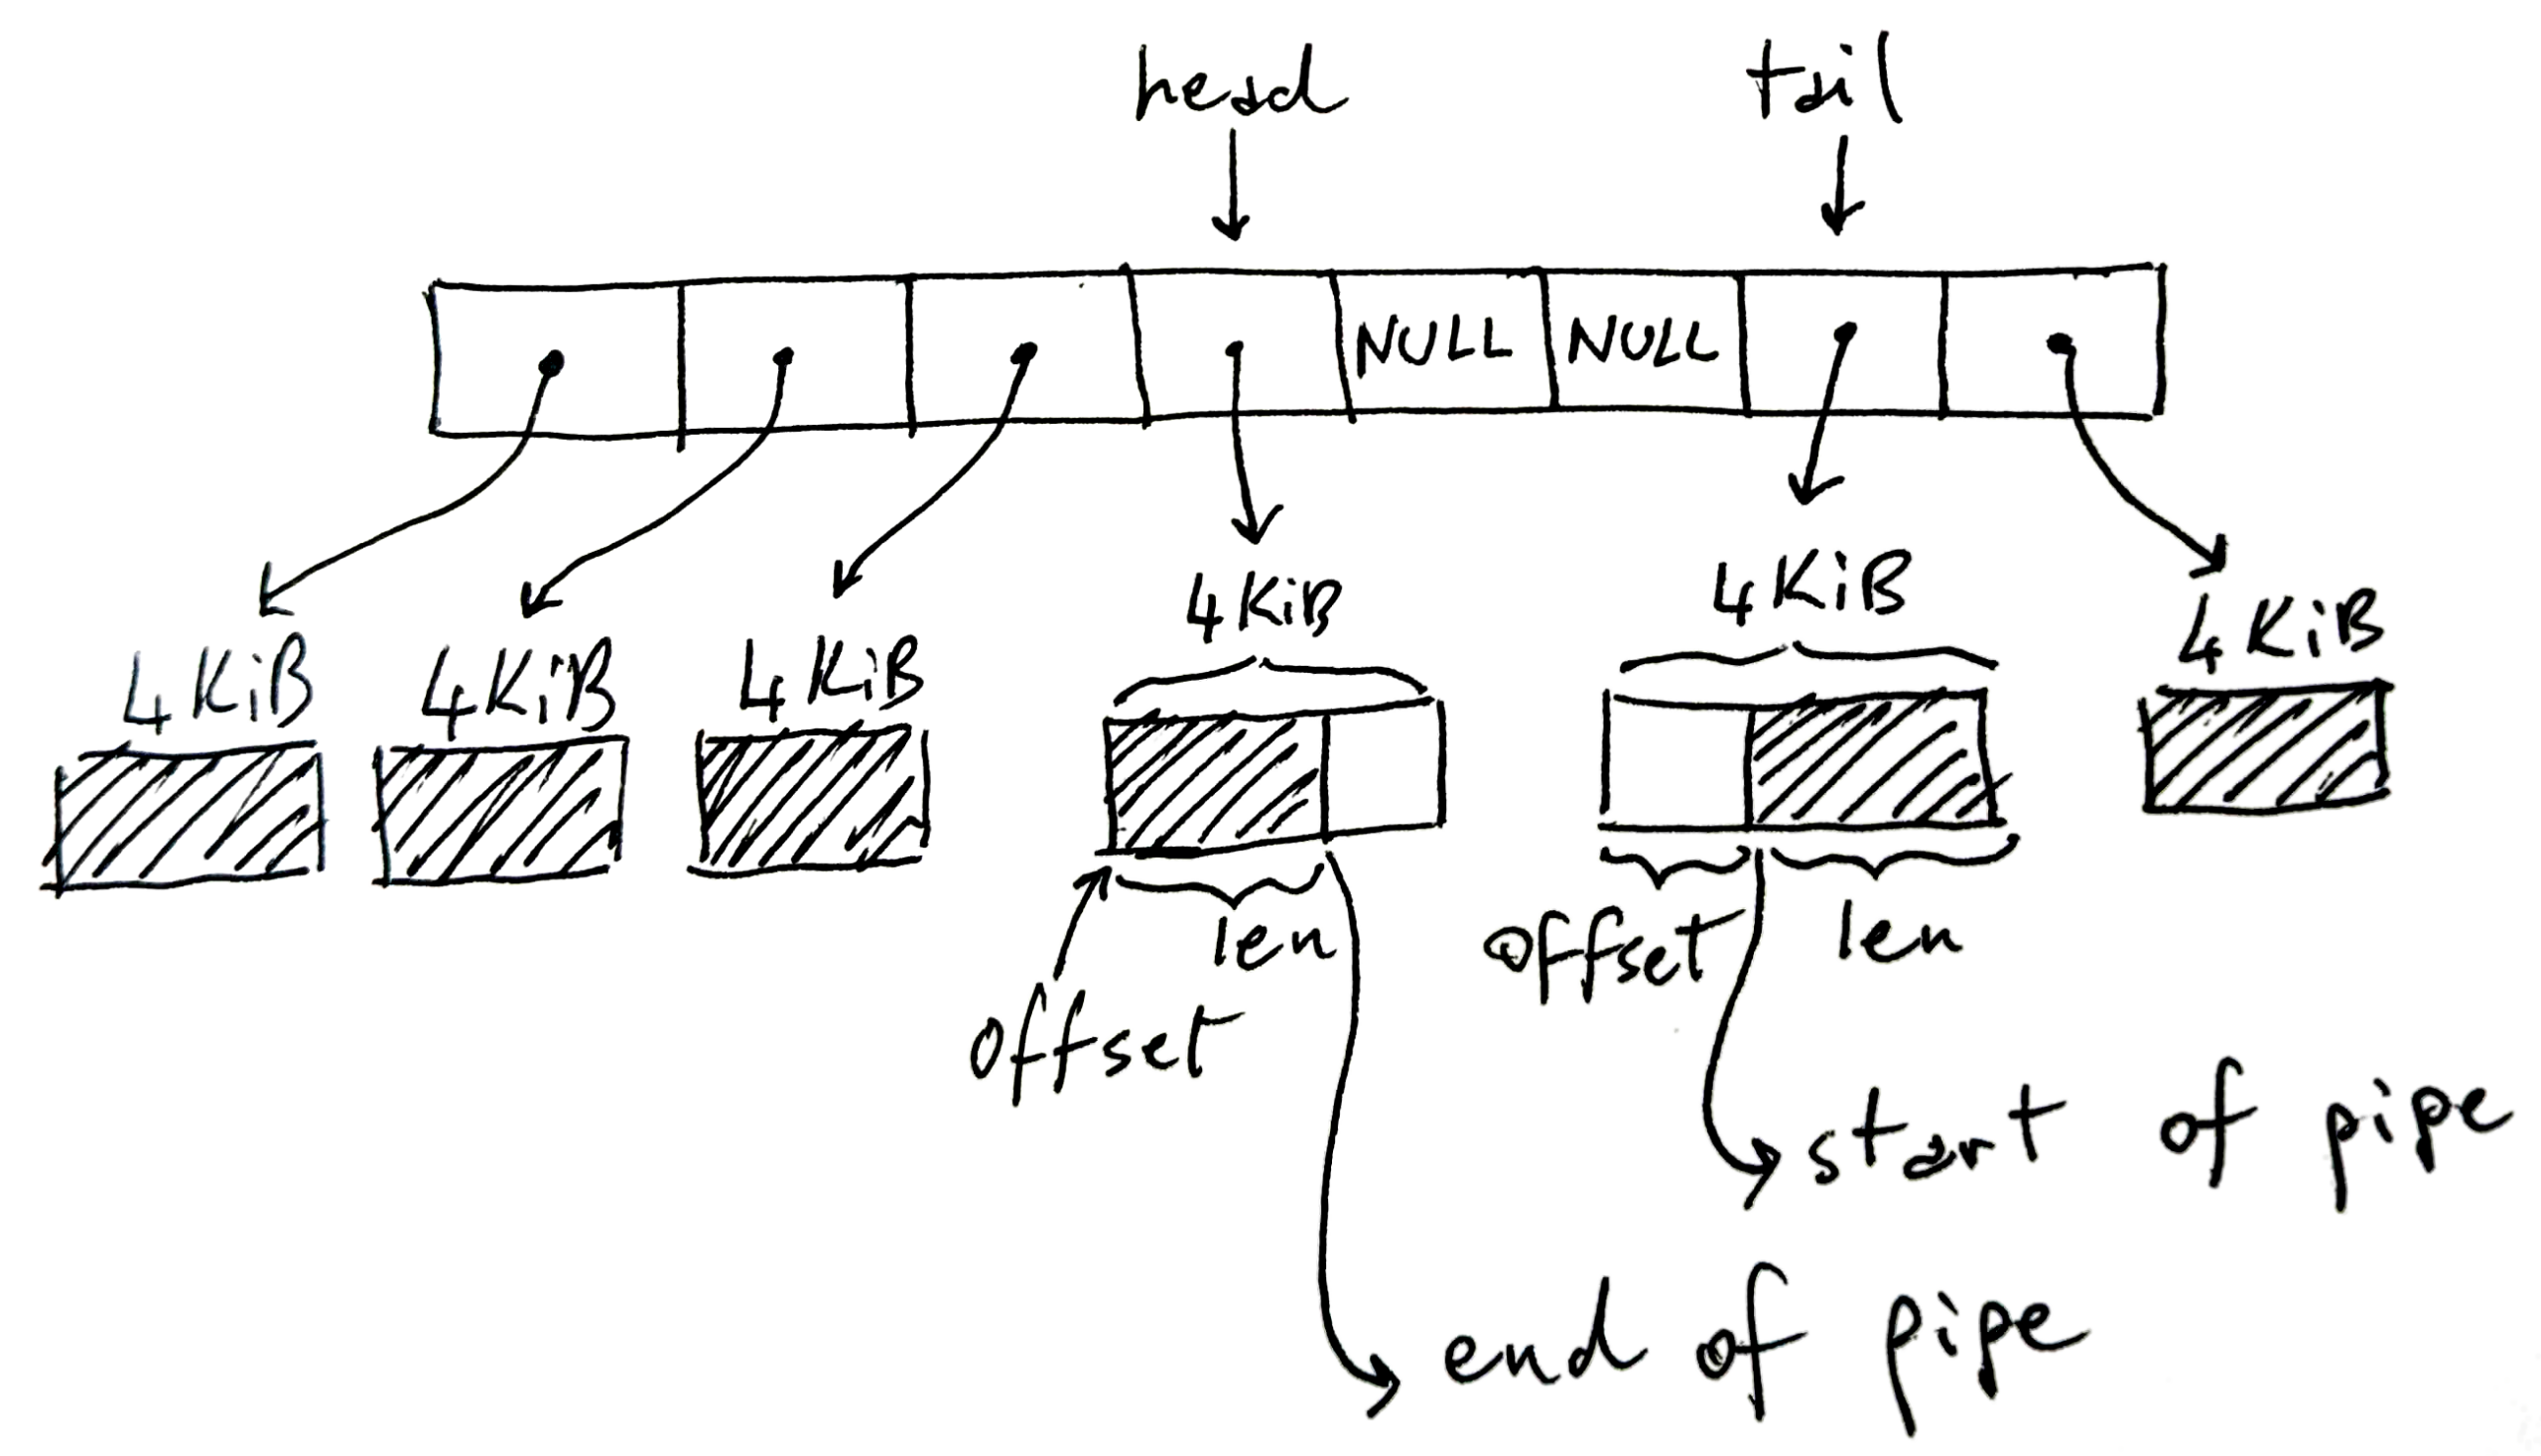
На рівні впровадження підтримка конвеєрів знаходиться в ядро Linuxне в оболонці. Інтерпретатор команд (bash, zsh тощо) просто створює конвеєр за допомогою системних викликів, таких як pipe() y fork()перенаправити файлові дескриптори, а потім запустити кожну програму. Справжня магія блокування процесів, управління буфером та поширення даних між виробником та споживачем здійснюється ядром системи.
Розуміння stdin, stdout та потоку даних
Для ефективної роботи з конвеєрами важливо розуміти, що таке stdin, stdout та stderr . Це не абстрактні поняття: кожен процес у Linux починається з трьох відкритих файлових дескрипторів, які вказують на певні ресурси, якими керує ядро.
stdin (дескриптор 0) та stdout (дескриптор 1) можна розглядати як потоки байтів, підключені до чогось: це може бути термінал, файл, мережевий сокет або канал. Вони є не просто буферами; це посилання на об'єкти ядра ( структури файлового типу ), які, у свою чергу, пов'язані з inode, сокетами або внутрішніми структурами каналів.
Кожен процес має свої власні дескриптори, тому кожна команда в конвеєрі Він переглядає свій stdin та stdout незалежно. У рядку типу ls | grep txt | wc -l, то ls пишіть у трубі, grep Він читає з одного каналу та записує в інший, і wc Зчитується з останнього. Для користувача це виглядає як один рядок, але внутрішньо вони кілька об'єднаних буферів ядрапричому кожен процес блокується та відновлюється залежно від доступного простору або даних.
Коли перший процес створює дані швидше, ніж другий їх споживає, буфер каналу заповнюється. У цей момент наступні операції запису повертаються, блокуючи процес надсилання, доки процес споживання... прочитати достатньо інформації і звільняє місце. Це запобігає неконтрольованому виходу пам'яті з-під контролю; дані не накопичуються нескінченно, якщо не використовувати неблокуючий ввід/вивід або спеціальні сигнали. Наприклад, у такому випадку, як dd if=/dev/sda | gzip -9і gzip стискається повільніше, dd він змушений чекати.
Цей механізм зворотного тиску робить конвеєри досить стабільними навіть за наявності дисбалансу продуктивності між етапами, що також відображається на проектуванні конвеєрів CI/CD , де повільні етапи стають вузьким місцем, яке необхідно вимірювати та оптимізувати.
Практичне використання каналів (pipes) у терміналі Linux
У повсякденному використанні конвеєри використовуються для ланцюжка команд в одному рядку та покрокового перетворення даних. Замість того, щоб виконувати команду, переглядати вивід, копіювати його та вставляти в іншу команду, можна створювати невеликі, дуже гнучкі «фабрики даних» у звичайному тексті.
Типовим прикладом у середовищах Unix є об'єднання команди fortune, який показує випадкові цитати, з cowsayщо друкує "розмовну" корову. Використовуючи вертикальну лінію, Відхід Форчуна стає посланням Коусеявсе в одній команді. Це грайливий приклад, але він чудово ілюструє ідею підключення простих інструментів для складніших завдань.
Ще один класичний спосіб — надіслати результат ls a wc підраховувати рядки, слова та символи. Щось на кшталт ls | wc Це дозволяє швидко побачити, скільки елементів у списку. Перевага полягає в тому, що вам не потрібна одна програма для всього, а радше... Ви створюєте рішення за допомогою невеликих, добре продуманих утиліт..
Також дуже поширене ланцюжок cat, sort y more (або інший пейджер) для сортування текстового файлу, а потім перегляду його сторінка за сторінкою. За допомогою каналу вміст переходить від однієї команди до наступної без збереження у тимчасові файли, що значно спрощує завдання написання сценаріїв та адміністрування.
У практичних випадках, таких як обробка списків студентів та оцінок в окремих файлах, можна використовувати paste об'єднати стовпці, cut щоб вибрати лише ті поля, які вас цікавлять, та з'єднані канали для фільтрації, сортування або перетворення всього в одному рядку скрипта оболонки. Цей шаблон розбити велику проблему на прості команди, поєднані з конвеєрами Це суть філософії Unix.
Розширені команди для максимального використання каналів: tee, xargs та cpio
Коли ви починаєте по-справжньому автоматизувати роботу в Linux, конвеєри стають ще потужнішими завдяки деяким ключовим інструментам. Серед них: tee, xargs y cpioякі дуже добре доповнюють стандартний потік даних.
Команда tee Він діє як літера «Т» у водопровідній трубі: зчитує зі stdin, записує на stdout, а також копіює той самий вивід в один або кілька файлів. Це ідеально, коли вам потрібно переглянути результат на екрані та одночасно зберегти його переглянути його пізніше або обробити на іншому етапі. З можливістю -a Він додає дані в кінець файлу, а не перезаписує його.
Наприклад, ви можете сортувати список за допомогою sortнадішліть результат до tee зберігати його в журналі та одночасно передавати його до more розбити його на сторінки. Таким чином, в одному конвеєрі ви маєте сортування, збереження на диск та зручний перегляд без повторення процесу сортування.
Команда xargs Це ще один фундаментальний елемент, коли йдеться про конвеєри. Його функція полягає в тому, щоб приймати дані, що надходять через stdin (зазвичай список елементів), і перетворювати їх на аргументи для іншої команди. Це особливо корисно, коли програма аварійно завершує роботу через отримання забагато параметрів одночасно, або коли ви хочете... розбити роботу на партії з опцією -n, що обмежує кількість аргументів, що передаються за виконання.
Наприклад, с ls | xargs -n 4 Ви розділяєте список файлів на групи по чотири, виконуючи команду target (за замовчуванням echo(або той, який ви вкажете) кілька разів. Таким чином, ви можете створювати конвеєри, такі як «попередній перегляд того, що я збираюся видалити», комбінуючи ls, xargs y echo rm перед запуском фактичного стирання.
Будьте обережні зі складними вхідними даними: шляхи з пробілами або спеціальними символами може порушити поведінку за замовчуванням xargsУ цих випадках його зазвичай використовують у поєднанні з find і варіант -print0, який розділяє елементи нульовим символом, а також xargs -0 щоб обидва кінці використовували один і той самий надійний роздільник.
Нарешті, cpio Це менш відома команда, ніж tarАле він неймовірно гнучкий для роботи з файловими потоками через канали. На відміну від tar, він розроблений з нуля для роботи з перенаправлення та каналиотримує список файлів через stdin (зазвичай генерується за допомогою find) та створює або використовує файли типу "пакет" без власного стиснення, які потім можна стиснути за допомогою gzip або подібні.
Основні режими cpio дозволити створення файлів (-o), копіювання дерев каталогів (-p) або витягти вміст (-i(часто називається «копіювання»). Такі опції, як -u перезаписати, -m зберегти часові позначки або -d відтворення структури каталогів робить можливим детально контролювати, що копіюється і як, особливо корисно у складних сценаріях, де tar не дотягує.
Проектування та оптимізація конвеєрів CI/CD на серверах Linux
Окрім традиційного командного рядка, концепція конвеєра стала фундаментальною у світі безперервної інтеграції та безперервної доставки (CI/CD) . На сервері Linux конвеєр CI/CD — це автоматизована послідовність кроків: вибірка коду, встановлення залежностей, компіляція, виконання тестів, пакування артефактів та розгортання.
Linux особливо добре підходить для цього, оскільки він вирізняється своєю швидкістю, стабільністю та екосистемою інструментів автоматизації . Такі платформи, як Jenkins, GitHub Actions та GitLab CI, покладаються на виконавці Linux (фізичні машини, віртуальні машини або контейнери) для послідовної роботи конвеєрів.
Оптимізація цих конвеєрів означає не лише забезпечення їхньої «працездатності», але й забезпечення їхньої роботи з мінімальними труднощами. Це означає скорочення часу перевірки, мінімізацію повторюваних установок залежностей, оптимізацію образів Docker для уникнення непотрібних перебудов, повторне використання вже згенерованих артефактів та підтримку безпеки та доступності середовища для спостереження.
Базова гарна практика полягає в структуруванні конвеєра на чітко визначені етапи: збірка, тестування та розгортання . В ідеалі, вам слід компілювати лише один раз, генерувати артефакт (бінарний файл, пакет, образ Docker), який тестується паралельно в різних варіантах (наприклад, різні мовні версії), а потім розгортати той самий артефакт у проміжному та виробничому середовищах без повторної компіляції.
Робота з незмінними артефактами, що зберігаються в репозиторіях (S3, Nexus, Artifactory, реєстрах контейнерів або пакетах, вбудованих у GitLab/GitHub), спрощує аудит, дозволяє швидко відкочувати версії та зменшує ймовірність ситуації, коли «це працює на моїй машині, але не в продакшені».
Необхідні умови: розподіл, захист користувачів неперервної інтеграції та серверів
Перш ніж заглиблюватися в мілісекундну оптимізацію тут і там, важливо створити стабільну основу на сервері Linux , який виступатиме виконавцем CI/CD. Це починається з вибору дистрибутива та мінімальної конфігурації безпеки.
Найрозумнішим підходом зазвичай є стандартизація на основі LTS або стабільного дистрибутива , з яким команда знайома: Ubuntu LTS, Debian Stable або корпоративні альтернативи, такі як AlmaLinux або Rocky Linux. Наявність усіх операційних систем на одній версії запобігає неочікуваній поведінці, спричиненій різними бібліотеками або ядрами між завданнями.
Ще одна рекомендація — налаштувати виділений користувач для CI, без root-прав, з обмеженим доступом до sudo лише необхідними командами (наприклад, systemctl o docker (якщо це дійсно необхідно). Цей користувач повинен пройти автентифікацію за допомогою SSH-ключів, як для доступу до сервера, так і для взаємодії з репозиторіями Git або іншими віддаленими машинами.
На системному рівні доцільно підтримувати сервер оновлений та мінімально посиленийЦе включає застосування оновлень безпеки, налаштування обмежувального брандмауера (наприклад, за допомогою UFW: заборона всього вхідного трафіку, крім необхідного, та дозвіл вихідного трафіку) та активацію таких інструментів, як fail2ban зупинити атаки грубої сили на SSH та налаштувати деякі параметри мережі та ядра через sysctl для покращення надійності та продуктивності.
Наприклад, поширеною є тенденція підвищувати ліміт прищеплювати щоб запобігти вичерпанню ресурсів у системах збірки, які відстежують багато файлів, та налаштувати параметр vm.swappiness щоб зробити ядро більш консервативним під час використання swap, що особливо актуально, коли завдання CI споживають багато пам'яті одночасно.
Кеші, Docker та паралелізація: важелі продуктивності в CI/CD
Якщо подивитися на те, скільки часу насправді витрачається в середньому конвеєрі, то можна побачити, що величезна його частина втрачається під час встановлення залежностей та перебудови образів Docker . Вирішення цієї проблеми зазвичай ефективніше, ніж оптимізація тестового коду на кілька мілісекунд.
Перший важіль – це кешування залежностей . Майже всі менеджери залежностей (pip, npm, Maven, Gradle, модулі Go тощо) використовують локальні каталоги кешу. На постійному сервері Linux ви можете спільно використовувати ці каталоги між завданнями або монтувати їх на постійному тому. Таким чином, кожне виконання не повинно завантажувати половину Інтернету знову.
Для Docker увімкніть BuildKit і добре структурувати Dockerfile Це знаменує собою поворотний момент. Розміщення встановлення залежностей одразу після копіювання файлу вимог і перед рештою коду гарантує повторне використання шарів, якщо версії цих залежностей залишаються незмінними. Крім того, окремі кеші для pip, npm тощо можна налаштувати в самій збірці.
Другий важливий важіль – це паралельне виконання тестівБагато фреймворків нативно підтримують паралельність: pytest з -n autoІнструменти Java, такі як Surefire, Jest у JavaScript з --maxWorkersтощо. Розподіл пакету за модулями, папками або навіть за розрахунковим часом та балансування його між кількома працівниками дозволяє скоротити тривалість фази тестування у 2–5 разів без зміни жодного напрямку діяльності.
Зрештою, є питання артефактів та розгортання . Замість перекомпіляції одного й того ж образу для проміжної, передпродакшн та продакшн-версії, ефективний підхід полягає в одноразовій збірці, збереженні результату в репозиторії та позначенні його відповідно до середовища розгортання. Це зменшує використання процесора, уникає невідповідностей та значно пришвидшує довгі конвеєри.
Оптимізація Jenkins, GitHub Actions та GitLab Runner у Linux
Кожна система неперервної інтеграції має свої особливості, але всі вони мають ті самі основні ідеї під час роботи в Linux. Ключовим є використання тимчасових та чистих виконавців , підтримка постійного кешу належного розміру та контроль паралельності.
У Jenkins поширеною практикою є використання легких тимчасових агентів (таких як контейнери Docker або pods у Kubernetes або інші рішення для оркестрації контейнерів ) для запуску завдань, при цьому головний вузол залишається максимально простим. Ці агенти можна налаштувати як системні служби на серверах Linux, реєструючись у контролері та запускаючись автоматично під час завантаження машини.
Для дій GitHub із самостійно розміщеними запускачами рекомендується розгортати їх у Віртуальні машини Linux зі швидкими SSD-накопичувачамиЩоб створити великий каталог кешу, призначений для дій (залежності від мови, кеші збірки тощо), обмежте кількість одночасних завдань, щоб уникнути перевантаження процесора та диска. Скористайтеся перевагами офіційної дії кешування зі шляхами, такими як ~/.cache/pip, ~/.npm o ~/.m2 Це має величезне значення в часі.
У GitLab Runner вибір між виконавцем оболонки та Docker залежить від необхідного балансу між продуктивністю та ізоляцією. Виконавець оболонки швидший, оскільки він працює безпосередньо на хості, але виконавець Docker пропонує чисті та репліковані середовища. Ви також можете налаштувати спільне кешування (локально або на S3) та регулювати максимальну кількість одночасних завдань, щоб використовувати переваги обладнання, не перевантажуючи його.
У всіх цих випадках наявність спільних томів для кешування залежностей, запобігаючи захаращенню робочих просторів між збірками, є критично важливою. Ефемерні машини або контейнери, які створюються та знищуються з кожним конвеєром або групою конвеєрів, значно зменшують проблеми типу «вчора працювало, а сьогодні ні», спричинені залишками попередніх збірок.
Продуктивність Linux-сервера: процесор, пам'ять, введення/виведення та Docker
Незалежно від того, наскільки оптимізовані ваші скрипти, якщо сервер Linux, на якому працює конвеєр, не має належного розміру, ви зіткнетеся з нескінченними чергами та повільними завданнями. Типова, розумна конфігурація для машини середнього класу — це 4-8 віртуальних процесорів та 8-16 ГБ оперативної пам'яті , з SSD-накопичувачем (в ідеалі NVMe) та деяким простором підкачки (2-4 ГБ) для обробки пікових навантажень без агресивного завершення процесів.
Файлова система також має значення. Використовуйте ext4 або XFS з опцією noatime У томах, де ви компілюєте або записуєте журнали, зменште непотрібні операції вводу-виводу. Крім того, монтування tmpfs для тимчасових файлів або короткочасних артефактів (наприклад, /mnt/ci-tmp) пришвидшує виконання ресурсоємних операцій та запобігає заповненню диска залишковими файлами між завданнями.
Щодо Docker, гігієна демона є ключовою. Безпечне та регулярне видалення невикористовуваних образів і томів, водночас підтримуючи «гарячі» базові образи, допомагає контроль дискового простору та часу завантаженняКоманди типу docker system prune Завдяки відповідним часовим фільтрам вони дозволяють проводити очищення без перевантаження нещодавно використаних ресурсів.
Якщо ваша неперервна інфраструктура (CI) використовує інтенсивні контейнери, ви також можете використовувати дзеркальні регістри , щоб уникнути постійного завантаження з Інтернету, використовувати BuildKit для паралельного виконання та кешування шарів, а також налаштовувати спорідненість процесорів (набори процесорів) або виділені вузли для найвимогливіших виконавців, запобігаючи перешкодам між сусідніми робочими навантаженнями. Крім того, розуміння мікроархітектури процесора допомагає вам краще розподілити ресурси для інтенсивних робочих навантажень CI.
Безпека в процесі розробки (DevSecOps) та розгортання на Linux
Швидкий, але незахищений конвеєр – це бомба уповільненої дії. Інтеграція безпеки в сам конвеєр та безпеку контейнерів Docker зараз є стандартом у будь-якій стратегії DevSecOps, і Linux пропонує багато інструментів для цього.
Перше, що потрібно зробити, це ставитися до секретів та облікових даних з максимальною обережністю . Вони ніколи не повинні знаходитися в коді або у файлах конфігурації з версіями. Натомість вони зберігаються в менеджерах секретів (масковані змінні GitLab, зашифровані секрети GitHub, сховище HashiCorp тощо) та вводяться лише під час виконання завдання, яке їх потребує, використовуючи короткочасні токени, коли це можливо.
Ще одним важливим рівнем є створення SBOM (переліків матеріалів програмного забезпечення) та підписання артефактів. Такі інструменти, як Syft або CycloneDX, дозволяють перерахувати всі компоненти, що складають образ або бінарний файл, тоді як Cosign або інші перевірені рішення для підписання гарантують, що розгортаються лише артефакти, які пройшли через конвеєр та були перевірені.
Що стосується мережі та доступу, доцільно сегментувати мережі непреривчастої інтеграції та виробничі мережі , впроваджувати суворі брандмауери, перевіряти журнали виконання та регулярно змінювати облікові дані. Там, де використовується SSH, краще використовувати сертифікати або ключі з терміном дії, а не статичні паролі.
Під час розгортання в Linux такі стратегії, як Blue/Green, rolling та canary, значно зменшують вплив помилок розгортання. Запуск програми як служби systemd, розміщення Nginx або HAProxy перед нею та контроль трафіку між версіями за допомогою перевірок справності дозволяє досягти практично нульового часу простою під час оновлень.
Наприклад, під час перезавантаження Nginx та перезапуску служб за допомогою systemd з використанням сигналів м’якої зупинки (таких як SIGTERMЗавдяки розумному часу очікування ви можете зупинити активні з’єднання до того, як процес зупиниться, зберігаючи зручність користування під час перемикання версій у фоновому режимі.
Спостережуваність, метрики та витрати в Linux-конвеєрах
Після того, як ваші конвеєри запущено та працюють, наступним кроком є їх вимірювання та розуміння того, куди витрачаються час і ресурси . Недостатньо знати, чи робочий процес успішний чи ні; вам потрібно контролювати тривалість кожного етапу, час очікування в черзі, коефіцієнт успішності, частоту розгортання, коефіцієнт звернень до кешу тощо.
Зазвичай експорт системних показників здійснюється за допомогою node_exporterЦентралізуйте журнали за допомогою таких рішень, як ELK або Loki, та візуалізуйте все на інформаційних панелях Grafana. Таким чином, ви можете виявити, наприклад, чи тривалість фази тестування збільшилася на 30% за останній тиждень, або чи завдання витрачають забагато часу на очікування доступного виконавця; моніторинг мережевого трафіку Інструменти з відкритим кодом доповнюють цю видимість.
Також можна інструментувати сам конвеєр, наприклад, у GitHub Actions або GitLab CI, щоб програмно вимірювати кількість успішних виконань, тривалість кожного запуску та загальний станСкрипт, який викликає API постачальника, обчислює загальну кількість запусків, кількість успішних запусків, кількість невдалих запусків, коефіцієнт успішності та середню тривалість, а також зберігає все у файлі JSON (наприклад pipeline-metrics.json) дозволяє інтегрувати ці показники у звіти або інформаційні панелі.
Маючи цю інформацію, ви можете приймати рішення щодо розміру та кількості раннерів : іноді краще мати більше маленьких раннерів, ніж кілька дуже великих, щоб скоротити час очікування. Автомасштабованість, наприклад, хмарне автомасштабування або динамічні пули вузлів Kubernetes, допомагає поглинати пікову активність протягом дня та мінімізувати недовикористані ресурси вночі.
Ці методи не лише покращують досвід команди, але й допомагають скоригувати витрати на інфраструктуру, контролюючи споживання процесора, пам'яті та особливо сховища, яке, як правило, різко зростає через образи та кеші, якщо їх не очищувати регулярно та за планом.
Оволодіння як класичними конвеєрами командного рядка, так і сучасними конвеєрами CI/CD у Linux пропонує потужне поєднання: ви можете автоматизувати все: від простих завдань фільтрації тексту до складних, зручних, безпечних та швидких конвеєрів збірки, тестування та розгортання. Розуміння того, як інформація передається між процесами, як кешуються залежності, як налаштовуються сервери та як інтегруються метрики та безпека, дозволяє вам створювати робочі процеси, які масштабуються разом з вашою командою та проектами, не стаючи постійним вузьким місцем.
