- Мікроархітектура визначає, як процесор реалізує ISA, та визначає його IPC, внутрішній паралелізм та фактичну ефективність, окрім частоти чи розміру кешу.
- Такі конструкції, як AMD Zen та Zen 2, поєднують оптимізовані кеші, позапорядкове виконання, поверхневе монтажне покриття (SMT) та великі векторні блоки для підвищення продуктивності на цикл та на ват.
- Стратегія чіплетів та Infinity Fabric дозволяє масштабувати кількість ядер в EPYC та Ryzen, зберігаючи при цьому контрольовані витрати та дуже конкурентоспроможну продуктивність.
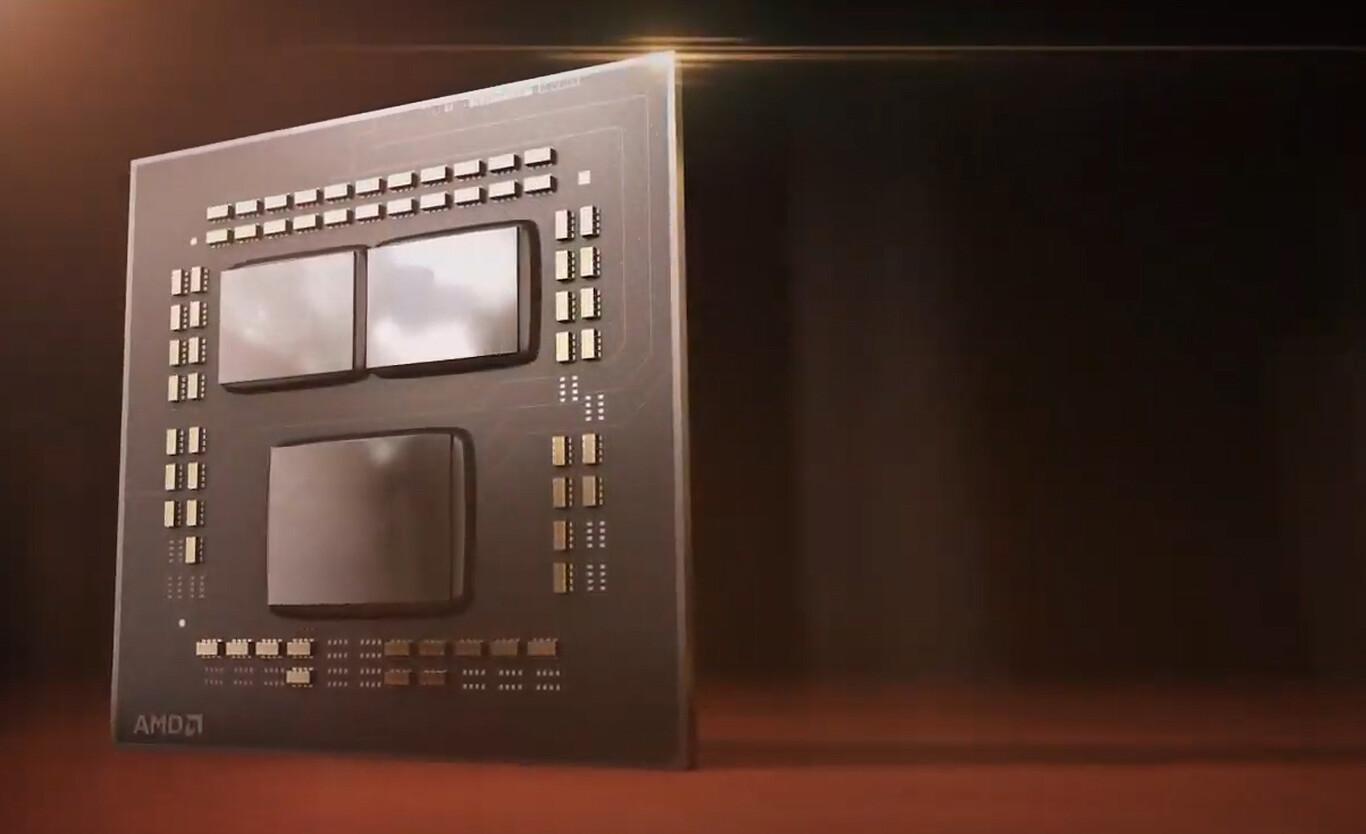
Мікроархітектура процесора часто поступається більш привабливим показникам, таким як ГГц або МБ кешу, але саме там, у внутрішній конструкції процесора, визначається більша частина його реальної продуктивності, його ефективності та навіть те, який тип програмного забезпечення може найкраще її використати.
Коли ви читаєте технічні характеристики, що згадують ядра, потоки, кеш L3 або AVX2 , ви насправді бачите конкретні наслідки певної мікроархітектури. Розуміння того, як ці компоненти організовані внутрішньо, що відрізняє Zen 3 від Zen 2 або гібридний Intel від класичного Ryzen, є ключем до розумного вибору наступного процесора та розуміння того, чому одні досягають успіху в іграх, інші — в рендерингу, а треті — в серверних завданнях.
ISA, макроархітектура та мікроархітектура: впорядкування концепцій
Перш ніж заглиблюватися у складнощі конвеєрів та предикторів, корисно розрізняти три часто змішувані рівні: макроархітектуру системи, ISA та мікроархітектуру . Кожен з них описує окремий рівень комп'ютера.
З одного боку, є макроархітектура, або загальний дизайн системи , який охоплює все, що ви бачите на материнській платі: процесор, контролери пам'яті, шини, основну пам'ять, мікросхеми введення/виведення, контролери пам'яті, будь-які зовнішні прискорювачі та логіку прямого доступу до пам'яті (DMA). Це загальне уявлення про те, як великі апаратні компоненти з'єднуються та як дані передаються між ними.
Вище цього знаходиться ISA (Архітектура Набору Інструкцій) – це набір інструкцій, який розуміє процесор: типи даних, які він обробляє, розмір слова, кількість і тип регістрів, режими адресації, формати інструкцій тощо. Коли ви програмуєте на асемблері, використовуючи мнемоніки, такі як ADD, SUB, MUL , або викликаєте розширення, такі як SSE, AVX або NEON, ви безпосередньо спілкуєтеся з ISA.
Нарешті, у нас є мікрокод, або μISA , який визначає внутрішні мікрооперації, що використовуються деякими складними архітектурами (наприклад, x86) для реалізації своїх CISC-інструкцій. Цей мікрокод можна оновлювати за допомогою прошивки, щоб виправити помилки або додати підтримку нових інструкцій.
Що саме являє собою мікроархітектура процесора?
Мікроархітектура процесора — це, по суті, внутрішній план, який визначає, як виконуються інструкції ISA та як переміщуються дані всередині чіпа. Два процесори можуть використовувати один і той самий ISA (наприклад, AMD64 в Intel та AMD) і все ж мати радикально різну поведінку та продуктивність через — або, можливо, саме через — свою мікроархітектуру.
Цей дизайн включає такі елементи, як тип блоку керування , чи використовується програмований мікрокод, чи апаратно-керована логіка; ієрархія пам'яті; глибина конвеєра; скільки функціональних блоків працюють паралельно; та чи здатний процесор виконувати інструкції не по порядку та спекулятивно.
Крім того, розробник повинен вибрати глибину конвеєра : від простих процесорів без конвеєрної обробки, де кожна інструкція обробляється від початку до кінця перед початком наступної, до сучасних конструкцій з багатьма етапами (вибірка, декодування, перейменування, відправлення, виконання, зворотний запис, виведення на архів…), що дозволяє одночасно виконувати десятки інструкцій.
З цим пов'язана кількість і тип виконавчих блоків : АЛП для цілих чисел, блоки множення, дільники, ФПУ для скалярних і векторних чисел з плаваючою комою, АГУ (блоки генерації адрес) для обчислення адрес пам'яті, блоки переходів тощо. Якщо є кілька блоків одного типу, ми говоримо про суперскалярні процесори, здатні виконувати кілька інструкцій за цикл.
Це основа для таких передових методів, як спекулятивне виконання , де процесор передбачає розв'язання гілки та виконує інструкції з однієї з гілок заздалегідь. Якщо прогноз правильний, час економиться; якщо він невдалий, виконана робота відкидається, а конвеєр спорожняється з відповідним штрафом.
Більшість сучасних високопродуктивних процесорів також використовують виконання поза порядком (OoO) . Замість того, щоб суворо дотримуватися порядку виконання програм, процесор внутрішньо перевпорядковує інструкції та виконує спочатку ті, дані яких готові, уникаючи циклів простою, поки інші чекають на пам'ять або результат попередніх операцій.
Щоб усе це працювало без порушення семантики програми, використовується перейменування регістрів . Компілятор бачить обмежений набір логічних регістрів, але мікроархітектура перетворює їх у більший банк фізичних регістрів, динамічно призначаючи нові пункти призначення, щоб розірвати хибні залежності та забезпечити більший паралелізм.
Зрештою, проектування може зосередитися на додаванні паралелізму на рівні ядра та потоків . Це включає все: від одноядерних процесорів до чіпів з десятками або сотнями ядер (багатоядерні), багатопроцесорні системи з кількома сокетами, з'єднаними між собою високошвидкісними мережевими мережами (Infinity Fabric, Intel Mesh, NVLink тощо), та підтримку одночасної багатопоточності (SMT), щоб кожне фізичне ядро могло обробляти два або більше логічних потоків.
Сумісність, ISA та сімейства мікроархітектур
Оскільки мікроархітектура — це лише одна конкретна реалізація ISA , одна ISA може мати десятки різних мікроархітектур протягом багатьох років і від різних виробників. Саме це відбувається з x86-64/AMD64 або ARM.
Якщо розглядати виключно AMD в рамках AMD64 ISA, ми знаходимо такі різноманітні сімейства, як K8/Hammer, K10, Bulldozer та вся серія Zen (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Всі вони виконують один і той самий базовий набір інструкцій, але їхня внутрішня організація, кеші, конвеєри та підходи до паралельного виконання абсолютно різні.
Коли ми змінюємо ISA, стрибок у сумісності є абсолютним. Процесор на базі ARM A64 (наприклад, Apple Silicon) не може запускати бінарні файли, скомпільовані для x86-64, і навпаки, якщо не використовується рівень трансляції або емуляції, такий як Rosetta 2, QEMU або подібний, що призводить до відповідних втрат продуктивності.
Навіть серед процесорів, які використовують один ISA-контролер, немає гарантії, що всі вони підтримують один і той самий набір інструкцій або розширення. У старішому чіпі може бути брак AVX2 або AVX-512, або ARM SoC може реалізовувати лише підмножину додаткових розширень. Тому бінарний файл, який активно використовує AVX-512, може не завантажитися на процесорі, який пропонує лише SSE4.
Під час компіляції програмного забезпечення поширеною практикою є створення універсальних бінарних файлів для певної ISA (наприклад, x86-64 з принаймні SSE2) без повного використання будь-якої конкретної мікроархітектури, щоб виконуваний файл працював на якомога більшій кількості процесорів. Однак, якщо ви компілюєте з прапорцями налаштування для певної мікроархітектури (-march=znver3, -mtune=skylake тощо), ви можете значно покращити продуктивність на цьому конкретному сімействі, але ціною втрати сумісності з іншими.
Ліцензії ISA та інтелектуальна власність на дизайн
Ліцензії захищають не лише програмний код: ISA та мікроархітектури також є інтелектуальною власністю. Ніхто не може легально клонувати ISA x86 або AMD64 без ліцензії, так само як не можна копіювати без дозволу власний дизайн процесора.
У сфері ISA існує три основні підходи. З одного боку, є закриті ISA , де власник жорстко контролює, хто може впроваджувати сумісні ядра. Класичним прикладом є IA-32 (x86-32), який історично належав Intel, що надавала ліцензії AMD, VIA та іншим компаніям, не без судових баталій.
Аналогічна ситуація склалася з AMD64/x86-64 , спочатку розробленим AMD, а пізніше ліцензованим Intel (яка назвала його EM64T) за угодами про перехресне ліцензування. Інші гравці, такі як Hygon у Китаї, також отримали ліцензії на певні версії (наприклад, Zen 1 для китайського ринку).
Також існують ISA з гнучким ліцензуванням , де власник пропонує як ліцензії ISA, так і готові до інтеграції IP-ядра. Сюди підходять ARM, SPARC або OpenPOWER: ви можете заплатити за використання Cortex A/M/R або Neoverse як є, або за ліцензію, яка дозволяє вам розробляти власні мікроархітектури поверх ISA, як це робить Apple зі своїми M1/M2/M3 або Qualcomm зі своїм Kryo.
Зрештою, існують ISA з відкритим кодом , де будь-хто може створювати сумісні мікроархітектури, не сплачуючи роялті за ISA (хоча вони можуть запатентувати або закрити власну реалізацію). RISC-V є найкращим прикладом: ISA працює під дозвільною ліцензією BSD, і існують варіанти від повністю відкритих ядер на Verilog або Chisel до закритих комерційних розробок.
Окрім ISA, кожна конкретна мікроархітектура (ядро Zen 4, Cortex X4, дизайн графічного процесора тощо) є блоком запатентованої або зареєстрованої інтелектуальної власності. Тут також є відкриті дизайни, опубліковані як м'які ядра на HDL для синтезу в FPGA або інтеграції в користувацькі SoC.
Глибше занурення в сучасні мікроархітектури: випадок AMD Zen
Щоб побачити, як усе це відображається на реальній продуктивності, ніщо не зрівняється з аналізом конкретного сімейства продуктів. Завдяки Zen та його послідовним ітераціям , AMD кардинально змінила свій бізнес , перейшовши від складної ери Bulldozer та старих процесорів FX до конкуренції (а іноді навіть перевершуючи) Intel на ринках настільних комп'ютерів, серверів та ноутбуків.
Після провалу стратегії AMD Fusion , компанія провела реструктуризацію та обрала високопродуктивний дизайн, очолюваний, серед інших, Джимом Келлером. План Zen мав на меті агресивно збільшити IPC (кількість інструкцій на цикл) порівняно з Bulldozer, покращити продуктивність на ват та повернути позиції в продуктивності одноядерних процесорів, де Intel роками лідирувала.
Однією з ключових змін стало посилення інтерфейсу , частини, відповідальної за вибірку та підготовку інструкцій. Zen запровадив кеш мікрооперацій , який зберігає вже декодовані мікрооперації, подібно до того, що робили деякі мікроархітектури Intel, такі як Conroe. Bulldozer цього не мав, і більше покладався на класичну ієрархію кешу інструкцій, що негативно впливало на його пропускну здатність.
Декодер Zen може перетворювати до чотирьох інструкцій CISC x86-64 за цикл на мікрооперації, подібні до RISC. Ці мікрооперації потім поміщаються в чергу, що живиться буфером мікрооперацій, який, у свою чергу, може надсилати до шести мікрооперацій за цикл до внутрішніх планувальників. Саме тут починається виконання поза порядком.
AMD чітко розділила цілочисельні шляхи та шляхи з плаваючою комою . На цілочисельній стороні, АЛУ, АГУ та логіка завантаження/збереження обробляються з черги мікрооперацій. Ця логіка здатна виконувати два 16-байтові завантаження та одне 16-байтове збереження за цикл з 32-кілобайтного, 8-канального L1D з політикою зворотного запису.
Сторона обчислень з плаваючою комою та векторна сторона живлять блоки FMAC та AVX. Маючи два порти множення та два порти додавання, Zen може одночасно виконувати дві 128-бітні операції FMA або одну 256-бітну операцію AVX за такт. Такий паралелізм на рівні інструкцій є одним із ключів до його високої продуктивності під час обчислювально інтенсивних робочих навантажень.
Ієрархія кешу, TLB та організація пам'яті в Zen
Ієрархія пам'яті в Zen організована у три рівні кешу: окремий L1 для інструкцій та даних, приватний L2 на ядро та спільний L3 . Хоча вона успадковує базову структуру попередніх мікроархітектур, розміри, асоціативність та політики були вдосконалені.
Кеш інструкцій (L1I ) пропонує 64 КБ на ядро з 4 асоціативними шляхами, що подвоює кількість шляхів на модуль порівняно з Bulldozer та зменшує конфлікти. Кеш даних ( L1D ) збільшено до 32 КБ, 8 шляхів та політики зворотного запису порівняно з 16 КБ, 4 шляхами та наскрізним записом у Bulldozer, що значно покращує як частоту влучань, так і ефективність запису.
Кеш L2 реалізовано як 512 КБ на ядро та 8-канальний, замість 2 МБ 16-канального кешу, що спільно використовувався на модуль попереднього покоління. Кеш L3 , тим часом, пропонує кілька МБ на ядро з 16-канальною асоціативністю, діючи як останній спільний рівень перед переходом до DRAM.
Паралельно, Zen розділяє TLB на ITLB (для інструкцій) та DTLB (для даних) , кожен з яких має кілька рівнів та сотні записів, всі із захистом парності. Це значно зменшує затримку трансляції віртуальних адрес у фізичні, яка стає все більш критичною зі зростанням розмірів пам'яті.
Коли ми говоримо про кеш як 2-, 4- або 8-канальний , ми описуємо його асоціативність, яка тісно пов'язана з ідеєю чергування в пам'яті. Більша асоціативність означає більше різних способів зберігання блоку пам'яті в цьому кеші, зменшуючи конфлікти, але ціною дещо складнішої логіки та незначного збільшення затримки.
Також важливо розуміти різницю між наскрізним записом та зворотним записом . При наскрізному записі кожен запис оновлює одночасно і кеш, і основну пам'ять, що спрощує узгодженість , але збільшує трафік. При зворотному записі записується лише кеш, а рядок позначається бітом «брудності»; DRAM оновлюється лише тоді, коли цей рядок видаляється, що заощаджує пропускну здатність і покращує продуктивність за рахунок дещо складнішої логіки.
Zen та Zen+: стрибок у споживчих цінах та ефективності
Zen являв собою дуже значний стрибок IPC для AMD порівняно з Bulldozer завдяки поєднанню кращого інтерфейсу, кращого предиктора розгалужень, більшої кількості виконавчих блоків, SMT замість CMT (кожне повне ядро обробляє два потоки, замість того, щоб розподіляти частину FPU між двома логічними ядрами) та набагато розумнішої ієрархії кешу.
Окрім дизайну, AMD скористалася перевагами більш досконалих виробничих процесів з FinFET та меншими вузлами , що дозволяє збільшити щільність транзисторів, зменшити енергоспоживання при тій самій продуктивності та вищі частоти, зберігаючи при цьому розумний TDP ( крива напруга-частота ). Такий баланс продуктивності на ват був вирішальним для відновлення конкурентоспроможності на ринку ноутбуків та серверів.
Перехід від Bulldozer до Zen також приніс довші черги на виведення на пенсію, більші планувальники інструкцій, більшу внутрішню пропускну здатність, прогнозування розгалужень за допомогою методів, заснованих навіть на простих нейронних мережах, та поверхневе моделювання (SMT), здатне краще стискати доступні виконавчі блоки.
У цьому контексті виникає Zen+ , який ми могли б розглядати як еквівалент «галочки» у старій стратегії Intel «Тік-Так»: та ж базова конструкція, що й у Zen, але виготовлена на більш вдосконаленому вузлі, з покращенням частоти, незначним зменшенням затримки та внутрішнім налаштуванням синхронізації. Це не архітектурна революція, а радше вдосконалення, яке призводить до кількох додаткових очок продуктивності.
Zen 2: чіплети, повний AVX2 та глибоке вдосконалення
З Zen 2 AMD більше не просто вдосконалює процес: вона впроваджує суттєві зміни в мікроархітектурі та масово запускає свою стратегію чіплетів . Замість одного великого монолітного кристала, вона розділяє конструкцію на кілька менших 7-нм обчислювальних кристалів (CCD) та окремий 12-нм кристал введення/виведення, що обробляє пам'ять, PCIe та з'єднання.
Такий чіплетний підхід покращує вихід продукції на пластину (легше виготовляти невеликі кристали без дефектів), знижує витрати та спрощує масштабування кількості ядер: просто додайте більше ПЗЗ-матриць, щоб досягти 16, 32 або більше ядер в EPYC та Threadripper. Компромісом є дещо складніша внутрішня комунікація, що залежить від з'єднання Infinity Fabric, яке AMD удосконалює покоління за поколінням.
Що стосується чистої продуктивності, AMD говорить про приблизно +15% IPC для Zen 2 порівняно з Zen+ на тій самій частоті та загальне покращення продуктивності на ват, яке може становити приблизно +75% порівняно з першим Zen, якщо поєднати вдосконалення дизайну та процесу.
У векторному сервері Zen 2 позбавлений відсутньої складової: він пропонує повну 256-бітну підтримку AVX2 в одній мікрооперації , без розділення інструкцій на дві 128-бітні операції, як це було в Zen/Zen+. Це означає, що векторні виконавчі блоки тепер дійсно 256-бітні та можуть обробляти робочі навантаження AVX2 на повній швидкості зі значно меншим зниженням частоти, ніж в інших розробках.
Кеш мікрооперацій також посилюється, збільшуючись до 4 КБ записів (вдвічі більше), використовуючи частину області, звільненої шляхом зменшення вдвічі кешу L1I, але подвоюючи його асоціативність з 4 до 8 способів. Внутрішнє моделювання призвело AMD до висновку, що для більшості реальних робочих навантажень більший кеш UOP є більш вигідним, ніж більший кеш L1I.
Ємність кешу L3 на блок ядра подвоюється , що допомагає зменшити кількість збоїв останнього рівня, хоча затримка доступу збільшується приблизно з 35 до 40 циклів. Щоб пом'якшити цей ефект, Zen 2 покращує пропускну здатність завантаження та зберігання, а також удосконалює політику попередньої вибірки.
Ще одним важливим аспектом є предиктор розгалужень. Zen 2 використовує предиктор TAGE (TAgged GEometric) з понад 7 записами, здатний використовувати історії змінної довжини та записи з тегами. Це зменшує псевдонімність між різними гілками та, за даними AMD, скорочує кількість неправильних прогнозів приблизно на 30% порівняно з попередньою схемою, що безпосередньо призводить до меншої кількості змивань конвеєра та вищого IPC.
Бекенд Zen 2: AGU, буфери та скориговані затримки
У всьому бекенді Zen 2 продовжує обробляти до шести мікрооперацій за цикл з буфера переупорядкування, який розширено приблизно до 224 записів (порівняно зі 192 у Zen). Блоки планування поділені на чотири черги для АЛУ по 16 записів кожна та одну чергу для АГУ з 28 записами.
Кількість блоків генерації адрес (AGU) збільшується з двох до трьох, хоча не всі вони однакові: два з них можуть обробляти як завантаження, так і запис, тоді як третій спеціалізується на операціях зберігання. Цей розподіл розроблено для типових профілів програмного забезпечення, де завантаження зазвичай частіші та критичніші, ніж операції зберігання.
У площині з плаваючою комою серверна частина може приймати чотири мікрооперації за цикл до своїх 256-бітних векторних блоків FMA, що підтримуються фізичним регістровим файлом на 160 записів. 256-бітні шляхи завантаження/зберігання були вдосконалені для забезпечення стабільної роботи цих блоків під час великих векторних навантажень.
Zen 2 також налаштовує затримки певних операцій : наприклад, множення з плаваючою комою зменшує затримку з 4 до 3 циклів, що допомагає з дуже щільними циклами числових обчислень. І загалом, існує набір невеликих оптимізацій, розподілених по всьому конвеєру, які в сумі призводять до додаткового IPC, що спостерігається в синтетичних бенчмарках та реальних додатках.
Щодо внутрішньої ієрархії за групами ядер, AMD використовує концепцію CCX (Core Complex) : блок із 4 ядер, які використовують один і той самий кеш L3 (16 МБ у Zen 2). Цей додатковий розмір означає дещо вищу затримку, але натомість знижує частоту збоїв, особливо в програмах з великими робочими наборами.
Для довідки, можна навести приблизні показники внутрішньої затримки: близько 4 циклів для L1 , близько 12 для L2 та близько 40 циклів для L3. Ключовим є збереження якомога більшої кількості даних у L1/L2 та зменшення трафіку до L3 та DRAM , чого мікроархітектура та компілятори прагнуть досягти разом.
Infinity Fabric: клей, що використовується в чіплетах, та його вплив на продуктивність
Один компонент, який не завжди пов'язаний з мікроархітектурою, але життєво важливий у Zen 2 та пізніших версіях, — це Infinity Fabric . Ця власна шина діє як комунікаційна «магістраль» між CCX, CCD, кристалом вводу/виводу, пам'яттю та загалом між усіма блоками SoC.
Infinity Fabric — це еволюція HyperTransport , високошвидкісної шини, яку AMD започаткувала багато років тому та яку також використовували треті сторони, такі як NVIDIA, Cisco, Sun та інші члени консорціуму. IF успадковує філософію масштабованих з'єднань "точка-точка", але адаптовану до потреб сучасних однокристальних систем (SoC) та взаємозв'язку між процесорами (CPU) та графічними процесорами (GPU).
У Zen 2 AMD представляє IF2 з підтримкою PCIe 4.0 та 512-бітною внутрішньою шиною між CCX, що вдвічі більше, ніж у першій версії. Це призводить до більш ефективної пропускної здатності та підвищення ефективності, яке AMD оцінює приблизно на 27% порівняно з IF1, допомагаючи зменшити зниження продуктивності від перемикання між чіплетами.
Крім того, тактова частота Infinity Fabric частково відокремлена від тактової частоти DRAM , що дозволяє основній пам'яті масштабуватися до вищих частот у певних сценаріях, не обов'язково змушуючи проміжну частоту тримати темп, що пропонує більше можливостей для точного налаштування для ентузіастів та розробників систем.
У серверних процесорах, таких як EPYC , з чотирма або більше обчислювальними чіплетами, Infinity Fabric дозволяє з'єднувати всі кристали разом з майже повними топологіями (повороти на 180º, прямі з'єднання тощо), досягаючи пропускної здатності між кристалами, яка може легко перевищувати 150 Гбіт/с у двонаправленому режимі залежно від швидкості використовуваної DDR.
Поєднання надійної мікроархітектури в кожному ядрі , масштабованої конструкції з використанням чіплетів та достатньо швидких міжз'єднань дозволяє AMD збирати процесори з 32, 64 або більше ядрами з видатною продуктивністю в умовах високопаралельних робочих навантажень, зберігаючи при цьому конкурентоспроможний IPC на потік.
Зрештою, коли ви порівнюєте процесори в ігрових бенчмарках, 3D-рендерингу, масивній компіляції чи науковому моделюванні, показники частоти в ГГц та кількості ядер розповідають лише частину історії. Що дійсно має значення, так це те, як мікроархітектура регулює внутрішнє виконання , як вона використовує або витрачає кожен тактовий цикл, і які компроміси виробник зробив між затримкою, пропускною здатністю, енергоспоживанням та складністю.

Індекс
- 1 ISA, макроархітектура та мікроархітектура: впорядкування концепцій
- 2 Що саме являє собою мікроархітектура процесора?
- 3 Сумісність, ISA та сімейства мікроархітектур
- 4 Ліцензії ISA та інтелектуальна власність на дизайн
- 5 Глибше занурення в сучасні мікроархітектури: випадок AMD Zen
- 6 Ієрархія кешу, TLB та організація пам'яті в Zen
- 7 Zen та Zen+: стрибок у споживчих цінах та ефективності
- 8 Zen 2: чіплети, повний AVX2 та глибоке вдосконалення
- 9 Бекенд Zen 2: AGU, буфери та скориговані затримки
- 10 Infinity Fabric: клей, що використовується в чіплетах, та його вплив на продуктивність