- RAID sistemi poboljšavaju performanse i dostupnost, ali ne zamjenjuju sigurnosne kopije i nisu imuni na fizičke, logičke ili ljudske greške.
- Čudni zvukovi, degradirano stanje, abnormalna sporost i greške u parnosti ili čitanju/pisanju su jasni znaci nadolazećih problema u RAID-u.
- Forsiranje ponovnih izgradnja, preuređivanje diskova bez dokumentacije ili korištenje generičkih alata za popravak može pretvoriti upravljivu grešku u potpuni gubitak podataka.
- Razborito i rano djelovanje, uz podršku stručnjaka za oporavak RAID-a, uveliko povećava šanse za spašavanje informacija.
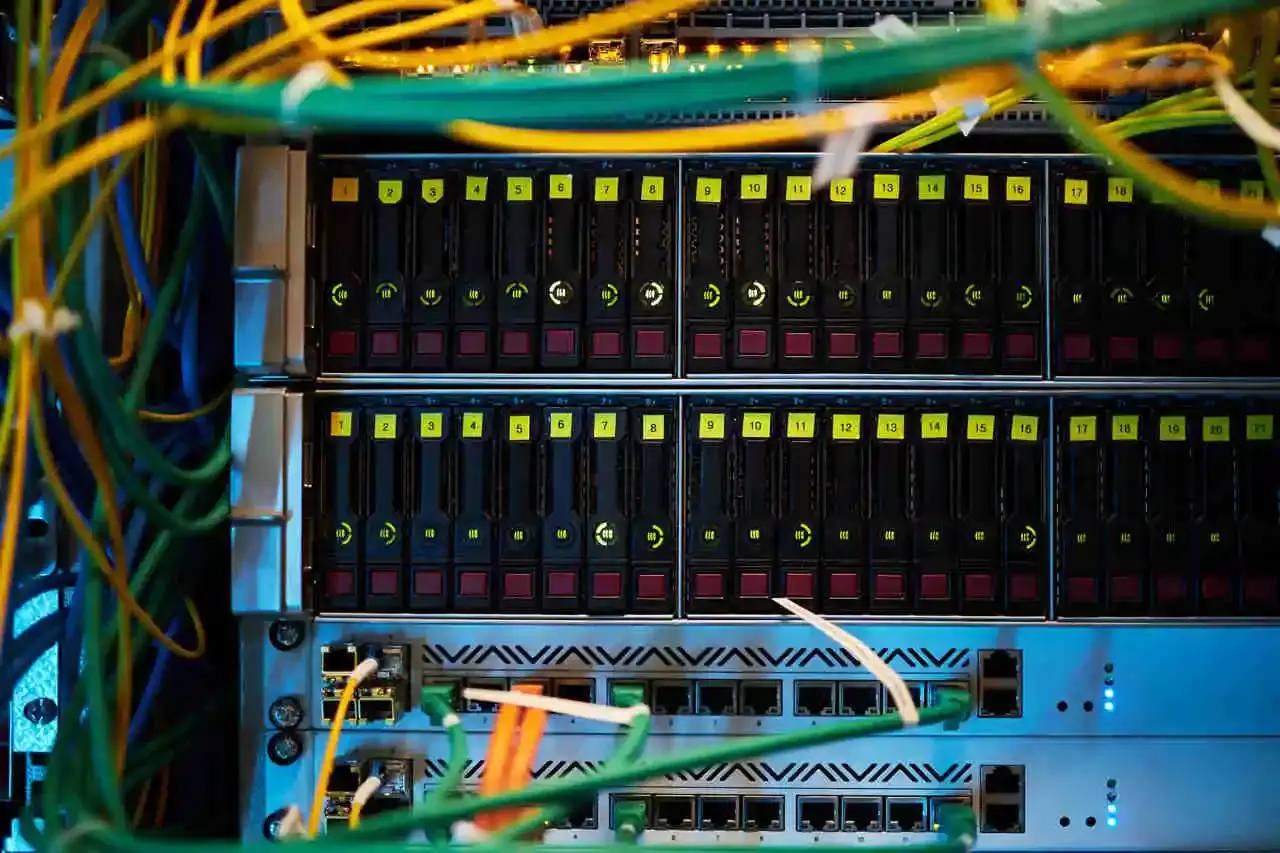
RAID sistemi su postali uobičajeni u serverima, NAS uređajima i nizovima za pohranu podataka jer obećavaju povećane performanse i toleranciju na greške . Međutim, iako nude mir, oni nisu čarobni štapić: loše upravljan kvar može dovesti do katastrofe i ostaviti vas bez podataka u roku od nekoliko minuta.
Kada RAID sistem počne pokazivati neobične simptome, ključ nije u tome da se što brže popravi, već u najopreznijem pristupu. Otkrivanje znakova kvara i poznavanje onoga što NE treba raditi čini razliku između jednostavne zamjene diska i potpunog i nepovratnog gubitka podataka, čak i za profesionalnu laboratoriju.
Šta je kvar RAID-a i zašto nije isto što i rezervna kopija?
RAID (Redundantni niz nezavisnih diskova) grupiše više diskova kako bi ponudio veću dostupnost, performanse i/ili redundanciju , ovisno o korištenom nivou. Od klasičnog zrcalnog RAID 1 do složenijih konfiguracija poput RAID 5, RAID 6 ili RAID 10, ideja je da sistem nastavlja funkcionirati čak i ako jedan (ili više) fizičkih diskova otkaže.
Problem je što mnogi ljudi pretpostavljaju: "Imam RAID, dakle imam i sigurnosnu kopiju", a to je fundamentalna greška. RAID ne zamjenjuje sigurnosne kopije : štiti od kvara jednog ili više diskova (ovisno o RAID nivou), ali ne sprječava logičku korupciju, ljudske greške, ransomware, slučajna brisanja ili kvarove kontrolera ili servera.
Nadalje, način na koji kontroler — uključujući firmver kontrolera — distribuira podatke (redoslijed diskova, veličina traka, algoritmi parnosti, metapodaci itd.) znači da svaka neispravna manipulacija nizom može poremetiti strukturu i izuzetno zakomplicirati oporavak, čak i kada diskovi "izgledaju" ispravno.
Glavni RAID nivoi i njihov uticaj na oporavak
Svaki RAID nivo se ponaša drugačije u slučaju kvarova, što značajno utiče na opcije oporavka podataka. Razumijevanje ovih razlika pomaže u izbjegavanju donošenja rizičnih odluka kada nešto krene po zlu.
U RAID 0 nizu, podaci se raspoređuju na više diskova bez pariteta ili zrcaljenja. Ne postoji nikakva redundancija : ako jedan disk otkaže ili se dovoljno degradira, logički gubitak je potpun jer nedostaje bitan dio svake datoteke. Govoriti o "rekonstrukciji" ovdje nema mnogo smisla; prioritet je pokušati oporaviti ono što se može oporaviti sa fizički oštećenih diskova.
U RAID 1 nizu, diskovi su zrcalno kopirani: svaki disk sadrži kompletnu kopiju podataka . Ova konfiguracija je obično prilično pouzdana za oporavak podataka, pod uslovom da se ne naprave greške u rukovanju (na primjer, inicijalizacija jednog od diskova na drugom sistemu ili njihovo miješanje na nekompatibilnim kontrolerima).
RAID 5 distribuira podatke na više diskova i izračunava distribuiranu parnost, što mu omogućava da izdrži kvar jednog diska . Problem nastaje kada drugi disk počne da ne funkcioniše ispravno tokom ponovne izgradnje: opterećenje naglo raste, pojavljuju se greške pri čitanju i niz se može srušiti bez upozorenja.
RAID 6 radi slično kao RAID 5, ali dodaje drugu parnost, što mu omogućava da toleriše kvar do dva diska . Zauzvrat, arhitektura je složenija, ponovna izgradnja traje duže, a sve logičke ili konfiguracijske greške dodatno komplikuju napore oporavka.
RAID 10 kombinuje ogledala i pruge: parovi diskova koji se ogledaju su "izgrebani". Za potrebe oporavka, redoslijed diskova i odnos između ogledala i pruga su ključni; miješanje pozicija ili naslijepo ponovno izgrađivanje može uništiti niz čak i ako su svi diskovi fizički ispravni.
Jasni znaci da vaš RAID počinje da otkazuje
Prije nego što sistem potpuno zakaže, obično ostavlja niz tragova. Učenje njihovog prepoznavanja omogućava vam da se zaustavite na vrijeme i spriječite daljnju štetu.
Jedan od najočitijih znakova su čudni zvukovi koji dolaze iz diskova: ponavljajući klikovi, škripanje, povremeno zujanje ili metalni zvukovi kojih prije nije bilo. Ovi zvukovi obično ukazuju na mehaničke kvarove u glavama za čitanje/pisanje ili pločama diska , ili na probleme s motorom. Ako ih ignorišete i nastavite s prisilnim čitanjem, stanje diska će se obično vrlo brzo pogoršati.
Još jedan tipičan znak je pojavljivanje poruka "Degraded", "Failed" ili "Critical" u konzoli za upravljanje NAS-a ili RAID kontrolera. Ova poruka znači da je jedan ili više diskova označeno kao problematično i da niz radi bez predviđene redundancije. U ovom trenutku, posebno kod RAID 5, drugi kvar može biti kap koja je prelila čašu.
Obratite pažnju na manje primjetne, ali podjednako opasne simptome, kao što je iznenadni i neobjašnjivi pad performansi . Ako vrijeme čitanja i pisanja naglo poraste, posebno prilikom pristupa određenim volumenima ili mapama, kontroler možda ima problema sa sektorima koje je teško pročitati ili ima stalne ponovne pokušaje koji preopterećuju sistem.
Sistemski ili kontrolni dnevnici često prikazuju I/O greške, poruke o netačnom paritetu, "Nepopravljiva greška čitanja", "Provjera pariteta nije uspjela" ili "Otkrivena loša pruga". Kontinuirano povećanje grešaka čitanja/pisanja , čak i ako sistem i dalje funkcioniše, predstavlja crveni znak koji se ne smije ignorisati.
Još jedan znak za uzbunu je da volumen izgleda degradiran iako nijedan disk nije očigledno potpuno otkazao . Ovo obično ukazuje na logičku korupciju u RAID metapodacima ili distribuiranim blokovima, a forsiranje automatske obnove u ovom stanju može proširiti korupciju na cijeli niz.
Simptomi logičke korupcije i tihi problemi u RAID-u
Nisu svi kvarovi RAID-a uzrok trenutnog "mrtvog" diska. Često je problem postepeno oštećenje podataka koje se tiho uvlači sve dok situacija ne postane vrlo teška za preokrenuti.
Tipičan primjer su datoteke koje izgledaju kao da su tu, imaju ispravnu veličinu i ime, ali se ne otvaraju, imaju greške u formatiranju ili izgledaju skraćeno . Baze podataka koje se ne mogu montirati, virtuelne mašine koje se ne mogu pokrenuti ili slike koje preglednik odbija obično su pokazatelji nedosljednosti u blokovima distribuiranim po diskovima.
Također je uobičajeno da operativni sistem ili aplikacije pokazuju lokaliziranu sporost na određenim RAID volumenima, iako CPU i RAM ne izgledaju posebno opterećeni. Ako je usporavanje koncentrirano na operacije čitanja/pisanja na istom volumenu, vrlo je vjerojatno da se radi o oštećenju ili nestabilnim sektorima.
Još jedan opasan simptom je da se ponovne izgradnje koje započnu nakon promjene diska uvijek zaustavljaju na istoj tački , izbacuju čudne greške ili jednostavno označavaju proces kao neuspješan. Ovo obično ukazuje na to da su izvorni blokovi već oštećeni i da kontroler nije u mogućnosti generirati koherentnu kopiju na novom disku.
Ponekad samo jedan disk prikazuje SMART upozorenja (preraspodijeljeni sektori, visoka vremena pristupa itd.), ali neobično ponašanje je primjetno na cijelom RAID nizu. U takvim slučajevima, jedan disk s lošim sektorima može ugroziti konzistentnost cijelog niza, posebno kada se pokrene provjera parnosti ili ponovna izgradnja.
Ignorisanje ovih upozorenja i nastavak normalnog rada, ili još gore, forsiranje intenzivnih zadataka poput verifikacija, masovnih sigurnosnih kopija ili automatske obnove, može proširiti korupciju i prepisati važeće blokove oštećenim podacima . Od tog trenutka nadalje, čak ni profesionalni alati ne mogu garantovati potpuni oporavak.
Tipični kvarovi u kontrolerima, serverima i matičnim pločama
Nije sve u diskovima. RAID kontroler, matična ploča ili čak cijeli server mogu postati slaba karika u lancu i uzrokovati kvarove niza čak i ako su diskovi ispravni.
RAID kontroler, bilo da je namjenski hardver ili integriran na matičnoj ploči, odgovoran je za odlučivanje gdje se svaki blok zapisuje, kako se izračunava paritet i kako se volumeni sastavljaju . Kvar, oštećeni firmver ili prenapon mogu ga onemogućiti, uzrokujući da niz nestane ili se prikaže kao "Strano", "Offline" ili slično.
U slučaju namjenskih hardverskih kontrolera, postoji dodatni problem: gotovo potpuni nedostatak kompatibilnosti između modela i proizvođača . Ako se, na primjer, određeni Supermicro kontroler pokvari, nije dovoljno jednostavno ga zamijeniti "sličnim": često je potreban potpuno isti model, sa sličnom verzijom firmvera, da bi ispravno pročitao RAID metapodatke.
Kod integriranih RAID rješenja (tzv. "lažni RAID"), kao što su neki softverski RAID-ovi s AMD ili Intel čipsetom, postoji rizik da zamjena matične ploče, resetiranje BIOS-a ili gubitak CMOS konfiguracije mogu učiniti niz neupotrebljivim. Kod mnogih desktop računara i radnih stanica, kvar matične ploče ili CMOS baterije može izbrisati RAID konfiguraciju, ostavljajući diskove kao izolirane jedinice.
Nadalje, sam server ( napajanje , memorija, matična ploča, zadnja ploča itd.) može otkazati zbog električnih problema, pregrijavanja ili hardverskih nedostataka. U mnogim od ovih slučajeva, praktična posljedica je da RAID postaje nedostupan , iako bi u stvarnosti diskovi, povezani s drugim sistemom s odgovarajućom strategijom, mogli oporaviti svoje podatke.
Da stvar bude gora, sistem mora "ponovo sastaviti" RAID niz svaki put kada se ponovo pokrene ili pokrene. Ako se tokom ovog procesa dogode nestanci struje, skokovi napona ili greške u konfiguracijskim datotekama (kao što je mdadm.conf u Linuxu), sistem može nepravilno sastaviti niz, ostaviti ga nepotpunim ili ga jednostavno ne prepoznati, što će volumen učiniti neupotrebljivim.
Uobičajeni uzroci gubitka podataka u RAID nizovima
Uzimajući u obzir sve navedeno, jasno je da su RAID nizovi, iako vrlo korisni, i dalje izloženi znatnim rizicima. Glavni pravi uzroci gubitka podataka u ovim okruženjima obično su kombinacija fizičkih, logičkih i ljudskih faktora.
Najočitiji uzrok je kvar jednog ili više diskova zbog habanja, proizvodnih grešaka, vibracija, temperature ili udara. Iako je RAID dizajniran da izdrži neke od ovih situacija, ne uspijeva uvijek bez kolateralne štete : disk koji počne vraćati oštećene sektore može povući za sobom susjednog, posebno tokom procesa verifikacije ili ponovne izgradnje.
Još jedan čest izvor problema su greške pri sastavljanju ili rekonstrukciji . Ako sistem montira niz s netačnim parametrima, diskovima u pogrešnom redoslijedu, RAID nivoima koji se razlikuju od originala ili nakon neuspjele migracije, podaci se lako mogu poravnati. U praksi, volumen se može pojaviti kao RAW, zahtijevati formatiranje ili prikazivati nekonzistentne strukture datoteka.
Kvarovi servera (matična ploča, firmver, backplane, SAS/SATA kontroler, itd.) također igraju značajnu ulogu. U vrlo visokom postotku incidenata, kada server iznenada otkaže, RAID niz postaje nedostupan i podaci nisu vidljivi sistemu, iako fizički još uvijek postoje na diskovima.
Svemu ovome moramo dodati i ljudske faktore: promjene konfiguracije bez dokumentacije, preuređivanje diskova "za testiranje", ažuriranja BIOS-a bez prethodne sigurnosne kopije konfiguracije, slučajno brisanje volumena, ponovnu instalaciju operativnog sistema na diskove koji su bili dio niza ili vraćanje oštećenih ili nepotpunih sigurnosnih kopija na istom oštećenom RAID-u.
Konačno, tu su i vanjske prijetnje poput ransomwarea, koji može šifrirati i podatke i strukture volumena smještenih na RAID nizovima. U ovim scenarijima, proces oporavka postaje dvostruko kompliciraniji: prvo se mora riješiti šifriranje, a zatim potencijalna interna korupcija samog RAID-a.
Šta NE treba raditi kada vaš RAID počne da otkazuje
Kada server padne vikendom i svi su na ivici, najčešća reakcija je da neko pokuša da ga popravi u hodu. To je razumljivo, ali mnogi od ovih dobronamjernih napora su upravo ono što na kraju pogoršava podatke.
Najopasnije iskušenje je prisiliti automatsko ponovno izgrađivanje bez prethodne analize stvarnog stanja diskova . Ako jedan od diskova ima oštećene podatke ili nečitljive sektore, ponovno izgrađivanje će kopirati i miješati neželjene podatke s ispravnim podacima sve dok se struktura volumena potpuno ne uništi.
Još jedna uobičajena greška je nasumično zamjenjivanje diskova bez znanja koji je zapravo oštećen ili dokumentiranja originalnog položaja svakog diska . Premještanje diskova između ležišta, njihovo miješanje između različitih kontrolera ili zamjena nekoliko odjednom bez plana može zbuniti kontroler i uzrokovati da RAID niz izgubi trag svoje konfiguracije.
Pokretanje alata poput CHKDSK na Windowsu ili fsck na Linuxu direktno na RAID volumenu koji pokazuje znakove korupcije također je vrlo rizično. Ovi uslužni programi pokušavaju "popraviti" strukturu datoteka na osnovu tabela koje mogu biti oštećene , a njihova rješenja često uključuju brisanje unosa, premještanje blokova i prepisivanje metapodataka. U već kompromitovanom okruženju, ovo može rezultirati trajnim gubitkom hiljada datoteka.
Podjednako loše je oslanjanje na generički softver za oporavak RAID-a koji obećava da će "automatski postaviti bilo koji RAID ". Mnogi od ovih alata rade površno, pretpostavljajući standardne obrasce pruganja, pomaka i pariteta koji nisu uvijek ispunjeni. Zloupotreba može prepisati ključne sektore ili ostaviti diskove u gorem stanju nego kada su prvi put instalirani.
Konačno, ponovljeno ponovno pokretanje servera, ponovno uključivanje i isključivanje NAS-a ili nastavak normalnog rada na oštećenom RAID nizu ili nizu s greškama parnosti samo uzrokuje daljnja oštećenja diskova, preraspodjelu više sektora i širenje korupcije . Što se više zapisa izvrši nakon prvog ozbiljnog problema, to će stručnjaci imati manje prostora za manevar.
Oprezni koraci koje treba preduzeti kada otkrijete mogući kvar RAID-a
U slučaju bilo kakvih ozbiljnih simptoma (šum, degradirano stanje, greške pariteta, ekstremna sporost, neuspješne obnove itd.), najmudriji postupak je usporiti i postupiti metodično . Ono što ne napišete ili ne promijenite sada, moglo bi se spasiti kasnije.
Prvo što treba uraditi je odmah zaustaviti sve operacije pisanja na nizu : bez kopiranja podataka preko njega, bez novih virtuelnih mašina, bez masovnih ažuriranja. Ako je volumen i dalje dostupan, najbolje ga je montirati samo za čitanje ako sistem to dozvoljava.
Zatim, preporučljivo je dokumentirati trenutno stanje što je detaljnije moguće: snimke ekrana BIOS-a ili NAS interfejsa, popis diskova s njihovom fizičkom lokacijom, serijskim brojem, portovima na koje su povezani, tačne poruke o greškama koje se pojavljuju u zapisnicima itd. Ove informacije su neprocjenjive za svaki laboratorij za oporavak prilikom rekonstrukcije originalnog scenarija.
U slučajevima kada se RAID ne uspije montirati ili server ne može pokrenuti, jedna tehnička opcija je uklanjanje diskova i njihovo povezivanje s drugim računarom kako bi se kreirale forenzičke kopije svakog diska sektor po sektor . Ove kopije, napravljene u režimu samo za čitanje, omogućavaju vam da naknadno radite na klonovima bez daljnjeg oštećenja originalnih diskova.
Sa naprednim znanjem, specijaliziranim alatima i kontroliranim okruženjem, logička rekonstrukcija niza može se pokušati iz ovih klonova, izvodeći redoslijed diska, veličinu pruga, obrasce parnosti, pomake i metapodatke . Međutim, ovo je delikatan zadatak obrnutog inženjeringa: svako pokušavanje i greška koje uključuju nasumične promjene parametara mogu dovesti do pogrešnog tumačenja podataka.
Za većinu preduzeća i kritičnih okruženja, najsigurniji postupak je što prije kontaktirati profesionalnu uslugu oporavka RAID sistema i slijediti njihova početna uputstva. Stopa uspjeha je obično usko povezana s brojem neuspjelih pokušaja prije dolaska u laboratoriju.
Kako funkcionišu profesionalni RAID laboratoriji za oporavak
Profesionalne usluge oporavka podataka koje su specijalizirane za RAID okruženja kombiniraju dubinsko poznavanje hardvera i datotečnih sistema s vlasničkim alatima i strogim procedurama. To je ono što obično rade, općenito govoreći, kada prime slučaj neuspjelog RAID-a.
Prvi korak je provođenje pojedinačne dijagnostike na svakom tvrdom disku : provjerava se mehaničko, elektronsko i logičko stanje diskova, identificiraju se loši sektori, pregledavaju se SMART tabele i procjenjuje se rizik od kratkotrajnog kvara. Ako bilo koji diskovi imaju fizička oštećenja, njihov tretman u čistoj sobi ima prioritet.
Zatim se kreiraju forenzički klonovi svih uključenih diskova . Umjesto rada na originalima, pravi se kopija sektor po sektor, koristeći alate koji omogućavaju preskakanje ozbiljno oštećenih sektora ili ponovni pokušaj sa sigurnim obrascima. Cilj je sačuvati originalno stanje u slučaju da bude potrebno vratiti se na prethodni korak u procesu.
Kada su klonovi spremni, vrši se ručna logička rekonstrukcija RAID-a : identificira se nivo (0, 1, 5, 6, 10, itd.), redoslijed diskova, veličina traka, pomaci, algoritmi parnosti i sve druge karakteristike originalnog kontrolera. Često se volumen može rekonstruirati čak i bez istog kontrolera ili NAS-a koji ga je kreirao.
Nakon što rekonstruirani virtualni volumen izgleda koherentno, sistem datoteka se popravlja ako je potrebno: NTFS, ReFS, ext4, XFS, Btrfs, ZFS, VMFS i drugi. Ovaj posao je sličan radu hirurga: strukture se ispravljaju, inode tabele, MFT-ovi, superblokovi ili dnevnici se ponovo grade, uvijek pokušavajući promijeniti apsolutni minimum.
Konačno, podaci se izdvajaju i sistematski validiraju. Provjerava se konzistentnost glavnih baza podataka, virtuelnih mašina i kritičnih foldera, verifikuje se da li se datoteke ispravno otvaraju, a podaci se isporučuju na novim, izolovanim medijima za pohranu , kao što su eksterni tvrdi diskovi ili novi NAS, tako da klijent može pregledati oporavak prije nego što ga prihvati.
U posebno složenim scenarijima, kao što su RAID-ovi pogođeni ransomware-om, neuspješne prethodne obnove ili virtualni volumeni unutar već oštećenih nizova, tehnike dešifriranja, forenzička analiza i RAID rekonstrukcija se kombinuju, ali uvijek pod istim pravilom: ne dirajte originale više nego što je strogo potrebno.
U konačnici, RAID sistemi su moćan alat za poboljšanje dostupnosti podataka, ali ostaju podložni fizičkim, logičkim i ljudskim greškama. Razumijevanje njihovih slabosti, prepoznavanje ranih znakova upozorenja i, prije svega, izbjegavanje impulzivnih odluka kada dođe do kvara, ono je što zaista čini razliku između manjeg straha i katastrofe podataka.
