- Většinu katastrof RAID systémů zhoršují ukvapené akce v prvních několika minutách po selhání.
- Každá úroveň RAIDu spravuje data a paritu odlišně, což určuje skutečné riziko a strategii obnovy.
- Profesionální zásah kombinuje klonování disků, rekonstrukci virtuálních polí a pokročilé techniky logické analýzy.
- RAID nenahrazuje zálohy: prevence a řádná reakce jsou klíčem k uložení dat.
Když selže systém RAID, prvních několik minut je kritických. V této takzvané „zlaté hodince“ po selhání dochází k většině lidských chyb, které z opravitelného problému dělají nevratnou katastrofu. Slepá výměna disků, neustálé restarty nebo pokusy o přestavbu systému bez znalosti problému jsou obvykle nejrychlejší cestou k úplné ztrátě dat.
Proč je obnova RAID tak delikátní?
V mnoha kritických incidentech není ztráta dat způsobena počátečním selháním hardwaru, ale ukvapenými akcemi provedenými během první hodiny . Toto období je klíčové: disk může změnit pozici, proces inicializace může být omylem zahájen, může být vynucena obnova systému nebo systém může být spuštěn z neúplné zálohy na stejném úložném poli a to, co bylo kdysi složitým, ale zvládnutelným problémem, se stane téměř neřešitelnou hádankou.
Mezi nejčastější rizikové situace patří výměna disků v nesprávném pořadí (v RAID 0, 1, 5, 6, 10 atd.), nahrazení řadiče jiným modelem bez klonování nebo dokumentace konfigurace, vynucené přepnutí disků do režimu „online“ bez analýzy skutečného stavu, inicializace nesprávných svazků nebo spouštění nedokončených rebuildů, které dále poškozují vnitřní strukturu pole.
Obzvláště nebezpečné jsou také zálohy prováděné přímo na poškozeném systému , migrace úložišť typu VMware Storage vMotion s nestabilním polem a jakékoli operace, které zapisují nová metadata konfigurace RAID na disky s potenciálně obnovitelnými informacemi.
RAID pole je základem většiny fyzických serverů, systémů NAS a SAN a není vždy hned jasné, že problém pochází ze samotného pole. Proto je v případě pochybností nejrozumnějším postupem zastavit veškeré zápisy na disky , situaci podrobně zdokumentovat a před provedením dalších změn vyhledat radu specialistů na obnovu dat.
Typické lidské chyby a základní osvědčené postupy
Když systém RAID přejde do degradovaného stavu, jeden nebo více disků selže nebo se NAS nespustí, instinktivní reakcí je obvykle zkoušet různé věci, „dokud něco nezačne fungovat“. Tento přístup téměř vždy problém zhorší, protože každá akce zanechává na discích stopu a může přepsat paritu, metadata nebo uživatelská data, která jsou stále neporušená.
Mezi nejčastější chyby, které komplikují obnovu, patří akce, jako je konfigurace nového RAIDu s použitím stejného řadiče a disků , vložení těchto disků do jiného úložného prostoru, aby se „zjistilo, zda je systém rozpozná“, nebo změna fyzického pořadí pozic pro disky. Ve vysokém procentu případů tyto akce přepíší původní konfiguraci, zničí paritní pruhy a drasticky snižují šance na úspěch.
Dalším běžným špatným postupem je nezaznamenávání čehokoli, co se stane. V komplexním scénáři selhání je nezbytné chronologicky zaznamenávat všechny události : výpadky napájení, systémové zprávy , změny disku, pokusy o obnovení systému, aktualizace firmwaru atd. Tyto informace později pomáhají specializovaným technikům poskládat skládačku dohromady.
Stejně důležité je dokumentovat a uchovávat přesnou polohu každého disku v poli . Změna diskových pozic „od oka“ nebo vyřazení údajně nefunkčních disků je bezohledná: pokud je později nutné RAID znovu sestavit v laboratoři, může znalost toho, který disk byl ve kterém slotu, a dostupnost všech původních disků (i těch vyměněných) znamenat zásadní rozdíl.
Obecně platí, že v případě selhání RAIDu je třeba provést následující kroky: zastavit počítač, nic nepřekonfigurovat, uchovávat všechny disky označené , shromáždit co nejvíce informací o incidentu a pokud jsou data důležitá, před pokračováním v experimentování kontaktovat profesionální službu pro obnovu dat.
Jak profesionálové přistupují k obnově RAID systémů
Společnosti specializující se na obnovu dat z RAID disků pracují s vysoce strukturovanými postupy , protože každé technické rozhodnutí musí minimalizovat riziko dalšího poškození . V typickém případě s více disky a terabajty dat v sázce může být jakýkoli improvizovaný krok nákladný.
Velmi ilustrativním příkladem z reálného světa je RAID pole s dvanácti disky a přibližně 12 TB dat. Záloha nebyla správně spravována, takže jediným schůdným řešením bylo kontaktovat profesionální společnost zabývající se obnovou dat z RAID pole . Situace byla naléhavá; provoz bylo nutné co nejdříve obnovit a pole již dosáhlo kritického stavu poté, co během rekonfigurace selhaly dva disky.
V takových scénářích specialisté obvykle začínají klonováním všech funkčních disků a vždy pracují s kopiemi, nikoli s originály. Zároveň se snaží co nejvíce opravit fyzicky poškozené disky, a to buď laboratorními zásahy (čisté prostory, výměna hlav, dárcovská elektronika atd.), nebo pokročilými technikami částečného čtení.
V případě 12TB disku byl největším problémem fakt, že rekonfigurace RAIDu začala před druhým selháním , takže řadič již částečně přepočítal nové hodnoty parity. Relativní výhodou bylo, že druhý disk selhal v raných fázích procesu, takže velká část staré logické struktury byla stále obnovitelná.
Po obnovení jednoho z poškozených disků a vygenerování kompletní kopie bylo náročné ručně rekonstruovat logickou strukturu pole : pořadí disků, velikost bloků, distribuci parity, možné změny v průběhu procesu… Tato práce, která může trvat několik dní analýzy, nám umožnila obnovit přibližně 90 % dat, což je za daných okolností považováno za vysokou míru úspěšnosti při obnově RAID.
Profesionální služby: co obvykle nabízejí a jak fungují
Společnosti specializující se na obnovu dat z RAID disků obvykle nabízejí rychlou a bezplatnou diagnostiku , zejména pro kritické servery nebo produkční NAS zařízení. V některých případech se zavazují k posouzení problému během několika hodin, poskytnutí zprávy o proveditelnosti a cenové nabídky s pevnou cenou a dodržování zásady „žádná obnova, žádný poplatek“.
Typická služba začíná, když si klient vyžádá bezplatnou cenovou nabídku na obnovu svého RAIDu . V této počáteční fázi se shromažďují informace o typu pole (RAID 0, 1, 5, 6, 10, JBOD atd.), počtu disků, souborovém systému (např. ext4, Btrfs, XFS, HFS+, NTFS…), použitém hardwaru (Synology NAS, QNAP, značkové servery, pole SAN…) a podrobný popis příznaků a dosud provedených opatření.
Jakmile je studie přijata, společnost obvykle zajistí bezplatný odběr zařízení nebo disků s uvedením přesných pokynů k balení: použijte antistatický nebo polstrovaný obal, umístěte zařízení do pevné krabice s nárazuvzdorným materiálem, zabraňte pohybu disků během přepravy a dobře označte číslem žádosti.
Zpátky v laboratoři technici provedou fyzickou a logickou diagnostiku každého disku , pokud možno vytvoří bitové obrazy, vyhodnotí stav sektorů a rozhodnou se, jak virtuálně rekonstruovat RAID. Teprve poté je předložena konečná cenová nabídka, která zahrnuje odhadované procento obnovitelných dat a přibližnou dobu realizace.
Pokud klient souhlasí, začíná samotný proces obnovy. Po stabilizaci disků a nastavení RAID v kontrolovaném prostředí specialisté vygenerují seznam přístupných souborů. Do tohoto okamžiku klient obvykle nic nezaplatil . Teprve pokud je seznam uspokojivý, data se zkopírují na nové úložné médium (externí pevný disk, náhradní NAS atd.) a odešlou se zpět klientovi, téměř vždy včetně poštovného.
Základy: jak RAID funguje uvnitř
Systém RAID je jednoduše řečeno sada fyzických disků, které jsou operačnímu systému prezentovány jako jedna logická jednotka . Klíčem je způsob distribuce dat a potenciálně parita mezi disky, aby se dosáhlo výkonu, kapacity, odolnosti proti chybám nebo jejich kombinace.
Technologie RAID umožňuje distribuci dat v pásech nebo blocích , které jsou zapisovány paralelně na více disků, což urychluje přístup kombinováním přenosů. Navíc jsou na určitých úrovních ukládána redundantní data (parita), aby se data z vadného disku přepočítala bez přerušení provozu, za předpokladu, že nejsou překročeny limity selhání stanovené v návrhu pole.
Další důležitou výhodou je možnost výměny disků za provozu v mnoha systémech. To znamená, že vadný disk lze fyzicky vyjmout a vyměnit bez nutnosti vypnutí serveru nebo úložného pole, což umožňuje řídicí jednotce rekonstruovat ztracená data na novém disku na pozadí, zatímco systém pokračuje v provozu.
Neexistuje jediná „dokonalá úroveň RAID“, která by vyhovovala všem scénářům. Každá úroveň upřednostňuje jinou rovnováhu mezi výkonem, zabezpečením a využitelnou kapacitou . Proto je před zahájením jakýchkoli oprav nebo obnovy zásadní pochopit, jaký typ RAID je nakonfigurován.
Když se něco pokazí, RAID obvykle dokáže data rekonstruovat sám, pokud je splněna plánovaná tolerance chyb. Pokud se však po sobě vyskytne několik fyzických, logických nebo lidských problémů, pole může ztratit koherenci a stát se neschopným samoobnovy, což vyžaduje zásah odborníka.
Běžné úrovně RAID a jejich charakteristiky
Každá úroveň RAIDu řídí distribuci dat a paritu mezi disky odlišně , což má za následek velmi zřetelné rozdíly v chování v případě selhání. Pochopení těchto rozdílů pomáhá posoudit skutečné riziko selhání a pravděpodobnost úspěšné obnovy.
RAID 0, známý pro svůj vysoký výkon, distribuuje data v pruzích na alespoň dva disky bez ukládání redundantních informací. To znamená, že ztráta jednoho disku má za následek ztrátu celého svazku , protože části každého souboru jsou rozptýleny na všech discích. Jeho hlavní výhodou je rychlost, ale z hlediska zabezpečení dat je velmi zranitelný.
RAID 1 neboli zrcadlení uchovává identické kopie dat na dvou discích . Pokud jeden selže, druhý pokračuje v bezproblémovém provozu. Je jednoduchý, spolehlivý a nabízí dobrou rychlost čtení, i když obětuje využitelnou kapacitu, protože dostupný prostor je ekvivalentní prostoru jednoho disku v páru. Při obnově je obvykle zachování alespoň jednoho z disků mnohem snazší.
Existují také úrovně RAID, jako je RAID 3 a RAID 4, dnes méně běžné, které kombinují datové disky s vyhrazeným paritním diskem . V RAID 3 je přístup k datovým diskům simultánní a paritní disk se stává potenciálním úzkým hrdlem, zatímco RAID 4 umožňuje nezávislejší přístup ke každému datovému disku, což zlepšuje výkon při určitých pracovních zátěžích.
RAID 5 je pravděpodobně nejrozšířenější konfigurace RAID v serverových a NAS prostředích. Distribuuje data v pruzích na více disků a prokládá paritní bloky rozdělené mezi všechny disky , aniž by pro tuto funkci vyhradil jeden disk. Tato konfigurace umožňuje obnovu dat na náhradní disk v případě selhání jednoho disku, za předpokladu, že během procesu obnovy nedojde k druhému selhání.
RAID 6 posouvá zabezpečení o krok dále tím, že pro každou datovou sadu ukládá dva paritní bloky , což mu umožňuje odolat současnému selhání až dvou disků bez ztráty dat. Vyžaduje větší diskovou kapacitu pro paritu a větší výpočetní výkon, ale na oplátku nabízí mnohem větší chybovost v případě řetězených selhání, což je vysoce ceněná funkce u velkých polí.
Kromě těchto „klasických“ úrovní RAID existují kombinace jako RAID 10 (zrcadlení + prokládání), RAID 50 nebo 60 a lineární nebo JBOD konfigurace, kde jsou disky jednoduše zřetězeny a tvoří velký svazek bez skutečné redundance. V žádném z těchto případů RAID nenahrazuje dobře navržený zálohovací systém.
Typické selhání systémů RAID a komplikace při obnově
Systémy RAID mají pověst robustnosti, a právem, ale nejsou imunní vůči problémům. V praxi dochází k fyzickým, logickým a lidským chybám , které se často vzájemně prolínají a vedou k delikátním situacím z hlediska obnovy.
Z logického hlediska je jednou z nejzávažnějších překážek ztráta nebo poškození paritních pruhů . Když dojde k degradaci metadat, která indikují, jak jsou data a parita distribuovány napříč disky, RAID již nedokáže informace sám regenerovat a je nutný externí zásah k ručnímu nebo poloautomatickému nalezení a obnovení těchto pruhů.
Pokud jde o hardware, statistiky ukazují, že v dané infrastruktuře může každý rok fyzicky selhat malé procento disků, přibližně 2–3 %. V poli s mnoha disky to znamená, že pravděpodobnost selhání alespoň jednoho není zanedbatelná. Mechanické poruchy, přepětí, vadný firmware, extrémní teploty nebo nekvalitní komponenty jsou běžnými příčinami fyzických selhání.
Problémy se zhoršují, když dojde k druhému selhání během obnovy, zejména v RAID 5 nebo konfiguracích s mnoha disky. Pokud se během regenerace dat z vadného disku na jiném disku začnou vyskytovat závažné chyby, může se stav pole z degradovaného stavu změnit na zcela nepřístupný. Pokud selže více disků, než je očekávaná tolerance , vnitřní logika RAIDu již není dostatečná a je nutné použít pokročilé techniky obnovy.
Lidská chyba doplňuje koktejl: odkládání výměny disku, který již vydával varování, ignorování alarmů řadiče, nesprávné vypínání systémů v důsledku opakovaných výpadků napájení , instalace nevhodných ovladačů , vynucování neustálých restartů nebo používání postupů údržby bez aktuálních záloh jsou praktiky, které výrazně zvyšují riziko ztráty dat.
Použití specializovaného softwaru: praktický příklad s R-Studiem
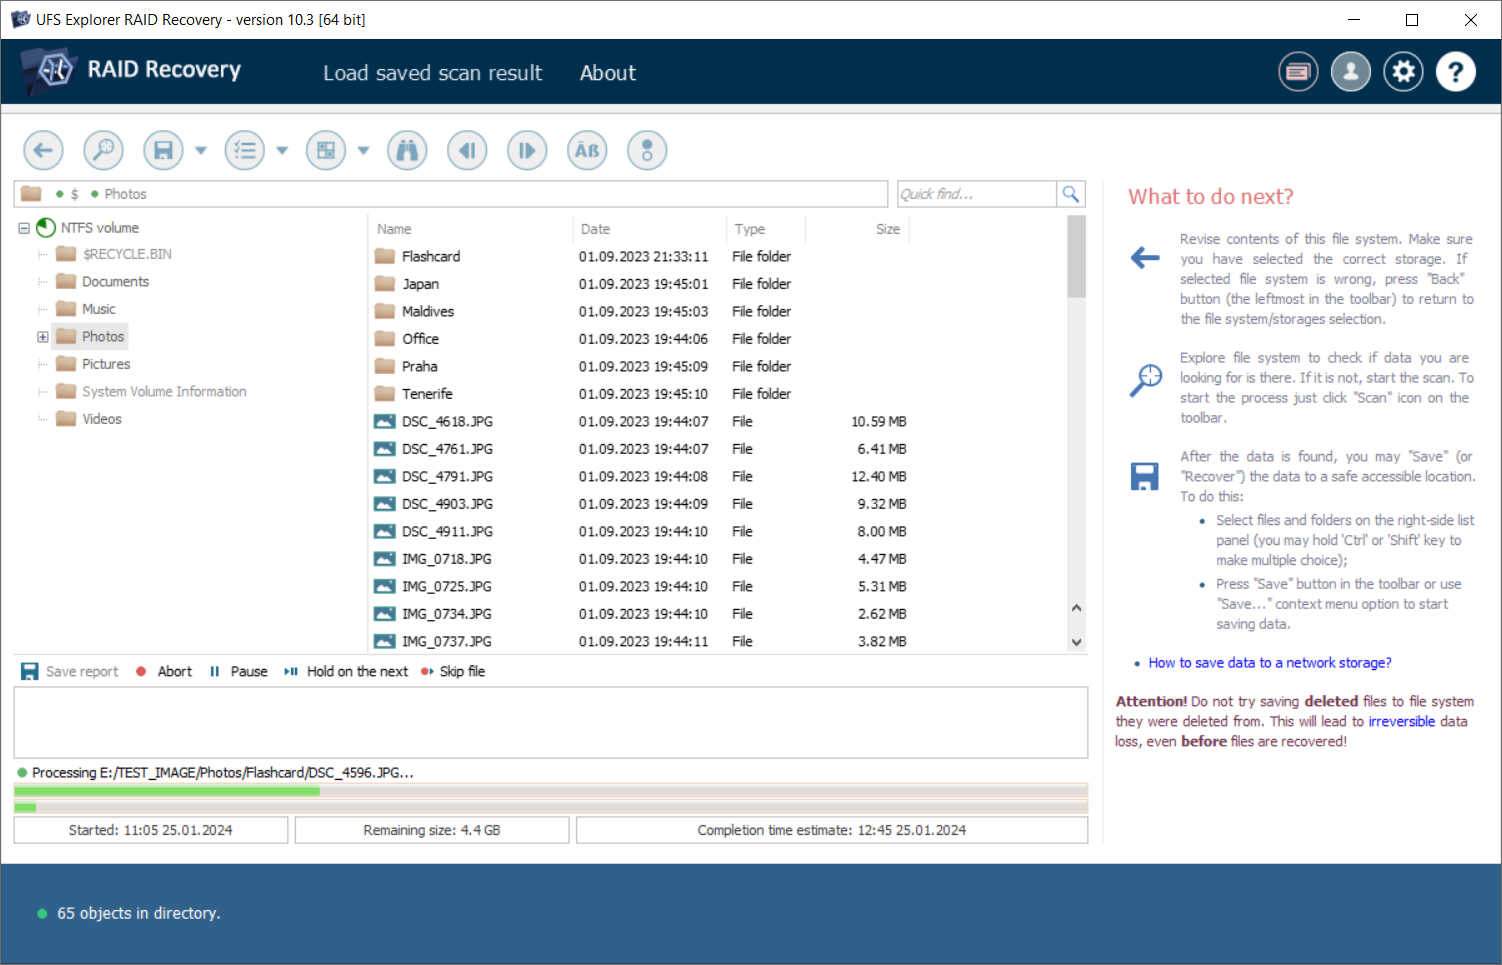
Pokud již není RAID přístupný přes původní řadič, jednou z technických možností je virtuální obnova pole pomocí specializovaného softwaru . Nástroje jako R-Studio umožňují detekovat stále konzistentní RAIDy, jako by se jednalo o normální svazky, a v závažnějších případech vytvářet virtuální RAIDy z disků nebo obrazů disků.
Princip fungování spočívá ve vytvoření virtuálního RAID pole na základě fyzických disků nebo jejich obrazů , a to ručním zadáním parametrů, jako je počet disků, velikost bloku, počáteční offset, typ RAID (0, 1, 4, 5, 6, 10, JBOD, ZFS RAIDZ, RAIDZ2 atd.) a pořadí disků. Jakmile software detekuje platný souborový systém, toto virtuální RAID pole se zobrazí jako navigovatelný svazek, ze kterého lze zobrazit a obnovit soubory.
Například pro jednoduché pole RAID 5 se třemi disky, bloky o velikosti 64 KB a asynchronní levou paritou byste jednoduše vybrali tři disky ve správném pořadí , zadali velikost bloku, nastavili příslušný offset a nechali nástroj identifikovat oddíl. Odtud můžete otevřít svazek, prozkoumat složky, zobrazit náhled souborů (zejména velkých) a ověřit, zda byla struktura správně připojena.
V složitějších konfiguracích, jako je RAID 5 s bloky o velikosti 4 KB a vlastním paritním vzorem, je nutné ručně definovat tabulku pořadí bloků . To zahrnuje zadávání řádek po řádku, který disk obsahuje každý datový nebo paritní blok, čímž se zajistí konzistence pořadí. Software vás upozorní, když v této tabulce zjistí nekonzistence, aby je bylo možné opravit před provedením změn.
Důležitým opatřením je, že tyto virtuální RAIDy jsou v rámci softwaru čistě logické objekty : na původní disky, ze kterých byly vytvořeny, nic nezapisují. To vám umožňuje experimentovat s různými kombinacemi parametrů, dokud nenajdete tu, která správně znovu sestaví souborový systém, aniž by riskovala další poškození.
V případech, kdy fyzický disk chybí, některé nástroje umožňují nahradit jej „chybějícím diskem“ nebo prázdným blokem prostoru, čímž simulují chování degradovaného RAIDu. Přesto musí být pro spolehlivou obnovu souborů všechny parametry správné; jediná nesprávná velikost bloku nebo špatně vypočítaný offset mohou poškodit extrahované soubory, a proto je důležitá technická odbornost.
Typy RAID a jejich chování při ztrátě dat
Kromě klasických úrovní RAID dnešní systémy RAID podporují širokou škálu hybridních a lineárních konfigurací . Každá z nich představuje specifické výzvy, pokud jde o obnovu dat po kritickém selhání.
V poli RAID 0 (čisté prokládání) jsou data fragmentována do malých skupin, které jsou postupně zapisovány na všechny disky v poli. Celková kapacita je součtem všech disků, ale nedochází k žádné redundanci . Pokud jeden z disků selže, celý svazek se stane nepoužitelným a jedinou možností obnovy jsou pokročilé techniky, které se pokoušejí rekonstruovat, co lze z přeživších disků udělat.
RAID 1 vždy uchovává identické kopie všech dat na každém disku v zrcadle . Tato jednoduchost je velkou výhodou v procesech obnovy, protože pokud jeden z disků zůstane neporušený, lze k jeho datům přistupovat přímo, jako by se jednalo o nezávislý disk, nebo lze jeho obsah zkopírovat na nový disk a zrcadlo později znovu vytvořit.
V úrovních RAID, jako je RAID 4 a RAID 5, kde je parita rozdělena odlišně, je použitelná kapacita obvykle součtem všech disků mínus kapacita pouze jednoho. Potřeba matematicky rekonstruovat data disku z parity je to, co komplikuje obnovu, když k selhání dochází postupně a dojde ke ztrátě více disků, než umožňuje návrh.
Lineární nebo JBOD (Just a Bunch Of Disks – jen svazek disků) konfigurace seskupují několik disků stejné nebo různé velikosti do jedné větší logické jednotky bez paralelní distribuce dat. Nenabízejí žádné významné zlepšení výkonu ani redundanci: pokud některý disk selže, přístup k celému svazku se ztratí . Obnova v těchto případech zahrnuje práci na každém disku a ruční rekonstrukci obsahu z nepostižených segmentů.
Všechny tyto scénáře zdůrazňují, že bez ohledu na to, jak pokročilé jsou technologie ukládání dat, externí a ověřené zálohy zůstávají nezbytné . RAID snižuje nebo eliminuje prostoje v případě určitých selhání, ale nechrání před náhodným smazáním, logickým poškozením, útoky malwaru nebo chybami v konfiguraci, které ničí informace na úrovni souborového systému.
Klíčové tipy pro minimalizaci rizik a ochranu vašich dat
Prvním doporučením, ať se to zdá jakkoli zřejmé, je udržovat pravidelnou politiku zálohování , která se nespoléhá na samotný RAID. To zahrnuje servery, pracovní stanice, chytré telefony, systémy NAS a jakékoli další zařízení, kde jsou uložena cenná data. Pouze tímto způsobem lze v případě vážného selhání obnovit službu, aniž bychom museli spoléhat na úspěch forenzní obnovy.
Pokud k incidentu stále dojde a neexistuje žádná použitelná záloha, nejmoudřejším postupem je vyhnout se jakémukoli pokusu o opravu svépomocí bez jasného pochopení kroků a jejich možných důsledků. Před spuštěním nástrojů pro opravu souborového systému, zahájením automatické obnovy nebo výměnou disků mezi pozicemi je vhodné poradit se se specialisty na obnovu dat a podrobně jim vysvětlit situaci.
Je také nezbytné věnovat pozornost včasným známkám selhání : disky, které začínají ukazovat realokované sektory, řadiče, které generují upozornění, systémové protokoly s upozorněními na I/O, úložná pole, která označují pole jako degradované… Ignorování těchto příznaků z lenosti nebo strachu ze zastavení služby je obvykle předehrou k mnohem vážnějšímu a nákladnějšímu selhání.
A konečně, pokud jsou data cenná, vyplatí se předem najít důvěryhodného poskytovatele služeb obnovy dat . Až přijde čas, přímý kontakt zkracuje dobu odezvy, umožňuje vám od samého začátku obdržet přesné pokyny a zvyšuje pravděpodobnost, že se vám podaří obnovit co nejvíce dat.
Zkušenosti nashromážděné v nesčetných případech ukazují, že kombinace vhodného návrhu RAID, spolehlivých záloh, klidné reakce na selhání a specializované podpory v případě potřeby je to, co skutečně rozhoduje mezi kontrolovaným panikem a katastrofickou ztrátou dat.