- Die Mikroarchitektur definiert, wie eine CPU eine ISA implementiert und bestimmt ihre IPC, ihren internen Parallelismus und ihre tatsächliche Effizienz, jenseits von Frequenz oder Cache-Größe.
- Designs wie AMD Zen und Zen 2 kombinieren optimierte Caches, Out-of-Order-Ausführung, SMT und große Vektoreinheiten, um die Leistung pro Zyklus und pro Watt zu steigern.
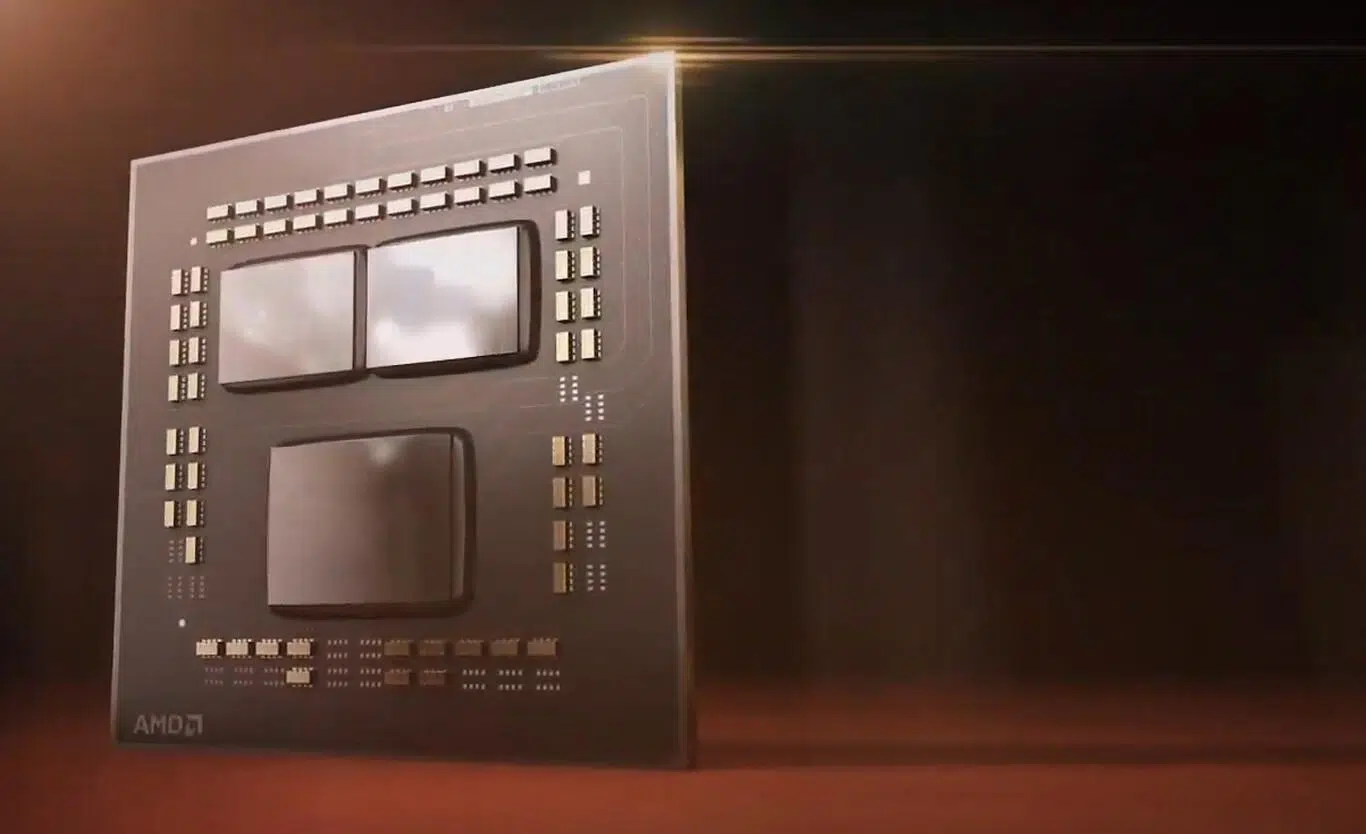
- Die Chiplet- und Infinity-Fabric-Strategie ermöglicht es, die Anzahl der Kerne in EPYC und Ryzen zu skalieren und gleichzeitig die Kosten zu kontrollieren und eine sehr wettbewerbsfähige Leistung zu erzielen.
Die Mikroarchitektur einer CPU tritt oft hinter auffälligeren Kennzahlen wie GHz oder MB Cache zurück, doch genau dort, im internen Design des Prozessors, wird der größte Teil seiner tatsächlichen Leistung, seiner Effizienz und sogar die Art von Software, die ihn am besten nutzen kann, entschieden.
Wenn Sie technische Spezifikationen lesen, die Kerne, Threads, L3-Cache oder AVX2 erwähnen , sehen Sie die konkreten Auswirkungen einer bestimmten Mikroarchitektur. Zu verstehen, wie diese Komponenten intern organisiert sind, was einen Zen 3 von einem Zen 2 oder einen Hybrid-Intel von einem klassischen Ryzen unterscheidet, ist entscheidend für die richtige Wahl Ihrer nächsten CPU und um zu wissen, warum manche Prozessoren beim Gaming, andere beim Rendering und wieder andere bei Serveraufgaben glänzen.
ISA, Makroarchitektur und Mikroarchitektur: Ordnung in die Konzepte bringen
Bevor wir uns mit den komplexen Details von Pipelines und Vorhersagemodellen befassen, ist es hilfreich, zwischen drei oft verwechselten Ebenen zu unterscheiden: Systemmakroarchitektur, ISA und Mikroarchitektur . Jede beschreibt eine andere Schicht des Computers.
Zum einen gibt es die Makroarchitektur oder das Gesamtsystemdesign , das alles umfasst, was auf dem Motherboard zu sehen ist: CPU, Speichercontroller, Busse, Hauptspeicher, Ein-/Ausgabechips, Speichercontroller, alle externen Beschleuniger und die DMA-Logik. Sie bietet einen Überblick darüber, wie die großen Hardwarekomponenten miteinander verbunden sind und wie die Daten zwischen ihnen fließen.
Darüber befindet sich die ISA (Befehlssatzarchitektur) , der Befehlssatz, den der Prozessor versteht: die Datentypen, die er verarbeitet, Wortgröße, Anzahl und Typ der Register, Adressierungsmodi, Befehlsformate usw. Wenn Sie in Assembler mit Mnemonics wie ADD, SUB, MUL programmieren oder Erweiterungen wie SSE, AVX oder NEON aufrufen, kommunizieren Sie direkt mit der ISA.
Schließlich gibt es noch den Mikrocode, auch μISA genannt , der die internen Mikrooperationen definiert, die einige komplexe Architekturen (wie x86) zur Implementierung ihrer CISC-Befehle verwenden. Dieser Mikrocode kann über Firmware aktualisiert werden, um Fehler zu beheben oder Unterstützung für neue Befehle hinzuzufügen.
Was genau ist die Mikroarchitektur einer CPU?
Die CPU-Mikroarchitektur ist im Wesentlichen der interne Bauplan, der festlegt, wie ISA-Befehle ausgeführt und Daten innerhalb des Chips übertragen werden. Zwei Prozessoren können dieselbe ISA verwenden (z. B. AMD64 bei Intel und AMD) und dennoch aufgrund ihrer Mikroarchitektur – oder vielleicht gerade deswegen – ein radikal unterschiedliches Verhalten und eine unterschiedliche Leistung aufweisen.
Dieses Design umfasst Elemente wie die Art der Steuereinheit , ob programmierbarer Mikrocode oder festverdrahtete Logik verwendet wird; die Speicherhierarchie; die Tiefe der Pipeline; wie viele Funktionseinheiten parallel arbeiten; und ob der Prozessor in der Lage ist, Befehle in beliebiger Reihenfolge und spekulativ auszuführen.
Darüber hinaus muss der Entwickler die Pipeline-Tiefe wählen : von einfachen CPUs ohne Pipelining, bei denen jede Anweisung von Anfang bis Ende verarbeitet wird, bevor die nächste gestartet wird, bis hin zu modernen Designs mit vielen Stufen (Fetch, Decode, Rename, Dispatch, Execute, Write-Back, Retire…), die es ermöglichen, Dutzende von Anweisungen gleichzeitig auszuführen.
Damit verbunden sind Anzahl und Art der Ausführungseinheiten : ALUs für ganze Zahlen, Multiplikationseinheiten, Dividierer, FPUs für skalare und vektorielle Gleitkommazahlen, AGUs (Adressgenerierungseinheiten) zur Berechnung von Speicheradressen, Sprungeinheiten usw. Bei mehreren Einheiten desselben Typs spricht man von superskalaren Prozessoren, die mehrere Befehle pro Taktzyklus ausführen können.
Dies ist die Grundlage für fortgeschrittene Techniken wie die spekulative Ausführung , bei der die CPU die Auflösung einer Verzweigung antizipiert und Anweisungen aus einer der Verzweigungen im Voraus ausführt. Ist die Vorhersage korrekt, wird Zeit gespart; schlägt sie fehl, werden die ausgeführten Operationen verworfen und die Pipeline geleert, was mit einem entsprechenden Zeitverlust verbunden ist.
Die meisten modernen Hochleistungsprozessoren nutzen auch die Out-of-Order-Ausführung (OoO) . Anstatt sich strikt an die Programmreihenfolge zu halten, ordnet der Prozessor die Befehle intern neu an und führt zuerst diejenigen aus, deren Daten bereitstehen. Dadurch werden Leerlaufzyklen vermieden, während andere auf Speicherzugriffe oder das Ergebnis vorheriger Operationen warten.
Um all dies zu ermöglichen, ohne die Semantik des Programms zu verletzen, wird eine Registerumbenennung verwendet . Der Compiler sieht eine begrenzte Anzahl logischer Register, die Mikroarchitektur übersetzt diese jedoch in einen größeren Block physischer Register und weist ihnen dynamisch neue Speicherorte zu, um falsche Abhängigkeiten aufzulösen und eine höhere Parallelität zu ermöglichen.
Schließlich kann sich das Design auf die Integration von Parallelverarbeitung auf Kern- und Thread-Ebene konzentrieren . Dies umfasst alles von Einkern-CPUs bis hin zu Chips mit Dutzenden oder Hunderten von Kernen (Manycore), Multiprozessorsystemen mit mehreren Sockeln, die über Hochgeschwindigkeits-Mesh-Netzwerke (Infinity Fabric, Intel Mesh, NVLink usw.) miteinander verbunden sind, sowie die Unterstützung von Simultaneous Multithreading (SMT), sodass jeder physische Kern zwei oder mehr logische Threads verarbeiten kann.
Kompatibilitäts-, ISA- und Mikroarchitekturfamilien
Da eine Mikroarchitektur lediglich eine spezifische Implementierung einer Befehlssatzarchitektur (ISA) darstellt , kann eine einzelne ISA im Laufe der Jahre und bei verschiedenen Herstellern Dutzende unterschiedlicher Mikroarchitekturen aufweisen. Genau dies ist bei x86-64/AMD64 oder ARM der Fall.
Betrachtet man ausschließlich AMD innerhalb der AMD64-ISA, findet man so unterschiedliche Familien wie K8/Hammer, K10, Bulldozer und die gesamte Zen-Serie (Zen, Zen+, Zen 2, Zen 3, Zen 4 usw.). Sie alle führen zwar denselben grundlegenden Befehlssatz aus, aber ihre interne Organisation, Caches, Pipelines und Ansätze zur parallelen Ausführung unterscheiden sich grundlegend.
Beim Wechsel der Architekturspezifikation (ISA) ist der Kompatibilitätssprung absolut. Ein ARM-A64 -basierter Prozessor (wie Apple Silicon) kann keine für x86-64 kompilierten Binärdateien ausführen und umgekehrt, es sei denn, es wird eine Übersetzungs- oder Emulationsschicht wie Rosetta 2, QEMU oder eine ähnliche verwendet, was mit entsprechenden Leistungseinbußen verbunden ist.
Selbst bei Prozessoren mit demselben Befehlssatz (ISA) gibt es keine Garantie, dass sie alle denselben Befehlssatz oder dieselben Erweiterungen unterstützen. Ältere Chips verfügen möglicherweise nicht über AVX2 oder AVX-512, oder ein ARM-SoC implementiert unter Umständen nur eine Teilmenge optionaler Erweiterungen. Daher kann es vorkommen, dass eine Binärdatei, die AVX-512 intensiv nutzt, auf einer CPU, die lediglich SSE4 unterstützt, nicht startet.
Beim Kompilieren von Software ist es üblich, generische Binärdateien für eine bestimmte Architekturspezifikation (z. B. x86-64 mit mindestens SSE2) zu erzeugen, ohne eine bestimmte Mikroarchitektur vollständig auszunutzen, damit die ausführbare Datei auf möglichst vielen CPUs läuft. Kompiliert man jedoch mit Optimierungsflags für eine spezifische Mikroarchitektur (z. B. `-march=znver3`, `-mtune=skylake`), lässt sich die Leistung auf dieser speziellen Familie deutlich verbessern, allerdings auf Kosten der Kompatibilität mit anderen.
ISA-Lizenzen und geistiges Eigentum des Designs
Nicht nur Programmcode ist durch Lizenzen geschützt: Auch Befehlssatzarchitekturen (ISAs) und Mikroarchitekturen sind geistiges Eigentum. Niemand darf eine x86- oder AMD64-ISA ohne Lizenz legal klonen, genauso wie ein proprietäres CPU-Design nicht ohne Genehmigung kopiert werden darf.
Im Bereich der Befehlssatzarchitekturen (ISAs) gibt es drei Hauptansätze. Zum einen existieren geschlossene ISAs , bei denen der Eigentümer streng kontrolliert, wer kompatible Kerne implementieren darf. Das klassische Beispiel ist IA-32 (x86-32), das historisch im Besitz von Intel war und dessen Lizenzen – nicht ohne Rechtsstreitigkeiten – an AMD, VIA und andere vergeben wurden.
Eine ähnliche Situation besteht bei AMD64/x86-64 , das ursprünglich von AMD entwickelt und später im Rahmen von Cross-Lizenzvereinbarungen an Intel (wo es EM64T genannt wurde) lizenziert wurde. Auch andere Anbieter, wie beispielsweise Hygon in China, haben Lizenzen für bestimmte Versionen erworben (zum Beispiel Zen 1 für den chinesischen Markt).
Dann gibt es ISAs mit flexibler Lizenzierung , bei denen der Anbieter sowohl ISA-Lizenzen als auch sofort einsatzbereite IP-Cores anbietet. ARM, SPARC oder OpenPOWER fallen in diese Kategorie: Man kann Cortex A/M/R oder Neoverse entweder direkt nutzen oder eine Lizenz erwerben, die es erlaubt, eigene Mikroarchitekturen auf Basis der ISA zu entwickeln, wie Apple es mit M1/M2/M3 oder Qualcomm mit Kryo tut.
Schließlich gibt es Open-Source -ISAs , mit denen jeder kompatible Mikroarchitekturen erstellen kann, ohne Lizenzgebühren für die ISA zahlen zu müssen (obwohl die eigene Implementierung patentiert oder proprietär sein kann). RISC-V ist das beste Beispiel: Die ISA steht unter einer freizügigen BSD-Lizenz, und es gibt Optionen, die von vollständig offenen Kerneln in Verilog oder Chisel bis hin zu geschlossenen kommerziellen Designs reichen.
Zusätzlich zur ISA stellt jede spezifische Mikroarchitektur (z. B. ein Zen-4-Kern, ein Cortex-X4-Prozessor, ein GPU-Design) einen Block patentierter oder eingetragener Schutzrechte dar. Darüber hinaus gibt es hier auch offene Designs, die als Soft-Cores in HDL für die Synthese in FPGAs oder die Integration in kundenspezifische SoCs veröffentlicht sind.
Ein genauerer Blick auf moderne Mikroarchitekturen: der Fall AMD Zen
Um zu sehen, wie sich all das in der Praxis auswirkt, ist die detaillierte Analyse einer bestimmten Produktfamilie unerlässlich. AMD hat sein Geschäft dank Zen und seinen Nachfolgegenerationen grundlegend verändert und sich von der schwierigen Bulldozer-Ära und den alten FX-Prozessoren zu einem direkten Konkurrenten (und teilweise sogar Überflügeln) von Intel auf den Märkten für Desktop-PCs, Server und Laptops entwickelt.
Nach dem Scheitern der AMD-Fusion- Strategie restrukturierte das Unternehmen und entschied sich unter anderem für ein Hochleistungsdesign, das unter anderem von Jim Keller geleitet wurde. Der Zen-Plan zielte darauf ab, die IPC (Instructions per Cycle) im Vergleich zu Bulldozer deutlich zu steigern, die Leistung pro Watt zu verbessern und bei der Single-Core-Leistung, in der Intel jahrelang führend war, wieder Boden gutzumachen.
Eine der wichtigsten Änderungen war die Stärkung des Frontends , also des Teils, der für das Abrufen und Vorbereiten von Befehlen zuständig ist. Zen führte einen Mikrooperations-Cache ein , der bereits dekodierte Mikrooperationen speichert, ähnlich wie es einige Intel-Mikroarchitekturen wie Conroe taten. Bulldozer fehlte dieser Cache und setzte stattdessen stärker auf die klassische Befehlscache-Hierarchie, was sich negativ auf den Durchsatz auswirkte.
Der Decoder von Zen kann bis zu vier CISC x86-64-Befehle pro Taktzyklus in RISC-ähnliche Mikrooperationen übersetzen. Diese Mikrooperationen werden dann in eine Warteschlange gestellt, die vom Mikrooperationspuffer gespeist wird. Dieser wiederum kann bis zu sechs Mikrooperationen pro Taktzyklus an die Backend-Scheduler weiterleiten. Hier beginnt die Out-of-Order-Ausführung.
AMD trennte die Pfade für Integer- und Gleitkommaverarbeitung klar . Auf der Integerseite werden ALUs, AGUs und die Lade-/Speicherlogik aus der Mikrooperationswarteschlange gespeist. Diese Logik kann pro Taktzyklus zwei 16-Byte-Ladevorgänge und einen 16-Byte-Speichervorgang aus einem 32 KB großen, 8-fachen L1D-Speicher mit Write-Back-Strategie durchführen.
Die Gleitkomma- und Vektorseite speist FMAC- und AVX-Einheiten. Mit zwei Multiplikations- und zwei Additionsports kann Zen pro Taktzyklus gleichzeitig zwei 128-Bit-FMA-Operationen oder eine 256-Bit-AVX-Operation ausführen. Diese Parallelität auf Befehlsebene ist einer der Schlüssel zu seiner hohen Leistungsfähigkeit bei rechenintensiven Aufgaben.
Cache-Hierarchie, TLB und Speicherorganisation in Zen
Die Speicherhierarchie in Zen ist in drei Cache-Ebenen unterteilt: einen separaten L1-Cache für Befehle und Daten, einen privaten L2-Cache pro Kern und einen gemeinsam genutzten L3- Cache. Obwohl die Grundstruktur früherer Mikroarchitekturen beibehalten wurde, wurden Größe, Assoziativität und Richtlinien verfeinert.
Der L1I -Befehlscache bietet 64 KB pro Kern mit 4 assoziativen Pfaden. Dadurch verdoppelt sich die Anzahl der Pfade pro Modul im Vergleich zu Bulldozer, was Konflikte reduziert. Der L1D -Datencache wurde auf 32 KB, 8 Pfade und eine Write-Back-Strategie erweitert, verglichen mit 16 KB, 4 Pfaden und Write-Through bei Bulldozer. Dies verbessert sowohl die Trefferrate als auch die Schreibeffizienz deutlich.
Der L2- Cache ist mit 512 KB pro Kern und 8-facher Assoziativität implementiert, im Gegensatz zu den 2 MB und 16-facher Assoziativität pro Modul der vorherigen Generation. Der L3- Cache bietet hingegen mehrere MB pro Kern mit 16-facher Assoziativität und dient als letzte gemeinsam genutzte Ebene vor dem Zugriff auf den DRAM.
Parallel dazu unterteilt Zen die TLBs in ITLBs (für Befehle) und DTLBs (für Daten) , die jeweils mehrere Ebenen und Hunderte von Einträgen umfassen und alle über Paritätsschutz verfügen. Dies reduziert die Latenz der Übersetzung virtueller in physische Adressen erheblich, was mit zunehmender Speichergröße immer wichtiger wird.
Wenn wir von einem 2-, 4- oder 8-fach assoziativen Cache sprechen , beschreiben wir seine Assoziativität, die eng mit dem Konzept des Interleaving im Speicher zusammenhängt. Höhere Assoziativität bedeutet mehr verschiedene Möglichkeiten, einen Speicherblock im Cache zu speichern, wodurch Konflikte reduziert werden. Dies geht jedoch mit einer etwas komplexeren Logik und einer geringfügig höheren Latenz einher.
Es ist außerdem wichtig, den Unterschied zwischen Write-Through und Write-Back zu verstehen . Beim Write-Through werden Cache und Hauptspeicher bei jedem Schreibvorgang gleichzeitig aktualisiert. Dies vereinfacht die Datenkonsistenz , erhöht aber den Datenverkehr. Beim Write-Back wird nur der Cache beschrieben und die entsprechende Zeile mit einem Dirty-Bit markiert. Der DRAM wird erst aktualisiert, wenn diese Zeile aus dem Cache entfernt wird. Dadurch wird Bandbreite gespart und die Leistung verbessert, allerdings auf Kosten einer etwas komplexeren Logik.
Zen und Zen+: Ein Quantensprung bei Kosten pro Index und Effizienz
Zen stellte für AMD im Vergleich zu Bulldozer einen sehr bedeutenden IPC-Sprung dar , dank der Kombination aus einem besseren Frontend, einem besseren Sprungvorhersager, mehr Ausführungseinheiten, SMT anstelle von CMT (jeder vollständige Kern verarbeitet zwei Threads, anstatt einen Teil der FPU zwischen zwei logischen Kernen zu teilen) und einer wesentlich sinnvolleren Cache-Hierarchie.
Neben dem Design profitierte AMD von fortschrittlicheren Fertigungsprozessen mit FinFET und kleineren Strukturgrößen . Diese ermöglichen eine höhere Transistordichte, einen geringeren Stromverbrauch bei gleicher Leistung und höhere Frequenzen bei gleichzeitig akzeptabler TDP ( Spannungs-Frequenz-Kennlinie ). Dieses optimale Verhältnis von Leistung zu Watt war entscheidend für die Wiedererlangung der Wettbewerbsfähigkeit bei Laptops und Servern.
Der Übergang von Bulldozer zu Zen brachte auch längere Warteschlangen für die Ausführungsreihenfolge, größere Befehlsplaner, eine höhere interne Bandbreite, Sprungvorhersage mit Techniken, die sogar auf einfachen neuronalen Netzen basieren, und eine SMT mit sich, die in der Lage ist, die verfügbaren Ausführungseinheiten besser auszunutzen.
In diesem Kontext erscheint Zen+ , das man als Äquivalent eines „Ticks“ in Intels alter Tick-Tock-Strategie betrachten könnte: dasselbe Grunddesign wie Zen, jedoch gefertigt in einem verfeinerten Fertigungsprozess, mit höheren Frequenzen, leicht reduzierter Latenz und optimierten internen Timings. Es handelt sich nicht um eine architektonische Revolution, sondern um eine Verfeinerung, die zu einigen zusätzlichen Leistungspunkten führt.
Zen 2: Chiplets, vollständiges AVX2 und tiefgreifende Optimierung
Mit Zen 2 beschränkt sich AMD nicht mehr nur auf die Optimierung des Fertigungsprozesses: Das Unternehmen führt grundlegende Änderungen an der Mikroarchitektur ein und treibt seine Chiplet- Strategie massiv voran . Anstelle eines einzelnen großen monolithischen Chips teilt AMD das Design in mehrere kleinere 7-nm-Rechenchips (CCDs) und einen separaten 12-nm-I/O-Chip auf, der Speicher, PCIe und Verbindungen verwaltet.
Dieser Chiplet-Ansatz verbessert die Ausbeute pro Wafer (kleine, fehlerfreie Chips lassen sich einfacher herstellen), senkt die Kosten und ermöglicht eine einfachere Skalierung der Kernanzahl: Durch Hinzufügen weiterer CCDs lassen sich 16, 32 oder mehr Kerne in EPYC und Threadripper realisieren. Der Nachteil ist eine etwas komplexere interne Kommunikation, die auf der Infinity Fabric-Verbindung basiert, welche AMD Generation für Generation optimiert hat.
Was die reine Leistung betrifft, spricht AMD von einer IPC von rund 15 % für Zen 2 im Vergleich zu Zen+ bei gleicher Frequenz und einer Gesamtleistungssteigerung pro Watt von rund 75 % im Vergleich zum ersten Zen, wenn Design- und Prozessverbesserungen zusammengezählt werden.
Im Vektor-Backend schließt Zen 2 die Lücke: Es bietet volle 256-Bit-AVX2-Unterstützung in einer einzigen Mikrooperation , ohne die Befehle wie bei Zen/Zen+ in zwei 128-Bit-Operationen aufzuteilen. Dadurch arbeiten die Vektorausführungseinheiten nun tatsächlich mit 256 Bit und können AVX2-Workloads mit voller Geschwindigkeit und deutlich geringeren Frequenzverlusten als in anderen Architekturen verarbeiten.
Der Mikro-Operations-Cache wird ebenfalls verstärkt und auf 4 Einträge (doppelte Größe) vergrößert. Dabei wird ein Teil der Fläche genutzt, die durch die Halbierung des L1I-Caches und die gleichzeitige Verdopplung seiner Assoziativität von 4 auf 8 Stellen frei wird. Interne Simulationen von AMD ergaben, dass für die meisten realen Arbeitslasten ein größerer Mikro-Operations-Cache vorteilhafter ist als ein größerer L1I-Cache.
Die Kapazität des L3-Caches pro Kernblock wurde verdoppelt , was dazu beiträgt, Fehler auf der letzten Ebene zu reduzieren. Allerdings erhöht sich die Zugriffszeit von etwa 35 auf 40 Zyklen. Um diesen Effekt abzumildern, verbessert Zen 2 die Bandbreiten für Laden und Speichern und optimiert die Vorabrufstrategie.
Ein weiterer wichtiger Aspekt ist die Zweigvorhersage. Zen 2 verwendet einen TAGE- Vorhersager (TAGG GEometric) mit über 7 Einträgen, der variable Verlaufslängen und getaggte Einträge nutzen kann. Dies reduziert Aliasing zwischen verschiedenen Zweigen und senkt laut AMD die Anzahl falscher Vorhersagen im Vergleich zum Vorgänger um etwa 30 %. Dies führt direkt zu weniger Pipeline-Flushes und einer höheren IPC.
Zen 2 Backend: AGUs, Puffer und angepasste Latenzen
Im gesamten Backend führt Zen 2 weiterhin bis zu sechs Mikrooperationen pro Zyklus aus dem Reorder-Puffer aus, der auf etwa 224 Einträge erweitert wurde (gegenüber 192 Einträgen bei Zen). Die Scheduling-Einheiten sind in vier Warteschlangen für ALUs mit je 16 Einträgen und eine Warteschlange für AGUs mit 28 Einträgen unterteilt.
Die Anzahl der Adressgenerierungseinheiten (AGUs) erhöht sich von zwei auf drei, wobei diese nicht alle identisch sind: Zwei von ihnen können sowohl Lese- als auch Schreibvorgänge verarbeiten, während die dritte auf Speicheroperationen spezialisiert ist. Diese Aufteilung ist für typische Softwareprofile ausgelegt, bei denen Lesevorgänge in der Regel häufiger und kritischer als Speicheroperationen auftreten.
Im Gleitkommabereich kann das Backend vier Mikrooperationen pro Taktzyklus an seine 256-Bit-FMA-Vektoreinheiten verarbeiten, die von einem physischen Registerfile mit 160 Einträgen unterstützt werden. Die 256-Bit-Lade-/Speicherpfade wurden optimiert, um diese Einheiten auch unter hoher Vektorlast mit einer konstanten Rate zu versorgen.
Zen 2 optimiert zudem die Latenzzeiten bestimmter Operationen : Beispielsweise wird die Latenz der Gleitkomma-Multiplikation von 4 auf 3 Zyklen reduziert, was bei sehr engen numerischen Berechnungsschleifen von Vorteil ist. Darüber hinaus gibt es eine Reihe kleiner Optimierungen entlang der gesamten Pipeline, die zusammen die in synthetischen Benchmarks und realen Anwendungen beobachtete höhere IPC (Instructions Per Cycle) bewirken.
Hinsichtlich der internen Hierarchie der Kerngruppen verwendet AMD das CCX-Konzept (Core Complex) : ein Block aus vier Kernen, die sich denselben L3-Cache teilen (16 MB in Zen 2). Diese größere Speicherkapazität führt zwar zu einer etwas höheren Latenz, reduziert aber im Gegenzug die Ausfallrate, insbesondere bei Anwendungen mit großen Arbeitssätzen.
Zur Orientierung seien die ungefähren internen Latenzzeiten genannt: etwa 4 Zyklen für L1 , etwa 12 für L2 und etwa 40 Zyklen für L3. Entscheidend ist, möglichst viele Daten in L1/L2 zu halten und den Datenverkehr zu L3 und DRAM zu reduzieren – ein Ziel, das durch das Zusammenspiel von Mikroarchitektur und Compilern erreicht wird.
Infinity Fabric: Der in Chiplets verwendete Klebstoff und seine Auswirkungen auf die Leistung
Eine Komponente, die nicht immer mit Mikroarchitektur in Verbindung gebracht wird, aber in Zen 2 und späteren Generationen unerlässlich ist, ist Infinity Fabric . Dieser proprietäre Bus dient als Kommunikationsschnittstelle zwischen CCXs, CCDs, dem I/O-Die, dem Speicher und allgemein zwischen allen Blöcken des SoC.
Infinity Fabric ist eine Weiterentwicklung von HyperTransport , dem Hochgeschwindigkeitsbus, den AMD vor Jahren als Pionier entwickelte und der auch von Drittanbietern wie NVIDIA, Cisco, Sun und anderen Konsortiumsmitgliedern eingesetzt wurde. IF übernimmt die Philosophie skalierbarer Punkt-zu-Punkt-Verbindungen, ist aber an die Bedürfnisse moderner SoCs und der CPU-GPU-Verbindung angepasst.
Mit Zen 2 führt AMD IF2 ein , das PCIe 4.0 unterstützt und einen 512-Bit-internen Bus zwischen den CCXs bietet – doppelt so viel wie die erste Version. Dies führt zu einer höheren effektiven Bandbreite und einer Effizienzsteigerung von schätzungsweise 27 % gegenüber IF1, wodurch die Leistungseinbußen beim Umschalten zwischen Chiplets reduziert werden.
Darüber hinaus ist der Infinity Fabric-Takt teilweise vom DRAM-Takt entkoppelt , wodurch der Hauptspeicher in bestimmten Szenarien auf höhere Frequenzen skalieren kann, ohne dass IF unbedingt mithalten muss. Dies bietet Enthusiasten und Systemdesignern mehr Spielraum für die Feinabstimmung.
Bei Serverprozessoren wie EPYC mit vier oder mehr Compute-Chiplets ermöglicht Infinity Fabric die Verbindung aller Chips mit nahezu vollständigen Topologien (180º-Drehungen, direkte Verbindungen usw.) und erreicht so Bandbreiten von Chip zu Chip, die je nach Geschwindigkeit des verwendeten DDR-Speichers leicht 150 GB/s bidirektional überschreiten können.
Die Kombination aus einer robusten Mikroarchitektur in jedem Kern , einem skalierbaren Design mit Chiplets und ausreichend schnellen Verbindungen ermöglicht es AMD, CPUs mit 32, 64 oder mehr Kernen zu montieren, die bei hochparallelen Arbeitslasten eine hervorragende Leistung erbringen und gleichzeitig eine wettbewerbsfähige IPC pro Thread beibehalten.
Beim Vergleich von Prozessoren in Gaming-Benchmarks, 3D-Rendering, umfangreichen Kompilierungen oder wissenschaftlichen Simulationen sagen GHz-Zahlen und Kernanzahl letztendlich nur einen Teil der Wahrheit aus. Entscheidend ist, wie die Mikroarchitektur die interne Ausführung orchestriert , wie sie jeden Taktzyklus nutzt oder verschwendet und welche Kompromisse der Hersteller zwischen Latenz, Bandbreite, Stromverbrauch und Komplexität eingegangen ist.

Index
- 1 ISA, Makroarchitektur und Mikroarchitektur: Ordnung in die Konzepte bringen
- 2 Was genau ist die Mikroarchitektur einer CPU?
- 3 Kompatibilitäts-, ISA- und Mikroarchitekturfamilien
- 4 ISA-Lizenzen und geistiges Eigentum des Designs
- 5 Ein genauerer Blick auf moderne Mikroarchitekturen: der Fall AMD Zen
- 6 Cache-Hierarchie, TLB und Speicherorganisation in Zen
- 7 Zen und Zen+: Ein Quantensprung bei Kosten pro Index und Effizienz
- 8 Zen 2: Chiplets, vollständiges AVX2 und tiefgreifende Optimierung
- 9 Zen 2 Backend: AGUs, Puffer und angepasste Latenzen
- 10 Infinity Fabric: Der in Chiplets verwendete Klebstoff und seine Auswirkungen auf die Leistung