- Die Echtzeit-Überwachung des Netzwerkverkehrs ermöglicht es, Ausfälle vorherzusehen, die Leistung zu verbessern und die Sicherheit der IT-Infrastruktur zu stärken.
- Open-Source-Tools wie Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS oder Observium bieten erweiterte Funktionen ohne Lizenzkosten.
- Die Kombination aus Metriksammlern, Zeitreihendatenbanken und Visualisierungsebenen wie Grafana und Graphite schafft hochflexible und skalierbare Lösungen.
- Die Definition von Anforderungen, die Anwendung bewährter Verfahren und die Durchführung eines Machbarkeitsnachweises sind entscheidend für die Auswahl und den Einsatz der am besten geeigneten Monitoring-Plattform.
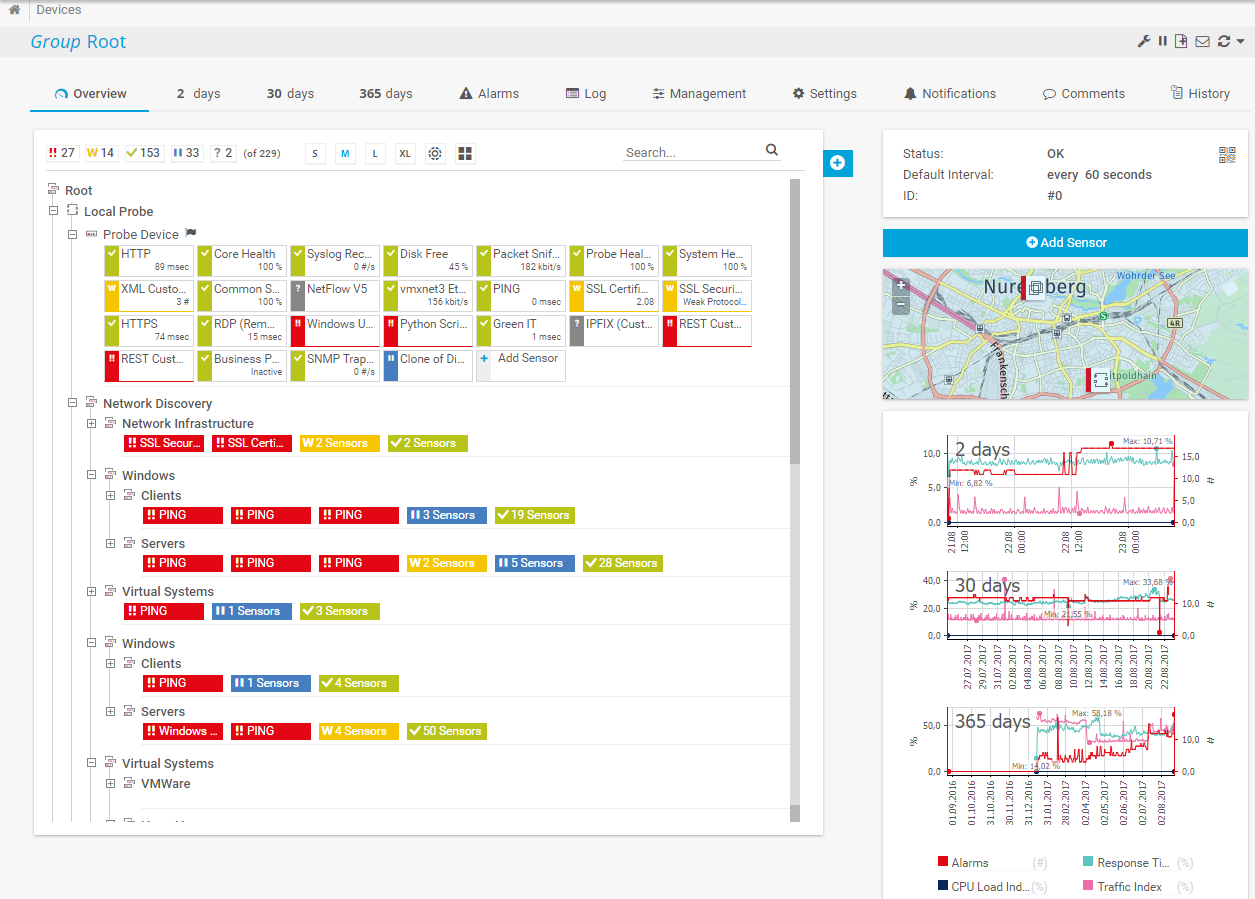
Wenn das Firmennetzwerk langsamer wird, die WLAN-Verbindung abbricht oder ein kritischer Server im ungünstigsten Moment ausfällt, reicht es nicht mehr aus, einfach den Router neu zu starten und auf Besserung zu hoffen. Heutzutage sind Open-Source-Tools zur Netzwerküberwachung unerlässlich , mit denen sich die Vorgänge in Echtzeit verfolgen, Probleme vorhersehen und kostspielige Ausfallzeiten vermeiden lassen.
Wer in der IT oder im Netzwerkbereich arbeitet oder schon einmal die technische Leitung in seinem Unternehmen innehatte, kennt wahrscheinlich Lösungen wie PRTG oder SolarWinds – und deren Lizenzen. Die gute Nachricht: Es gibt ein ausgereiftes Ökosystem an Open-Source-Plattformen zur Überwachung von Geräten, Diensten und Netzwerkverkehr (Router, Switches, WLAN-Zugangspunkte, Server, Container, Public Clouds und vieles mehr) – ohne überhöhte Gebühren und mit unglaublicher Flexibilität.
Was ist Echtzeit-Netzwerkverkehrsüberwachung und warum ist sie so wichtig?
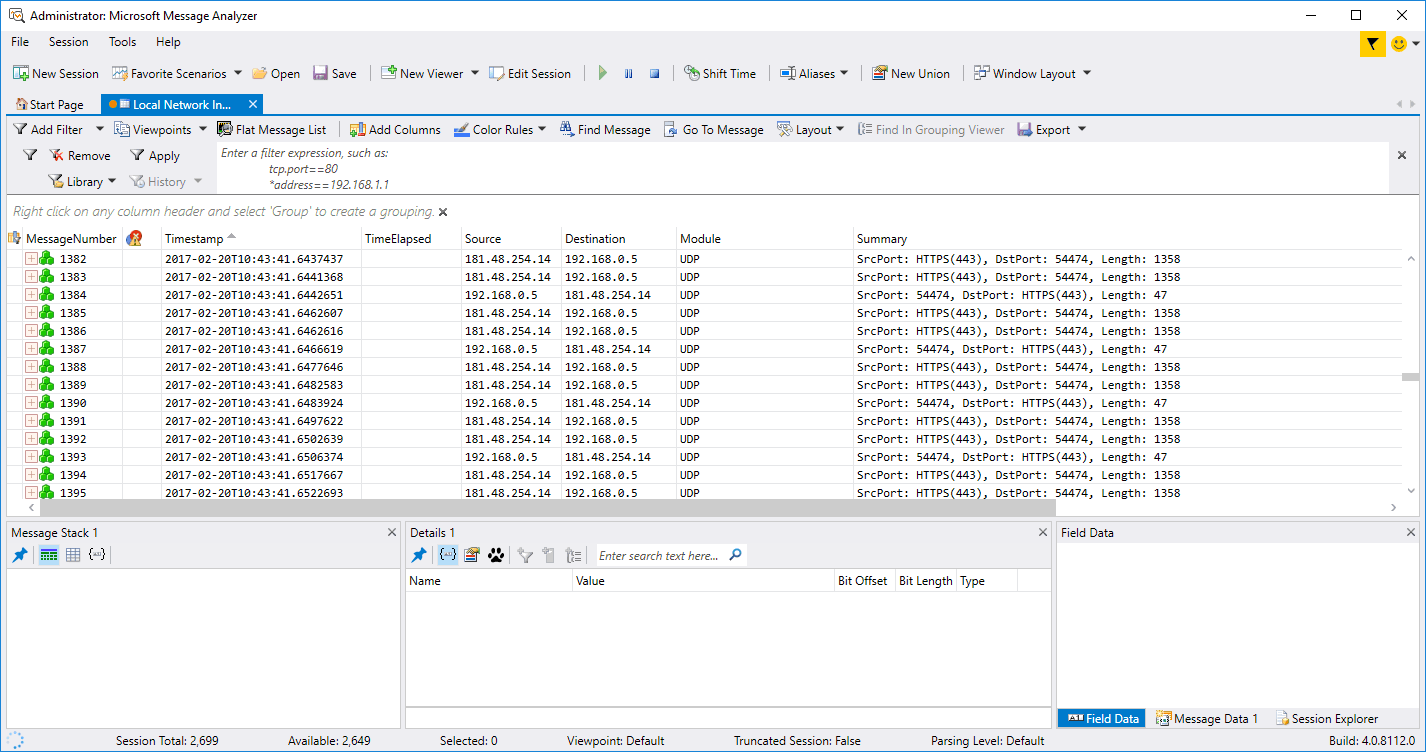
Bei Echtzeit-Netzwerküberwachung meinen wir die kontinuierliche Überwachung von Status, Leistung und Sicherheit der IT- und Kommunikationsinfrastruktur sowie die Erkennung von Vorfällen im Moment ihres Auftretens. Die Software erfasst und analysiert permanent Kennzahlen von Geräten, Systemen und Anwendungen, sodass das IT-Team reagieren kann, bevor das Problem Auswirkungen auf den Geschäftsbetrieb hat.
Diese Art von Lösungen basiert auf Protokollen wie SNMP, NetFlow/sFlow, ICMP , APIs und spezifischen Agenten, um Daten von Routern, Switches, Firewalls, Zugangspunkten, physischen und virtuellen Servern, Containern, Cloud-Diensten, Webanwendungen, Datenbanken und praktisch jedem Element, das Teil der Infrastruktur ist, zu sammeln.
Das Hauptziel besteht darin, vollständige Transparenz über Datenverkehr, Bandbreitennutzung, Verfügbarkeit und den Zustand jeder Komponente zu gewährleisten . Dies ermöglicht die Erkennung von Engpässen , Angriffen, Hardwareausfällen oder Überlastungen, bevor es zu Ausfällen, flächendeckenden Leistungseinbußen oder Datenverlusten kommt.
Neben Live-Daten ermöglichen viele Tools auch das Speichern historischer Kennzahlen für Trendanalysen , Kapazitätsplanung, Überprüfung der SLA/OLA-Konformität, Sicherheitsaudits und zur Unterstützung von Investitionsentscheidungen in neue Geräte oder Verbindungen.
Hauptanwendungen und Vorteile der Echtzeitüberwachung
Einer der größten Vorteile ist die vorbeugende Wartung der IT- und Netzwerkinfrastruktur . Kontinuierliche Messwerte zu CPU, Arbeitsspeicher, Temperatur, Stromversorgungsstatus, Schnittstellenfehlern und Paketverlusten helfen, frühzeitig Anzeichen von Ausfällen zu erkennen, bevor es zu schwerwiegenden Störungen oder Dienstausfällen kommt.
Eine frühzeitige Reaktion auf Sicherheitsvorfälle ist ein weiterer wichtiger Baustein. Überwachungsplattformen generieren individuell anpassbare Benachrichtigungen (E-Mail, SMS, Slack, Teams, Webhooks usw.), sobald ein Wert einen Schwellenwert überschreitet, ein Dienst nicht mehr reagiert oder ein verdächtiges Datenverkehrsmuster auftritt. Dadurch werden Ausfallzeiten und die Auswirkungen von Sicherheitsvorfällen oder Leistungsstörungen drastisch reduziert.
Im täglichen Betrieb trägt die Überwachung zur Optimierung der Gesamtleistung von Netzwerken, Servern und Anwendungen bei. Die Möglichkeit, überlastete Verbindungen, ressourcenintensive Dienste oder Zeitzonen mit Spitzenlasten zu erkennen, hilft dabei, Konfigurationen anzupassen, Lasten auszugleichen, QoS-Richtlinien neu zu definieren und allgemein die Leistung der installierten Technologie zu verbessern.
Ein weiterer, zunehmend wichtiger Aspekt ist die Einhaltung gesetzlicher Vorschriften. Ein gutes Überwachungssystem erleichtert die Zugriffskontrolle, die Nachverfolgung sensibler Daten und die Erkennung unberechtigter Zugriffe und liefert Protokolle und Kennzahlen, die für Audits und den Nachweis der Einhaltung gesetzlicher oder vertraglicher Anforderungen nützlich sind.
Schließlich werden diese Lösungen aus geschäftlicher Sicht zu Entscheidungshilfen : regelmäßige Berichte, Management-Dashboards, historische Analysen von Vorfällen und Verfügbarkeit, Vergleiche zwischen Standorten oder Cloud-Anbietern… all dies hilft, Investitionen zu rechtfertigen, mit Dritten zu verhandeln und IT-Projekte zu priorisieren.
Spezifische Vorteile von Open-Source-Überwachungssoftware
Der erste offensichtliche Vorteil von Open-Source-Tools ist ihre Kosteneffizienz: Es gibt keine proprietären Lizenzen oder hohe Gerätegebühren wie bei vielen kommerziellen Plattformen. Das heißt nicht, dass alles kostenlos ist (Infrastruktur-, Support- und Schulungskosten fallen immer an), aber die Einsparungen bei den Lizenzen schaffen Spielraum für Investitionen in andere wichtige Bereiche.
Die zweite große Stärke ist die Unterstützung und Innovation durch die Community . Projekte wie Nagios, Zabbix, Prometheus, LibreNMS und Netdata verfügen über sehr aktive Communities, die Plugins, Integrationen, Dashboards und ständige Verbesserungen entwickeln sowie Fehler schnell beheben und Sicherheitslücken schließen.
Es zeichnet sich außerdem durch seine Code-Transparenz und Vertrauenswürdigkeit aus : Als Open-Source-Software kann jeder die Datenverarbeitung und -speicherung überprüfen, die Systemsicherheit beurteilen und den Quellcode an spezifische Bedürfnisse anpassen. Dies reduziert das Risiko versteckter Hintertüren und erleichtert die Einhaltung interner Sicherheitsrichtlinien.
Ein weiterer wichtiger Punkt ist die Vermeidung von Anbieterabhängigkeit. Mit offenen Lösungen ist es einfacher, zwischen Tools zu migrieren oder sie zu kombinieren (zum Beispiel Prometheus für Anwendungsmetriken, Zabbix für Netzwerkgeräte und Grafana als einheitliche Visualisierungsebene), ohne für die gesamte Lebensdauer an die Roadmap eines einzelnen Unternehmens gebunden zu sein.
Natürlich erfordern Open-Source-Tools in der Regel ein gewisses Maß an technischem Können für Installation, Konfiguration und Wartung , bieten im Gegenzug aber Flexibilität und Leistungsfähigkeit, die mit vielen kommerziellen Lösungen konkurrieren können, insbesondere in Umgebungen, in denen Anpassung und Integration in bestehende Systeme geschätzt werden.
Die besten Open-Source-Überwachungstools für Netzwerke und Infrastruktur
Es gibt Dutzende ausgereifter Projekte zur Überwachung von Netzwerken, Servern, Anwendungen und Cloud-Umgebungen. Nachfolgend finden Sie eine Übersicht der wichtigsten Open-Source-Tools für Netzwerkverkehr und Observability , basierend auf verschiedenen technischen Analysen und spezialisierten Vergleichen.
Ein klassisches Beispiel ist Nagios Core , eine äußerst robuste Monitoring- und Alarmierungsplattform. Sie dient als Grundlage für zahlreiche Nagios-Projekte und übernimmt die Planung von Prüfungen, die Verarbeitung der Ergebnisse, das Ereignismanagement und die Generierung von Alarmen. Dank ihrer modularen Architektur lässt sie sich durch benutzerdefinierte APIs und Plugins erweitern, und ihr Ökosystem ist umfangreich und bietet Integrationen für nahezu jedes Gerät und jeden Dienst.
Ein weiterer Gigant in der Open-Source-Welt ist Zabbix , das sich stark auf die Überwachung umfangreicher IT-Infrastrukturen konzentriert. Es eignet sich besonders gut zum Erfassen und Analysieren von Netzwerkgerätemetriken (Bandbreitennutzung, Schnittstellenstatus, Verbindungen, Paketverlust, Temperatur, CPU, Speicher usw.), entweder über SNMP oder mit eigenen Agenten. Benutzer können Schwellenwerte, Eskalationsprozesse für Alarme, Zeitpläne, Benachrichtigungskanäle und eine sehr detaillierte Ereignislogik definieren.
Im Bereich cloudnativer Anwendungen und Zeitreihendaten sticht Prometheus hervor . Diese Lösung nutzt ein dimensionales Datenmodell, das durch Metriknamen und Schlüssel-Wert-Paare identifiziert wird, und verwendet die Abfragesprache PromQL zur Erstellung von Diagrammen, Tabellen, Alarmregeln und komplexen Abfragen. Die Daten werden effizient im Arbeitsspeicher und auf der lokalen Festplatte gespeichert, wodurch einzelne Instanzen hochgradig autonom arbeiten. Die nahtlose Integration mit Grafana ermöglicht die Visualisierung der Daten.
Für alle, die eine schlanke Lösung mit Fokus auf sehr kurze Echtzeitzeiten und minimale Latenz suchen, ist Netdata eine interessante Option. Es installiert sich als Agent auf jedem Linux-Server oder -Gerät, erfasst System- und Anwendungsmetriken, speichert die Daten direkt auf dem Knoten (ohne kurzfristig auf externe Datenbanken angewiesen zu sein) und bietet automatisierte Dashboards mit detaillierten Leistungsvisualisierungen. Dabei werden sogar Modelle des maschinellen Lernens zur Anomalieerkennung eingesetzt.
Spezialisierte Werkzeuge für Netzwerk- und Verkehrsvisualisierung
Neben universellen Plattformen gibt es Open-Source-Tools, die sich direkt an die Überwachung des Netzwerkverkehrs und an Leistungsdiagramme richten und besonders nützlich sind, wenn der Fokus auf der Anzeige von Bandbreite, Datenflüssen und Verbindungsstatus liegt.
Eine der beliebtesten Lösungen ist Cacti , das sich auf die Erstellung von Netzwerkdiagrammen und das Fehlermanagement für die Betriebsüberwachung konzentriert. Es verwendet RRDTool zur Datenspeicherung und Diagrammerstellung, bietet Vorlagen zur automatisierten Geräteregistrierung und unterstützt verschiedene Datenerfassungsmethoden. Die Plugins (u. a. THold, SysLog und MacTrack) ermöglichen Schwellenwerte, Syslog-Integration, MAC-Adressenverfolgung und Echtzeit-Geräteüberwachung.
Eine weitere sehr leistungsstarke Plattform ist OpenNMS Horizon , die als eine der ersten vollständig quelloffenen Lösungen zur Überwachung von Netzwerkdiensten auf Unternehmensebene gilt. Sie unterstützt die Überwachung lokaler und verteilter Netzwerke und bietet Funktionen wie Inventarisierung, Fehlermanagement, Datenerfassung aus der Ferne, Alarmkorrelation, Überwachung von Geschäftsdiensten und Verkehrsüberwachung. Die Verwaltung erfolgt über eine intuitive Weboberfläche mit anpassbaren Dashboards.
Ähnlich positioniert sich Icinga als moderne Weiterentwicklung des Nagios-Modells mit einer ansprechenden Weboberfläche und einem starken Fokus auf Netzwerküberwachung, Schnittstellenleistung, Bandbreitennutzung, Fehler, CPU- und Speicherauslastung sowie Hardwarezustand. Icinga unterstützt SNMP-Prüfungen, herstellerspezifische Metriken und den Empfang von SNMP-Traps und lässt sich in Logstash integrieren, um Ereignisse von mehreren Geräten zu verwalten.
Für Anwender, die einen sehr detaillierten Überblick über Netzwerkgeräte, Schnittstellen und Datenverkehr benötigen, sind Projekte wie LibreNMS und Observium besonders nützlich. Beide basieren maßgeblich auf SNMP und Erkennungsprotokollen (CDP, LLDP, OSPF, BGP, ARP usw.), um das Netzwerk automatisch zu erkennen, Karten zu erstellen und Leistungskennzahlen mit übersichtlichen Diagrammen , konfigurierbaren Schwellenwerten und flexiblen Alarmsystemen darzustellen.
Erweiterte Visualisierung mit Grafana und Graphite
In vielen komplexen Implementierungen ist die Metrikenerfassung von der Visualisierungsebene getrennt. Zwei Schlüsselprojekte dieses Ansatzes sind Grafana und Graphite , beides Open-Source-Lösungen, die in Unternehmensumgebungen weit verbreitet sind.
Grafana ist ein plattformübergreifendes, pluginfähiges Tool zur Erstellung vollständig individualisierter Datenvisualisierungs-Dashboards. Es ermöglicht die Anbindung verschiedener Datenquellen (Prometheus, Graphite, InfluxDB, MySQL, Cloud-Anbieter usw.) und die Darstellung von Kennzahlen in Histogrammen, geografischen Karten, Heatmaps, Liniendiagrammen, Tabellen und vielen weiteren Visualisierungsarten. Grafana unterstützt Echtzeit-Anmerkungen, dynamische Dashboards und die Definition von Warnmeldungen mit Benachrichtigungen an verschiedene Kanäle.
Graphite konzentriert sich auf die Erfassung und grafische Darstellung von Zeitreihenmetriken. Es lässt sich auf einfacher Hardware oder in der Cloud einsetzen und eignet sich ideal zur Überwachung der Performance von Websites, Unternehmensdiensten, Servern und Netzwerkmetriken . Viele Teams entscheiden sich für Graphite-basierte Managed Services (wie MetricFire), die Cluster-Speicher, Datenkennzeichnung, zusätzliche Integrationen und Multi-Channel-Alerting bieten und gleichzeitig die Leistungsfähigkeit von Graphite und häufig Grafana für die Benutzeroberfläche nutzen.
Bei einer typischen Bereitstellung senden Netzwerksysteme und Server Metriken an Graphite oder einen kompatiblen Collector (z. B. unter Verwendung von Protokollen wie StatsD), und dann werden in Grafana Dashboards erstellt, um eine einheitliche Sicht auf den Zustand der gesamten Infrastruktur zu bieten: vom Datenverkehr auf jeder Schnittstelle bis hin zur Abfragelatenz oder CPU-Auslastung pro Dienst.
Weitere relevante Open-Source-Überwachungslösungen
Das Open-Source-Monitoring-Ökosystem ist sehr breit gefächert und deckt spezifische Bedürfnisse ab, wie z. B. die automatische Erkennung, die Prozessüberwachung, Observability-Pipelines oder die Erfassung von Metriken aus sehr heterogenen Umgebungen.
Checkmk ist beispielsweise eine hochskalierbare Plattform, die die Überwachung von kleinen Umgebungen bis hin zu großen Unternehmen ermöglicht. Sie umfasst fortschrittliches Agentenmanagement, automatische Netzwerkerkennung, interaktive Visualisierungen, leistungsstarke Alarmsysteme, SLA-Berichte, Protokoll- und Ereignisanalyse sowie APIs zur Funktionserweiterung. Checkmk ist in verschiedenen Editionen (kostenlose RAW-Version, Enterprise, Cloud und MSP) erhältlich und passt sich so unterschiedlichen Unternehmensgrößen und Servicemodellen an.
M/Monit konzentriert sich auf die Überwachung und Selbstreparatur von Unix- und Linux-Systemen. Es überwacht Prozesse, CPU- und Speicherauslastung sowie Netzwerkschnittstellen und kann automatisch auf Fehler reagieren, indem es Korrekturmaßnahmen durchführt. Darüber hinaus ermöglicht es die Überwachung des Dienststarts, das Scannen von Dateien und Verzeichnissen auf unautorisierte Änderungen sowie die Überprüfung von Netzwerkverbindungen zu lokalen oder entfernten Servern.
Im Bereich der Netzwerktopologie- und Metrikanalyse zeichnet sich Pandora FMS als Komplettlösung aus und bietet Netzwerk-, UX-, Cloud-, Server- und Anwendungsüberwachung, Inventarisierung, Log-Management und individuell anpassbare Dashboards. Es erkennt automatisch Netzwerkschnittstellen, erstellt Karten, zeigt Echtzeitstatistiken zu Engpässen an und liefert umfassende Berichte.
Für moderne Microservices- und Multi-Cloud-Architekturen fungiert Sensu als zentrale Überwachungsplattform , die verschiedene Monitoring-Tools vereint. Es bietet Integritätsprüfungen, benutzerdefinierte Leistungsmetriken, Log-Management, Netzwerk-Problemmanagement und Multi-Channel-Alerting mit Deduplizierung. Darüber hinaus unterstützt es die Selbstheilung durch Neustarts von Diensten oder die Ausführung benutzerdefinierter Skripte bei Problemerkennung.
Agenten, Sammler und Hilfsmittel
Neben den großen Plattformen gibt es auch leichtere Tools, deren Hauptfunktion darin besteht, Metriken von Systemen, Sensoren und Anwendungen zu sammeln und an Datenbanken oder zentrale Überwachungssysteme zu senden.
Ein Paradebeispiel ist Telegraf , ein Go-basierter Agent ohne externe Abhängigkeiten, der über ein umfangreiches Plugin-System funktioniert. Mit über 300 Input/Output-Plugins kann Telegraf Metriken und Ereignisse aus verschiedenen Technologie-Stacks extrahieren und die Daten an Systeme wie InfluxDB, Graphite, OpenTSDB, Datadog, Librato und andere senden. Seine In-Memory-Puffer gewährleisten, dass Metriken auch bei vorübergehendem Ausfall des Haupt-Backends nicht verloren gehen.
Ein weiteres wichtiges Element in vielen Architekturen ist die Verwendung spezifischer Exporter und Collector (zum Beispiel im Prometheus-Ökosystem mit Exportern für Datenbanken, Webserver, Warteschlangensysteme usw.), die es ermöglichen, Metriken in einem Standardformat bereitzustellen, ohne dass jede Anwendung neu geschrieben werden muss.
Durch die Kombination von Agenten wie Telegraf, spezialisierten Exportern und Zeitreihen- und Visualisierungsplattformen ist es möglich, sehr umfassende Lösungen für die Überwachung von Netzwerken, Servern, Anwendungen und Clouds zu erstellen , die vollständig auf freier Software basieren oder nur minimale kommerzielle Komponenten benötigen, wenn offizieller Support gewünscht wird.
Dieser modulare Ansatz hat den Vorteil, dass jede Organisation nur die benötigten Komponenten auswählen , diese in ihre bestehenden Systeme (Ticketing, CMDB, SIEM usw.) integrieren und die Architektur weiterentwickeln kann, wenn die Umgebung wächst oder sich in Richtung Container, Kubernetes oder serverlose Dienste verändert.
Wie man das beste Open-Source-Netzwerküberwachungstool auswählt
Bevor Sie das erste gängige Tool installieren, ist es wichtig , genau zu definieren, was Sie überwachen möchten : nur das physische Netzwerk (Router, Switches, Access Points) oder auch Server, virtuelle Maschinen, Container, Anwendungen oder sogar die Benutzererfahrung und Cloud-Dienste. Diese Priorisierung ermöglicht es Ihnen, die Auswahl einzugrenzen und Lösungen zu finden, die optimal zu Ihrem Hauptanwendungsfall passen.
Es ist wichtig, die benötigten Kernfunktionen zu ermitteln : Berichte, Benachrichtigungen, Datenvisualisierung, Speicherung historischer Daten, Integration mit Drittsystemen, APIs und Unterstützung spezifischer Protokolle (SNMP, NetFlow, WMI, Cloud-APIs usw.). Prometheus eignet sich beispielsweise ideal für benutzerdefinierte Metriken und komplexe Benachrichtigungsregeln; Cacti ist hervorragend geeignet für die Darstellung von Netzwerkverkehrsdiagrammen; und Checkmk bietet interaktive Visualisierung und umfassende SLA-Berichte.
Benutzerfreundlichkeit und einfache Konfiguration sind weitere wichtige Faktoren. Tools wie Zabbix, Netdata oder Checkmk bieten in der Regel benutzerfreundliche Einrichtungsassistenten und Dashboards, während hochflexible Lösungen unter Umständen einen höheren Einrichtungsaufwand erfordern. Es empfiehlt sich, die Netzwerkerkennung, die Host- und Serviceerstellung sowie die Alarmkonfiguration vor der endgültigen Entscheidung zu testen.
Im Hinblick auf die Sicherheit ist es unerlässlich, dass die Plattform Verschlüsselung, starke Authentifizierung und rollenbasierte Zugriffskontrolle unterstützt . Einige Plattformen, wie beispielsweise OpenNMS, Icinga oder Prometheus, ermöglichen die Integration erweiterter Module oder Konfigurationen zur Erhöhung der Sicherheit, zur Segmentierung des Datenzugriffs und zur Einhaltung interner oder regulatorischer Standards. Darüber hinaus empfiehlt es sich, dies durch Best Practices für die erweiterte Firewall-Konfiguration auf Servern zu ergänzen.
Abschließend wird dringend empfohlen, einen Proof of Concept (POC) mit 2 oder 3 Finalisten-Tools durchzuführen , diese in einer kontrollierten Umgebung einzusetzen, einen repräsentativen Teil der Infrastruktur zu überwachen und die Leistung, Benutzerfreundlichkeit, Qualität der Warnmeldungen und Integrationsfähigkeit mit bestehenden Tools (Ticketsysteme, CI/CD, Messaging usw.) zu bewerten.
Bewährte Verfahren für eine effektive Netzwerküberwachung
Sobald die Plattform ausgewählt ist, hängt der Erfolg maßgeblich von der Konzeption der Implementierung ab. Ein entscheidender erster Schritt ist die Dokumentation und Kartierung des Netzwerks : Welche Geräte sind vorhanden, wo befinden sie sich, welche Verbindungen nutzen sie, welche kritischen Dienste unterstützen sie und welche Abhängigkeiten bestehen zwischen ihnen? Dies erleichtert die Definition von Umfang und Art der Überwachung. Weitere Informationen zu Netzwerktopologien und -typen finden Sie unter „ Computernetzwerke: Typen und Beispiele“.
Es empfiehlt sich, ein oder mehrere Standardkommunikationsprotokolle für die Geräte auszuwählen , um Informationen an das Tool zu senden: SNMP für Netzwerkgeräte, Agenten für Server, Prometheus-Exporter für spezifische Dienste, Syslog für Ereignisse usw. Je einheitlicher der Ansatz, desto einfacher ist die langfristige Wartung.
Wichtig ist auch die Definition von Basisverhalten : Normalwerte für Latenz, Bandbreite, CPU, Speicher, gleichzeitige Verbindungen usw. Dies ermöglicht die Konfiguration realistischer Schwellenwerte und eine genauere Erkennung von Anomalien, wodurch sowohl Fehlalarme als auch verpasste Warnungen bei realen Vorfällen vermieden werden.
Die Einrichtung übersichtlicher, rollenspezifischer Dashboards (24/7-Betrieb, Netzwerk, Systeme, Management usw.) trägt zur Reduzierung der Diagnosezeit bei. Ein Network Operations Center (NOC) benötigt Übersichten und Echtzeitwarnungen; ein Netzwerkadministrator detaillierte Schnittstellen, Fehler und Warteschlangen; und ein CIO Verfügbarkeits- und SLA-Informationen für kritische Dienste.
Schließlich ist es unerlässlich, eine Eskalationsrichtlinie für Alarme festzulegen : Wer erhält welche Art von Alarm über welchen Kanal und mit welcher Priorität? Was geschieht außerhalb der Arbeitszeit? Was gilt als schwerwiegender Vorfall? Und wie wird die Reaktion zwischen den Teams koordiniert? Selbst die besten Tools der Welt verlieren ihre Wirksamkeit, wenn niemand auf Alarme reagiert oder kein klarer Aktionsplan existiert.
Unter Berücksichtigung all dieser Faktoren ermöglichen Open-Source-Lösungen zur Überwachung des Netzwerkverkehrs den Aufbau äußerst robuster Umgebungen mit durchgängiger Transparenz, Entscheidungsunterstützung und einer soliden Grundlage für die Verbesserung der Sicherheit, Verfügbarkeit und Leistung jeder Infrastruktur, vom kleinen Unternehmen bis zum großen verteilten Konzern.