- Linuxin putket mahdollistavat prosessien ketjuttamisen yhdistämällä stdoutin ja stdinin. Niissä on myös ydintuki ja työkaluja, kuten tee, xargs ja cpio, monimutkaisia työnkulkuja varten.
- Tehokas CI/CD-prosessi Linuxissa perustuu hyvään lavasuunnitteluun, välimuistien intensiiviseen käyttöön, muuttumattomiin artefakteihin ja rinnakkaistestaukseen.
- Linux-palvelimen (CPU, RAM, I/O, Docker) ja Jenkins-, GitHub Actions- tai GitLab Runner -suorittajien optimointi on avainasemassa aikojen lyhentämisessä.
- Tietoturvan, havainnoitavuuden ja kustannusten hallinnan integrointi prosessiin varmistaa luotettavat, jäljitettävät ja kestävät käyttöönotot tuotantoympäristöissä.
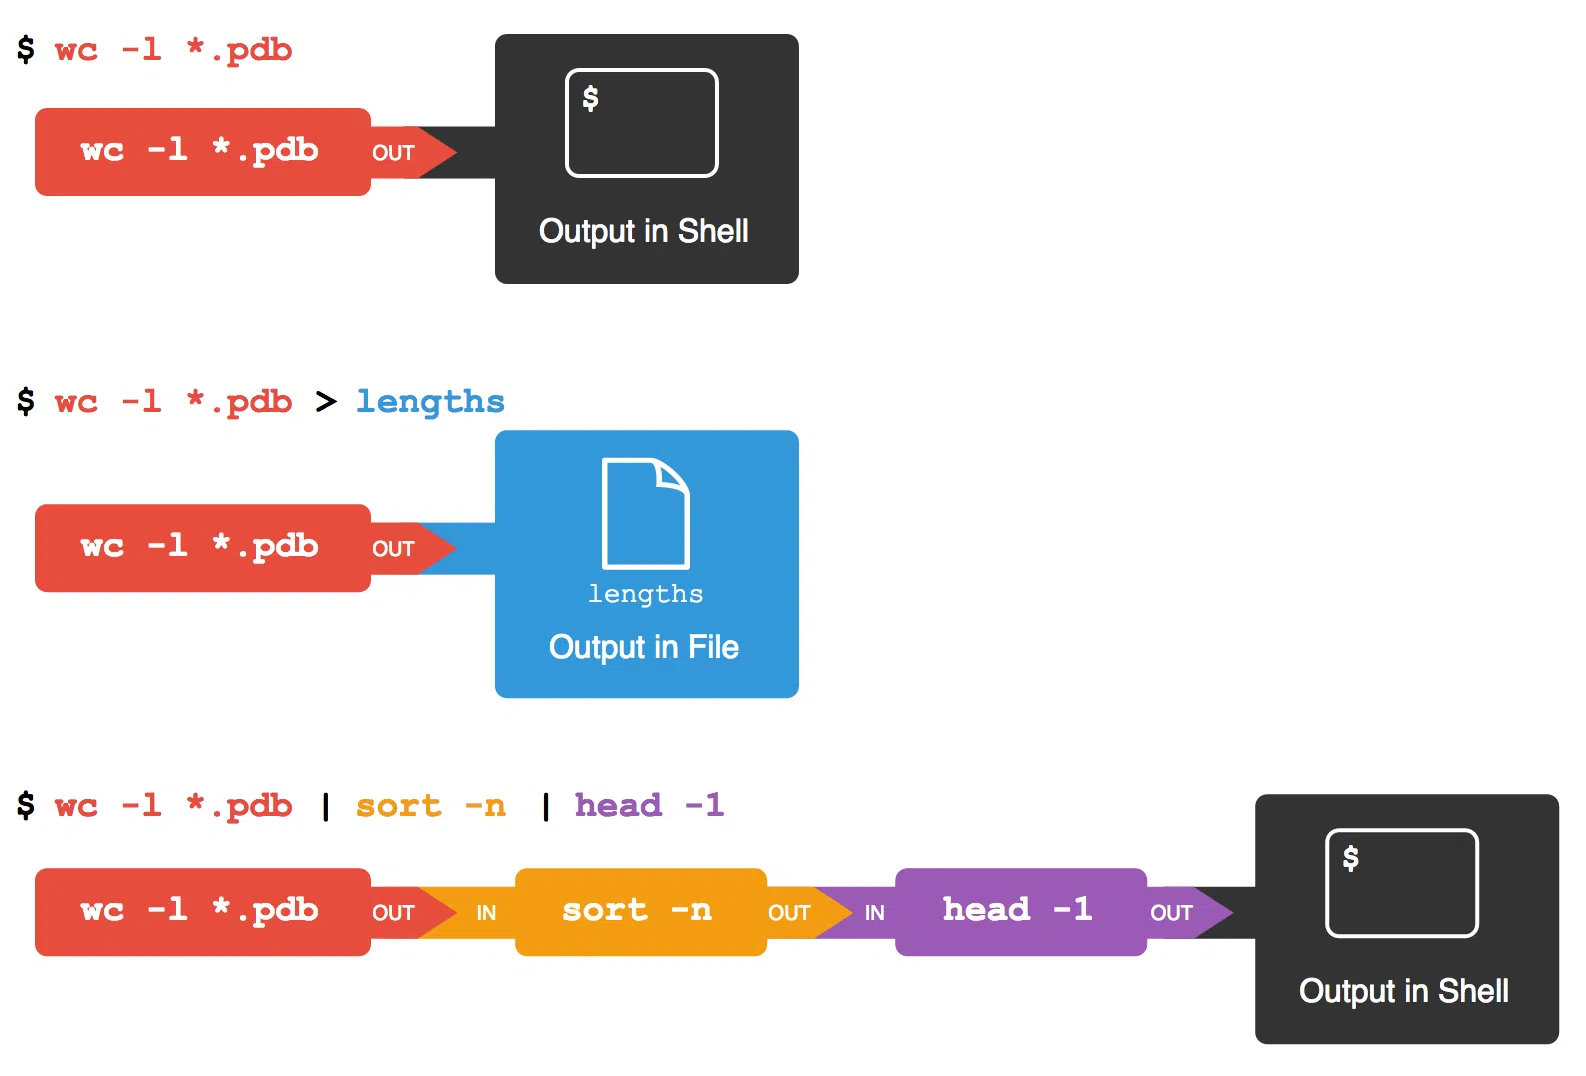
Putkilinjojen optimointi Linuxissa Kyse ei ole vain komentojen ketjuttamisesta symbolilla |Kaiken takana on kokonainen maailma suorituskyvyn optimointiTyönkulun suunnittelu, CI/CD, tietoturva ja käyttöjärjestelmän viritys tekevät kaiken eron hitaan ja epävakaan prosessin sekä toimivan, luotettavan ja edullisen ylläpitää välillä. Jos työskentelet Linux-palvelimien kanssa, olipa kyse sitten tehtävien automatisoinnista terminaalissa tai jatkuvien integraatioprosessien käytöstä, näiden yksityiskohtien ymmärtäminen säästää paljon aikaa ja vaivaa.
Tässä artikkelissa yhdistämme kaksi toisiaan täydentävää näkökulmaa: toisaalta Klassinen putkien käyttö Linuxin komentorivillä (putket, uudelleenohjaukset, komennot kuten tee, xargs o cpio); toisaalta CI/CD-putken optimointi Linux-palvelimillaTämä sisältää välimuistin, testien rinnakkaistuksen, Dockerin virityksen, toimitusketjun suojauksen ja edistyneet työnkulun mittarit. Kaikki selitetty espanjaksi (Espanjasta) selkeiden esimerkkien ja erittäin käytännöllisen lähestymistavan avulla.
Mikä on pipeline ja miten pipetit sopivat Linuxiin?
Termi putkisto tulee putken käsitteestä : tiedon virtauksesta, joka kulkee pisteestä toiseen. Tietotekniikassa ja erityisesti Linuxissa putki on mekanismi, jonka avulla yhden prosessin vakiotulosteesta tulee toisen prosessin vakiotulo. Toisin sanoen yhden komennon tuloste syötetään automaattisesti seuraavaan ilman, että se kulkee välitiedostojen kautta.
Unix-tyyppisissä järjestelmissä on kahdenlaisia putkia . On olemassa anonyymeja eli nimettömiä putkia , joita voidaan käyttää vain läheisesti toisiinsa liittyvien prosessien (esimerkiksi pää- ja lapsiprosessin) välillä. On myös nimettyjä putkia , jotka tunnetaan myös nimellä FIFO (First In – First Out), ja jotka mahdollistavat kommunikoinnin prosessien välillä, jotka eivät ole suoraan yhteydessä toisiinsa ja voivat jopa sijaita eri koneilla verkkoon kytkettyinä.
Anonyymit putket tarjoavat tyypillisesti yksisuuntaisen kommunikaation : yksi prosessi kirjoittaa ja toinen lukee. Sitä vastoin nimetyt putket mahdollistavat kaksisuuntaisen kommunikaation , jos ne on suunniteltu niin, esimerkiksi avaamalla FIFO:n luku-/kirjoitustilassa molemmista päistä. Niitä käytetään laajalti koordinoimaan daemon-prosesseja, komentosarjoja tai palveluita, joiden on välitettävä tietoja toisilleen estoitta.
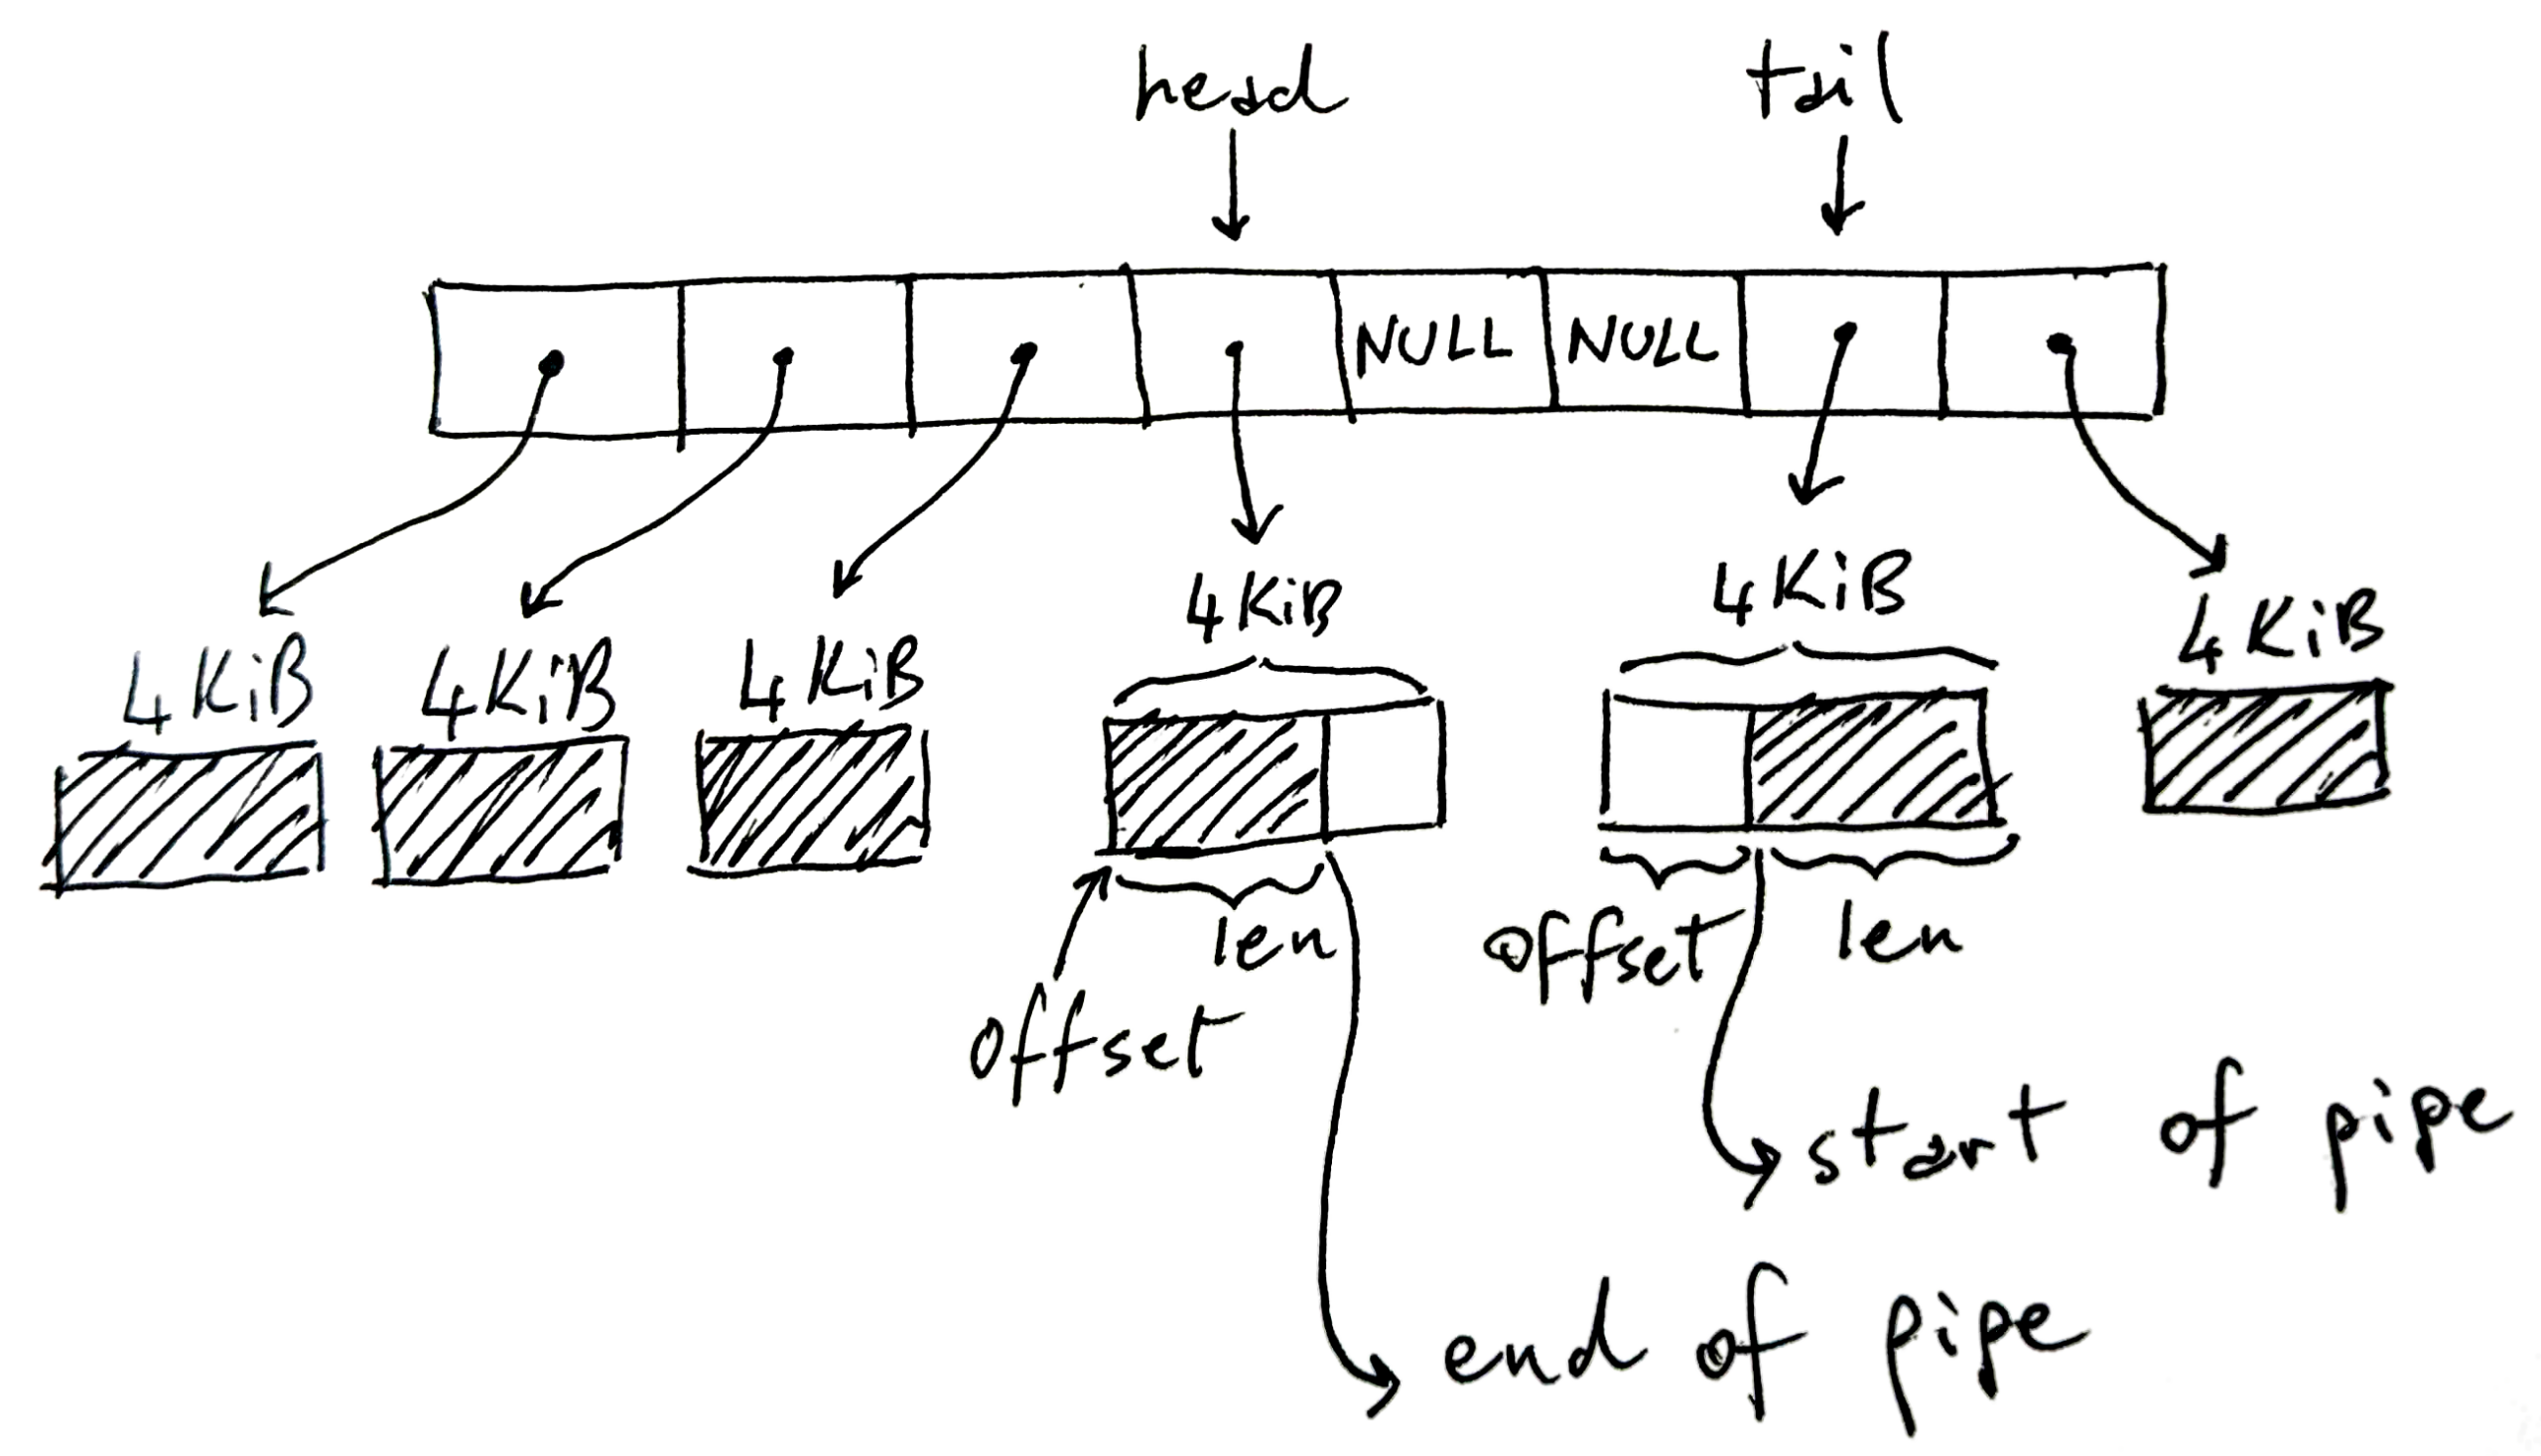
Toteutustasolla putkilinjojen tuki on linux-ydinei komentotulkissa. Komentotulkki (bash, zsh jne.) yksinkertaisesti luo putken järjestelmäkutsujen, kuten pipe() y fork()uudelleenohjaa tiedostodeskriptorit ja käynnistä sitten kukin ohjelma. Järjestelmän ydin hoitaa prosessien estämisen, puskurin hallinnan ja tiedon välittämisen tuottajan ja kuluttajan välillä.
Stdinin, stdoutin ja datavuon ymmärtäminen
Jotta putkistojen kanssa voidaan työskennellä tehokkaasti, on tärkeää ymmärtää, mitä stdin, stdout ja stderr ovat . Nämä eivät ole abstrakteja käsitteitä: jokainen Linux-prosessi alkaa kolmella avoimen tiedoston kuvaajalla, jotka viittaavat tiettyihin ytimen hallinnoimiin resursseihin.
stdin (deskriptori 0) ja stdout (deskriptori 1) voidaan nähdä tavuvirtoina, jotka ovat yhteydessä johonkin: se voi olla pääte, tiedosto, verkkosocket tai putki. Ne eivät ole pelkästään puskureita; ne ovat viittauksia ytimen objekteihin ( tiedostotyyppirakenteisiin ), jotka puolestaan liittyvät inodeihin, soketteihin tai sisäisiin putkirakenteisiin.
Jokaisella prosessilla on omat kuvaajansa, joten jokainen komento putkessa Se tarkastelee stdin- ja stdout-arvojaan itsenäisesti. Rivillä, kuten ls | grep txt | wc -l, ls kirjoita putkeen, grep Se lukee yhdestä putkesta ja kirjoittaa toiseen, ja wc Lue viimeisestä. Käyttäjälle se näkyy yhtenä merkkijonona, mutta sisäisesti ne ovat useita ketjutettuja ydinpuskureitajokaisen prosessin estyessä ja jatkuessa käytettävissä olevan tilan tai datan mukaan.
Kun ensimmäinen prosessi tuottaa dataa nopeammin kuin toinen sitä kuluttaa, putkipuskuri täyttyy. Tässä vaiheessa seuraavat kirjoitukset palaavat, mikä estää lähettävän prosessin, kunnes kuluttava prosessi... lue tarpeeksi tietoa ja vapauttaa tilaa. Tämä estää muistin hallitsemattoman kasvun; data ei kerry loputtomiin, ellet käytä estämättömiä I/O-signaaleja tai erityisiä signaaleja. Esimerkiksi tällaisessa tapauksessa dd if=/dev/sda | gzip -9ja gzip puristuu hitaammin, dd hän joutuu odottamaan.
Tämä vastapainemekanismi tekee putkistoista melko vakaita, vaikka vaiheiden välillä olisi suorituskyvyn epätasapainoa, mikä heijastuu myös CI/CD-putkistojen suunnittelussa , jossa hitaista vaiheista tulee pullonkaula, jota on mitattava ja optimoitava.
Putkien käytännön käyttö Linux-päätteessä
Arkikäytössä putkia käytetään komentojen ketjuttamiseen yhdelle riville ja datan muuntamiseen askel askeleelta. Sen sijaan, että ajaisit komennon, katsoisit tulostetta, kopioisit sen ja liittäisit sen toiseen komentoon, voit rakentaa pieniä, erittäin joustavia "tietotehtaita" selkokielellä.
Tyypillinen esimerkki Unix-ympäristöissä on komentojen yhdistäminen fortune, joka näyttää satunnaisia lainausmerkkejä, joissa cowsayjoka tulostaa "puhuvan" lehmän. Piippua käytettäessä Fortunen lähdöstä tulee Cowsayn viestikaikki yhdellä komennolla. Se on leikkisä esimerkki, mutta se havainnollistaa täydellisesti ajatusta yksinkertaisten työkalujen yhdistämisestä monimutkaisempia tehtäviä varten.
Toinen klassinen tapa on lähettää tulos ls a wc laskea rivejä, sanoja ja merkkejä. Jotain tällaista ls | wc Sen avulla näet nopeasti, kuinka monta kohdetta on listattu. Hienoa on, että et tarvitse yhtä ohjelmaa kaiken tekemiseen, vaan pikemminkin... Luot ratkaisuja pienillä, hyvin suunnitelluilla apuohjelmilla..
On myös hyvin yleistä ketjuttaa yhteen cat, sort y more (tai toisen sivutusohjelman) lajitellaksesi tekstitiedoston ja selataksesi sitä sivu sivulta. Putken avulla sisältö siirtyy komennosta toiseen tallentamatta sitä väliaikaisiin tiedostoihin, mikä yksinkertaistaa huomattavasti komentosarjojen kirjoittamista ja hallintatehtäviä.
Käytännön tapauksissa, kuten opiskelijaluetteloiden ja arvosanojen käsittelyssä erillisissä tiedostoissa, voit käyttää paste sarakkeiden yhdistämiseksi, cut valitaksesi vain haluamasi kentät ja ketjutettuja pipeja suodattaaksesi, lajitellaksesi tai muuntaaksesi kaiken yhdellä komentosarjarivillä. Tämä malli pilkkoa suuri ongelma yksinkertaisiksi komennoiksi yhdistettynä putkiin Se on Unix-filosofian ydin.
Edistyneet komennot putkien tehokkaaseen hyödyntämiseen: tee, xargs ja cpio
Kun Linuxissa aletaan todella automatisoida asioita, putkista tulee entistä tehokkaampia joidenkin keskeisten työkalujen ansiosta. Näitä ovat muun muassa: tee, xargs y cpiojotka täydentävät erittäin hyvin vakiomuotoista tiedonkulkua.
Komento tee Se toimii kuin vesiputken "T": se lukee stdin:stä, kirjoittaa stdout:iin ja kopioi myös saman tulosteen yhteen tai useampaan tiedostoon. Se on ihanteellinen, kun haluat tarkastella tulostetta näytöllä ja samalla tallentaa se tarkastella sitä myöhemmin tai käsitellä sitä toisessa vaiheessa. Vaihtoehtoisesti -a Se lisää tietoja tiedoston loppuun sen sijaan, että se korvaisi sen.
Voit esimerkiksi lajitella listan seuraavasti: sortlähetä tulos osoitteeseen tee tallentaa sen lokiin ja samalla siirtää sen more sivuttaaksesi sen. Tällä tavoin voit lajitella, tallentaa levylle ja tarkastella kätevästi yhdessä putkessa ilman lajitteluprosessin toistamista.
Komento xargs Se on toinen putkiin liittyvä peruspilari. Sen tehtävänä on ottaa stdin:n kautta saapuva sisältö (yleensä lista elementtejä) ja muuntaa se argumenteiksi toiselle komennolle. Se on erityisen hyödyllinen, kun ohjelma kaatuu, koska se vastaanottaa liian monta parametria kerralla, tai kun haluat jaa työ eriin vaihtoehdolla -n, mikä rajoittaa suoritusta kohden välitettävien argumenttien määrää.
Esimerkiksi ls | xargs -n 4 Jaat tiedostoluettelon neljän ryhmään ja suoritat kohdekomennon (oletusarvoisesti echo(tai määrittämäsi) useita kertoja. Tällä tavoin voit rakentaa prosesseja, kuten "esikatsele poistettavat", yhdistämällä ls, xargs y echo rm ennen varsinaisen pyyhkimisen aloittamista.
Ole varovainen monimutkaisten syötteiden kanssa: polut, joissa on välilyöntejä tai erikoismerkkejä voi rikkoa oletuskäyttäytymisen xargsNäissä tapauksissa sitä käytetään yleensä yhdessä ns. find ja vaihtoehto -print0, joka erottaa elementit null-merkillä, sekä xargs -0 niin että molemmat päät käyttävät samaa vankkaa erotinta.
Lopuksi, cpio Se on vähemmän tunnettu komento kuin tarMutta se on uskomattoman joustava tiedostovirtojen käsittelyyn putkien kautta. Toisin kuin tar, se on alusta alkaen suunniteltu toimimaan uudelleenohjaukset ja putket: vastaanottaa tiedostoluettelon stdin:n kautta (yleensä luotu komennolla find) ja tuottaa tai kuluttaa "paketti"-tyyppisiä tiedostoja ilman omaa pakkausta, jotka voit sitten pakata gzip tai samankaltainen.
Tärkeimmät toimintatavat cpio salli tiedostojen luominen (-o), kopioi hakemistopuut (-p) tai poimi sisältöä (-i(usein kutsutaan ”kopioinniksi”). Vaihtoehtoja, kuten -u päällekirjoittaa, -m aikaleimojen säilyttämiseksi tai -d hakemistorakenteen uudelleenluominen mahdollistaa hallita tarkasti, mitä ja miten kopioidaan, erityisen hyödyllinen monimutkaisissa skripteissä, joissa tar jää vajaaksi.
CI/CD-putkistojen suunnittelu ja optimointi Linux-palvelimilla
Perinteisen komentorivin lisäksi putkilinjan käsite on tullut olennaiseksi jatkuvan integraation ja jatkuvan toimituksen (CI/CD) maailmassa . Linux-palvelimella CI/CD-putkilinja on automatisoitu vaihesarja: koodin nouto, riippuvuuksien asentaminen, kääntäminen, testien suorittaminen, artefaktien pakkaaminen ja käyttöönotto.
Linux sopii tähän erityisen hyvin, koska se erottuu edukseen nopeudellaan , vakaudellaan ja automaatiotyökalujensa ekosysteemillä . Alustat, kuten Jenkins, GitHub Actions ja GitLab CI, käyttävät Linux-suorittajia (fyysisiä koneita, virtuaalikoneita tai säilöjä) prosessointiputkien johdonmukaiseen suorittamiseen.
Näiden prosessien optimointi ei tarkoita pelkästään niiden "toimivuuden" varmistamista, vaan niiden toimivuuden varmistamista mahdollisimman vähällä kitkalla. Tämä tarkoittaa uloskirjautumisaikojen lyhentämistä, toistuvien riippuvuusasennusten minimointia, Docker-kuvien optimointia tarpeettomien uudelleenrakennusten välttämiseksi, jo luotujen artefaktien uudelleenkäyttöä sekä ympäristön pitämistä turvallisena ja havaittavana.
Hyvänä peruskäytäntönä on jakaa prosessi hyvin määriteltyihin vaiheisiin: koonti, testaus ja käyttöönotto . Ihannetapauksessa käännetään vain kerran, luodaan artefakti (binääri, paketti, Docker-kuva), jota testataan rinnakkain eri muunnelmissa (esimerkiksi eri kieliversioissa), ja sitten otetaan sama artefakti käyttöön sekä testi- että tuotantoympäristöissä ilman uudelleenkääntämistä.
Työskentely repositorioissa (S3, Nexus, Artifactory, säilörekisterit tai GitLabiin/GitHubiin upotetut paketit) tallennettujen muuttumattomien artefaktien kanssa yksinkertaistaa auditointia, mahdollistaa nopeat versioiden palautukset ja vähentää todennäköisyyttä, että "se toimii koneellani, mutta ei tuotannossa".
Edellytykset: jakelu, CI-käyttäjä ja palvelinpuolen suojaus
Ennen kuin juututaan millisekuntioptimointiin siellä täällä, on tärkeää luoda vakaa perusta Linux-palvelimelle , joka toimii CI/CD-suorittajana. Tämä alkaa jakelun ja vähimmäistietoturva-asetusten valinnalla.
Järkevin lähestymistapa on yleensä standardoida LTS- tai vakaa jakelu , jonka tiimi tuntee: Ubuntu LTS, Debian Stable tai yritysversiot, kuten AlmaLinux tai Rocky Linux. Kaikkien suorittimien pitäminen samassa versiossa estää odottamattoman toiminnan, joka johtuu eri kirjastoista tai ytimistä töiden välillä.
Toinen suositus on määrittää CI:lle oma käyttäjäilman pääkäyttäjän oikeuksia, ja sudo-komennon ollessa hyvin rajoitettu vain tärkeimpiin komentoihin (esimerkiksi systemctl o docker (jos se on todella välttämätöntä). Tämän käyttäjän on todennettava itsensä SSH-avaimilla sekä palvelimelle pääsyä että Git-arkistojen tai muiden etäkoneiden kanssa toimimista varten.
Järjestelmätasolla on suositeltavaa ylläpitää palvelinta päivitetty ja minimaalisesti vahvistettuTämä sisältää tietoturvapäivitysten asentamisen, rajoittavan palomuurin määrittämisen (esimerkiksi UFW:llä: estetään kaikki saapuva liikenne paitsi välttämätön ja sallitaan lähtevä liikenne) ja työkalujen, kuten fail2ban pysäyttääkseen SSH:n raa'an voiman hyökkäykset ja säätääkseen joitakin verkko- ja ydinparametreja sysctl luotettavuuden ja suorituskyvyn parantamiseksi.
On yleistä nostaa rajaa esimerkiksi ilmoita estääksesi resurssien loppumisen useiden tiedostojen valvontajärjestelmille ja säädä parametria vm.swappiness jotta ytimestä tulisi varovaisempi swapia käytettäessä, mikä on erityisen tärkeää silloin, kun CI-työt kuluttavat paljon muistia kerrallaan.
Välimuistit, Docker ja rinnakkaistaminen: CI/CD:n suorituskyvyn vivut
Jos tarkastellaan, mihin aikaan keskimääräisessä testiputkessa todellisuudessa kuluu, havaitaan, että valtava osa siitä menetetään riippuvuuksien asentamisessa ja Docker-kuvien uudelleenrakentamisessa . Tämän korjaaminen on yleensä tehokkaampaa kuin testikoodin optimointi muutamalla millisekunnilla.
Ensimmäinen vipu on riippuvuuksien välimuisti . Lähes kaikki riippuvuuksien hallintaohjelmat (pip, npm, Maven, Gradle, Go-moduulit jne.) käyttävät paikallisia välimuistihakemistoja. Pysyvällä Linux-palvelimella voit jakaa näitä hakemistoja töiden välillä tai liittää ne pysyvälle taltiolle. Tällä tavoin jokaisen suorituksen ei tarvitse ladata puolta internetiä uudelleen.
Dockerin osalta ota käyttöön BuildKit ja rakenna hyvin Dockerfile Tämä on käännekohta. Riippuvuuksien asennuksen sijoittaminen heti vaatimustiedoston kopioinnin jälkeen ja ennen muuta koodia varmistaa, että tasoja käytetään uudelleen niin kauan kuin näiden riippuvuuksien versiot pysyvät muuttumattomina. Lisäksi pip-, npm- jne.:lle voidaan määrittää omat välimuistit itse buildin sisällä.
Toinen tärkeä vipu on rinnakkaisten testien suorittaminenMonet kehykset tukevat natiivisti samanaikaisuutta: pytest kanssa -n autoJava-työkalut, kuten Surefire ja Jest, JavaScriptissä --maxWorkersjne. Testipaketin jakaminen moduuleihin, kansioihin tai jopa arvioidun ajan mukaan ja sen tasapainottaminen useiden työntekijöiden kesken mahdollistaa testausvaiheen keston lyhentämisen 2–5-kertaisesti ilman, että yhtäkään liiketoiminta-aluetta muutetaan.
Lopuksi on vielä artefaktien ja käyttöönoton ongelma . Sen sijaan, että sama levykuva käännettäisiin uudelleen testi-, esituotanto- ja tuotantoympäristöä varten, tehokas lähestymistapa on rakentaa kerran, tallentaa tulos repositorioon ja merkitä se käyttöönottoympäristön mukaan. Tämä vähentää suorittimen käyttöä, välttää epäjohdonmukaisuuksia ja nopeuttaa merkittävästi pitkiä prosessointiputkia.
Jenkinsin, GitHub Actionsin ja GitLab Runnerin optimointi Linuxissa
Jokaisella CI-järjestelmällä on omat erityispiirteensä, mutta ne kaikki hyötyvät samoista perusperiaatteista Linuxissa toimiessaan. Tärkeintä on yleensä käyttää lyhytaikaisia ja puhtaita suoritusyksiköitä , ylläpitää sopivan kokoista pysyvää välimuistia ja hallita samanaikaisuutta.
Jenkinsissä on yleinen käytäntö käyttää kevyitä, väliaikaisia agentteja (kuten Docker-kontteja tai podeja Kuberneteksissä tai muissa konttien orkestrointiratkaisuissa ) töiden suorittamiseen pitäen samalla pääsolmu mahdollisimman yksinkertaisena. Nämä agentit voidaan konfiguroida systemd-palveluiksi Linux-palvelimilla, jolloin ne rekisteröityvät ohjaimeen ja käynnistyvät automaattisesti koneen käynnistyessä.
Itse isännöityjen suorittajien sisältävien GitHub-toimintojen käyttöönotto on suositeltavaa Linux-virtuaalikoneet nopeilla SSD-levyilläJos haluat luoda suuren välimuistihakemiston toiminnoille (kieliriippuvuudet, koontivälimuistit jne.), rajoita samanaikaisten töiden määrää, jotta vältät suorittimen ja levyn ylikuormituksen. Hyödynnä virallista välimuistitoimintoa esimerkiksi seuraavilla poluilla: ~/.cache/pip, ~/.npm o ~/.m2 Sillä on valtava vaikutus ajassa.
GitLab Runnerissa valinta shell-suorittimen ja Dockerin välillä riippuu tarvitsemastasi suorituskyvyn ja eristäytymisen tasapainosta. Shell-suoritin on nopeampi, koska se toimii suoraan isännässä, mutta Docker-suoritin tarjoaa puhtaat ja replikoitavat ympäristöt. Voit myös määrittää jaetun välimuistin (paikallisen tai S3:ssa) ja säätää samanaikaisten töiden enimmäismäärää hyödyntääksesi laitteistoa ylikuormittamatta sitä.
Kaikissa näissä tapauksissa on ratkaisevan tärkeää jakaa taltiot riippuvuuksien välimuistiin ja samalla estää työtilojen täyttyminen koontiversioiden välillä. Lyhytaikaiset koneet tai säilöt, jotka luodaan ja tuhotaan jokaisen putken tai putkiryhmän mukana, vähentävät huomattavasti "toimi eilen, mutta ei tänään" -ongelmia, jotka johtuvat aiempien koontiversioiden jäänteistä.
Linux-palvelimen suorituskyky: suoritin, muisti, I/O ja Docker
Vaikka skriptisi olisivat kuinka optimoituja tahansa, jos putkea pyörittävä Linux-palvelin ei ole oikean kokoinen, kohtaat loputtomia jonoja ja hitaasti eteneviä töitä. Tyypillinen ja kohtuullinen kokoonpano keskitason koneelle on 4–8 virtuaalista suoritinta (vCPU) ja 8–16 Gt RAM-muistia , SSD-tallennustilalla (mieluiten NVMe) ja jonkin verran swap-tilaa (2–4 Gt) huippukuormituksen käsittelemiseksi ilman prosessien aggressiivista lopettamista.
Tiedostojärjestelmällä on myös merkitystä. ext4 tai XFS ja vaihtoehto noatime Vähennä tarpeetonta I/O:ta niillä levyillä, joille käännät tai kirjoitat lokeja. Lisäksi liitä tmpfs väliaikaisille tiedostoille tai lyhytikäisille artefakteille (esimerkiksi /mnt/ci-tmp) nopeuttaa intensiivisiä toimintoja ja estää levyn täyttymisen jäännöstiedostoilla töiden välillä.
Dockerin osalta daemon-hygienia on avainasemassa. Käyttämättömien levykuvien ja -taltioiden turvallinen ja säännöllinen poistaminen samalla, kun kuumat peruslevykuvat säilytetään, auttaa hallitse levytilaa ja käynnistysaikojaKomentoja, kuten docker system prune Sopivien aikasuodattimien avulla ne mahdollistavat puhdistuksen ilman äskettäin käytettyjen resurssien ylikuormitusta.
Jos CI-sovelluksesi on säilöintensiivinen, voit käyttää myös peilattuja rekistereitä välttääksesi jatkuvan lataamisen internetistä, käyttää BuildKitiä samanaikaisuuteen ja kerrosvälimuistiin ja jopa määrittää suorittimen affiniteetit (CPU-sarjat) tai erilliset solmut vaativimmille suorittimille, estäen vierekkäisten työkuormien väliset häiriöt. Lisäksi suorittimen mikroarkkitehtuurin ymmärtäminen auttaa sinua mitoittamaan resursseja paremmin intensiivisille CI-työkuormille.
Tietoturva valmisteilla (DevSecOps) ja käyttöönotot Linuxissa
Nopea mutta epävarma prosessi on tikittävä aikapommi. Tietoturvan integrointi itse prosessiin ja Docker-konttien tietoturva ovat nyt vakio-osa kaikissa DevSecOps-strategioissa, ja Linux tarjoaa tähän monia työkaluja.
Ensimmäinen asia on käsitellä salaisuuksia ja tunnistetietoja äärimmäisen huolellisesti . Niiden ei tulisi koskaan sijaita koodissa tai versioiduissa asetustiedostoissa. Sen sijaan ne tallennetaan salaisuuksien hallintaohjelmiin (GitLabin maskatut muuttujat, GitHubin salatut salaisuudet, HashiCorp-holvi jne.) ja injektoidaan vain niitä tarvitsevan työn suorituksen aikana käyttäen lyhytikäisiä tokeneita aina kun mahdollista.
Toinen tärkeä taso on SBOMien (ohjelmiston materiaaliluetteloiden) luominen ja artefaktien allekirjoittaminen. Työkalut, kuten Syft tai CycloneDX, mahdollistavat kaikkien kuvan tai binääritiedoston muodostavien komponenttien listaamisen, kun taas Cosign tai muut todennettavat allekirjoitusratkaisut varmistavat, että vain prosessin läpi kulkeneet ja validoidut artefaktit otetaan käyttöön.
Verkon ja käyttöoikeuksien osalta on suositeltavaa segmentoida CI- ja tuotantoverkot , ottaa käyttöön tiukat palomuurit, auditoida suorituslokit ja vaihtaa tunnistetietoja säännöllisesti. SSH:ta käytettäessä on parempi käyttää vanhenemispäivämääräisiä varmenteita tai avaimia staattisten salasanojen sijaan.
Linuxissa käyttöönotettaessa strategiat, kuten Blue/Green, rolling ja canary, vähentävät huomattavasti käyttöönottovirheiden vaikutusta. Sovelluksen suorittaminen systemd-palveluna, Nginxin tai HAProxyn asettaminen sen eteen ja versioiden välisen liikenteen hallinta terveystarkastuksilla mahdollistavat käytännössä nollakäyttökatkoksen päivitysten aikana.
Esimerkiksi kun Nginx käynnistetään uudelleen ja palvelut käynnistetään uudelleen systemd:llä käyttämällä pehmeitä pysäytyssignaaleja (kuten SIGTERMKohtuullisten odotusaikojen ansiosta voit tyhjentää aktiiviset yhteydet ennen prosessin pysähtymistä, pitäen käyttökokemuksen ennallaan, kun vaihdat versioita taustalla.
Havaittavuus, mittarit ja kustannukset Linux-putkistoissa
Kun prosessisi ovat toiminnassa, seuraava vaihe on mitata niitä ja ymmärtää, mihin aika ja resurssit menevät . Pelkkä työnkulun onnistumisen tai epäonnistumisen tietäminen ei riitä; sinun on seurattava kunkin vaiheen kestoa, jonotusaikaa, onnistumisprosenttia, käyttöönottotiheyttä, välimuistin osumaprosenttia ja niin edelleen.
Järjestelmän mittareita viedään usein käyttämällä node_exporterKeskitä lokit ratkaisuilla, kuten ELK tai Loki, ja visualisoi kaikki Grafanan kojelaudoissa. Tällä tavoin voit esimerkiksi havaita, onko testausvaiheen kesto pidentynyt 30 % viimeisen viikon aikana tai viettävätkö työt liikaa aikaa odottaen vapaata suorittajaa; verkkoliikenteen valvonta Avoimen lähdekoodin työkalut täydentävät tätä näkyvyyttä.
Myös itse putkilinjaa voidaan instrumentoida esimerkiksi GitHub Actionsissa tai GitLab CI:ssä mittaamaan ohjelmallisesti, kuinka monta suoritusta on onnistunut, kuinka kauan kukin suoritus on kestänyt ja mikä on yleinen tilaSkripti, joka kutsuu tarjoajan API:a, laskee suoritusten kokonaismäärän, onnistuneiden suoritusten määrän, epäonnistuneiden suoritusten määrän, onnistumisprosentin ja keskimääräisen keston ja tallentaa kaiken JSON-tiedostoon (kuten pipeline-metrics.json) avulla voit integroida nämä mittarit raportteihin tai koontinäyttöihin.
Näiden tietojen avulla voit tehdä päätöksiä palveluntarjoajien koosta ja lukumäärästä : joskus on parempi olla useampi pieni palveluntarjoaja kuin muutama erittäin suuri, jotta odotusajat lyhenevät. Automaattinen skaalautuvuus – esimerkiksi pilven automaattinen skaalaus tai Kubernetes-solmujen dynaamiset poolit – auttaa absorboimaan huippuaktiivisuutta päivän aikana ja minimoimaan vajaakäytössä olevat resurssit yöllä.
Nämä käytännöt eivät ainoastaan paranna tiimin käyttökokemusta, vaan auttavat myös säätämään infrastruktuurikustannuksia hallitsemalla suorittimen, muistin ja erityisesti tallennustilan kulutusta, joka yleensä kasvaa pilviin kuvien ja välimuistien kanssa, jos niitä ei puhdisteta säännöllisesti ja suunnitellusti.
Sekä klassisten komentoriviprosessien että nykyaikaisten CI/CD-prosessien hallinta Linuxissa tarjoaa tehokkaan yhdistelmän: voit automatisoida kaiken yksinkertaisista tekstin suodatustehtävistä monimutkaisiin, ylläpidettäviin, turvallisiin ja nopeisiin koonti-, testaus- ja käyttöönottoprosesseihin. Ymmärtämällä, miten tieto virtaa prosessien välillä, miten riippuvuudet tallennetaan välimuistiin, miten palvelimet viritetään ja miten mittarit ja tietoturva integroidaan, voit rakentaa työnkulkuja, jotka skaalautuvat tiimisi ja projektiesi kanssa ilman, että niistä tulee jatkuvaa pullonkaulaa.
