- Les systèmes RAID améliorent les performances et la disponibilité, mais ils ne remplacent pas les sauvegardes et ne sont pas à l'abri des pannes physiques, logiques ou humaines.
- Des bruits étranges, un état dégradé, une lenteur anormale et des erreurs de parité ou de lecture/écriture sont des signes clairs de problèmes imminents dans le RAID.
- Forcer les reconstructions, réorganiser les disques sans documentation ou utiliser des outils de réparation génériques peut transformer une panne gérable en une perte totale de données.
- Agir avec prudence et rapidité, avec le soutien de spécialistes de la récupération RAID, augmente considérablement les chances de sauver les données.
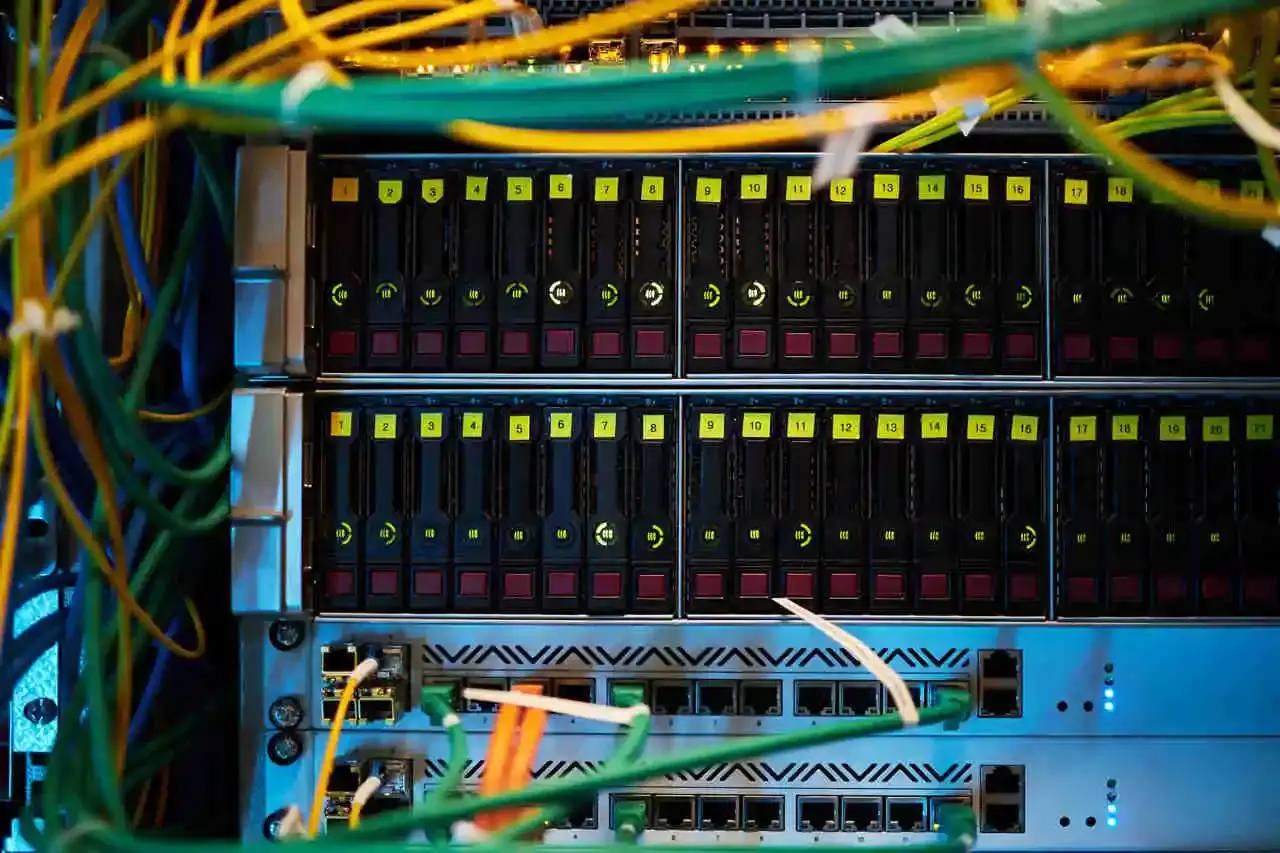
Les systèmes RAID sont devenus monnaie courante dans les serveurs, les NAS et les baies de stockage car ils promettent des performances accrues et une meilleure tolérance aux pannes . Cependant, malgré leur aspect rassurant, ils ne constituent pas une solution miracle : une panne mal gérée peut avoir des conséquences désastreuses et vous priver de vos données en quelques minutes.
Lorsqu'un système RAID présente des symptômes inhabituels, la clé n'est pas la précipitation, mais la prudence. Détecter les signes de défaillance et savoir ce qu'il ne faut surtout pas faire fait toute la différence entre un simple remplacement de disque et une perte totale et irréversible de données, même pour un laboratoire professionnel.
Qu’est-ce qu’une panne RAID et pourquoi n’est-ce pas la même chose qu’une sauvegarde ?
Un RAID (Redundant Array of Independent Disks) regroupe plusieurs disques pour offrir une disponibilité, des performances et/ou une redondance accrues , selon le niveau utilisé. Du RAID 1 classique en miroir aux configurations plus complexes comme le RAID 5, le RAID 6 ou le RAID 10, l'objectif est que le système continue de fonctionner même en cas de défaillance d'un ou plusieurs disques physiques.
Le problème, c'est que beaucoup pensent : « J'ai un RAID, donc j'ai une sauvegarde », ce qui est une erreur fondamentale. Le RAID ne remplace pas les sauvegardes : il protège contre la défaillance d'un ou plusieurs disques (selon le niveau RAID), mais il n'empêche pas la corruption logique, les erreurs humaines, les ransomwares, les suppressions accidentelles, ni les pannes de contrôleur ou de serveur.
De plus, la manière dont le contrôleur — y compris le micrologiciel du contrôleur — distribue les données (ordre des disques, taille des bandes, algorithmes de parité, métadonnées, etc.) signifie que toute manipulation incorrecte de la baie peut en perturber la structure et rendre la récupération extrêmement compliquée, même lorsque les disques « semblent » être en bon état.
Principaux niveaux RAID et leur impact sur la récupération
Chaque niveau RAID réagit différemment en cas de panne, ce qui influe considérablement sur les options de récupération des données. Comprendre ces différences permet d'éviter les décisions risquées en cas de problème.
Dans une configuration RAID 0, les données sont réparties sur plusieurs disques sans parité ni duplication. Il n'y a aucune redondance : si un seul disque tombe en panne ou se dégrade suffisamment, la perte logique est totale car une partie essentielle de chaque fichier est manquante. Parler de « reconstruction » dans ce cas n'a guère de sens ; la priorité est de tenter de récupérer ce qui peut l'être à partir des disques physiquement endommagés.
Dans une configuration RAID 1, les disques sont dupliqués : chaque disque contient une copie complète des données . Cette configuration est généralement très fiable pour la récupération des données, à condition qu'aucune erreur de manipulation ne soit commise (par exemple, initialiser l'un des disques sur un système différent ou les connecter à des contrôleurs incompatibles).
Le RAID 5 répartit les données sur plusieurs disques et calcule la parité distribuée, ce qui lui permet de résister à la défaillance d'un disque . Le problème survient lorsqu'un deuxième disque commence à dysfonctionner pendant la reconstruction : la charge de travail explose, des erreurs de lecture apparaissent et la grappe peut planter brutalement.
Le RAID 6 fonctionne de manière similaire au RAID 5, mais ajoute une seconde parité, ce qui lui permet de tolérer la défaillance de deux disques maximum . En contrepartie, son architecture est plus complexe, les reconstructions sont plus longues et toute erreur logique ou de configuration complique davantage les opérations de récupération.
Le RAID 10 combine les miroirs et les bandes : les paires de disques en miroir sont « rayées ». Pour la récupération, l’ordre des disques et la relation entre les miroirs et les bandes sont essentiels ; mélanger les positions ou reconstruire à l’aveugle peut corrompre la grappe même si tous les disques sont physiquement en bon état.
Signes évidents de défaillance de votre RAID
Avant qu'un système ne tombe complètement en panne, il laisse généralement une série d'indices. Apprendre à les reconnaître permet d'intervenir à temps et d'éviter des dommages plus importants.
L'un des signes les plus évidents est l'apparition de bruits étranges provenant des disques : cliquetis répétitifs, grincements, bourdonnements intermittents ou sons métalliques inhabituels. Ces bruits indiquent généralement des défaillances mécaniques au niveau des têtes de lecture/écriture ou des plateaux , ou encore des problèmes de moteur. Si vous les ignorez et persistez à forcer les lectures, l'état du disque se détériorera généralement très rapidement.
Un autre signe typique est l'apparition des messages « Dégradé », « Défaillant » ou « Critique » dans la console de gestion du NAS ou du contrôleur RAID. Ce message indique qu'un ou plusieurs disques sont défectueux et que la grappe fonctionne sans la redondance prévue. À ce stade, notamment avec le RAID 5, une seconde panne peut s'avérer fatale.
Soyez attentif aux symptômes moins visibles mais tout aussi dangereux, comme une chute soudaine et inexpliquée des performances . Si les temps de lecture et d'écriture augmentent considérablement, notamment lors de l'accès à certains volumes ou dossiers, le contrôleur peut rencontrer des difficultés avec des secteurs difficiles à lire ou subir des tentatives de relecture continues qui surchargent le système.
Les journaux système ou de contrôleur affichent souvent des erreurs d'E/S, des messages de parité incorrects, des erreurs de lecture irrécupérables, des échecs de contrôle de parité ou des erreurs de bande défectueuse détectées. Une augmentation soutenue des erreurs de lecture/écriture , même si le système fonctionne encore, est un signal d'alarme à ne pas ignorer.
Un autre signe d'alerte est la dégradation apparente du volume, même si aucun disque n'est apparemment totalement défaillant . Cela indique généralement une corruption logique des métadonnées RAID ou des blocs distribués, et forcer une reconstruction automatique dans cet état peut propager la corruption à l'ensemble de la grappe.
Symptômes de corruption logique et problèmes silencieux dans un RAID
Les pannes RAID ne se traduisent pas toutes par un disque instantanément inutilisable. Souvent, le problème est une corruption progressive des données qui s'installe silencieusement jusqu'à ce que la situation devienne très difficile à résoudre.
Un exemple typique est celui de fichiers qui semblent présents, ont la bonne taille et le bon nom, mais qui ne s'ouvrent pas, présentent des erreurs de formatage ou apparaissent tronqués . Les bases de données qui ne se montent pas, les machines virtuelles qui ne démarrent pas ou les images que la visionneuse rejette sont généralement des indicateurs d'incohérences dans la répartition des blocs sur les disques.
Il est fréquent que le système d'exploitation ou les applications présentent des ralentissements localisés sur certains volumes RAID, même si le processeur et la mémoire vive ne semblent pas particulièrement sollicités. Si le ralentissement se concentre sur les opérations de lecture/écriture sur le même volume, il est fort probable que vous soyez confronté à une corruption de données ou à des secteurs instables.
Un autre symptôme inquiétant est que les reconstructions qui démarrent après un changement de disque s'arrêtent systématiquement au même point , génèrent des erreurs étranges ou signalent simplement l'échec du processus. Cela indique généralement que les blocs sources sont déjà corrompus et que le contrôleur est incapable de générer une copie cohérente sur le nouveau disque.
Il arrive parfois qu'un seul disque présente des alertes SMART (secteurs réalloués, temps d'accès élevés, etc.), mais ce comportement anormal est perceptible sur l'ensemble de la grappe RAID. Dans ce cas, un seul disque présentant des secteurs défectueux peut compromettre la cohérence de la grappe entière, notamment lors d'un contrôle de parité ou d'une reconstruction.
Ignorer ces avertissements et poursuivre les opérations normalement, ou pire, forcer des tâches intensives telles que des vérifications, des sauvegardes massives ou des reconstructions automatiques, peut propager la corruption et écraser des blocs valides avec des données endommagées . Dès lors, même les outils professionnels ne peuvent garantir une récupération complète.
Pannes typiques des contrôleurs, serveurs et cartes mères
Les disques ne sont pas le seul facteur en cause. Le contrôleur RAID, la carte mère, voire le serveur entier, peuvent constituer le maillon faible et provoquer des pannes de la grappe RAID, même si les disques sont en bon état.
Le contrôleur RAID, qu'il soit dédié ou intégré à la carte mère, détermine l' emplacement d'écriture de chaque bloc, le calcul de la parité et l'assemblage des volumes . Une panne, un firmware corrompu ou une surtension peuvent le désactiver, entraînant la disparition de la grappe RAID ou son affichage avec les mentions « Étranger », « Hors ligne », etc.
Dans le cas des contrôleurs matériels dédiés, un problème supplémentaire se pose : l’ incompatibilité quasi totale entre les modèles et les fabricants . Si un contrôleur Supermicro spécifique tombe en panne, par exemple, il ne suffit pas de le remplacer par un modèle similaire : souvent, il faut exactement le même modèle, avec une version de firmware similaire, pour qu’il puisse lire correctement les métadonnées RAID.
Avec les solutions RAID intégrées (dites « fausses RAID »), comme certains RAID logiciels pour chipsets AMD ou Intel, le risque est qu'un remplacement de carte mère, une réinitialisation du BIOS ou la perte de la configuration CMOS rendent la grappe RAID inopérante. Sur de nombreux ordinateurs de bureau et stations de travail, une panne de carte mère ou de pile CMOS peut effacer la configuration RAID, isolant ainsi les disques.
De plus, le serveur lui-même ( alimentation , mémoire, carte mère, fond de panier, etc.) peut tomber en panne suite à des problèmes électriques, une surchauffe ou des défauts matériels. Dans de nombreux cas, le RAID devient inaccessible , même si, en réalité, les disques, connectés à un autre système avec la stratégie appropriée, pourraient récupérer leurs données.
Pour ne rien arranger, le système doit « réassembler » la grappe RAID à chaque redémarrage. Si des coupures de courant, des surtensions ou des erreurs dans les fichiers de configuration (comme mdadm.conf sous Linux) surviennent pendant ce processus, le système risque de mal assembler la grappe, de la laisser incomplète ou tout simplement de ne pas la reconnaître, rendant ainsi le volume inutilisable.
Causes fréquentes de perte de données dans les matrices RAID
Compte tenu de ce qui précède, il apparaît clairement que les systèmes RAID, bien qu'utiles, restent exposés à des risques considérables. Les principales causes de perte de données dans ces environnements résultent généralement d'une combinaison de facteurs physiques, logiques et humains.
La cause la plus évidente est la défaillance d'un ou plusieurs disques due à l'usure, à des défauts de fabrication, aux vibrations, aux variations de température ou aux chocs. Bien que le RAID soit conçu pour résister à certaines de ces situations, il n'est pas toujours exempt de dommages collatéraux : un disque présentant des secteurs corrompus peut entraîner la défaillance d'un disque voisin, notamment lors des processus de vérification ou de reconstruction.
Une autre source fréquente de problèmes réside dans les erreurs d'assemblage ou de reconstruction . Si le système monte la grappe RAID avec des paramètres incorrects, des disques mal ordonnés, des niveaux RAID différents des originaux, ou après une migration ayant échoué, les données peuvent facilement se désaligner. Concrètement, le volume peut apparaître comme RAW, nécessiter un formatage ou afficher des structures de fichiers incohérentes.
Les pannes de serveur (carte mère, firmware, fond de panier, contrôleur SAS/SATA, etc.) jouent également un rôle important. Dans une très grande majorité des cas, lorsqu'un serveur tombe soudainement en panne, la grappe RAID devient inaccessible et les données ne sont plus visibles par le système, même si elles sont toujours physiquement présentes sur les disques.
À tout cela, il faut ajouter les facteurs humains : modifications de configuration sans documentation, réorganisation des disques « pour tester », mises à jour du BIOS sans sauvegarde préalable de la configuration, suppression accidentelle de volumes, réinstallation du système d’exploitation sur des disques qui faisaient partie de la grappe, ou restauration de sauvegardes corrompues ou incomplètes sur le même RAID endommagé.
Enfin, il existe des menaces externes telles que les rançongiciels, capables de chiffrer à la fois les données et la structure des volumes hébergés sur des baies RAID. Dans ce cas, le processus de récupération se complexifie d'autant plus : il faut d'abord déchiffrer le système, puis traiter l'éventuelle corruption interne du RAID lui-même.
Que NE PAS faire lorsque votre RAID commence à dysfonctionner
Lorsqu'un serveur tombe en panne le week-end et que l'inquiétude monte, la réaction la plus courante est de tenter de le réparer sur le champ. C'est compréhensible, mais nombre de ces efforts, pourtant bien intentionnés, contribuent précisément à aggraver la situation.
La tentation la plus dangereuse consiste à forcer une reconstruction automatique sans analyser au préalable l'état réel des disques . Si l'un des disques contient des données corrompues ou des secteurs illisibles, la reconstruction copiera et mélangera des données erronées avec des données saines jusqu'à ce que la structure du volume soit complètement détruite.
Une autre erreur fréquente consiste à remplacer les disques au hasard, sans savoir lequel est endommagé ni consigner leur position d'origine . Déplacer des disques d'une baie à l'autre, les mélanger entre différents contrôleurs ou en remplacer plusieurs simultanément sans planification peut perturber le contrôleur et entraîner une perte de configuration du RAID.
L'exécution directe d'outils comme CHKDSK sous Windows ou fsck sous Linux sur un volume RAID présentant des signes de corruption est également très risquée. Ces utilitaires tentent de « réparer » la structure des fichiers à partir de tables potentiellement endommagées , et leurs réparations impliquent souvent la suppression d'entrées, le déplacement de blocs et la réécriture des métadonnées. Dans un environnement déjà compromis, cela peut entraîner la perte définitive de milliers de fichiers.
Il est tout aussi problématique de se fier à des logiciels de récupération RAID génériques qui promettent de « configurer automatiquement n'importe quel RAID ». Nombre de ces outils fonctionnent superficiellement, en supposant des configurations standard de bandes, de décalages et de parité qui ne sont pas toujours respectées. Une mauvaise utilisation peut écraser des secteurs essentiels ou laisser les disques dans un état pire qu'avant leur installation.
Enfin, redémarrer le serveur à répétition, mettre hors tension ou sous tension le NAS, ou continuer à travailler normalement sur une grappe RAID dégradée ou présentant des erreurs de parité ne fait qu'aggraver les dommages aux disques, réallouer davantage de secteurs et propager la corruption . Plus le nombre d'écritures effectuées après le premier problème sérieux est élevé, moins les techniciens auront de marge de manœuvre.
Mesures de précaution à prendre en cas de détection d'une possible défaillance RAID
En cas de symptômes graves (bruit, dégradation de l'état, erreurs de parité, lenteur extrême, échecs de reconstruction, etc.), la meilleure solution consiste à ralentir et à procéder méthodiquement . Ce que vous n'écrivez ou ne modifiez pas maintenant pourra peut-être être récupéré plus tard.
La première chose à faire est d'arrêter immédiatement toute opération d'écriture sur la baie : aucune copie de données, aucune nouvelle machine virtuelle, aucune mise à jour massive. Si le volume est encore accessible, il est préférable de le monter en lecture seule si le système le permet.
Ensuite, il est conseillé de documenter l'état actuel le plus précisément possible : captures d'écran du BIOS ou de l'interface NAS, liste des disques avec leur emplacement physique, leur numéro de série, les ports auxquels ils sont connectés, messages d'erreur exacts apparaissant dans les journaux, etc. Ces informations sont précieuses pour tout laboratoire de récupération lors de la reconstitution du scénario initial.
Si le RAID ne parvient pas à se monter ou si le serveur ne démarre pas, une solution technique consiste à retirer les disques et à les connecter à un autre ordinateur afin de créer des copies forensiques secteur par secteur de chaque disque . Ces copies, réalisées en mode lecture seule, permettent de travailler ultérieurement sur des clones sans endommager davantage les disques originaux.
Grâce à des connaissances approfondies, des outils spécialisés et un environnement contrôlé, il est possible de tenter une reconstruction logique de la matrice à partir de ces clones, en déduisant l'ordre des disques, la taille des bandes, les motifs de parité, les décalages et les métadonnées . Cependant, il s'agit d'une opération de rétro-ingénierie délicate : toute manipulation empirique impliquant des modifications aléatoires des paramètres peut conduire à une mauvaise interprétation des données.
Pour la plupart des entreprises et des environnements critiques, la solution la plus sûre consiste à contacter au plus vite un service professionnel de récupération RAID et à suivre ses instructions initiales. Le taux de réussite est généralement étroitement lié au nombre de tentatives infructueuses effectuées avant de faire appel au laboratoire.
Comment fonctionnent les laboratoires professionnels de récupération RAID
Les services professionnels de récupération de données spécialisés dans les environnements RAID combinent une connaissance approfondie du matériel et des systèmes de fichiers avec des outils propriétaires et des procédures rigoureuses. Voici, en résumé, ce qu'ils font généralement lorsqu'ils sont confrontés à une défaillance RAID.
La première étape consiste à effectuer un diagnostic individuel sur chaque disque dur : l’état mécanique, électronique et logique des disques est vérifié, les secteurs défectueux sont identifiés, les tables SMART sont examinées et le risque de panne à court terme est évalué. Si des disques présentent des dommages physiques, leur traitement en salle blanche est prioritaire.
Ensuite, des clones forensiques de tous les disques concernés sont créés . Au lieu de travailler sur les originaux, une copie secteur par secteur est réalisée à l'aide d'outils permettant d'ignorer les secteurs gravement endommagés ou de réessayer avec des séquences de référence sûres. L'objectif est de préserver l'état initial au cas où il serait nécessaire de revenir à une étape précédente du processus.
Une fois les clones prêts, une reconstruction logique manuelle du RAID est effectuée : le niveau (0, 1, 5, 6, 10, etc.), l’ordre des disques, la taille des bandes, les décalages, les algorithmes de parité et toutes les autres caractéristiques du contrôleur d’origine sont identifiés. Souvent, le volume peut être reconstruit même sans utiliser le contrôleur ou le NAS ayant servi à sa création.
Une fois le volume virtuel reconstruit cohérent, le système de fichiers est réparé si nécessaire : NTFS, ReFS, ext4, XFS, Btrfs, ZFS, VMFS, etc. Ce travail s’apparente à celui d’un chirurgien : les structures sont corrigées, les tables d’inodes, les MFT, les superblocs ou les journaux sont reconstruits, en veillant toujours à altérer le strict minimum.
Enfin, les données sont extraites et validées systématiquement. La cohérence des bases de données principales, des machines virtuelles et des dossiers critiques est vérifiée, l'ouverture correcte des fichiers est contrôlée et les données sont transférées sur un nouveau support de stockage isolé , tel qu'un disque dur externe ou un nouveau NAS, afin que le client puisse examiner la récupération avant de l'accepter.
Dans des scénarios particulièrement complexes, tels que les RAID affectés par un ransomware, des reconstructions précédentes ayant échoué ou des volumes virtuels au sein de matrices déjà endommagées, les techniques de déchiffrement, l'analyse forensique et la reconstruction RAID sont combinées, mais toujours selon la même règle : ne pas toucher aux originaux plus que strictement nécessaire.
En définitive, les systèmes RAID constituent un outil puissant pour améliorer la disponibilité des données, mais ils restent vulnérables aux erreurs physiques, logiques et humaines. Comprendre leurs faiblesses, identifier les signes avant-coureurs et, surtout, éviter les décisions impulsives en cas de panne sont autant d'éléments qui font la différence entre une simple frayeur et une catastrophe pour les données.

Sommaire
- 1 Qu’est-ce qu’une panne RAID et pourquoi n’est-ce pas la même chose qu’une sauvegarde ?
- 2 Principaux niveaux RAID et leur impact sur la récupération
- 3 Signes évidents de défaillance de votre RAID
- 4 Symptômes de corruption logique et problèmes silencieux dans un RAID
- 5 Pannes typiques des contrôleurs, serveurs et cartes mères
- 6 Causes fréquentes de perte de données dans les matrices RAID
- 7 Que NE PAS faire lorsque votre RAID commence à dysfonctionner
- 8 Mesures de précaution à prendre en cas de détection d'une possible défaillance RAID
- 9 Comment fonctionnent les laboratoires professionnels de récupération RAID