- De fleste RAID-systemkatastrofer forverres av forhastede handlinger i løpet av de første minuttene etter feilen.
- Hvert RAID-nivå håndterer data og paritet forskjellig, noe som bestemmer den faktiske risikoen og gjenopprettingsstrategien.
- Den profesjonelle intervensjonen kombinerer diskkloning, rekonstruksjon av virtuelle arrayer og avanserte logiske analyseteknikker.
- En RAID erstatter ikke sikkerhetskopier: forebygging og en ordnet respons er nøkkelen til å lagre data.
Når et RAID-system svikter, er de første minuttene kritiske. I den såkalte «gylne timen» etter feilen skjer de fleste menneskelige feil, og forvandler et problem som kan repareres til en irreversibel katastrofe. Blind diskbytte, konstant omstart eller forsøk på å gjenoppbygge uten å vite hva som er galt, er vanligvis den raskeste veien til totalt datatap.
Hvorfor er RAID-gjenoppretting så delikat?
I mange kritiske hendelser er ikke datatap forårsaket av den første maskinvarefeilen, men av forhastede handlinger som ble utført i løpet av den første timen . Denne perioden er avgjørende: en disk kan endre posisjon, en initialiseringsprosess kan startes ved en feiltakelse, en gjenoppbygging kan bli tvunget frem, eller systemet kan starte opp fra en ufullstendig sikkerhetskopi på samme lagringsarray, og det som en gang var et komplekst, men håndterbart problem, blir et nesten umulig puslespill.
De vanligste risikosituasjonene inkluderer å bytte disker i feil rekkefølge (i RAID 0, 1, 5, 6, 10 osv.), erstatte kontrolleren med en annen modell uten å klone eller dokumentere konfigurasjonen, tvinge disker "online" uten å analysere den faktiske tilstanden, initialisere feil volumer eller starte gjenoppbygginger som ikke er ferdige og ytterligere ødelegger den interne strukturen til arrayet.
Spesielt farlig er også sikkerhetskopiering og gjenoppretting direkte på det skadede systemet , VMware Storage vMotion-type lagringsmigreringer med en ustabil array, og enhver operasjon som skriver nye RAID-konfigurasjonsmetadata på disker med potensielt gjenopprettelig informasjon.
En RAID-matrise er grunnlaget for de fleste fysiske servere, NAS-er og SAN-systemer, og det er ikke alltid umiddelbart klart at problemet stammer fra selve matrisen. Derfor, når du er i tvil, er det klokeste å stoppe all skriving til diskene , dokumentere situasjonen i detalj og søke råd fra spesialister på datagjenoppretting før du foretar ytterligere endringer.
Typiske menneskelige feil og grunnleggende god praksis
Når et RAID-system går inn i en degradert tilstand, én eller flere disker svikter, eller NAS-en ikke starter opp, er den instinktive reaksjonen vanligvis å prøve ting «til noe fungerer». Denne tilnærmingen ender nesten alltid opp med å forverre problemet fordi hver handling etterlater et spor på diskene og kan overskrive paritet, metadata eller brukerdata som fortsatt er intakte.
Blant de vanligste feilene som kompliserer gjenoppretting er handlinger som å konfigurere en ny RAID med samme kontroller og disker , sette disse diskene inn i et annet lagringskabinett for å "se om den gjenkjenner dem", eller endre den fysiske rekkefølgen på diskbrønnene. I en høy andel tilfeller overskriver disse handlingene den opprinnelige konfigurasjonen, ødelegger paritetsstripene og reduserer drastisk sjansene for suksess.
En annen vanlig dårlig praksis er å ikke registrere alt som skjer. I et komplekst feilscenario er det viktig å logge alle hendelser kronologisk : strømbrudd, systemmeldinger , diskendringer, gjenoppbyggingsforsøk, fastvareoppdateringer osv. Denne informasjonen hjelper senere spesialiserte teknikere med å sette sammen puslespillet.
Det er like viktig å dokumentere og bevare den nøyaktige posisjonen til hver disk i arrayet . Å bytte diskbrønner "med øye" eller å kaste angivelig døde disker er hensynsløst: hvis RAID-en må settes sammen på nytt i et laboratorium senere, kan det å vite hvilken disk som var i hvilket spor og ha alle de originale diskene (til og med de erstattede) tilgjengelige utgjøre hele forskjellen.
Som en generell regel bør følgende handlinger iverksettes i tilfelle en RAID-feil: stopp datamaskinen, ikke konfigurer noe på nytt, hold alle disker merket , samle så mye informasjon som mulig om hendelsen, og hvis dataene er viktige, kontakt en profesjonell gjenopprettingstjeneste før du fortsetter å eksperimentere.
Hvordan fagfolk går frem for å gjenopprette RAID-systemer
Selskaper som spesialiserer seg på RAID-datagjenoppretting jobber med svært strukturerte prosedyrer fordi hver tekniske avgjørelse må minimere risikoen for ytterligere skade . I et typisk tilfelle med flere disker og terabyte med data på spill, kan ethvert improvisert trinn være kostbart.
Et svært illustrerende eksempel fra den virkelige verden er en RAID-matrise med tolv disker og omtrent 12 TB med data. Sikkerhetskopieringen hadde ikke blitt håndtert riktig, så den eneste levedyktige løsningen var å kontakte et profesjonelt RAID-datagjenopprettingsfirma . Situasjonen var presserende; driften måtte gjenopptas så snart som mulig, og matrisen hadde allerede nådd en kritisk tilstand etter at to disker sviktet under en rekonfigurasjon.
I slike tilfeller begynner spesialister vanligvis med å klone alle fungerende disker og alltid jobbe med kopier, ikke originalene. Samtidig forsøker de å reparere, så langt det er mulig, de fysisk skadede diskene, enten gjennom laboratorieinngrep (renrom, utskifting av diskhoder, donorelektronikk osv.) eller med avanserte teknikker for delvis lesing.
Når det gjaldt 12 TB-disken, var det største problemet at RAID-rekonfigurasjonen hadde startet før den andre feilen , slik at kontrolleren allerede delvis hadde beregnet de nye paritetsverdiene på nytt. Den relative fordelen var at den andre disken feilet i de tidlige stadiene av prosessen, slik at mye av den gamle logiske strukturen fortsatt kunne gjenopprettes.
Etter å ha gjenopprettet en av de skadede diskene og generert en komplett kopi, var utfordringen å manuelt rekonstruere den logiske strukturen til arrayet : diskrekkefølge, blokkstørrelse, paritetsfordeling, mulige endringer underveis i prosessen ... Dette arbeidet, som kan ta flere dager med analyse, tillot oss å gjenopprette rundt 90 % av dataene, noe som, gitt omstendighetene, anses som en høy suksessrate i RAID-gjenoppretting.
Profesjonelle tjenester: hva de vanligvis tilbyr og hvordan de jobber
Selskaper som spesialiserer seg på RAID-datagjenoppretting tilbyr vanligvis rask, gratis diagnostikk , spesielt for kritiske servere eller produksjons-NAS-enheter. I noen tilfeller forplikter de seg til å vurdere problemet innen få timer, gi en mulighetsrapport og et fast pristilbud, og overholde en «ingen gjenoppretting, ingen kostnad»-policy.
En typisk tjeneste starter når klienten ber om et gratis tilbud for å gjenopprette RAID-en sin . I denne innledende fasen samles informasjon om array-typen (RAID 0, 1, 5, 6, 10, JBOD osv.), antall disker, filsystemet (f.eks. ext4, Btrfs, XFS, HFS+, NTFS…), maskinvaren som er involvert (Synology NAS, QNAP, merkevareservere, SAN-arrayer…), og en detaljert beskrivelse av symptomene og tiltakene som er iverksatt så langt.
Når studien er godkjent, arrangerer selskapet vanligvis gratis henting av utstyret eller skivene , med nøyaktige pakkeinstruksjoner: bruk antistatisk eller polstret emballasje, plasser enheten i en stiv eske med støtdempende materiale, forhindre at skivene beveger seg under transport og merk godt med søknadsnummeret.
Tilbake i laboratoriet utfører teknikerne en fysisk og logisk diagnostikk av hver disk , lager bit-for-bit-bilder når det er mulig, evaluerer tilstanden til sektorene og bestemmer hvordan RAID-en skal rekonstrueres virtuelt. Først da presenteres et endelig tilbud, inkludert estimert prosentandel av gjenopprettbare data og omtrentlig behandlingstid.
Hvis klienten godkjenner, starter selve gjenopprettingsprosessen. Etter å ha stabilisert diskene og satt opp RAID-en i et kontrollert miljø, genererer spesialistene en liste over tilgjengelige filer. Frem til dette punktet har klienten vanligvis ikke betalt noe . Bare hvis listen er tilfredsstillende, kopieres dataene til nye lagringsmedier (en ekstern harddisk, en erstatnings-NAS osv.) og sendes tilbake til klienten, nesten alltid inkludert frakt.
Grunnleggende: hvordan en RAID fungerer på innsiden
Et RAID-system er enkelt sagt et sett med fysiske disker som presenteres for operativsystemet som én logisk enhet . Nøkkelen ligger i hvordan dataene distribueres, og potensielt pariteten mellom diskene for å oppnå ytelse, kapasitet, feiltoleranse eller en kombinasjon av disse.
RAID-teknologi lar data distribueres i striper eller blokker som skrives parallelt på tvers av flere disker, noe som akselererer tilgangen ved å kombinere overføringer. I tillegg lagres redundante data (paritet) på bestemte nivåer for å beregne dataene fra en defekt disk på nytt uten avbrudd i tjenesten, forutsatt at feilgrensene som er spesifisert i arraydesignet ikke overskrides.
En annen viktig fordel er muligheten til å bytte disker under drift på mange systemer. Dette betyr at en defekt disk kan fjernes og erstattes fysisk uten å slå av serveren eller lagringsarrayet, slik at kontrolleren kan rekonstruere de tapte dataene på den nye disken i bakgrunnen mens systemet fortsetter å fungere.
Det finnes ikke et enkelt «perfekt RAID-nivå» som passer alle scenarier. Hvert nivå prioriterer en annen balanse mellom ytelse, sikkerhet og brukbar kapasitet . Derfor er det avgjørende å forstå hvilken type RAID som er konfigurert før man prøver å reparere eller gjenopprette.
Når noe går galt, kan RAID-systemet vanligvis rekonstruere dataene hvis den planlagte feiltoleransen er oppfylt. Men når flere fysiske, logiske eller menneskelige problemer oppstår etter hverandre, kan arrayet miste koherens og ikke klare å gjenopprette seg selv, noe som krever ekspertinngripen.
Vanlige RAID-nivåer og deres egenskaper
Hvert RAID-nivå håndterer datadistribusjon og paritet mellom disker forskjellig , noe som resulterer i svært tydelige forskjeller i oppførsel ved feil. Å forstå disse forskjellene hjelper med å vurdere den faktiske risikoen for en feil og sannsynligheten for en vellykket gjenoppretting.
RAID 0, kjent for sin høye ytelse, distribuerer data i striper over minst to disker uten å lagre overflødig informasjon. Dette betyr at tap av én enkelt disk resulterer i tap av hele volumet , siden deler av hver fil er spredt over alle stasjoner. Hovedfordelen er hastighet, men fra et datasikkerhetsperspektiv er det svært sårbart.
RAID 1, eller speiling, opprettholder identiske kopier av data på to disker . Hvis den ene feiler, fortsetter den andre å fungere sømløst. Det er enkelt, pålitelig og tilbyr gode lesehastigheter, selv om det ofrer brukbar kapasitet, ettersom den tilgjengelige plassen tilsvarer plassen til en enkelt disk i paret. Ved gjenoppretting gjør det vanligvis mye enklere å ha minst én av diskene intakt.
Det finnes også RAID-nivåer som RAID 3 og RAID 4, mindre vanlige i dag, som kombinerer datadisker med en dedikert paritetsdisk . I RAID 3 er tilgangen til datadiskene samtidig, og paritetsdisken blir en potensiell flaskehals, mens RAID 4 gir mer uavhengig tilgang til hver datadisk, noe som forbedrer ytelsen under visse arbeidsbelastninger.
RAID 5 er sannsynligvis den mest brukte RAID-konfigurasjonen i server- og NAS-miljøer. Den distribuerer data i striper på tvers av flere disker og fletter sammen paritetsblokker fordelt mellom alle stasjonene , uten å dedikere en enkelt disk utelukkende til den funksjonen. Denne konfigurasjonen tillater gjenoppretting av data på en erstatningsdisk hvis en feil oppstår, forutsatt at det ikke oppstår en ny feil under gjenopprettingsprosessen.
RAID 6 tar sikkerhet et skritt videre ved å lagre to paritetsblokker for hvert datasett , slik at det kan tåle samtidig feil på opptil to disker uten datatap. Det krever mer diskkapasitet for paritet og mer datakraft, men tilbyr til gjengjeld en mye større feilmargin i tilfelle kjedede feil, en høyt verdsatt funksjon i store arrayer.
I tillegg til disse «klassiske» RAID-nivåene finnes det kombinasjoner som RAID 10 (speiling + striping), RAID 50 eller 60, og lineære eller JBOD-konfigurasjoner, der disker ganske enkelt sammenkobles for å danne et stort volum , uten ekte redundans. I ingen av disse tilfellene erstatter RAID et godt designet sikkerhetskopieringssystem.
Typiske RAID-systemfeil og når gjenoppretting blir komplisert
RAID-systemer har et rykte for robusthet, og med rette, men de er ikke immune mot problemer. I praksis oppstår fysiske, logiske og menneskelige feil , ofte sammenflettet og fører til utfordrende gjenopprettingssituasjoner.
Fra et logisk synspunkt er en av de mest alvorlige hindringene tap eller korrupsjon av paritetsstriper . Når metadataene som indikerer hvordan data og paritet er fordelt på tvers av disker, forringes, kan ikke RAID-en lenger regenerere informasjonen på egenhånd, og ekstern inngripen er nødvendig for å finne og gjenoppbygge disse stripene manuelt eller halvautomatisk.
Når det gjelder maskinvare, viser statistikk at en liten prosentandel av disker i en gitt infrastruktur kan få fysiske feil hvert år, rundt 2–3 %. I en array med mange disker betyr dette at sjansene for minst én feil ikke er ubetydelige. Mekaniske feil, strømstøt, feil fastvare, ekstreme temperaturer eller komponenter av dårlig kvalitet er vanlige årsaker til fysiske feil.
Problemene forverres når det oppstår en ny feil under en gjenoppbygging, spesielt i RAID 5 eller konfigurasjoner med mange disker. Hvis en annen disk begynner å oppleve alvorlige feil mens systemet regenererer data fra en defekt disk, kan arrayet gå fra å være degradert til fullstendig utilgjengelig. Når flere disker feiler enn forventet toleranse , er ikke RAID-ens interne logikk lenger tilstrekkelig, og avanserte gjenopprettingsteknikker må brukes.
Menneskelige feil fullfører cocktailen: å utsette utskiftingen av en disk som allerede ga advarsler, ignorere kontrolleralarmer, feilaktig slå av systemer ved gjentatte strømbrudd , installere utilstrekkelige drivere , tvinge frem kontinuerlige omstarter eller bruke vedlikeholdsprosedyrer uten nylige sikkerhetskopier er praksiser som øker risikoen for datatap betraktelig.
Bruk av spesialisert programvare: et praktisk eksempel med R-Studio
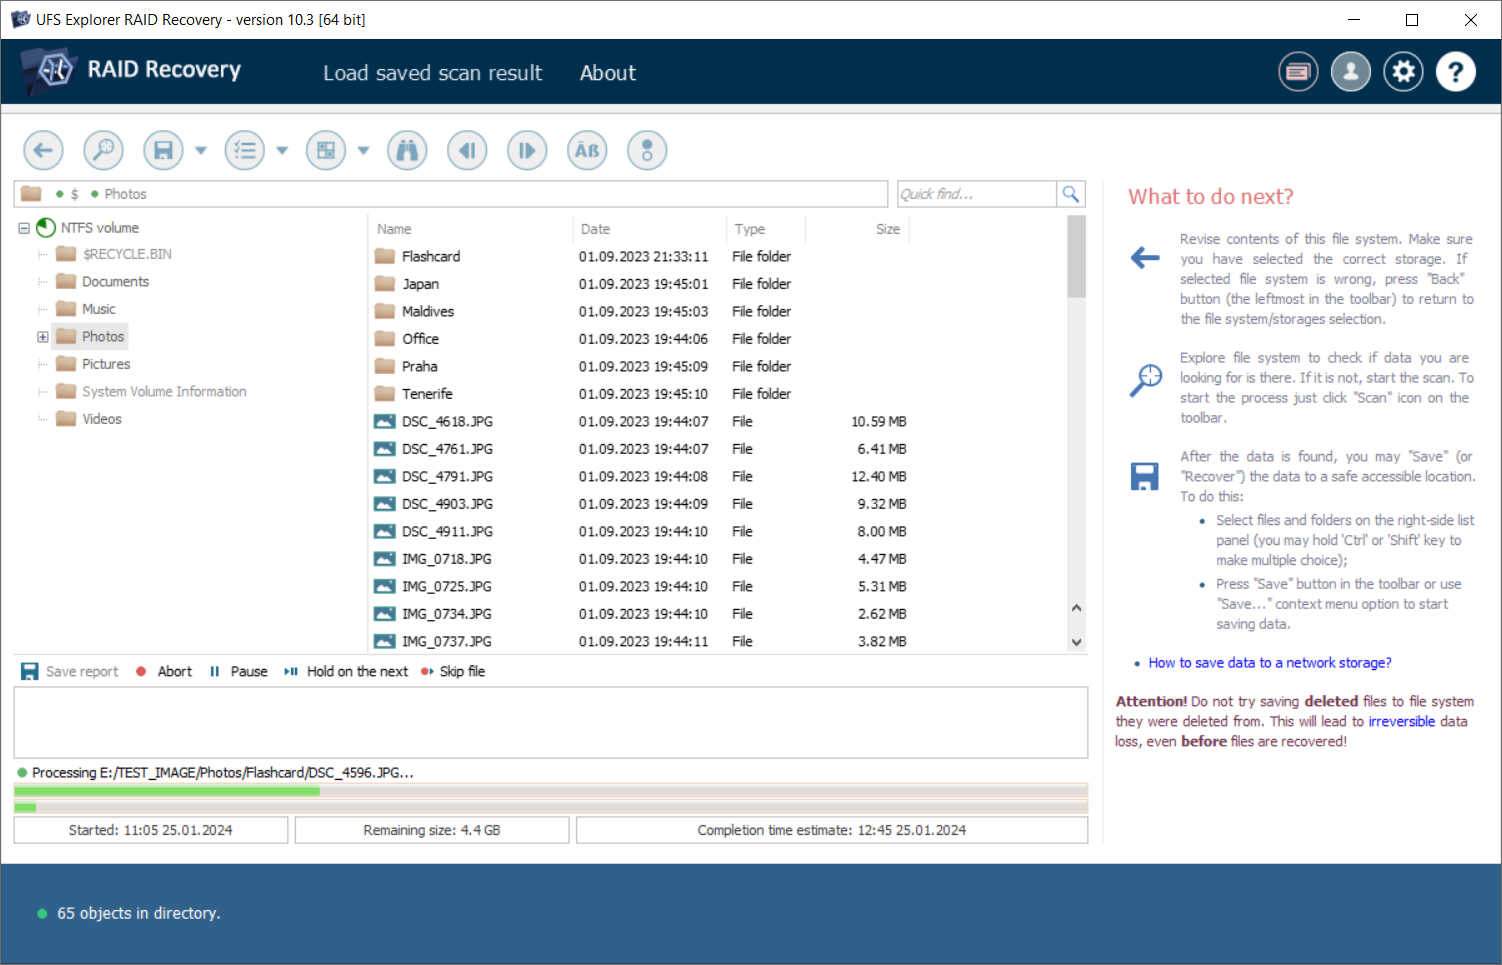
Når RAID-en ikke lenger er tilgjengelig via den opprinnelige kontrolleren, er et av de tekniske alternativene å virtuelt gjenoppbygge arrayet ved hjelp av spesialisert programvare . Verktøy som R-Studio lar deg oppdage fortsatt konsistente RAID-er som om de var normale volumer, og i mer alvorlige tilfeller å opprette virtuelle RAID-er fra disker eller diskavbildninger.
Driftsprinsippet innebærer å opprette en virtuell RAID-matrise basert på fysiske disker eller deres imagekopier , ved å manuelt legge inn parametere som antall disker, blokkstørrelse, startforskyvning, RAID-type (0, 1, 4, 5, 6, 10, JBOD, ZFS RAIDZ, RAIDZ2, osv.) og diskrekkefølge. Når programvaren oppdager et gyldig filsystem, presenteres denne virtuelle RAID-matrisen som et navigerbart volum hvorfra filer kan listes opp og gjenopprettes.
For eksempel, for en enkel RAID 5-matrise med tre disker, 64 KB-blokker og asynkron venstreparitet, ville du ganske enkelt velge de tre diskene i riktig rekkefølge , spesifisere blokkstørrelsen, angi riktig forskyvning og la verktøyet identifisere partisjonen. Derfra kan du åpne volumet, undersøke mappene, forhåndsvise filer (spesielt store) og bekrefte at strukturen er montert riktig.
I mer komplekse konfigurasjoner, som for eksempel en RAID 5 med 4KB-blokker og et tilpasset paritetsmønster, må en blokkrekkefølgetabell defineres manuelt . Dette innebærer å angi, rad for rad, hvilken disk som inneholder hver data- eller paritetsblokk, slik at sekvensen er konsistent. Programvaren varsler deg når den oppdager uoverensstemmelser i denne tabellen, slik at de kan korrigeres før endringene implementeres.
En viktig forholdsregel er at disse virtuelle RAID-ene er rent logiske objekter i programvaren : de skriver ingenting til de originale diskene de ble opprettet fra. Dette lar deg eksperimentere med forskjellige kombinasjoner av parametere til du finner den som gjenoppbygger filsystemet på riktig måte uten å risikere ytterligere skade.
I tilfeller der en fysisk disk mangler, lar noen verktøy deg erstatte den med en "manglende disk" eller en tom blokk med plass, som simulerer oppførselen til en degradert RAID. Likevel, for at filgjenoppretting skal være pålitelig, må alle parametere være korrekte; en enkelt feil blokkstørrelse eller en feilberegnet offset kan ødelegge de utpakkede filene, derav viktigheten av teknisk ekspertise.
RAID-typer og deres oppførsel i møte med datatap
Utover de klassiske RAID-nivåene støtter dagens RAID-systemer et bredt utvalg av hybride og lineære konfigurasjoner . Hver av dem presenterer forskjellige utfordringer når det gjelder å gjenopprette data etter en kritisk feil.
I en RAID 0-matrise (pure striping) fragmenteres data i små grupper som skrives sekvensielt til alle diskene i matrisen. Den totale kapasiteten er summen av alle stasjonene, men det er ingen redundans av noe slag . Hvis en av diskene svikter, blir hele volumet ubrukelig, og det eneste gjenopprettingsalternativet involverer avanserte teknikker som prøver å rekonstruere hva som kan gjøres fra de gjenværende diskene.
RAID 1 opprettholder alltid identiske kopier av alle data på hver disk i speilet . Denne enkelheten er en stor fordel i gjenopprettingsprosesser, fordi hvis en av diskene forblir intakt, kan dataene nås direkte som om den var en uavhengig disk, eller innholdet kan kopieres til en ny stasjon og speilet kan gjenskapes senere.
I RAID-nivåer som RAID 4 og RAID 5, der paritet er fordelt forskjellig, er den brukbare kapasiteten vanligvis summen av alle disker minus kapasiteten til bare én. Behovet for å matematisk rekonstruere en disks data fra paritet er det som kompliserer gjenoppretting når feil oppstår sekvensielt og flere disker går tapt enn designet tillater.
Lineære konfigurasjoner eller JBOD-konfigurasjoner (Just a Bunch Of Disks) grupperer flere disker av samme eller ulik størrelse for å danne én større logisk enhet uten å distribuere data parallelt. De tilbyr ingen betydelige ytelsesforbedringer eller redundans: hvis en disk svikter, mister du tilgangen til hele volumet . Gjenoppretting i disse tilfellene innebærer å jobbe på hver disk og manuelt rekonstruere innholdet fra de upåvirkede segmentene.
Alle disse scenariene fremhever at uansett hvor avanserte lagringsteknologier er, er eksterne og verifiserte sikkerhetskopier fortsatt viktige . RAID reduserer eller eliminerer nedetid i tilfelle visse feil, men det beskytter ikke mot utilsiktet sletting, logisk korrupsjon, skadelig programvare eller konfigurasjonsfeil som ødelegger informasjon på filsystemnivå.
Viktige tips for å minimere risikoer og beskytte dataene dine
Den første anbefalingen, uansett hvor åpenbar den kan virke, er å opprettholde en regelmessig sikkerhetskopieringspolicy som ikke er avhengig av selve RAID-en. Dette inkluderer servere, arbeidsstasjoner, smarttelefoner, NAS-systemer og alle andre enheter der verdifulle data er lagret. Bare på denne måten, i tilfelle en alvorlig feil, kan tjenesten gjenopprettes uten å være avhengig av om en rettsmedisinsk gjenoppretting lykkes.
Hvis en hendelse fortsatt oppstår og det ikke finnes noen brukbar sikkerhetskopi, er det klokeste å unngå ethvert forsøk på en gjør-det-selv-reparasjon uten en klar forståelse av trinnene og deres potensielle konsekvenser. Før du kjører verktøy for reparasjon av filsystemet, starter automatiske gjenoppbygginger eller bytter disker mellom brønner, anbefales det å konsultere med spesialister på datagjenoppretting og forklare situasjonen i detalj for dem.
Det er også viktig å være oppmerksom på tidlige tegn på feil : disker som begynner å vise omfordelte sektorer, kontrollere som genererer varsler, systemlogger med I/O-advarsler, lagringsarrayer som markerer en array som degradert ... Å ignorere disse symptomene på grunn av latskap eller frykt for å stoppe tjenesten er vanligvis opptakten til en mye mer alvorlig og kostbar feil.
Til slutt, når dataene er verdifulle, er det verdt å ha en pålitelig leverandør av datagjenoppretting identifisert på forhånd . Når tiden er inne, forkorter en direkte kontakt responstidene, lar deg motta presise instruksjoner fra starten av og øker sannsynligheten for å gjenopprette så mye data som mulig.
Erfaringen som er samlet i utallige tilfeller viser at kombinasjonen av et passende RAID-design, pålitelige sikkerhetskopier, en rolig respons på feil og spesialstøtte når det er nødvendig, er det som virkelig utgjør forskjellen mellom en kontrollert skremsel og et katastrofalt datatap.