- Potoki w systemie Linux umożliwiają łączenie procesów poprzez łączenie stdout i stdin, przy wsparciu jądra i narzędzi takich jak tee, xargs i cpio dla złożonych przepływów.
- Wydajny proces CI/CD w systemie Linux opiera się na dobrym projektowaniu etapów, intensywnym wykorzystaniu pamięci podręcznej, niezmiennych artefaktach i równoległym testowaniu.
- Kluczem do skrócenia czasu jest optymalizacja serwera Linux (procesora, pamięci RAM, wejścia/wyjścia, Dockera) oraz modułów Jenkins, GitHub Actions lub GitLab Runner.
- Integracja zabezpieczeń, możliwości obserwacji i kontroli kosztów w ramach procesu zapewnia niezawodne, możliwe do prześledzenia i zrównoważone wdrożenia w środowiskach produkcyjnych.
Optymalizacja potoków w systemie Linux Nie chodzi tylko o łączenie poleceń za pomocą symbolu |Za tym wszystkim kryje się cały świat optymalizacja wydajnościProjektowanie przepływu pracy, CI/CD, bezpieczeństwo i dostrajanie systemu operacyjnego decydują o różnicy między powolnym, niestabilnym potokiem a takim, który działa sprawnie, jest niezawodny i niedrogi w utrzymaniu. Jeśli pracujesz z serwerami Linux, automatyzując zadania w terminalu lub uruchamiając potoki ciągłej integracji, zrozumienie tych szczegółów zaoszczędzi Ci mnóstwo czasu i nerwów.
W tym artykule połączymy dwie uzupełniające się perspektywy: z jednej strony Klasyczne zastosowanie potoków w wierszu poleceń systemu Linux (rury, przekierowania, polecenia takie jak tee, xargs o cpio); z drugiej strony Optymalizacja potoku CI/CD na serwerach LinuxObejmuje to buforowanie, paralelizację testów, dostrajanie Dockera, bezpieczeństwo łańcucha dostaw i zaawansowane metryki przepływu pracy. Wszystko wyjaśnione w języku hiszpańskim (z Hiszpanii), z przejrzystymi przykładami i bardzo praktycznym podejściem.
Czym jest potok i jak potoki pasują do Linuksa?
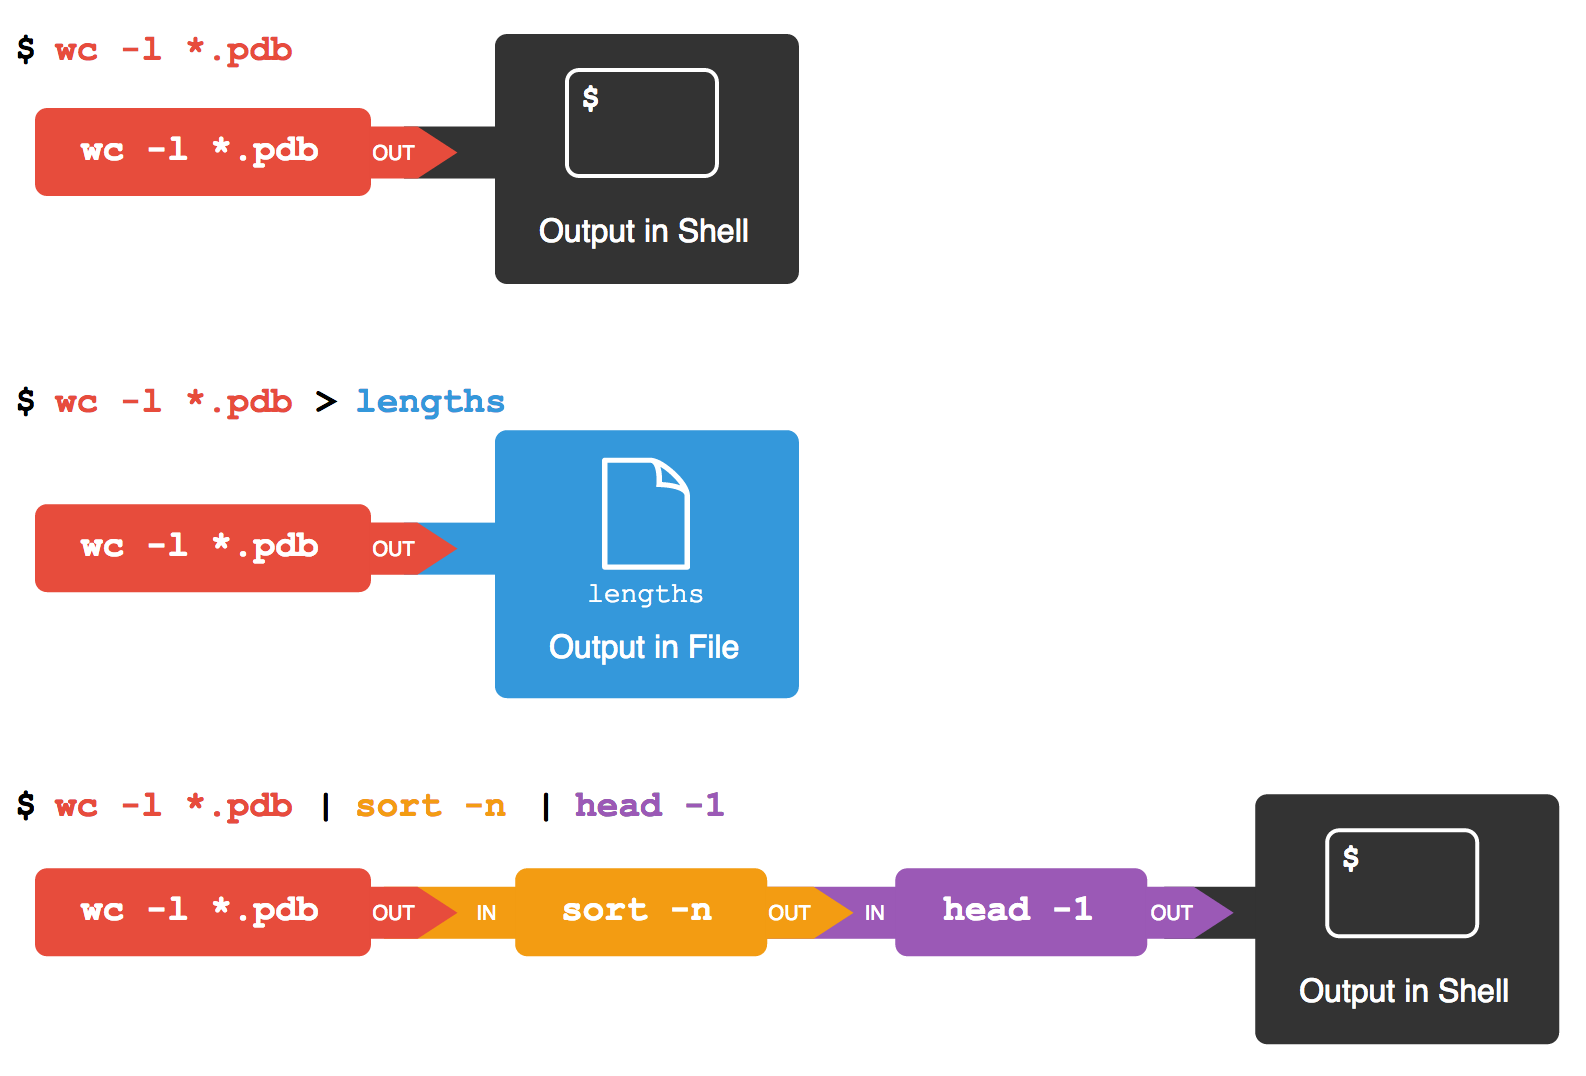
Termin „potok” pochodzi od idei potoku : przepływu danych, który przemieszcza się z jednego punktu do drugiego. W informatyce, a szczególnie w systemie Linux, potok to mechanizm, który pozwala, aby standardowe wyjście jednego procesu stało się standardowym wejściem innego. Innymi słowy, wyjście jednego polecenia jest automatycznie przekazywane do następnego, bez przechodzenia przez pliki pośrednie.
W systemach uniksowych istnieją dwa główne typy potoków . Z jednej strony istnieją potoki anonimowe lub nienazwane , które mogą być używane tylko między blisko powiązanymi procesami (na przykład nadrzędnym i potomnym). Z drugiej strony istnieją potoki nazwane , znane również jako FIFO (First In – First Out), które umożliwiają komunikację między procesami, które nie są bezpośrednio powiązane, a nawet mogą znajdować się na różnych maszynach podłączonych do sieci.
Anonimowe potoki zazwyczaj zapewniają komunikację jednokierunkową : jeden proces zapisuje, a drugi odczytuje. Natomiast potoki nazwane umożliwiają komunikację dwukierunkową , jeśli są odpowiednio zaprojektowane, na przykład poprzez otwarcie kolejki FIFO w trybie odczytu/zapisu z obu stron. Są one powszechnie używane do koordynowania procesów demonów, skryptów lub usług, które muszą przesyłać sobie dane bez blokowania.
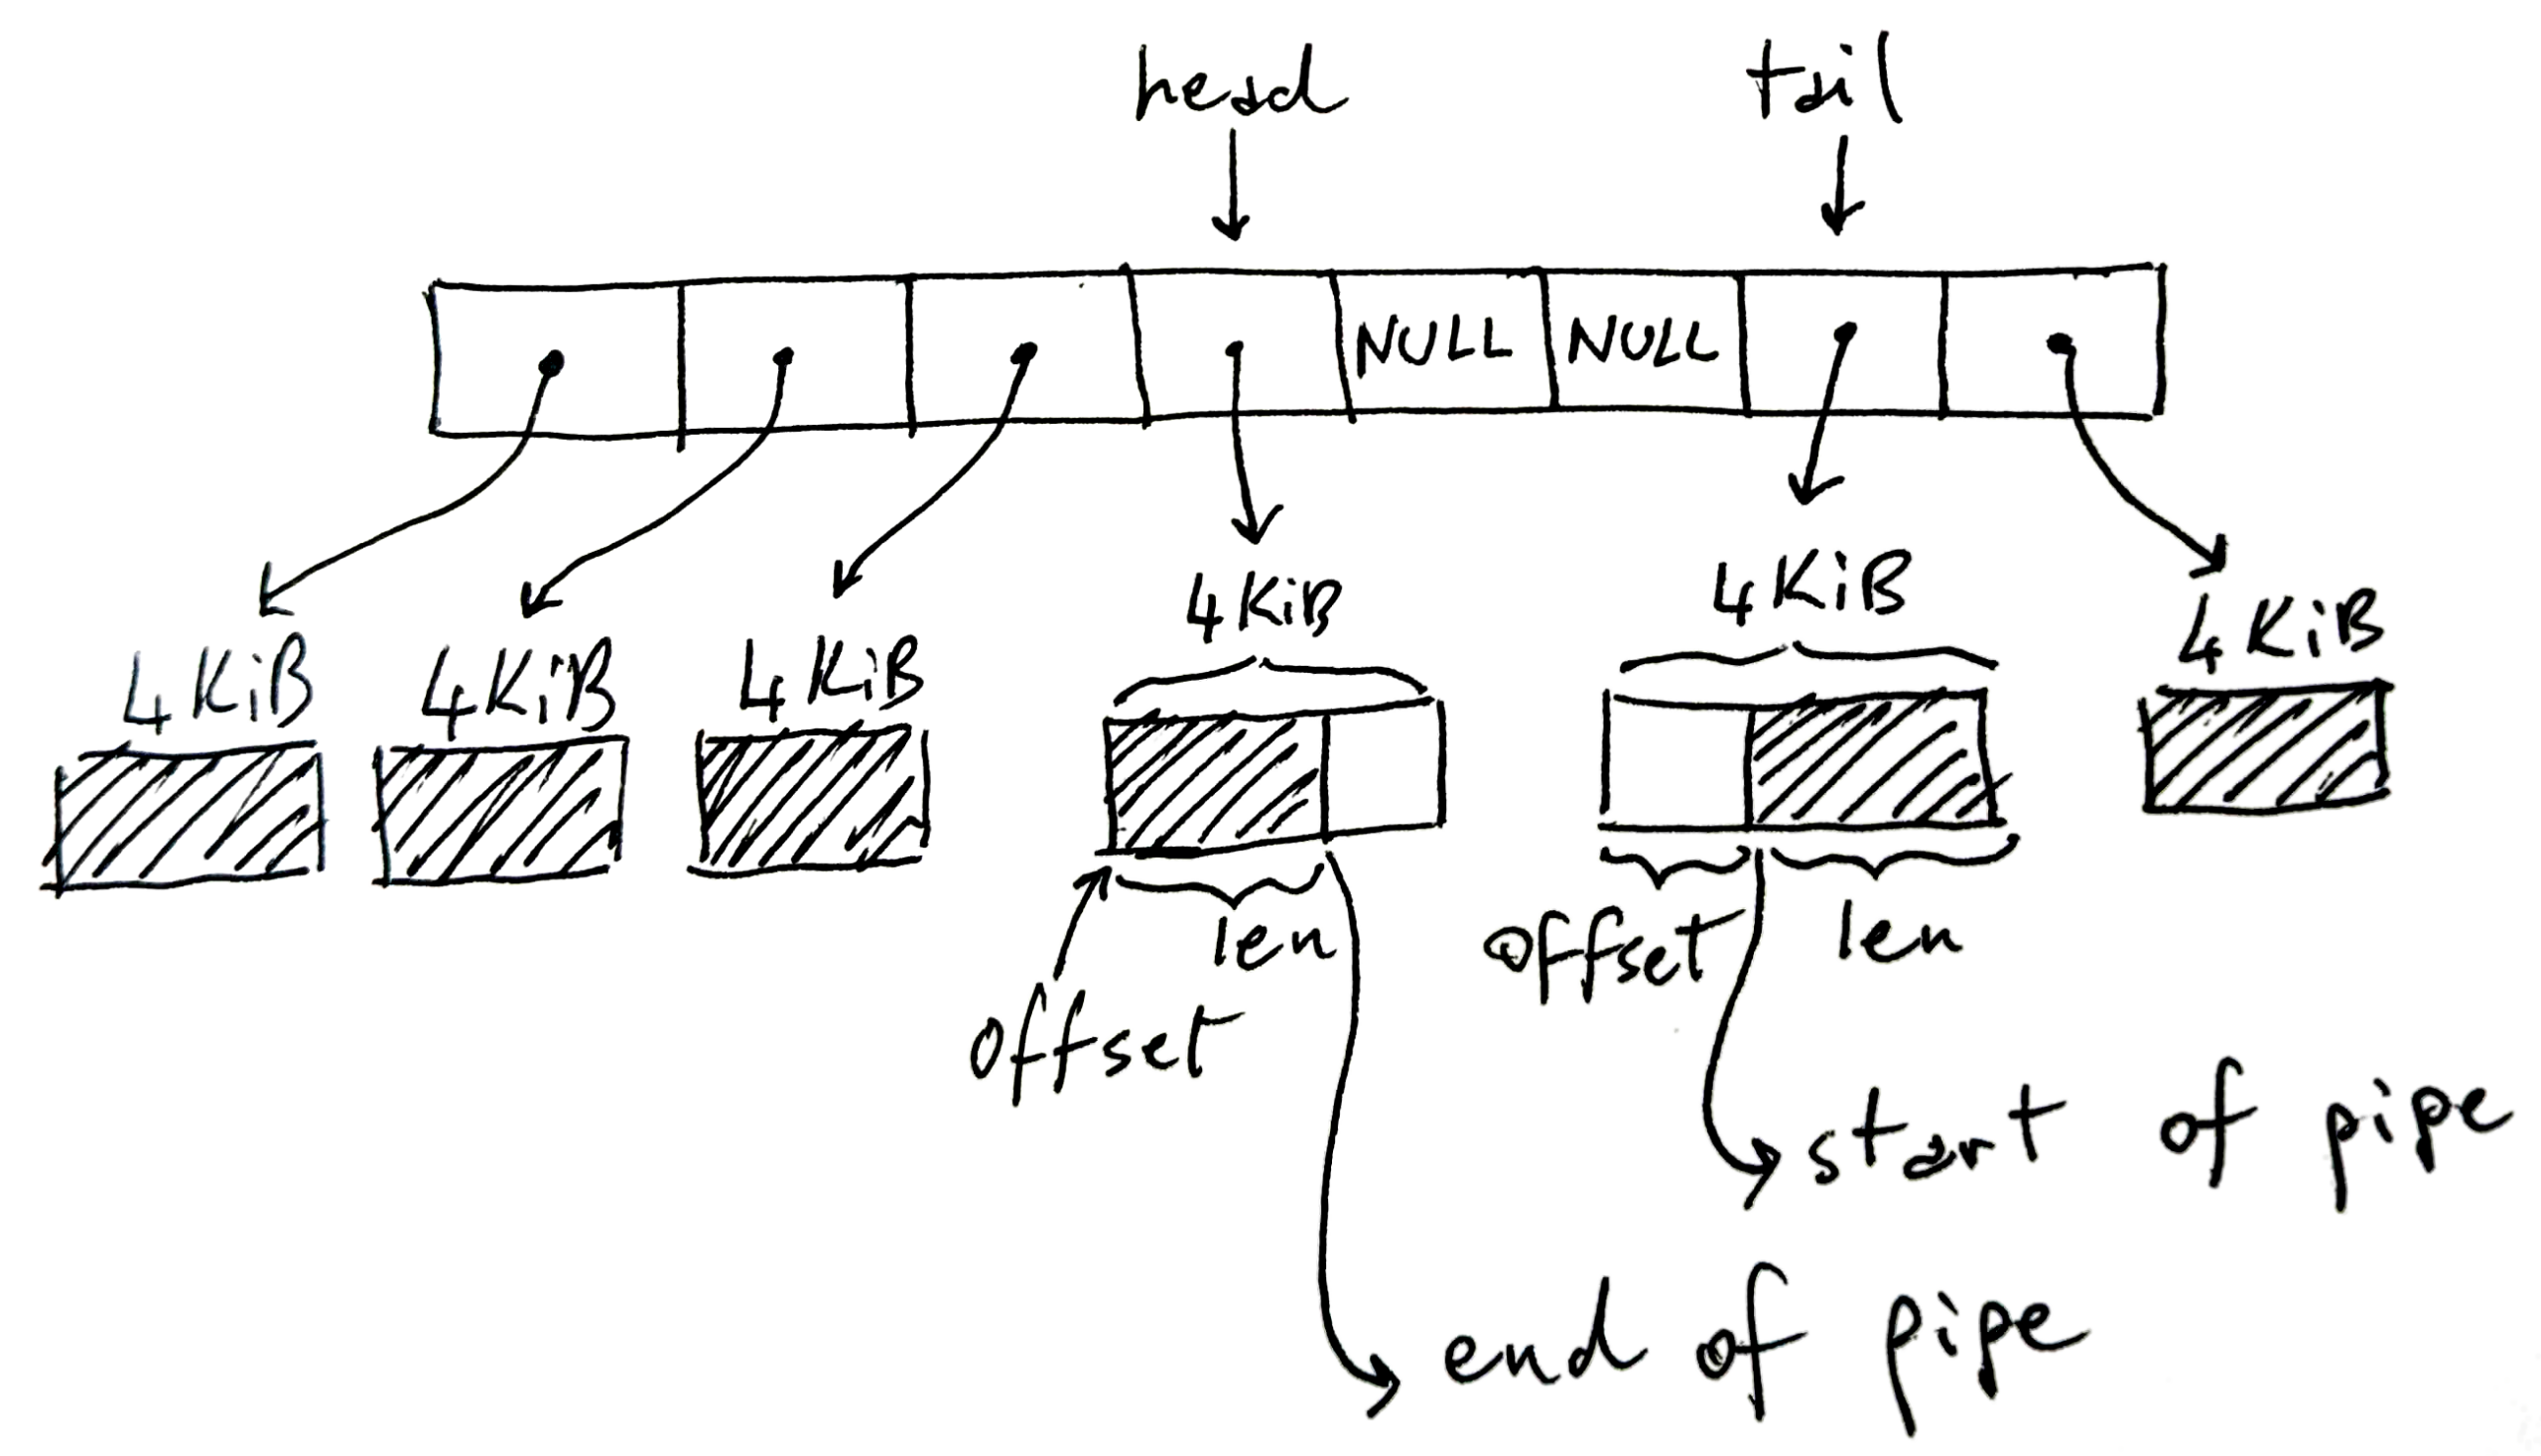
Na poziomie wdrożenia wsparcie dla potoków znajduje się w jądro Linuksanie w powłoce. Interpreter poleceń (bash, zsh itp.) po prostu tworzy potok za pomocą wywołań systemowych, takich jak pipe() y fork()Przekieruj deskryptory plików, a następnie uruchom każdy program. Prawdziwą magią blokowania procesów, zarządzania buforem i propagacji danych między producentem a konsumentem zajmuje się jądro systemu.
Zrozumienie stdin, stdout i przepływu danych
Aby efektywnie pracować z potokami, kluczowe jest zrozumienie, czym są stdin, stdout i stderr . Nie są to abstrakcyjne koncepcje: każdy proces w systemie Linux rozpoczyna się od trzech otwartych deskryptorów plików, które wskazują na określone zasoby zarządzane przez jądro.
stdin (deskryptor 0) i stdout (deskryptor 1) można postrzegać jako strumienie bajtów połączone z czymś: może to być terminal, plik, gniazdo sieciowe lub potok. Nie są to po prostu bufory; są to odwołania do obiektów jądra ( struktur typu pliku ), które z kolei są powiązane z inodami, gniazdami lub wewnętrznymi strukturami potoku.
Każdy proces ma swoje własne deskryptory, dzięki czemu każde polecenie w potoku Niezależnie widzi swoje wejście standardowe i wyjście standardowe. W linii takiej jak ls | grep txt | wc -l, ls pisać w rurze, grep Odczytuje z jednej rury i zapisuje do drugiej, i wc Odczytaj od ostatniego. Dla użytkownika wygląda to jak pojedynczy ciąg, ale wewnętrznie jest to wiele połączonych buforów jądraprzy czym każdy proces jest blokowany i wznawiany w zależności od ilości dostępnego miejsca lub danych.
Gdy pierwszy proces generuje dane szybciej, niż drugi je konsumuje, bufor potoku się zapełnia. W tym momencie kolejne zapisy wracają, blokując proces wysyłający do czasu, aż proces konsumujący... przeczytaj wystarczająco dużo informacji i zwalnia miejsce. Zapobiega to niekontrolowanemu gromadzeniu się pamięci; dane nie gromadzą się w nieskończoność, chyba że użyjesz nieblokującego wejścia/wyjścia lub sygnałów specjalnych. Na przykład w przypadku takim jak dd if=/dev/sda | gzip -9i gzip kompresuje się wolniej, dd jest zmuszony czekać.
Ten mechanizm przeciwciśnienia sprawia, że potoki są dość stabilne, nawet gdy występują nierównowagi wydajności pomiędzy etapami, co znajduje odzwierciedlenie także w projektowaniu potoków CI/CD , w których wolniejsze etapy stają się wąskim gardłem, które należy mierzyć i optymalizować.
Praktyczne wykorzystanie potoków w terminalu Linux
W codziennym użyciu potoki służą do łączenia poleceń w jednym wierszu i przekształcania danych krok po kroku. Zamiast uruchamiać polecenie, przeglądać dane wyjściowe, kopiować je i wklejać do innego polecenia, można budować małe, wysoce elastyczne „fabryki danych” w postaci zwykłego tekstu.
Typowym przykładem w środowiskach Unix jest łączenie poleceń fortune, który pokazuje losowe cytaty, z cowsayktóry drukuje „mówiącą” krowę. Używając fajki, Odejście Fortune staje się przesłaniem CowsayaWszystko w jednym poleceniu. To zabawny przykład, ale doskonale ilustruje ideę łączenia prostych narzędzi do bardziej złożonych zadań.
Inną klasyką jest wysłanie wyniku ls a wc liczyć wiersze, słowa i znaki. Coś takiego ls | wc Pozwala szybko sprawdzić, ile przedmiotów jest na liście. Piękno polega na tym, że nie potrzebujesz jednego programu do wszystkiego, ale raczej... Tworzysz rozwiązania przy użyciu małych, dobrze zaprojektowanych narzędzi..
Bardzo często stosuje się również łączenie łańcuchowe cat, sort y more (lub innego pagera), aby posortować plik tekstowy i przeglądać go strona po stronie. Dzięki potokowi treść jest przesyłana z jednego polecenia do drugiego bez zapisywania jej w jawnych plikach tymczasowych, co znacznie upraszcza pisanie skryptów i zadania administracyjne.
W praktycznych przypadkach, takich jak przetwarzanie list uczniów i ocen w oddzielnych plikach, można użyć paste aby połączyć kolumny, cut aby wybrać tylko interesujące Cię pola i zastosować potoki filtrowania, sortowania lub transformacji wszystkiego w jednym wierszu skryptu powłoki. Ten wzór rozbić duży problem na proste polecenia połączone z rurami To jest esencja filozofii Uniksa.
Zaawansowane polecenia pozwalające w pełni wykorzystać potencjał rur: tee, xargs i cpio
Kiedy zaczynasz naprawdę automatyzować rzeczy w Linuksie, potoki stają się jeszcze potężniejsze dzięki kilku kluczowym narzędziom. Wśród nich są: tee, xargs y cpioktóre bardzo dobrze uzupełniają standardowy przepływ danych.
Polecenie tee Działa jak „T” w rurze wodociągowej: odczytuje dane ze standardowego wejścia, zapisuje je na standardowe wyjście, a następnie kopiuje te same dane wyjściowe do jednego lub kilku plików. Jest idealny, gdy chcesz przeglądaj wynik na ekranie i jednocześnie go zapisz aby przejrzeć go później lub przetworzyć na innym etapie. Z opcją -a Dodaje dane na końcu pliku zamiast je nadpisywać.
Na przykład możesz sortować listę za pomocą sortwyślij wynik do tee aby zapisać go w dzienniku i jednocześnie przekazać dalej more aby podzielić go na strony. W ten sposób, w jednym procesie, masz możliwość sortowania, zapisywania na dysku i wygodnego przeglądania bez konieczności powtarzania procesu sortowania.
Polecenie xargs To kolejny fundamentalny element w kontekście potoków. Jego funkcją jest pobieranie danych przychodzących przez stdin (zazwyczaj listy elementów) i konwertowanie ich na argumenty dla innego polecenia. Jest to szczególnie przydatne, gdy program ulega awarii z powodu otrzymania zbyt wielu parametrów naraz lub gdy chcesz… podzielić pracę na partie z opcją -n, który ogranicza liczbę argumentów przekazywanych podczas jednego wykonania.
Na przykład za pomocą ls | xargs -n 4 Dzielisz listę plików na grupy po cztery, wykonując polecenie docelowe (domyślnie echo(lub ten, który określisz) kilka razy. W ten sposób możesz budować potoki takie jak „podgląd tego, co usunę”, łącząc ls, xargs y echo rm przed rozpoczęciem faktycznego czyszczenia.
Zachowaj ostrożność przy złożonych danych wejściowych: ścieżki ze spacjami lub znakami specjalnymi może naruszyć domyślne zachowanie xargsW takich przypadkach stosuje się go zazwyczaj w połączeniu z find i opcja -print0, który oddziela elementy znakiem null, wraz z xargs -0 tak aby oba końce używały tego samego, solidnego ogranicznika.
Wreszcie, cpio Jest to polecenie mniej znane niż tarAle jest niezwykle elastyczny w pracy ze strumieniami plików przesyłanymi przez potoki. W przeciwieństwie do tar, został zaprojektowany od podstaw do pracy z… przekierowania i potoki: otrzymuje listę plików przez stdin (zwykle generowaną za pomocą find) i produkuje lub zużywa pliki typu „pakiet” bez własnej kompresji, które następnie można skompresować gzip lub podobne.
Główne tryby cpio zezwól na tworzenie plików (-o), skopiuj drzewa katalogów (-p) lub wyodrębnij zawartość (-i(często określane jako „kopiowanie”). Opcje takie jak -u nadpisać, -m aby zachować znaczniki czasu lub -d odtworzenie struktury katalogów umożliwia aby szczegółowo kontrolować, co jest kopiowane i w jaki sposób, szczególnie przydatne w złożonych skryptach, gdzie tar nie spełnia oczekiwań.
Projektowanie i optymalizacja potoków CI/CD na serwerach Linux
Poza tradycyjną linią poleceń, koncepcja potoku stała się fundamentalna w świecie ciągłej integracji i ciągłego dostarczania (CI/CD) . Na serwerze Linux potok CI/CD to zautomatyzowana sekwencja kroków: pobieranie kodu, instalowanie zależności, kompilacja, uruchamianie testów, pakowanie artefaktów i wdrażanie.
Linux jest do tego szczególnie odpowiedni, ponieważ wyróżnia się szybkością, stabilnością i ekosystemem narzędzi automatyzacji . Platformy takie jak Jenkins, GitHub Actions i GitLab CI opierają się na executorach Linuksa (maszynach fizycznych, maszynach wirtualnych lub kontenerach) do spójnego uruchamiania potoków.
Optymalizacja tych potoków oznacza nie tylko ich „działanie”, ale także zapewnienie im jak najmniejszego tarcia. Oznacza to skrócenie czasu pobierania, minimalizację powtarzających się instalacji zależności, optymalizację obrazów Dockera w celu uniknięcia niepotrzebnych przebudów, ponowne wykorzystanie już wygenerowanych artefaktów oraz zapewnienie bezpieczeństwa i widoczności środowiska.
Podstawową dobrą praktyką jest struktura potoku w dobrze zdefiniowane etapy: kompilacja, testowanie i wdrożenie . W idealnym przypadku należy skompilować tylko raz, wygenerować artefakt (plik binarny, pakiet, obraz Dockera), który jest testowany równolegle w różnych wariantach (na przykład w różnych wersjach językowych), a następnie wdrożyć ten sam artefakt w środowiskach testowych i produkcyjnych bez konieczności ponownej kompilacji.
Praca z niezmiennymi artefaktami przechowywanymi w repozytoriach (S3, Nexus, Artifactory, rejestrach kontenerów lub pakietach osadzonych w GitLab/GitHub) upraszcza audyt, umożliwia szybkie wycofywanie wersji i zmniejsza prawdopodobieństwo wystąpienia sytuacji „działa na moim komputerze, ale nie w środowisku produkcyjnym”.
Wymagania wstępne: dystrybucja, użytkownik CI i wzmocnienie serwera
Zanim zagłębisz się w optymalizację milisekundową, ważne jest, aby zbudować stabilny fundament na serwerze Linux , który będzie pełnił rolę wykonawcy CI/CD. Zaczyna się to od wyboru dystrybucji i minimalnej konfiguracji zabezpieczeń.
Najrozsądniejszym podejściem jest zazwyczaj standaryzacja dystrybucji LTS lub stabilnej , z którą zespół jest zaznajomiony: Ubuntu LTS, Debian Stable lub alternatywy dla przedsiębiorstw, takie jak AlmaLinux czy Rocky Linux. Umieszczenie wszystkich programów uruchamiających na tej samej wersji zapobiega nieoczekiwanemu zachowaniu spowodowanemu przez różne biblioteki lub jądra między zadaniami.
Innym zaleceniem jest skonfigurowanie dedykowany użytkownik dla CI, bez uprawnień roota, z sudo bardzo ograniczonym tylko do podstawowych poleceń (na przykład, systemctl o docker (jeśli to naprawdę konieczne). Ten użytkownik musi uwierzytelnić się za pomocą kluczy SSH, zarówno w celu uzyskania dostępu do serwera, jak i interakcji z repozytoriami Git lub innymi zdalnymi maszynami.
Na poziomie systemu wskazane jest utrzymanie serwera zaktualizowane i minimalnie wzmocnioneObejmuje to stosowanie aktualizacji zabezpieczeń, konfigurowanie restrykcyjnej zapory sieciowej (na przykład z UFW: odrzucającą cały ruch przychodzący z wyjątkiem niezbędnego i zezwalającą na ruch wychodzący) oraz włączanie narzędzi takich jak fail2ban aby zatrzymać ataki siłowe na SSH i dostosować niektóre parametry sieciowe i jądra za pomocą sysctl w celu zwiększenia niezawodności i wydajności.
Na przykład, często podnosi się limit powiadomić aby zapobiec wyczerpaniu zasobów w systemach kompilacji monitorujących wiele plików i dostosować parametr vm.swappiness aby jądro było bardziej konserwatywne podczas korzystania z wymiany, co jest szczególnie istotne, gdy zadania CI zużywają dużą ilość pamięci na raz.
Pamięć podręczna, Docker i paralelizacja: czynniki wpływające na wydajność w CI/CD
Jeśli przyjrzysz się, ile czasu faktycznie pochłania przeciętny potok, zobaczysz, że ogromna jego część jest tracona na instalowanie zależności i przebudowywanie obrazów Dockera . Rozwiązanie tego problemu jest zazwyczaj skuteczniejsze niż optymalizacja kodu testowego o kilka milisekund.
Pierwszą dźwignią jest buforowanie zależności . Prawie wszystkie menedżery zależności (pip, npm, Maven, Gradle, moduły Go itp.) korzystają z lokalnych katalogów pamięci podręcznej. Na serwerze Linux z trwałym systemem operacyjnym można udostępniać te katalogi między zadaniami lub montować je na trwałym woluminie. W ten sposób każde uruchomienie nie musi ponownie pobierać połowy danych z internetu.
W przypadku Dockera włącz Zestaw do budowania i dobrze ustrukturyzować Dockerfile To punkt zwrotny. Umieszczenie instalacji zależności zaraz po skopiowaniu pliku wymagań, a przed resztą kodu, gwarantuje, że warstwy będą ponownie wykorzystywane, o ile wersje tych zależności pozostaną niezmienione. Co więcej, określone pamięci podręczne dla pip, npm itp. można skonfigurować w samym procesie kompilacji.
Drugą ważną dźwignią jest równoległe wykonywanie testówWiele frameworków natywnie obsługuje współbieżność: pytest z -n autoNarzędzia Java, takie jak Surefire, Jest w JavaScript z --maxWorkersitd. Podzielenie pakietu według modułów, folderów, a nawet według szacowanego czasu i rozłożenie go na kilku pracowników pozwala na skrócenie fazy testowania od 2 do 5 razy bez zmiany żadnej linii biznesowej.
Na koniec pozostaje kwestia artefaktów i wdrożenia . Zamiast rekompilować ten sam obraz na potrzeby środowiska testowego, preprodukcyjnego i produkcyjnego, efektywnym podejściem jest jednokrotne zbudowanie, zapisanie wyniku w repozytorium i otagowanie go zgodnie ze środowiskiem wdrożenia. Zmniejsza to obciążenie procesora, zapobiega niespójnościom i znacznie przyspiesza długie potoki.
Optymalizacja Jenkinsa, GitHub Actions i GitLab Runner w systemie Linux
Każdy system CI ma swoją specyfikę, ale wszystkie korzystają z tych samych podstawowych założeń, gdy działają w systemie Linux. Kluczem jest zazwyczaj używanie efemerycznych i przejrzystych programów wykonywalnych , utrzymywanie odpowiedniej wielkości trwałej pamięci podręcznej oraz kontrola współbieżności.
W Jenkinsie powszechną praktyką jest używanie lekkich, tymczasowych agentów (takich jak kontenery Docker lub pody w Kubernetes lub innych rozwiązaniach do orkiestracji kontenerów ) do uruchamiania zadań, przy jednoczesnym zachowaniu jak największej prostoty węzła głównego. Agentów tych można skonfigurować jako usługi systemd na serwerach Linux, rejestrując się w kontrolerze i uruchamiając automatycznie po uruchomieniu komputera.
W przypadku akcji GitHub z samodzielnie hostowanymi menedżerami zaleca się ich wdrożenie w Maszyny wirtualne Linux z szybkimi dyskami SSDAby utworzyć duży katalog pamięci podręcznej dedykowany akcjom (zależności językowe, buforowanie kompilacji itp.), ogranicz liczbę równoczesnych zadań, aby uniknąć przeciążenia procesora i dysku. Skorzystaj z oficjalnego działania buforowania, używając ścieżek takich jak: ~/.cache/pip, ~/.npm o ~/.m2 To robi ogromną różnicę w czasie.
W GitLab Runner wybór między programem shell executor a Dockerem zależy od pożądanej równowagi między wydajnością a izolacją. Program shell executor jest szybszy, ponieważ działa bezpośrednio na hoście, ale program Docker executor oferuje czyste i replikowalne środowiska. Można również skonfigurować współdzielone buforowanie (lokalne lub w S3) i dostosować maksymalną liczbę równoczesnych zadań, aby wykorzystać możliwości sprzętu bez jego przeciążania.
We wszystkich tych przypadkach kluczowe jest posiadanie współdzielonych woluminów do buforowania zależności, przy jednoczesnym zapobieganiu zaśmiecaniu obszarów roboczych między kompilacjami. Ulotne maszyny lub kontenery, tworzone i niszczone z każdym potokiem lub grupą potoków, znacznie redukują problemy typu „wczoraj działało, ale dziś nie działa” spowodowane pozostałościami po poprzednich kompilacjach.
Wydajność serwera Linux: procesor, pamięć, wejście/wyjście i Docker
Niezależnie od tego, jak zoptymalizowane są Twoje skrypty, jeśli serwer Linux obsługujący potok nie ma odpowiedniego rozmiaru, napotkasz niekończące się kolejki i wolno działające zadania. Typowa, rozsądna konfiguracja dla maszyny średniej klasy to 4-8 wirtualnych procesorów (vCPU) i 8-16 GB pamięci RAM , z dyskiem SSD (najlepiej NVMe) i odrobiną przestrzeni wymiany (2-4 GB), aby obsłużyć szczytowe obciążenia bez agresywnego zamykania procesów.
System plików również ma znaczenie. Użyj ext4 lub XFS z opcją noatime W woluminach, w których kompilujesz lub zapisujesz logi, zredukuj zbędne operacje wejścia/wyjścia. Dodatkowo, montując tmpfs w przypadku plików tymczasowych lub krótkotrwałych artefaktów (na przykład /mnt/ci-tmp) przyspiesza intensywne operacje i zapobiega zapełnianiu dysku resztkowymi plikami pomiędzy zadaniami.
W przypadku Dockera kluczowa jest higiena demonów. Bezpieczne i regularne usuwanie nieużywanych obrazów i woluminów, przy jednoczesnym utrzymywaniu obrazów bazowych w trybie „hot base”, pomaga kontrolować przestrzeń dyskową i czas rozruchu. Polecenia takie jak docker system prune Przy zastosowaniu odpowiednich filtrów czasowych umożliwiają one sprzątanie bez przeciążania ostatnio wykorzystywanych zasobów.
Jeśli Twoja CI intensywnie korzysta z kontenerów, możesz również użyć rejestrów lustrzanych , aby uniknąć ciągłego pobierania danych z internetu, użyć BuildKit do zapewnienia współbieżności i buforowania warstwowego, a nawet skonfigurować powinowactwa procesorów (zestawy procesorów) lub dedykowane węzły dla najbardziej wymagających wykonawców, zapobiegając interferencjom między sąsiednimi obciążeniami. Co więcej, zrozumienie mikroarchitektury procesorów pomoże Ci lepiej dobrać zasoby do intensywnych obciążeń CI.
Bezpieczeństwo w procesie (DevSecOps) i wdrożenia w systemie Linux
Szybki, ale niezabezpieczony potok to tykająca bomba zegarowa. Integracja zabezpieczeń z samym potokiem i zabezpieczeniami kontenerów Docker jest obecnie standardem w każdej strategii DevSecOps, a Linux oferuje wiele narzędzi do tego celu.
Pierwszą rzeczą, którą należy zrobić, to obchodzić się z sekretami i danymi uwierzytelniającymi z najwyższą ostrożnością . Nigdy nie powinny one znajdować się w kodzie ani w wersjonowanych plikach konfiguracyjnych. Zamiast tego są przechowywane w menedżerach sekretów (zamaskowane zmienne GitLab, zaszyfrowane sekrety GitHub, HashiCorp Vault itp.) i wstrzykiwane tylko podczas wykonywania zadania, które ich potrzebuje, używając, gdy tylko jest to możliwe, tokenów o krótkim czasie życia.
Kolejną ważną warstwą jest generowanie zestawień materiałowych oprogramowania (SBOM) i podpisywanie artefaktów. Narzędzia takie jak Syft czy CycloneDX umożliwiają wylistowanie wszystkich komponentów składających się na obraz lub plik binarny, podczas gdy Cosign lub inne weryfikowalne rozwiązania do podpisywania zapewniają, że wdrażane są tylko te artefakty, które przeszły przez proces i zostały zweryfikowane.
Z punktu widzenia sieci i dostępu, wskazane jest segmentowanie sieci CI i produkcyjnych , wdrożenie ścisłych zapór sieciowych, audytowanie dzienników wykonania oraz regularna rotacja danych uwierzytelniających. W przypadku korzystania z protokołu SSH lepiej jest używać certyfikatów lub kluczy z datą ważności niż statycznych haseł.
Podczas wdrażania w systemie Linux strategie takie jak Blue/Green, rolling i canary znacznie zmniejszają wpływ błędów wdrożenia. Uruchomienie aplikacji jako usługi systemd, umieszczenie przed nią serwera Nginx lub HAProxy oraz kontrolowanie ruchu między wersjami za pomocą kontroli stanu pozwala na osiągnięcie praktycznie zerowego przestoju podczas aktualizacji.
Na przykład podczas ponownego ładowania Nginx i ponownego uruchamiania usług za pomocą systemd przy użyciu sygnałów miękkiego zatrzymania (takich jak SIGTERMPrzy zachowaniu rozsądnego czasu oczekiwania możesz rozładować aktywne połączenia przed zatrzymaniem procesu, zachowując przy tym komfort użytkowania podczas przełączania wersji w tle.
Obserwowalność, metryki i koszty w potokach Linux
Gdy Twoje potoki są już uruchomione, kolejnym krokiem jest ich pomiar i zrozumienie, na co przeznaczany jest czas i zasoby . Nie wystarczy wiedzieć, czy przepływ pracy kończy się sukcesem, czy porażką; musisz monitorować czas trwania każdego etapu, czas oczekiwania w kolejce, wskaźnik sukcesu, częstotliwość wdrożeń, wskaźnik trafień w pamięci podręcznej itd.
Eksport metryk systemowych jest powszechny, ponieważ node_exporterCentralizuj logi za pomocą rozwiązań takich jak ELK lub Loki i wizualizuj wszystko na pulpitach Grafana. W ten sposób możesz na przykład wykryć, czy faza testowania wydłużyła się o 30% w ciągu ostatniego tygodnia lub czy zadania spędzają zbyt dużo czasu w oczekiwaniu na dostępnego wykonawcę; monitorowanie ruchu sieciowego Widoczność tę uzupełniają narzędzia typu open source.
Możliwe jest również instrumentowanie samego potoku, na przykład w GitHub Actions lub GitLab CI, aby programowo mierzyć, ile wykonań zakończyło się sukcesem, jak długo trwało każde uruchomienie i jaki jest ogólny stanSkrypt, który wywołuje API dostawcy, oblicza całkowitą liczbę przebiegów, liczbę przebiegów pomyślnych, liczbę przebiegów nieudanych, współczynnik powodzenia i średni czas trwania oraz zapisuje wszystko w pliku JSON (takim jak pipeline-metrics.json) umożliwia integrację tych metryk z raportami lub pulpitami nawigacyjnymi.
Dzięki tym informacjom można podejmować decyzje dotyczące rozmiaru i liczby serwerów : czasami lepiej mieć więcej małych serwerów niż kilka bardzo dużych, aby skrócić czas oczekiwania. Autoskalowalność – na przykład automatyczne skalowanie w chmurze lub dynamiczne pule węzłów Kubernetes – pomaga absorbować szczytową aktywność w ciągu dnia i minimalizować niewykorzystane zasoby w nocy.
Praktyki te nie tylko poprawiają pracę zespołu, ale także pomagają regulować koszty infrastruktury poprzez kontrolę zużycia procesora, pamięci i przede wszystkim pamięci masowej, które ma tendencję do gwałtownego wzrostu ilości obrazów i pamięci podręcznej, jeśli nie jest regularnie i planowo czyszczone.
Znajomość zarówno klasycznych potoków wiersza poleceń, jak i nowoczesnych potoków CI/CD w systemie Linux oferuje potężne połączenie: można zautomatyzować wszystko, od prostych zadań filtrowania tekstu po złożone, łatwe w utrzymaniu, bezpieczne i szybkie potoki kompilacji, testowania i wdrażania. Zrozumienie przepływu informacji między procesami, buforowania zależności, dostrajania serwerów oraz integracji metryk i zabezpieczeń pozwala budować przepływy pracy, które skalują się wraz z zespołem i projektami, nie stając się ciągłym wąskim gardłem.
