- O monitoramento do tráfego de rede em tempo real permite antecipar falhas, melhorar o desempenho e fortalecer a segurança da infraestrutura de TI.
- Ferramentas de código aberto como Nagios, Zabbix, Prometheus, Cacti, OpenNMS, Icinga, Netdata, LibreNMS ou Observium oferecem recursos avançados sem custos de licença.
- A combinação de coletores de métricas, bancos de dados de séries temporais e camadas de visualização como Grafana e Graphite cria soluções altamente flexíveis e escaláveis.
- Definir requisitos, aplicar as melhores práticas e realizar uma prova de conceito são fundamentais para escolher e implementar a plataforma de monitoramento mais adequada.
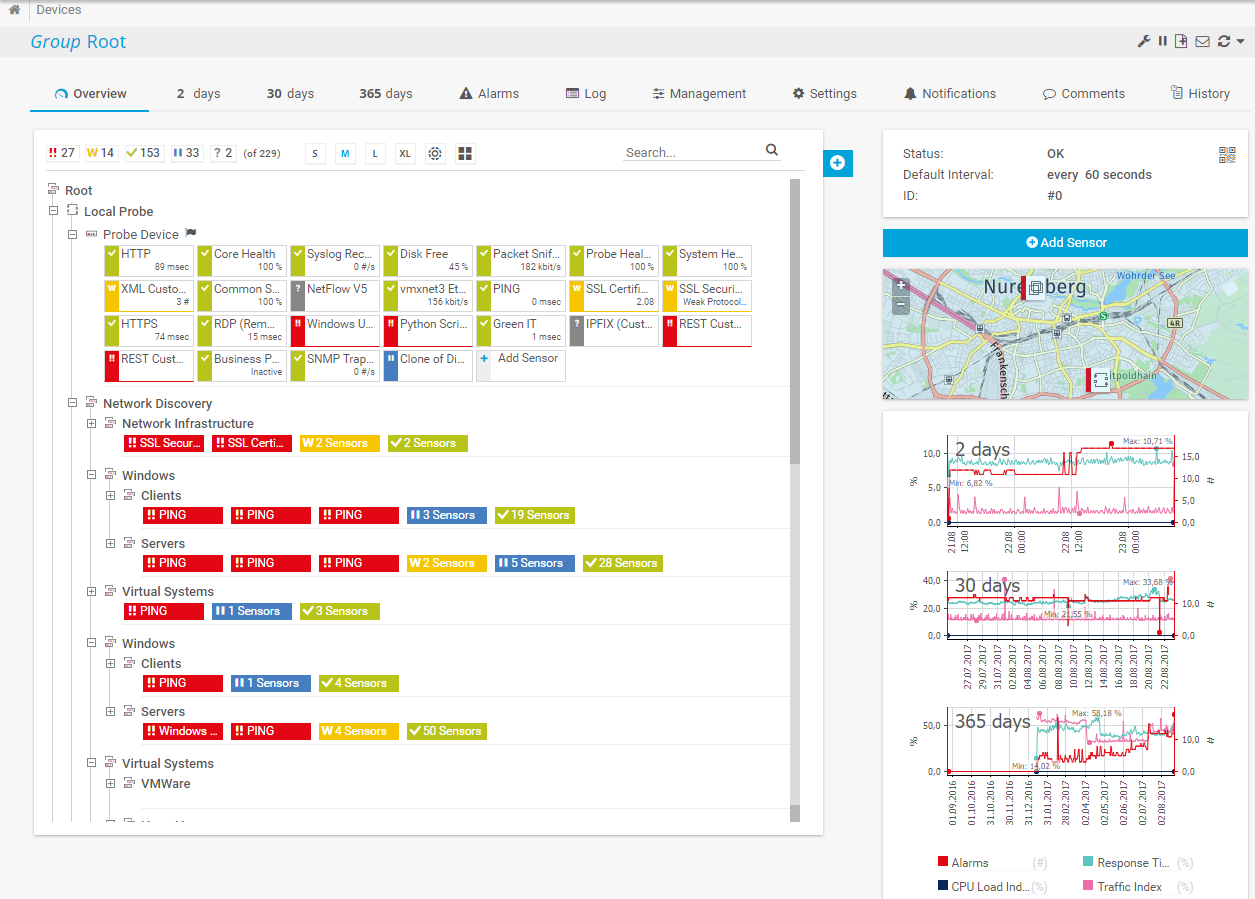
Quando a rede de uma empresa começa a ficar lenta, a conexão Wi-Fi cai ou um servidor crítico trava no pior momento possível, simplesmente "reiniciar o roteador e torcer para que tudo dê certo" não é mais suficiente. Hoje, é crucial contar com ferramentas de monitoramento de tráfego de rede de código aberto que permitam visualizar o que está acontecendo em tempo real, antecipar problemas e evitar interrupções dispendiosas.
Se você trabalha na área de TI, redes ou já foi o líder técnico da sua empresa, provavelmente já ouviu falar de soluções como PRTG ou SolarWinds… e suas licenças. A boa notícia é que existe um ecossistema muito maduro de plataformas de código aberto para monitoramento de dispositivos, serviços e tráfego de rede (roteadores, switches, pontos de acesso Wi-Fi, servidores, contêineres, nuvens públicas e muito mais) sem taxas exorbitantes e com incrível flexibilidade.
O que é monitoramento de tráfego de rede em tempo real e por que é tão importante?
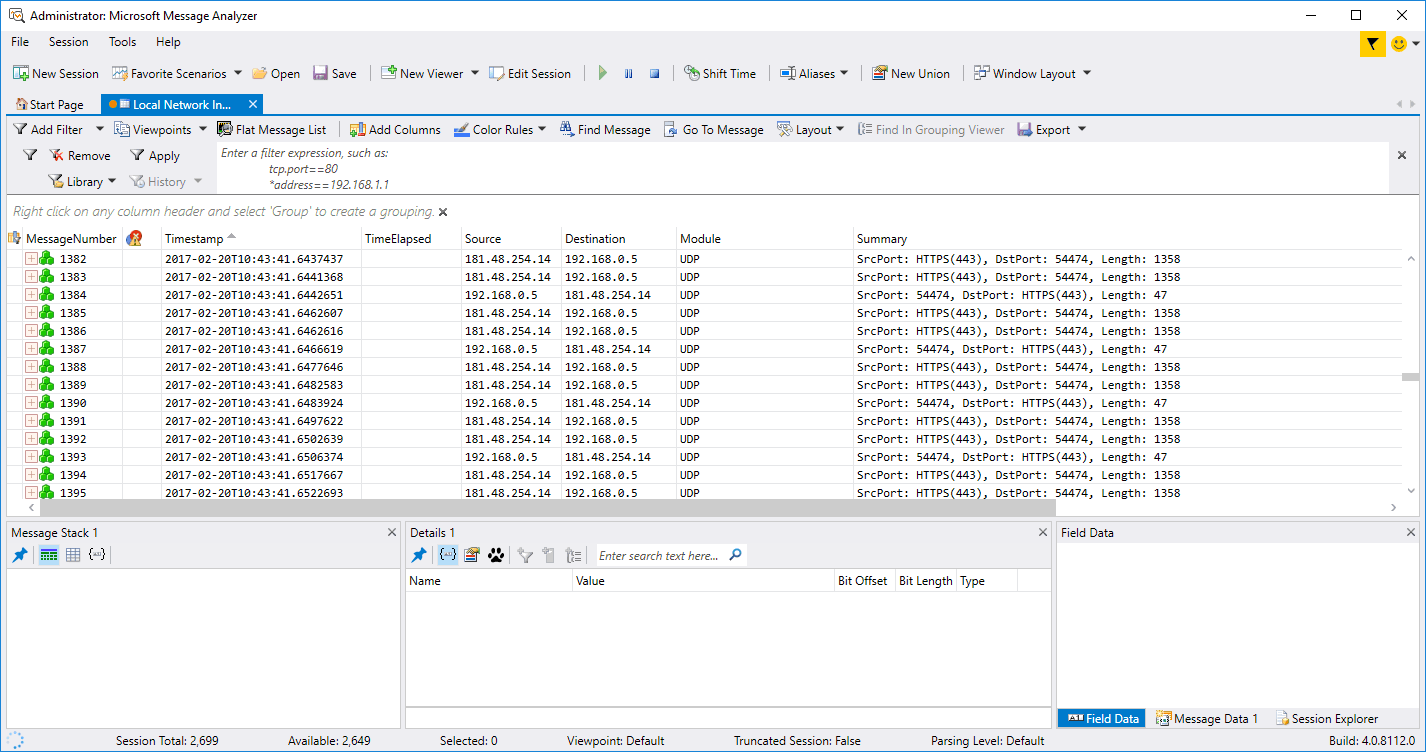
Quando falamos de monitoramento de rede em tempo real, estamos nos referindo à supervisão contínua do status, desempenho e segurança da infraestrutura de TI e comunicações , detectando incidentes no momento em que ocorrem. O software coleta e analisa constantemente métricas de dispositivos, sistemas e aplicativos para que a equipe de TI possa reagir antes que o problema impacte os negócios.
Esses tipos de soluções dependem de protocolos como SNMP, NetFlow/sFlow, ICMP , APIs e agentes específicos para coletar dados de roteadores, switches, firewalls, pontos de acesso, servidores físicos e virtuais, contêineres, serviços em nuvem, aplicativos da web, bancos de dados e praticamente qualquer elemento que faça parte da infraestrutura.
O principal objetivo é ter visibilidade completa do tráfego, uso de largura de banda, disponibilidade e integridade de cada componente . Isso permite a detecção de gargalos , ataques, falhas de hardware ou sobrecargas de serviço antes que resultem em interrupções, lentidão generalizada ou perda de dados.
Além de dados em tempo real, muitas ferramentas permitem armazenar métricas históricas para análise de tendências , planejamento de capacidade, verificação de conformidade com SLA/OLA, auditoria de segurança e suporte para decisões de investimento em novos equipamentos ou links.
Principais usos e benefícios do monitoramento em tempo real
Um dos maiores benefícios é a manutenção preventiva da infraestrutura de TI e de rede . Ter métricas contínuas sobre CPU, memória, temperatura, status da fonte de alimentação, erros de interface e perda de pacotes ajuda a detectar sinais precoces de falha antes que ocorra uma pane grave ou interrupção do serviço.
A resposta rápida a incidentes é outro pilar fundamental. As plataformas de monitoramento geram alertas personalizáveis (e-mail, SMS, Slack, Teams, webhooks, etc.) quando um valor ultrapassa um limite, um serviço deixa de responder ou um padrão de tráfego suspeito é detectado. Isso reduz drasticamente o tempo de inatividade e o impacto de incidentes de segurança ou interrupções de desempenho.
No dia a dia, o monitoramento contribui para otimizar o desempenho geral de redes, servidores e aplicações. Ser capaz de visualizar quais links estão congestionados, quais serviços estão consumindo mais recursos ou quais fusos horários estão causando picos de carga ajuda a ajustar configurações, balancear cargas, redefinir políticas de QoS e, em geral, obter melhor desempenho da tecnologia instalada.
Outro aspecto cada vez mais importante é a conformidade regulamentar. Um bom sistema de monitoramento facilita o controle de acesso, o rastreamento de dados sensíveis e a detecção de acessos não autorizados , fornecendo registros e métricas úteis para auditorias e para demonstrar a conformidade com os requisitos regulamentares ou contratuais.
Por fim, do ponto de vista empresarial, essas soluções se tornam ferramentas de apoio à decisão : relatórios periódicos, painéis executivos, análise histórica de incidentes e disponibilidade, comparações entre sites ou provedores de nuvem... tudo isso ajuda a justificar investimentos, negociar com terceiros e priorizar projetos de TI.
Vantagens específicas do software de monitoramento de código aberto
A primeira vantagem óbvia das ferramentas de código aberto é a sua relação custo-benefício: não existem licenças fechadas nem custos agressivos por dispositivo, como acontece em muitas plataformas comerciais. Isso não significa que tudo seja gratuito (sempre existem custos de infraestrutura, suporte e treinamento), mas a economia com licenças libera espaço para investir em outras áreas críticas.
O segundo ponto forte principal é o apoio e a inovação da comunidade . Projetos como Nagios, Zabbix, Prometheus, LibreNMS e Netdata possuem comunidades muito ativas que desenvolvem plugins, integrações, dashboards e melhorias constantes, além de corrigir bugs e solucionar vulnerabilidades rapidamente.
Destaca-se também pela transparência e confiabilidade do código : como software de código aberto, qualquer pessoa pode auditar como os dados são processados e armazenados, revisar a segurança do sistema e adaptar o código-fonte a necessidades específicas. Isso reduz o risco de backdoors ocultos e facilita o cumprimento das políticas internas de segurança.
Outro ponto fundamental é evitar a dependência de um único fornecedor. Com soluções abertas, é mais fácil migrar entre ferramentas ou combiná-las (por exemplo, usando o Prometheus para métricas de aplicativos, o Zabbix para dispositivos de rede e o Grafana como uma camada de visualização unificada), sem ficar preso ao planejamento estratégico de uma única empresa para sempre.
Obviamente, as ferramentas de código aberto geralmente exigem um certo nível de conhecimento técnico para instalação, configuração e manutenção , mas em contrapartida oferecem flexibilidade e potência que competem diretamente com muitas soluções comerciais, especialmente em ambientes onde a personalização e a integração com sistemas existentes são valorizadas.
Principais ferramentas de monitoramento de código aberto para redes e infraestrutura
Existem dezenas de projetos consolidados focados no monitoramento de redes, servidores, aplicações e ambientes em nuvem. Abaixo, apresentamos uma visão geral das ferramentas de código aberto mais relevantes para tráfego de rede e observabilidade , com base em diversas análises técnicas e comparações especializadas.
Um dos exemplos clássicos é o Nagios Core , um mecanismo de monitoramento e alertas extremamente robusto. Ele serve como base para múltiplos projetos Nagios e lida com o agendamento de verificações, processamento de resultados, gerenciamento de eventos e geração de alertas. Sua arquitetura modular permite a expansão de recursos por meio de APIs e plugins personalizados, e seu ecossistema é vasto, com integrações para praticamente qualquer tipo de dispositivo ou serviço.
Outro gigante no mundo do código aberto é o Zabbix , que se concentra fortemente no monitoramento de infraestruturas de TI de grande escala. Ele é especialmente poderoso para coletar e analisar métricas de dispositivos de rede (uso de largura de banda, status da interface, links, perda de pacotes, temperatura, CPU, memória, etc.), seja por meio de SNMP ou com seus próprios agentes. Permite que os usuários definam limites, fluxos de escalonamento de alertas, agendamentos, canais de notificação e lógica de eventos altamente granular.
No universo de aplicações nativas da nuvem e dados de séries temporais, o Prometheus se destaca . Essa solução utiliza um modelo de dados dimensional, identificado por nomes de métricas e tags de chave-valor, e aproveita a linguagem de consulta PromQL para criar gráficos, tabelas, regras de alerta e consultas complexas. Seus dados são armazenados de forma eficiente na memória e no disco local, tornando as instâncias individuais altamente autônomas, e a integração com o Grafana para visualização é perfeita.
Para quem busca uma solução leve, focada em tempos de execução muito curtos e latência mínima, o Netdata é uma opção muito interessante. Ele é instalado como um agente em cada servidor ou dispositivo Linux, coleta métricas de sistema e de aplicativos, armazena os dados no próprio nó (sem depender de bancos de dados externos no curto prazo) e oferece painéis automatizados com visualizações de desempenho altamente detalhadas, inclusive utilizando modelos de aprendizado de máquina para detectar anomalias.
Ferramentas especializadas para visualização de redes e tráfego.
Além das plataformas de uso geral, existem ferramentas de código aberto voltadas especificamente para o monitoramento do tráfego de rede e gráficos de desempenho , especialmente úteis quando o foco é visualizar largura de banda, fluxos e integridade dos links.
Uma das mais populares é o Cacti , que se concentra na criação de gráficos de rede e no gerenciamento de falhas para monitoramento operacional. Ele usa o RRDTool para armazenar dados e gerar gráficos, oferece modelos para automatizar o registro de dispositivos e suporta múltiplos métodos de aquisição de dados. Seus plugins (THold, SysLog, MacTrack, entre outros) permitem a definição de limites, integração com syslog, rastreamento de endereços MAC e monitoramento de dispositivos em tempo real.
Outra plataforma muito poderosa é o OpenNMS Horizon , considerado uma das primeiras soluções de monitoramento de serviços de rede de nível empresarial totalmente de código aberto. Ele oferece suporte ao monitoramento de redes locais e distribuídas, incluindo inventário, gerenciamento de falhas, coleta remota de dados, correlação de alarmes, monitoramento de serviços de negócios e monitoramento de tráfego. Tudo é gerenciado por meio de uma interface web intuitiva com painéis personalizáveis.
De maneira semelhante, o Icinga se posiciona como uma evolução moderna do modelo Nagios, com uma interface web refinada e um forte foco em monitoramento de rede, desempenho de interfaces, uso de largura de banda, erros, carga de CPU e memória e integridade do hardware. O Icinga suporta verificações SNMP, métricas específicas do fornecedor e recepção de traps SNMP, integrando-se ao Logstash para gerenciar eventos de múltiplos dispositivos.
Para quem precisa de uma visão muito detalhada de dispositivos de rede, interfaces e tráfego, projetos como LibreNMS e Observium são especialmente úteis. Ambos dependem fortemente de SNMP e protocolos de descoberta (CDP, LLDP, OSPF, BGP, ARP, etc.) para descobrir automaticamente a rede, gerar mapas e apresentar métricas de desempenho com gráficos claros , limites configuráveis e sistemas de alerta flexíveis.
Visualização avançada com Grafana e Graphite
Em muitas implementações complexas, a camada de coleta de métricas é separada da camada de visualização. Dois projetos importantes nessa abordagem são o Grafana e o Graphite , ambos de código aberto e amplamente utilizados em ambientes corporativos.
O Grafana é uma ferramenta multiplataforma, com suporte a plugins, projetada para criar dashboards de visualização de dados totalmente personalizados. Ele permite conectar múltiplas fontes de dados (Prometheus, Graphite, InfluxDB, MySQL, provedores de nuvem, etc.) e exibir métricas em histogramas, mapas geográficos, mapas de calor, gráficos de linhas, tabelas e muitos outros tipos de visualizações. Suporta anotações em tempo real, dashboards dinâmicos e a definição de alertas com notificações para diversos canais.
O Graphite se concentra na captura e na representação gráfica de métricas de séries temporais. Ele pode ser implementado em hardware simples ou na nuvem e é ideal para monitorar o desempenho de sites, serviços corporativos, servidores e métricas de rede . Muitas equipes optam por serviços gerenciados baseados em Graphite (como o MetricFire) que adicionam armazenamento em cluster, rotulagem de dados, integrações adicionais e alertas multicanal, enquanto ainda aproveitam o poder do Graphite e, frequentemente, do Grafana para a interface.
Em uma implementação típica, os sistemas de rede e servidores enviam métricas para o Graphite ou um coletor compatível (por exemplo, usando protocolos como o StatsD), e então painéis são criados no Grafana para fornecer uma visão unificada do estado de toda a infraestrutura: desde o tráfego em cada interface até a latência de consulta ou o uso da CPU por serviço.
Outras soluções relevantes de monitoramento de código aberto
O ecossistema de monitoramento de código aberto é muito amplo e abrange necessidades específicas, como descoberta automática, monitoramento de processos, pipelines de observabilidade ou coleta de métricas de ambientes muito heterogêneos.
Por exemplo, o Checkmk é uma plataforma altamente escalável capaz de monitorar desde pequenos ambientes até grandes empresas. Inclui gerenciamento avançado de agentes, descoberta automática de rede, visualizações interativas, sistemas de alerta robustos, relatórios de SLA, análise de logs e eventos, e APIs para ampliar sua funcionalidade. É oferecido em diferentes edições (RAW gratuita, Enterprise, Cloud e MSP), adaptando-se a diversos tamanhos e modelos de serviço.
O M/Monit concentra-se no monitoramento e na autorreparação de sistemas Unix e Linux. Ele monitora processos, uso de CPU e memória, e interfaces de rede, podendo reagir automaticamente a erros executando ações corretivas. Também permite monitorar a inicialização de serviços, verificar arquivos e diretórios em busca de alterações não autorizadas e checar conexões de rede com servidores locais ou remotos.
No âmbito da topologia de rede e análise de métricas, o Pandora FMS se destaca como uma solução completa, oferecendo monitoramento de rede, UX, nuvem, servidor e aplicativos, inventário, gerenciamento de logs e painéis personalizáveis. Ele pode detectar automaticamente interfaces de rede, criar mapas, exibir estatísticas em tempo real sobre gargalos e fornecer relatórios abrangentes.
Para arquiteturas modernas de microsserviços e multicloud, o Sensu funciona como uma espécie de pipeline de observabilidade centralizado que unifica diversas ferramentas de monitoramento. Ele oferece verificações de integridade, métricas de desempenho personalizadas, gerenciamento de logs, gerenciamento de problemas de rede e alertas multicanal com deduplicação. Além disso, suporta autorrecuperação executando reinicializações de serviços ou scripts personalizados quando detecta problemas.
Agentes, cobradores e ferramentas auxiliares
Além das grandes plataformas, existem ferramentas mais leves cuja principal função é coletar e enviar métricas de sistemas, sensores e aplicativos para bancos de dados ou sistemas de monitoramento principais.
Um excelente exemplo é o Telegraf , um agente baseado em Go sem dependências externas, capaz de operar através de um vasto sistema de plugins. Com mais de 300 plugins de entrada/saída, o Telegraf pode extrair métricas e eventos de diversas plataformas tecnológicas e enviar os dados para sistemas como InfluxDB, Graphite, OpenTSDB, Datadog, Librato e outros. Seus buffers em memória garantem que as métricas não sejam perdidas mesmo se o servidor principal estiver temporariamente indisponível.
Outro elemento importante em muitas arquiteturas é o uso de exportadores e coletores específicos (por exemplo, no ecossistema Prometheus, com exportadores para bancos de dados, servidores web, sistemas de filas, etc.), que permitem que as métricas sejam expostas em um formato padrão sem a necessidade de reescrever cada aplicação.
Combinando agentes como o Telegraf, exportadores especializados e plataformas de visualização e séries temporais, é possível construir soluções muito completas para monitoramento de redes, servidores, aplicativos e nuvens , totalmente baseadas em software livre ou com componentes comerciais mínimos, quando o suporte oficial for desejado.
Essa abordagem modular tem a vantagem de que cada organização pode selecionar apenas as partes de que precisa , integrá-las aos seus sistemas existentes (sistema de emissão de bilhetes, CMDB, SIEM etc.) e evoluir a arquitetura à medida que o ambiente cresce ou muda para contêineres, Kubernetes ou serviços sem servidor.
Como escolher a melhor ferramenta de monitoramento de rede de código aberto
Antes de instalar a primeira ferramenta popular, é importante definir claramente o que você deseja monitorar : apenas a rede física (roteadores, switches, pontos de acesso), ou também servidores, máquinas virtuais, contêineres, aplicativos ou até mesmo a experiência do usuário e serviços em nuvem. Essa priorização permite que você reduza o leque de opções e escolha soluções que se adequem bem ao seu caso de uso principal.
É importante avaliar as principais funcionalidades de que você precisa: relatórios, alertas, visualização de dados, armazenamento de dados históricos, integração com sistemas de terceiros, APIs e suporte para protocolos específicos (SNMP, NetFlow, WMI, APIs de nuvem, etc.). Por exemplo, o Prometheus é ideal quando são necessárias métricas personalizadas e regras de alerta complexas; o Cacti se destaca na exibição de gráficos de tráfego de rede; e o Checkmk oferece visualização interativa e relatórios de SLA abrangentes.
A facilidade de uso e configuração é outro fator crucial. Ferramentas como Zabbix, Netdata ou Checkmk geralmente oferecem assistentes de configuração e painéis de controle intuitivos , enquanto soluções altamente flexíveis podem exigir uma configuração inicial mais complexa. É recomendável testar a interface de descoberta de rede, a criação de hosts e serviços e a configuração de alertas antes de tomar uma decisão.
Em termos de segurança, é essencial que a plataforma suporte criptografia, autenticação forte e controle de acesso baseado em funções . Algumas, como OpenNMS, Icinga ou Prometheus, permitem a adição de módulos ou configurações avançadas para reforçar a segurança, segmentar o acesso aos dados e atender a padrões internos ou regulatórios; além disso, é recomendável complementar isso com as melhores práticas para configuração avançada de firewall em servidores.
Por fim, é altamente recomendável realizar uma prova de conceito (POC) com 2 ou 3 ferramentas finalistas , implantá-las em um ambiente controlado, monitorar um subconjunto representativo da infraestrutura e avaliar o desempenho, a facilidade de uso, a qualidade dos alertas e a capacidade de integração com as ferramentas existentes (sistemas de tickets, CI/CD, mensagens, etc.).
Melhores práticas para monitoramento eficaz de redes
Uma vez escolhida a plataforma, o sucesso depende em grande parte de como a implementação é projetada. Um primeiro passo crucial é documentar e mapear a rede : quais dispositivos estão presentes, onde estão localizados, quais links utilizam, quais serviços críticos suportam e quais dependências existem entre eles. Isso facilitará a definição do que e como monitorar. Para entender melhor as topologias e os tipos de rede, consulte Redes de Computadores: Tipos e Exemplos.
É recomendável escolher um ou mais protocolos de comunicação padrão para que os dispositivos enviem informações para a ferramenta: SNMP para equipamentos de rede, agentes para servidores, exportadores Prometheus para serviços específicos, syslog para eventos, etc. Quanto mais homogênea for a abordagem, mais fácil será a manutenção a longo prazo.
Também é importante definir comportamentos de referência : valores normais para latência, largura de banda, CPU, memória, conexões simultâneas, etc. Isso permite a configuração de limites realistas e uma detecção mais precisa de anomalias, evitando alarmes falsos e alertas perdidos para incidentes reais.
Configurar painéis de controle claros e específicos para cada função (operações 24 horas por dia, 7 dias por semana, rede, sistemas, gerenciamento etc.) ajuda a reduzir o tempo de diagnóstico. Um NOC precisará de visualizações resumidas e alertas em tempo real; um administrador de rede, de interfaces detalhadas, erros e filas; e um CIO, de disponibilidade e SLAs para serviços críticos.
Por fim, é essencial definir uma política de escalonamento de alertas : quem recebe qual tipo de alerta, por qual canal e com qual prioridade; o que deve ser feito fora do horário de trabalho; o que constitui um incidente grave; e como a resposta é coordenada entre as equipes. Mesmo as melhores ferramentas do mundo perdem a eficácia se ninguém responder aos alertas ou se não houver um plano de ação claro.
Levando em consideração todos esses fatores, as soluções de monitoramento de tráfego de rede de código aberto permitem que você construa ambientes extremamente robustos, com visibilidade de ponta a ponta, suporte à decisão e uma base sólida para melhorar a segurança, a disponibilidade e o desempenho de qualquer infraestrutura, desde uma pequena empresa até uma grande corporação distribuída.