- ระบบ RAID ช่วยเพิ่มประสิทธิภาพและความพร้อมใช้งาน แต่ไม่สามารถทดแทนการสำรองข้อมูลได้ และไม่สามารถป้องกันความเสียหายจากความผิดพลาดทางกายภาพ ตรรกะ หรือมนุษย์ได้ทั้งหมด
- เสียงแปลกๆ สภาพการทำงานที่เสื่อมลง ความช้าผิดปกติ และข้อผิดพลาดด้านพาริตี้หรือข้อผิดพลาดในการอ่าน/เขียน เป็นสัญญาณที่ชัดเจนว่าระบบ RAID กำลังมีปัญหา
- การบังคับให้ทำการสร้างระบบใหม่ การจัดเรียงดิสก์ใหม่โดยไม่มีเอกสารอ้างอิง หรือการใช้เครื่องมือซ่อมแซมทั่วไป อาจทำให้ความเสียหายที่แก้ไขได้กลายเป็นข้อมูลสูญหายทั้งหมด
- การดำเนินการอย่างรอบคอบและรวดเร็ว พร้อมด้วยความช่วยเหลือจากผู้เชี่ยวชาญด้านการกู้คืนข้อมูล RAID จะช่วยเพิ่มโอกาสในการกู้คืนข้อมูลได้อย่างมาก
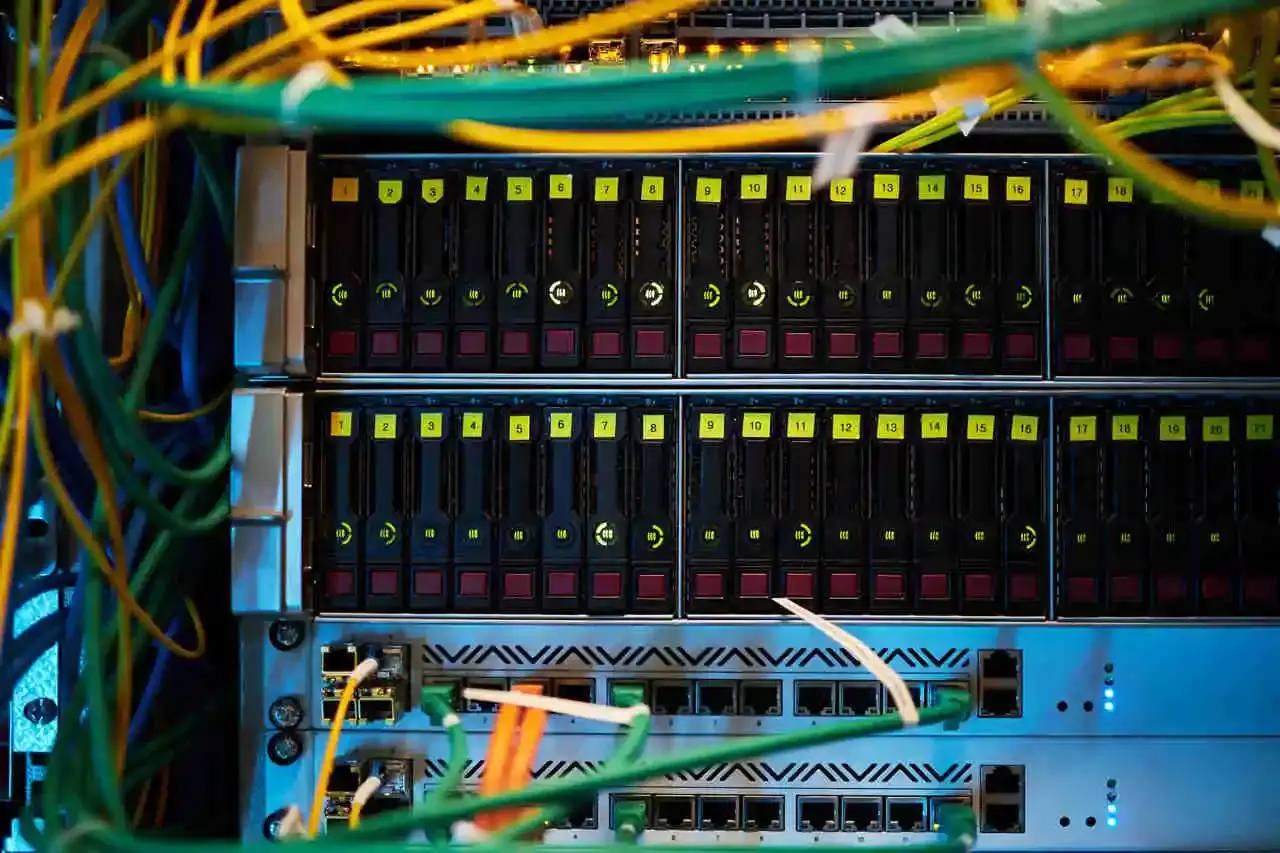
ระบบ RAID กลายเป็นเรื่องปกติในเซิร์ฟเวอร์ อุปกรณ์ NAS และระบบจัดเก็บข้อมูลเนื่องจากให้ประสิทธิภาพและความทนทานต่อความเสียหายที่เพิ่มขึ้นอย่างไรก็ตาม แม้ว่าจะช่วยให้สบายใจได้ แต่ก็ไม่ใช่ทางออกวิเศษ: ความล้มเหลวที่จัดการไม่ดีอาจนำไปสู่หายนะและทำให้คุณสูญเสียข้อมูลได้ในเวลาเพียงไม่กี่นาที
เมื่อระบบ RAID เริ่มแสดงอาการผิดปกติ สิ่งสำคัญไม่ใช่การรีบไปแก้ไข แต่เป็นการระมัดระวังที่สุดการตรวจจับสัญญาณของความล้มเหลวและรู้ว่าไม่ควรทำอะไรจะเป็นตัวกำหนดความแตกต่างระหว่างการเปลี่ยนฮาร์ดดิสก์อย่างง่ายกับการสูญเสียข้อมูลทั้งหมดที่ไม่สามารถกู้คืนได้ แม้แต่สำหรับห้องปฏิบัติการระดับมืออาชีพก็ตาม
การทำงานผิดพลาดของ RAID คืออะไร และทำไมจึงไม่เหมือนกับการสำรองข้อมูล?
RAID (Redundant Array of Independent Disks) คือระบบที่รวมดิสก์หลายตัวเข้าด้วยกันเพื่อเพิ่มความพร้อมใช้งาน ประสิทธิภาพ และ/หรือความซ้ำซ้อน ขึ้นอยู่กับระดับที่ใช้งาน ตั้งแต่ RAID 1 แบบคลาสสิกไปจนถึงการกำหนดค่าที่ซับซ้อนกว่า เช่น RAID 5, RAID 6 หรือ RAID 10 แนวคิดก็คือระบบจะยังคงทำงานต่อไปได้แม้ว่าดิสก์ทางกายภาพหนึ่งตัว (หรือมากกว่านั้น) จะเสียหายก็ตาม
ปัญหาคือหลายคนเข้าใจผิดว่า "ฉันมี RAID ดังนั้นฉันจึงมีระบบสำรองข้อมูล" ซึ่งเป็นความเข้าใจผิดอย่างร้ายแรงRAID ไม่สามารถทดแทนการสำรองข้อมูลได้ มันช่วยป้องกันความเสียหายของดิสก์หนึ่งตัวหรือมากกว่า (ขึ้นอยู่กับระดับของ RAID) แต่ไม่สามารถป้องกันความเสียหายเชิงตรรกะ ความผิดพลาดของมนุษย์ มัลแวร์เรียกค่าไถ่ การลบโดยไม่ได้ตั้งใจ หรือความล้มเหลวของคอนโทรลเลอร์หรือเซิร์ฟเวอร์ได้
นอกจากนี้ วิธีการที่ตัวควบคุม —รวมถึงเฟิร์มแวร์ของตัวควบคุม —กระจายข้อมูล (ลำดับของดิสก์ ขนาดแถบ อัลกอริทึมพาริตี เมตาเดตา ฯลฯ) หมายความว่าการจัดการอาร์เรย์ที่ไม่ถูกต้องใดๆ ก็ตามอาจทำให้โครงสร้างเสียหายและทำให้การกู้คืนทำได้ยากอย่างยิ่ง แม้ว่าดิสก์จะ "ดูเหมือน" จะใช้งานได้ปกติก็ตาม
ระดับ RAID หลักและผลกระทบต่อการกู้คืนข้อมูล
แต่ละระดับของ RAID มีพฤติกรรมที่แตกต่างกันในกรณีที่เกิดความล้มเหลว และสิ่งนี้ส่งผลกระทบอย่างมากต่อตัวเลือกในการกู้คืนข้อมูล การทำความเข้าใจความแตกต่างเหล่านี้จะช่วยหลีกเลี่ยงการตัดสินใจที่เสี่ยงเมื่อเกิดปัญหาขึ้น
ในระบบ RAID 0 ข้อมูลจะถูกกระจายไปยังดิสก์หลายแผ่นโดยไม่มีพาริตี้หรือมิเรอร์ไม่มีการสำรองข้อมูลใดๆ ทั้งสิ้น : หากดิสก์แผ่นใดแผ่นหนึ่งเสียหายหรือเสื่อมสภาพอย่างมาก การสูญเสียทางตรรกะจะเป็นการสูญเสียทั้งหมด เนื่องจากส่วนสำคัญของแต่ละไฟล์หายไป การพูดถึง "การกู้คืน" ในที่นี้จึงไม่ค่อยมีประโยชน์ เพราะสิ่งสำคัญคือการพยายามกู้คืนสิ่งที่สามารถกู้คืนได้จากดิสก์ที่เสียหายทางกายภาพ
ในระบบ RAID 1 ดิสก์จะถูกทำสำเนา: แต่ละไดรฟ์จะมีสำเนาข้อมูลที่สมบูรณ์การกำหนดค่านี้โดยทั่วไปค่อนข้างเชื่อถือได้สำหรับการกู้คืนข้อมูล หากไม่มีข้อผิดพลาดในการจัดการ (ตัวอย่างเช่น การเริ่มต้นใช้งานดิสก์ตัวใดตัวหนึ่งในระบบอื่น หรือการใช้ดิสก์หลายตัวบนคอนโทรลเลอร์ที่ไม่เข้ากัน)
RAID 5 กระจายข้อมูลไปยังไดรฟ์หลายตัวและคำนวณพาริตีแบบกระจาย ทำให้สามารถทนต่อความเสียหายของไดรฟ์ตัวใดตัวหนึ่งได้ ปัญหาเกิดขึ้นเมื่อไดรฟ์ตัวที่สองเริ่มทำงานผิดปกติในระหว่างการกู้คืนระบบ: ภาระงานจะเพิ่มขึ้นอย่างมาก ข้อผิดพลาดในการอ่านจะปรากฏขึ้น และอาร์เรย์อาจล่มโดยไม่มีการเตือนล่วงหน้า
RAID 6 ทำงานคล้ายกับ RAID 5 แต่เพิ่มพาริตีตัวที่สอง ทำให้สามารถทนต่อความเสียหายของดิสก์ได้สูงสุดถึงสองตัวอย่างไรก็ตาม โครงสร้างมีความซับซ้อนมากขึ้น การกู้คืนใช้เวลานานขึ้น และข้อผิดพลาดทางตรรกะหรือการกำหนดค่าใดๆ ก็จะทำให้การกู้คืนทำได้ยากขึ้น
RAID 10 ผสานรวมการทำมิเรอร์และสไตรป์เข้าด้วยกัน: คู่ของดิสก์ที่ทำมิเรอร์กันจะถูกเรียกว่า "สแครช" (scratch) เพื่อการกู้คืนข้อมูล ลำดับของดิสก์และความสัมพันธ์ระหว่างมิเรอร์และสไตรป์มีความสำคัญอย่างยิ่ง การสลับตำแหน่งหรือการสร้างใหม่โดยไม่ตรวจสอบอาจทำให้ระบบเสียหายได้ แม้ว่าดิสก์ทั้งหมดจะอยู่ในสภาพสมบูรณ์ก็ตาม
สัญญาณที่ชัดเจนว่าระบบ RAID ของคุณเริ่มล้มเหลว
ก่อนที่ระบบจะล้มเหลวโดยสมบูรณ์ มักจะทิ้งร่องรอยไว้หลายอย่าง การเรียนรู้ที่จะจดจำร่องรอยเหล่านั้นจะช่วยให้คุณหยุดระบบได้ทันท่วงทีและป้องกันความเสียหายเพิ่มเติม
หนึ่งในสัญญาณที่ชัดเจนที่สุดคือเสียงแปลกๆ ที่ดังมาจากฮาร์ดดิสก์ เช่น เสียงคลิกซ้ำๆ เสียงเอี๊ยดอ๊าด เสียงหึ่งๆ เป็นช่วงๆ หรือเสียงโลหะที่ไม่เคยได้ยินมาก่อน เสียงเหล่านี้มักบ่งชี้ถึงความล้มเหลวทางกลไกในหัวอ่าน/เขียนหรือแผ่นดิสก์หรือปัญหาเกี่ยวกับมอเตอร์ หากคุณเพิกเฉยและยังคงฝืนอ่านข้อมูลต่อไป สภาพของฮาร์ดดิสก์จะเสื่อมลงอย่างรวดเร็ว
อีกหนึ่งสัญญาณที่พบได้ทั่วไปคือ ข้อความ "เสื่อมสภาพ" "ล้มเหลว" หรือ "วิกฤต" ปรากฏขึ้นในคอนโซลการจัดการของ NAS หรือคอนโทรลเลอร์ RAID ข้อความนี้หมายความว่าดิสก์อย่างน้อยหนึ่งตัวถูกทำเครื่องหมายว่ามีปัญหาและอาร์เรย์กำลังทำงานโดยไม่มีระบบสำรองข้อมูลตามที่ตั้งใจไว้ ณ จุดนี้ โดยเฉพาะอย่างยิ่งใน RAID 5 ความล้มเหลวครั้งที่สองอาจเป็นฟางเส้นสุดท้าย
ควรสังเกตอาการที่ไม่ค่อยเด่นชัดแต่ก็อันตรายไม่แพ้กัน เช่นประสิทธิภาพการทำงานลดลงอย่างกะทันหันและไม่ทราบสาเหตุหากเวลาในการอ่านและเขียนข้อมูลเพิ่มขึ้นอย่างมาก โดยเฉพาะอย่างยิ่งเมื่อเข้าถึงไดรฟ์หรือโฟลเดอร์บางแห่ง ตัวควบคุมอาจกำลังมีปัญหาในการอ่านเซกเตอร์ที่ยาก หรือมีการพยายามเข้าถึงซ้ำๆ อย่างต่อเนื่องจนทำให้ระบบทำงานหนักเกินไป
บันทึกของระบบหรือตัวควบคุมมักแสดงข้อผิดพลาด I/O ข้อความพาริตีที่ไม่ถูกต้อง “ข้อผิดพลาดในการอ่านที่ไม่สามารถแก้ไขได้” “การตรวจสอบพาริตีล้มเหลว” หรือ “ตรวจพบแถบข้อมูลที่ไม่ถูกต้อง” การเพิ่มขึ้นอย่างต่อเนื่องของข้อผิดพลาดในการอ่าน/เขียนแม้ว่าระบบจะยังคงทำงานได้ ก็เป็นสัญญาณอันตรายที่ไม่ควรมองข้าม
อีกหนึ่งสัญญาณอันตรายคือ ปริมาณข้อมูลดูเหมือนจะลดลง แม้ว่าจะไม่มีดิสก์ใดเสียหายอย่างสมบูรณ์ก็ตาม โดยปกติแล้วนี่บ่งชี้ถึงความเสียหายเชิงตรรกะในเมตาเดต้า RAID หรือบล็อกแบบกระจาย และการบังคับให้สร้างใหม่โดยอัตโนมัติในสถานะนี้อาจทำให้ความเสียหายลุกลามไปทั่วทั้งอาร์เรย์
อาการบ่งชี้ความเสียหายเชิงตรรกะและปัญหาที่ซ่อนเร้นในระบบ RAID
ไม่ใช่ว่าความล้มเหลวของ RAID ทุกครั้งจะทำให้ดิสก์ "เสีย" ทันที บ่อยครั้ง ปัญหาคือการเสียหายของข้อมูลทีละน้อยอย่างเงียบๆ จนกระทั่งสถานการณ์ยากที่จะแก้ไขได้
ตัวอย่างทั่วไปคือไฟล์ที่ดูเหมือนจะมีอยู่ มีขนาดและชื่อถูกต้อง แต่เปิดไม่ได้ มีข้อผิดพลาดในการจัดรูปแบบ หรือดูเหมือนจะถูกตัดทอนฐานข้อมูลที่ไม่สามารถเชื่อมต่อได้ เครื่องเสมือนที่ไม่สามารถเริ่มต้นได้ หรือรูปภาพที่โปรแกรมดูรูปภาพปฏิเสธ มักเป็นตัวบ่งชี้ถึงความไม่สอดคล้องกันในบล็อกที่กระจายอยู่ทั่วดิสก์
นอกจากนี้ ยังเป็นเรื่องปกติที่ระบบปฏิบัติการหรือแอปพลิเคชันจะแสดงอาการช้าลงเฉพาะจุดบนไดรฟ์ RAID บางตัวแม้ว่า CPU และ RAM จะดูไม่ทำงานหนักเป็นพิเศษก็ตาม หากความช้าลงเกิดขึ้นเฉพาะกับการอ่าน/เขียนข้อมูลบนไดรฟ์เดียวกัน คุณอาจกำลังเจอปัญหาข้อมูลเสียหายหรือมีเซกเตอร์ที่ไม่เสถียรอยู่
อีกหนึ่งอาการที่อันตรายคือ การสร้างข้อมูลใหม่ที่เริ่มต้นหลังจากเปลี่ยนดิสก์มักจะหยุดอยู่ที่จุดเดิมแสดงข้อผิดพลาดแปลก ๆ หรือเพียงแค่ระบุว่ากระบวนการล้มเหลว ซึ่งโดยปกติแล้วบ่งชี้ว่าบล็อกต้นฉบับเสียหายไปแล้ว และตัวควบคุมไม่สามารถสร้างสำเนาที่สอดคล้องกันบนดิสก์ใหม่ได้
บางครั้งอาจมีเพียงดิสก์เดียวที่แสดงการแจ้งเตือน SMART (เช่น เซกเตอร์ที่ถูกจัดสรรใหม่ เวลาเข้าถึงสูง ฯลฯ) แต่พฤติกรรมที่ผิดปกตินั้นสังเกตเห็นได้ทั่วทั้งอาร์เรย์ RAID ในกรณีเช่นนี้ดิสก์เพียงตัวเดียวที่มีเซกเตอร์เสียอาจส่งผลกระทบต่อความสอดคล้องของอาร์เรย์ทั้งหมด โดยเฉพาะอย่างยิ่งเมื่อมีการเริ่มตรวจสอบความเท่าเทียมกันหรือการสร้างใหม่
การเพิกเฉยต่อคำเตือนเหล่านี้และยังคงดำเนินการตามปกติ หรือที่แย่กว่านั้นคือการบังคับให้ระบบทำงานอย่างหนัก เช่น การตรวจสอบ การสำรองข้อมูลจำนวนมาก หรือการสร้างระบบใหม่โดยอัตโนมัติ อาจทำให้ข้อมูลเสียหายและเขียนทับบล็อกข้อมูลที่ถูกต้องด้วยข้อมูลที่เสียหายได้หลังจากนั้น แม้แต่เครื่องมือระดับมืออาชีพก็ไม่สามารถรับประกันการกู้คืนข้อมูลได้อย่างสมบูรณ์
ความล้มเหลวทั่วไปในคอนโทรลเลอร์ เซิร์ฟเวอร์ และเมนบอร์ด
ปัญหาไม่ได้อยู่ที่ฮาร์ดดิสก์เพียงอย่างเดียว ตัวควบคุม RAID เมนบอร์ด หรือแม้แต่เซิร์ฟเวอร์ทั้งหมดก็อาจกลายเป็นจุดอ่อนในระบบและทำให้เกิดความล้มเหลวของอาร์เรย์ได้ แม้ว่าฮาร์ดดิสก์จะอยู่ในสภาพสมบูรณ์ก็ตาม
ตัวควบคุม RAID ไม่ว่าจะเป็นฮาร์ดแวร์เฉพาะหรือรวมอยู่ในเมนบอร์ด มีหน้าที่ตัดสินใจว่าจะเขียนข้อมูลแต่ละบล็อกไปที่ใด วิธีการคำนวณพาริตี้ และวิธีการประกอบวอลุ่ม การทำงานผิดพลาด เฟิร์มแวร์เสียหาย หรือไฟกระชาก อาจทำให้ตัวควบคุมใช้งานไม่ได้ ส่งผลให้ RAID หายไปหรือแสดงเป็น "ต่างประเทศ" "ออฟไลน์" หรือข้อความที่คล้ายกัน
ในกรณีของตัวควบคุมฮาร์ดแวร์เฉพาะทาง มีปัญหาเพิ่มเติมอีกอย่างหนึ่งคือความเข้ากันได้ระหว่างรุ่นและผู้ผลิตแทบจะไม่มีเลย ตัวอย่างเช่น หากตัวควบคุม Supermicro ตัวใดตัวหนึ่งเสีย การเปลี่ยนด้วย "ตัวที่คล้ายกัน" นั้นไม่เพียงพอ บ่อยครั้งที่ต้องใช้รุ่นเดียวกันเป๊ะๆ ที่มีเวอร์ชันเฟิร์มแวร์ที่คล้ายคลึงกัน เพื่อให้สามารถอ่านข้อมูลเมตาของ RAID ได้อย่างถูกต้อง
สำหรับโซลูชัน RAID ในตัว (ที่เรียกว่า "RAID ปลอม") เช่น RAID ซอฟต์แวร์ของชิปเซ็ต AMD หรือ Intel บางรุ่น ความเสี่ยงคือการเปลี่ยนเมนบอร์ด การรีเซ็ต BIOS หรือการสูญเสียการกำหนดค่า CMOSอาจทำให้ระบบ RAID ใช้งานไม่ได้ ในคอมพิวเตอร์เดสก์ท็อปและเวิร์กสเตชันจำนวนมาก ความล้มเหลวของเมนบอร์ดหรือแบตเตอรี่ CMOS อาจลบการกำหนดค่า RAID ทำให้ไดรฟ์กลายเป็นหน่วยที่แยกจากกัน
นอกจากนี้ ตัวเซิร์ฟเวอร์เอง ( แหล่งจ่ายไฟหน่วยความจำ เมนบอร์ด แผงวงจรหลัก ฯลฯ) ก็อาจเสียหายได้เนื่องจากปัญหาทางไฟฟ้า ความร้อนสูงเกินไป หรือข้อบกพร่องของฮาร์ดแวร์ ในหลายกรณีผลที่เกิดขึ้นจริงคือระบบ RAID จะไม่สามารถเข้าถึงได้แม้ว่าในความเป็นจริงแล้ว ดิสก์ที่เชื่อมต่อกับระบบอื่นด้วยกลยุทธ์ที่เหมาะสม อาจสามารถกู้คืนข้อมูลได้ก็ตาม
ที่แย่ไปกว่านั้น ระบบจะต้อง "ประกอบ" อาร์เรย์ RAID ใหม่ทุกครั้งที่รีสตาร์ทหรือบูตเครื่อง หาก เกิด ไฟดับ ไฟกระชาก หรือข้อผิดพลาดในไฟล์การกำหนดค่า (เช่น mdadm.conf ใน Linux) ในระหว่างกระบวนการนี้ ระบบอาจประกอบอาร์เรย์ไม่ถูกต้อง ไม่สมบูรณ์ หรือไม่สามารถจดจำอาร์เรย์ได้ ทำให้ไม่สามารถใช้งานได้
สาเหตุทั่วไปของการสูญหายของข้อมูลในระบบ RAID
เมื่อพิจารณาจากทั้งหมดข้างต้นแล้ว เห็นได้ชัดว่าแม้ว่าระบบ RAID จะมีประโยชน์มาก แต่ก็ยังคงมีความเสี่ยงสูงสาเหตุหลักที่ทำให้ข้อมูลสูญหายในสภาพแวดล้อมเหล่านี้มักเกิดจากปัจจัยทางกายภาพ ตรรกะ และมนุษย์ร่วมกัน
สาเหตุที่เห็นได้ชัดที่สุดคือความเสียหายของดิสก์อย่างน้อยหนึ่งตัวเนื่องจากการสึกหรอ ข้อบกพร่องในการผลิต การสั่นสะเทือน อุณหภูมิ หรือแรงกระแทก แม้ว่า RAID จะถูกออกแบบมาให้ทนต่อสถานการณ์เหล่านี้ได้ในระดับหนึ่ง แต่ก็ไม่ได้หมายความว่าจะไม่มีปัญหาเกิดขึ้นกับดิสก์ข้างเคียงเสมอไปเช่น ดิสก์ที่เริ่มส่งคืนเซกเตอร์ที่เสียหายอาจดึงดิสก์ข้างเคียงให้เสียหายไปด้วย โดยเฉพาะอย่างยิ่งในระหว่างกระบวนการตรวจสอบหรือการสร้างใหม่
อีกหนึ่งสาเหตุของปัญหาที่พบบ่อยคือข้อผิดพลาดในการประกอบหรือการสร้างใหม่หากระบบติดตั้งอาร์เรย์ด้วยพารามิเตอร์ที่ไม่ถูกต้อง ดิสก์อยู่ในลำดับที่ไม่ถูกต้อง ระดับ RAID แตกต่างจากเดิม หรือหลังจากการย้ายข้อมูลล้มเหลว ข้อมูลอาจเกิดการคลาดเคลื่อนได้ง่าย ในทางปฏิบัติ วอลุ่มอาจแสดงเป็น RAW ต้องทำการฟอร์แมต หรือแสดงโครงสร้างไฟล์ที่ไม่สอดคล้องกัน
ความล้มเหลวของเซิร์ฟเวอร์ (เมนบอร์ด เฟิร์มแวร์ แบ็คเพลน ตัวควบคุม SAS/SATA ฯลฯ) ก็มีบทบาทสำคัญเช่นกัน ในเหตุการณ์ส่วนใหญ่ เมื่อเซิร์ฟเวอร์ล้มเหลวอย่างกะทันหันอาร์เรย์ RAID จะไม่สามารถเข้าถึงได้ และข้อมูลจะไม่ปรากฏให้เห็นในระบบ แม้ว่าข้อมูลจะยังคงอยู่บนดิสก์ก็ตาม
นอกจากนี้ เราต้องคำนึงถึงปัจจัยด้านมนุษย์ด้วย เช่น การเปลี่ยนแปลงการตั้งค่าโดยไม่มีเอกสารประกอบ การจัดเรียงดิสก์ใหม่ "เพื่อทดสอบ" การอัปเดต BIOS โดยไม่มีการสำรองข้อมูลการตั้งค่าไว้ก่อน การลบวอลุ่มโดยไม่ตั้งใจการติดตั้งระบบปฏิบัติการใหม่บนดิสก์ที่เป็นส่วนหนึ่งของอาร์เรย์ หรือการกู้คืน ข้อมูลสำรองที่เสียหายหรือไม่สมบูรณ์บน RAID ที่เสียหายเดียวกัน
สุดท้ายนี้ ยังมีภัยคุกคามจากภายนอก เช่น แรนซัมแวร์ ซึ่งสามารถเข้ารหัสทั้งข้อมูลและโครงสร้างของไดรฟ์ที่จัดเก็บอยู่บนอาร์เรย์ RAID ในสถานการณ์เช่นนี้ กระบวนการกู้คืนจะซับซ้อนขึ้นเป็นสองเท่า กล่าวคือ ต้องจัดการกับการเข้ารหัสก่อน จากนั้นจึงต้องจัดการกับความเสียหายภายในที่อาจเกิดขึ้นกับ RAID เองด้วย
สิ่งที่ไม่ควรทำเมื่อระบบ RAID ของคุณเริ่มมีปัญหา
เมื่อเซิร์ฟเวอร์ล่มในช่วงสุดสัปดาห์และทุกคนต่างก็กังวลใจ ปฏิกิริยาที่พบบ่อยที่สุดคือการที่ใครสักคนพยายามแก้ไขปัญหาแบบฉุกเฉิน ซึ่งเป็นเรื่องที่เข้าใจได้ แต่ความพยายามที่หวังดีเหล่านี้กลับเป็นสิ่งที่ทำให้ข้อมูลแย่ลงในท้ายที่สุด
สิ่งที่อันตรายที่สุดคือการบังคับให้ทำการสร้างระบบใหม่โดยอัตโนมัติโดยไม่วิเคราะห์สถานะที่แท้จริงของดิสก์ก่อนหากดิสก์ใดดิสก์หนึ่งมีข้อมูลเสียหายหรือมีเซกเตอร์ที่ไม่สามารถอ่านได้ การสร้างระบบใหม่จะคัดลอกและผสมข้อมูลที่เสียหายกับข้อมูลที่ดีจนกว่าโครงสร้างของไดรฟ์จะถูกทำลายอย่างสมบูรณ์
อีกหนึ่งข้อผิดพลาดที่พบบ่อยคือ การเปลี่ยนฮาร์ดไดรฟ์อย่างไม่เป็นระเบียบโดยไม่รู้ว่าฮาร์ดไดรฟ์ตัวใดเสียหาย หรือไม่จดบันทึกตำแหน่งเดิมของแต่ละฮาร์ดไดรฟ์การย้ายฮาร์ดไดรฟ์ระหว่างช่อง การสลับฮาร์ดไดรฟ์ระหว่างคอนโทรลเลอร์ต่างๆ หรือการเปลี่ยนหลายตัวพร้อมกันโดยไม่มีแผนการ อาจทำให้คอนโทรลเลอร์สับสนและทำให้ RAID array สูญเสียการติดตามการกำหนดค่าได้
การใช้งานเครื่องมืออย่าง CHKDSK บน Windows หรือ fsck บน Linux โดยตรงกับไดรฟ์ RAID ที่แสดงสัญญาณความเสียหายนั้นมีความเสี่ยงสูงมาก เครื่องมือเหล่านี้พยายาม "แก้ไข" โครงสร้างไฟล์โดยอิงจากตารางที่อาจเสียหายและการแก้ไขมักเกี่ยวข้องกับการลบรายการ การย้ายบล็อก และการเขียนเมตาเดตาใหม่ ในสภาพแวดล้อมที่เสียหายอยู่แล้ว การกระทำเช่นนี้อาจส่งผลให้ไฟล์หลายพันไฟล์สูญหายอย่างถาวร
การพึ่งพาซอฟต์แวร์กู้คืน RAID ทั่วไปที่โฆษณาว่าจะ"ตั้งค่า RAID ใดๆ ได้โดยอัตโนมัติ " ก็แย่ไม่แพ้กัน เครื่องมือเหล่านี้จำนวนมากทำงานอย่างผิวเผิน โดยสันนิษฐานรูปแบบการแบ่งแถบ การชดเชย และพาริตีมาตรฐาน ซึ่งไม่เป็นไปตามนั้นเสมอไป การใช้งานที่ไม่ถูกต้องอาจเขียนทับเซกเตอร์สำคัญหรือทำให้ดิสก์อยู่ในสภาพที่แย่กว่าตอนติดตั้งครั้งแรก
สุดท้ายแล้ว การรีสตาร์ทเซิร์ฟเวอร์ซ้ำๆ การปิดและเปิดเครื่อง NAS ใหม่ หรือการใช้งานตามปกติบนอาร์เรย์ RAID ที่เสียหายหรือมีข้อผิดพลาดด้านพาริตี จะยิ่งทำให้ดิสก์เสียหายมากขึ้น จัดสรรเซกเตอร์ใหม่มากขึ้น และแพร่กระจายความเสียหายออกไปยิ่งมีการเขียนข้อมูลมากเท่าไหร่หลังจากเกิดปัญหาที่ร้ายแรงครั้งแรก ผู้เชี่ยวชาญก็จะมีพื้นที่ในการแก้ไขปัญหาน้อยลงเท่านั้น
ขั้นตอนที่ควรปฏิบัติอย่างระมัดระวังเมื่อตรวจพบความเป็นไปได้ที่ RAID จะล้มเหลว
หากพบอาการผิดปกติร้ายแรงใดๆ (เช่น เสียงดังผิดปกติ สถานะการทำงานเสื่อมลง ข้อผิดพลาดด้านความเท่าเทียมกัน การทำงานช้ามาก การสร้างใหม่ล้มเหลว ฯลฯ) วิธีที่ชาญฉลาดที่สุดคือการลดความเร็วลงและดำเนินการอย่างเป็นระบบสิ่งที่คุณไม่ได้เขียนหรือเปลี่ยนแปลงในตอนนี้ อาจสามารถแก้ไขได้ในภายหลัง
สิ่งแรกที่ต้องทำคือหยุดการเขียนข้อมูลลงในอาร์เรย์ทันที : ห้ามคัดลอกข้อมูลลงไป ห้ามสร้างเครื่องเสมือนใหม่ ห้ามอัปเดตข้อมูลจำนวนมาก หากยังสามารถเข้าถึงวอลุ่มได้ ควรทำการเมานต์เป็นแบบอ่านอย่างเดียวหากระบบอนุญาต
ถัดไป ขอแนะนำให้บันทึกสถานะปัจจุบันโดยละเอียดที่สุดเท่าที่จะเป็นไปได้ เช่น ภาพหน้าจอของ BIOS หรืออินเทอร์เฟซ NAS รายชื่อดิสก์พร้อมตำแหน่งที่ตั้ง หมายเลขซีเรียล พอร์ตที่เชื่อมต่อ ข้อความแสดงข้อผิดพลาดที่ปรากฏในบันทึก ฯลฯ ข้อมูลเหล่านี้มีค่าอย่างยิ่งสำหรับห้องปฏิบัติการกู้คืน ข้อมูล เมื่อต้องการจำลองสถานการณ์เดิม
ในกรณีที่ RAID ไม่สามารถเชื่อมต่อได้ หรือเซิร์ฟเวอร์ไม่สามารถบูตได้ ทางเลือกทางเทคนิคอย่างหนึ่งคือการถอดดิสก์ออกและเชื่อมต่อกับคอมพิวเตอร์เครื่องอื่นเพื่อสร้างสำเนาแบบเซกเตอร์ต่อเซกเตอร์ของแต่ละไดรฟ์เพื่อใช้ในการตรวจสอบทางนิติวิทยาศาสตร์สำเนาเหล่านี้ซึ่งสร้างขึ้นในโหมดอ่านอย่างเดียว จะช่วยให้คุณสามารถทำงานกับสำเนาได้ในภายหลังโดยไม่ทำให้ดิสก์ต้นฉบับเสียหายเพิ่มเติม
ด้วยความรู้ขั้นสูง เครื่องมือเฉพาะทาง และสภาพแวดล้อมที่ควบคุมได้ เราสามารถพยายามสร้างโครงสร้างเชิงตรรกะของอาร์เรย์ขึ้นใหม่จากสำเนาเหล่านี้ได้ โดยอนุมานลำดับของดิสก์ ขนาดแถบ รูปแบบพาริตี ค่าออฟเซ็ต และเมตาเดตาอย่างไรก็ตาม นี่เป็นงานวิศวกรรมย้อนกลับที่ละเอียดอ่อน การลองผิดลองถูกใดๆ ที่เกี่ยวข้องกับการเปลี่ยนแปลงพารามิเตอร์แบบสุ่มอาจนำไปสู่การตีความข้อมูลที่ผิดพลาดได้
สำหรับธุรกิจส่วนใหญ่และสภาพแวดล้อมที่สำคัญ วิธีที่ปลอดภัยที่สุดคือการติดต่อบริการกู้คืน RAID ระดับมืออาชีพโดยเร็วที่สุดและปฏิบัติตามคำแนะนำเบื้องต้นของพวกเขา อัตราความสำเร็จมักจะขึ้นอยู่กับจำนวนครั้งที่พยายามกู้คืนไม่สำเร็จก่อนที่จะติดต่อห้องปฏิบัติการ
ห้องปฏิบัติการกู้คืนข้อมูล RAID ระดับมืออาชีพทำงานอย่างไร
บริการกู้ข้อมูลระดับมืออาชีพที่เชี่ยวชาญด้านระบบ RAID ผสานความรู้เชิงลึกเกี่ยวกับฮาร์ดแวร์และระบบไฟล์เข้ากับเครื่องมือเฉพาะและขั้นตอนที่เข้มงวด นี่คือสิ่งที่พวกเขาทำโดยทั่วไปเมื่อได้รับกรณีที่ระบบ RAID ล้มเหลว
ขั้นตอนแรกคือการตรวจสอบวินิจฉัยฮาร์ดไดรฟ์แต่ละตัวอย่างละเอียด : ตรวจสอบสภาพทางกล ทางอิเล็กทรอนิกส์ และทางตรรกะของไดรฟ์ ระบุเซกเตอร์เสีย ตรวจสอบตาราง SMART และประเมินความเสี่ยงต่อความล้มเหลวในระยะสั้น หากไดรฟ์ใดมีรอยเสียหายทางกายภาพ จะต้องได้รับการซ่อมแซมในห้องปลอดฝุ่นเป็นลำดับแรก
ขั้น ตอนต่อไปคือการสร้างสำเนาทางนิติวิทยาศาสตร์ของดิสก์ทั้งหมดที่เกี่ยวข้องแทนที่จะทำงานกับดิสก์ต้นฉบับ จะทำการคัดลอกแบบเซกเตอร์ต่อเซกเตอร์ โดยใช้เครื่องมือที่อนุญาตให้ข้ามเซกเตอร์ที่เสียหายอย่างรุนแรงหรือลองใหม่ด้วยรูปแบบที่ปลอดภัย เป้าหมายคือการรักษาสถานะดั้งเดิมไว้ในกรณีที่จำเป็นต้องย้อนกลับไปยังขั้นตอนก่อนหน้าในกระบวนการ
เมื่อเตรียมสำเนาเสร็จแล้ว จะทำการ สร้าง RAID ขึ้นใหม่ด้วยตนเองโดยใช้ ตรรกะ : ระบุระดับ (0, 1, 5, 6, 10 ฯลฯ), ลำดับของดิสก์, ขนาดแถบข้อมูล, ออฟเซ็ต, อัลกอริทึมพาริตี และคุณลักษณะอื่นๆ ของคอนโทรลเลอร์เดิม บ่อยครั้งที่สามารถสร้างวอลุ่มขึ้นใหม่ได้แม้ว่าจะไม่ได้ใช้คอนโทรลเลอร์หรือ NAS ตัวเดียวกันกับที่สร้างวอลุ่มนั้นขึ้นมาก็ตาม
เมื่อปริมาตรเสมือนที่สร้างขึ้นใหม่ดูสมบูรณ์แล้วระบบไฟล์จะได้รับการซ่อมแซมหากจำเป็น ได้แก่ NTFS, ReFS, ext4, XFS, Btrfs, ZFS, VMFS และอื่นๆ งานนี้คล้ายกับการทำงานของศัลยแพทย์ คือมีการแก้ไขโครงสร้าง สร้างตาราง inode, MFTs, superblocks หรือ journals ขึ้นใหม่ โดยพยายามเปลี่ยนแปลงให้น้อยที่สุดเท่าที่จะเป็นไปได้เสมอ
สุดท้าย ข้อมูลจะถูกดึงออกมาและตรวจสอบความถูกต้องอย่างเป็นระบบ ความสอดคล้องของฐานข้อมูลหลัก เครื่องเสมือน และโฟลเดอร์สำคัญจะถูกตรวจสอบ ไฟล์จะถูกตรวจสอบว่าเปิดได้อย่างถูกต้อง และข้อมูลจะถูกส่งไปยังสื่อจัดเก็บข้อมูลใหม่ที่แยกต่างหากเช่น ฮาร์ดไดรฟ์ภายนอกหรือ NAS ใหม่ เพื่อให้ลูกค้าสามารถตรวจสอบการกู้คืนก่อนที่จะยอมรับได้
ในสถานการณ์ที่ซับซ้อนเป็นพิเศษ เช่น RAID ที่ได้รับผลกระทบจากแรนซัมแวร์ การสร้างใหม่ที่ไม่ประสบความสำเร็จก่อนหน้านี้ หรือวอลุ่มเสมือนภายในอาร์เรย์ที่เสียหายอยู่แล้ว เทคนิคการถอดรหัส การวิเคราะห์ทางนิติวิทยาศาสตร์ และการสร้าง RAID ใหม่จะถูกนำมาใช้ร่วมกัน แต่ภายใต้กฎเดียวกันเสมอคือห้ามแตะต้องข้อมูลต้นฉบับมากเกินความจำเป็น
โดยสรุปแล้ว ระบบ RAID เป็นเครื่องมือที่มีประสิทธิภาพในการเพิ่มความพร้อมใช้งานของข้อมูล แต่ก็ยังคงมีความเสี่ยงต่อข้อผิดพลาดทางกายภาพ ตรรกะ และมนุษย์ การทำความเข้าใจจุดอ่อน การระบุสัญญาณเตือนล่วงหน้า และเหนือสิ่งอื่นใดการหลีกเลี่ยงการตัดสินใจอย่างหุนหันพลันแล่นเมื่อเกิดความล้มเหลวคือสิ่งที่สร้างความแตกต่างอย่างแท้จริงระหว่างเหตุการณ์ที่น่าตกใจเล็กน้อยกับหายนะทางข้อมูล
