- Каналните изводи (Pipes) в Linux ви позволяват да свързвате процеси във верига, като свързвате stdout и stdin, с поддръжка на ядрото и инструменти като tee, xargs и cpio за сложни потоци.
- Ефективният CI/CD конвейер в Linux разчита на добър дизайн на сцената, интензивно използване на кеш памети, непроменими артефакти и паралелно тестване.
- Оптимизирането на Linux сървъра (CPU, RAM, I/O, Docker) и изпълнителите на Jenkins, GitHub Actions или GitLab Runner е ключово за намаляване на времето.
- Интегрирането на сигурност, наблюдаемост и контрол на разходите в процесите на разработка осигурява надеждни, проследими и устойчиви внедрявания в производствени среди.
Оптимизиране на тръбопроводи в Linux Не става въпрос само за верижно свързване на команди със символа |Зад всичко това се крие цял свят от оптимизиране на производителносттаДизайнът на работния процес, CI/CD, сигурността и настройката на операционната система правят цялата разлика между бавен и нестабилен конвейер и такъв, който работи, е надежден и евтин за поддръжка. Ако работите с Linux сървъри, независимо дали автоматизирате задачи в терминала или изпълнявате конвейери за непрекъсната интеграция, разбирането на тези подробности ви спестява много време и главоболия.
В тази статия ще комбинираме две допълващи се перспективи: от една страна, Класическо използване на канали (pipes) в командния ред на Linux (тръби, пренасочвания, команди като tee, xargs o cpio); от друга, на Оптимизация на CI/CD конвейер на Linux сървъриТова включва кеширане, паралелизиране на тестове, настройване на Docker, сигурност на веригата за доставки и разширени показатели за работен процес. Всичко това е обяснено на испански (от Испания), с ясни примери и много практичен подход.
Какво е конвейер и как се вписват каналите в Linux?
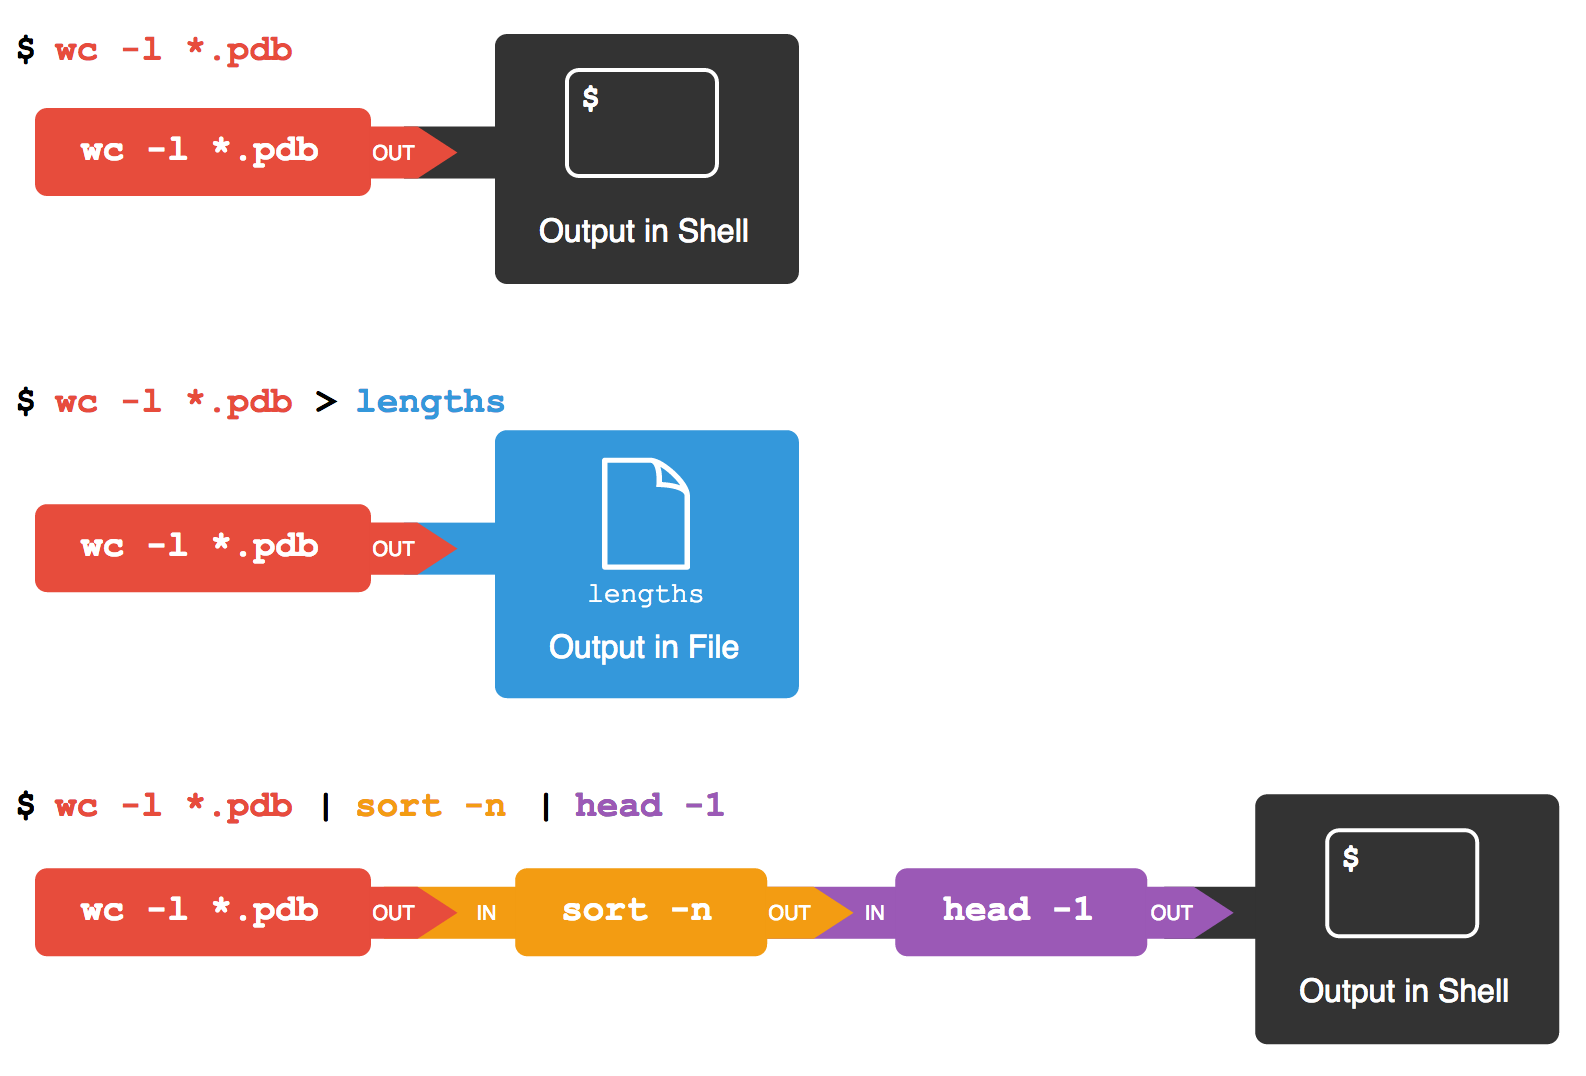
Терминът „конвейер“ произлиза от идеята за канал : поток от данни, който пътува от една точка до друга. В компютърните науки, и по-специално в Linux, каналът е механизъм, който позволява стандартният изход на един процес да се превърне в стандартен вход на друг. С други думи, изходът на една команда автоматично се подава към следващата, без да преминава през междинни файлове.
В Unix-подобните системи има два основни вида канали (pipes ). От една страна, има анонимни или неназовани канали , които могат да се използват само между тясно свързани процеси (например родител и дете). От друга страна, има именувани канали , известни още като FIFO (First In – First Out), които позволяват комуникация между процеси, които не са пряко свързани и дори могат да бъдат на различни машини, свързани към мрежа.
Анонимните канали обикновено осигуряват еднопосочна комуникация : единият процес пише, а другият чете. За разлика от тях, именуваните канали позволяват двупосочна комуникация , ако са проектирани по този начин, например чрез отваряне на FIFO в режим на четене/запис от двата края. Те се използват широко за координиране на демонични процеси, скриптове или услуги, които трябва да си предават данни без блокиране.
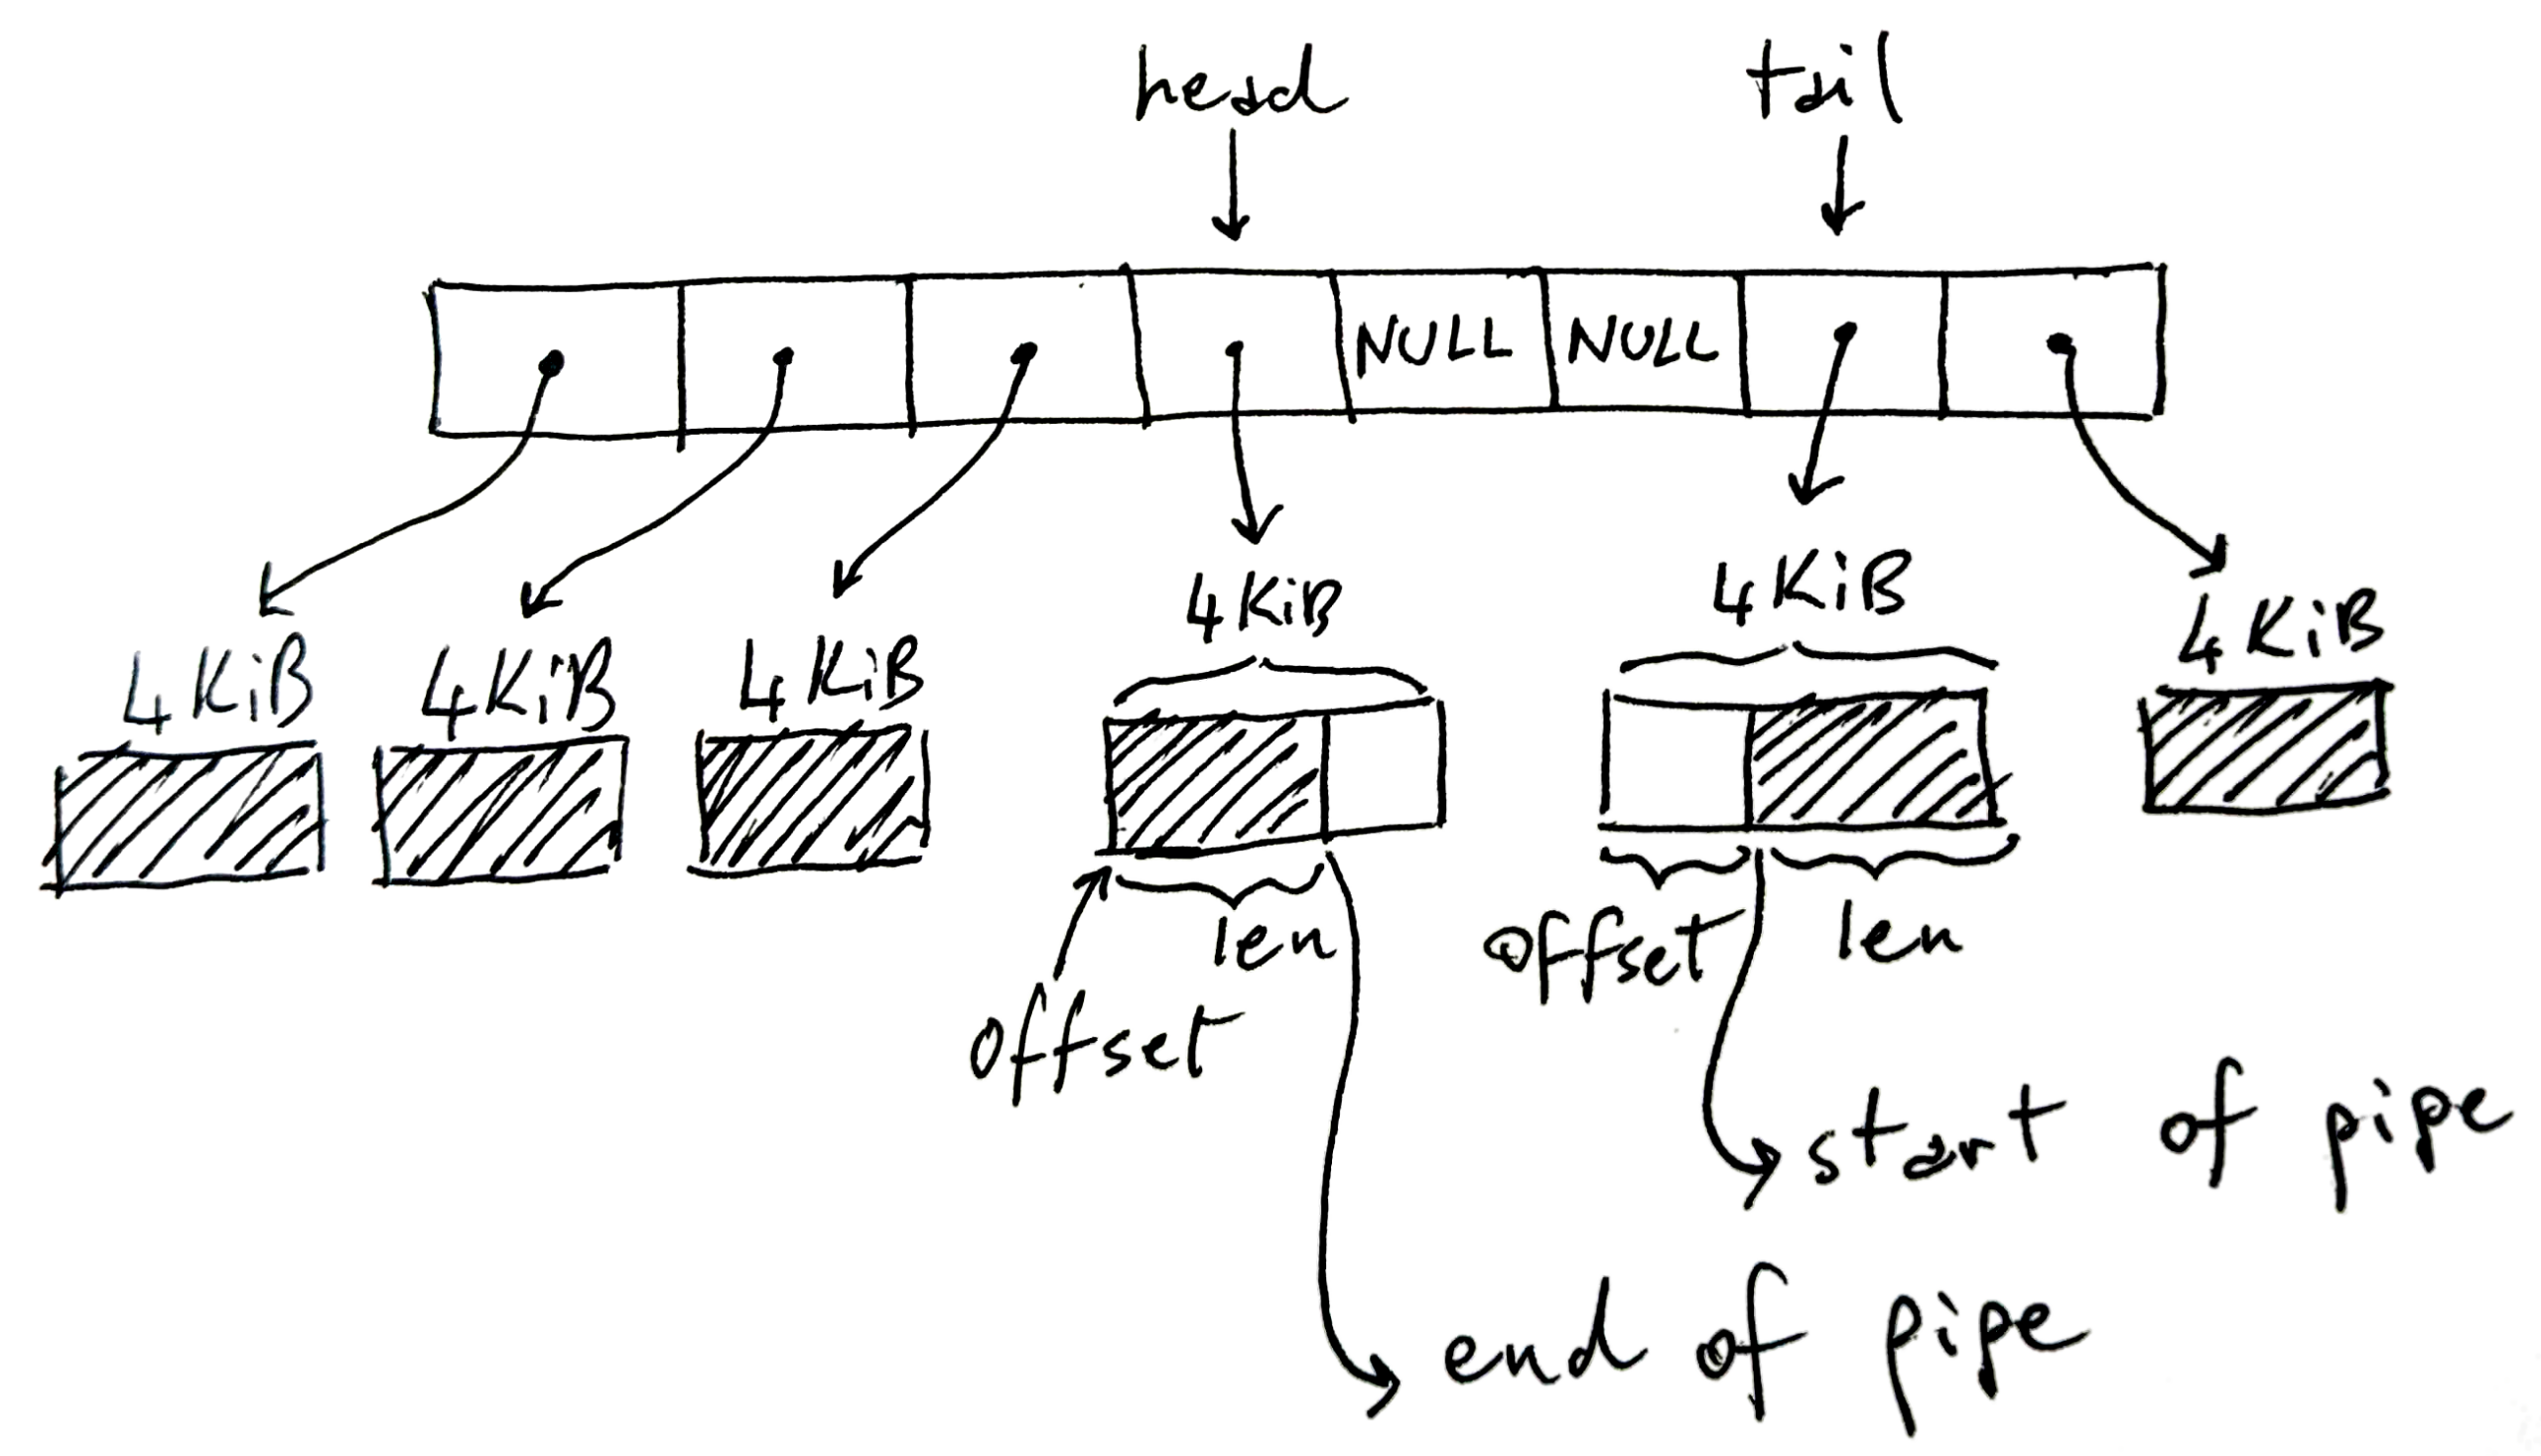
На ниво внедряване, поддръжката за тръбопроводите е в ядро на Linuxне в обвивката. Интерпретаторът на командите (bash, zsh и т.н.) просто създава конвейера чрез системни извиквания като pipe() y fork()пренасочете файловите дескриптори и след това стартирайте всяка програма. Истинската магия на това как се блокират процесите, как се управлява буферът и как данните се разпространяват между производителя и потребителя се обработва от системното ядро.
Разбиране на stdin, stdout и потока от данни
За да работите ефективно с конвейери, е изключително важно да разберете какво представляват stdin, stdout и stderr . Това не са абстрактни понятия: всеки процес в Linux започва с три отворени файлови дескриптора, които сочат към специфични ресурси, управлявани от ядрото.
stdin (дескриптор 0) и stdout (дескриптор 1) могат да се разглеждат като байтови потоци, свързани с нещо: може да е терминал, файл, мрежов сокет или канал. Те не са просто буфери; те са препратки към обекти на ядрото ( структури от файлов тип ), които от своя страна са свързани с inode, sockets или вътрешни канални структури.
Всеки процес има свои собствени дескриптори, така че всяка команда в конвейер Той преглежда своите stdin и stdout независимо. На ред като ls | grep txt | wc -l, на ls пиша в тръба, grep Чете от една тръба и записва в друга, и wc Прочетете от последния. За потребителя изглежда като единичен низ, но вътрешно те са множество конкатенирани буфери на ядротокато всеки процес се блокира и възобновява в зависимост от наличното пространство или данни.
Когато първият процес генерира данни по-бързо, отколкото вторият ги консумира, буферът на канала се запълва. В този момент последващите записи се връщат, блокирайки изпращащия процес, докато консумиращият процес... прочетете достатъчно информация и освобождава място. Това предотвратява излизането на паметта извън контрол; данните не се натрупват безкрайно, освен ако не използвате неблокиращ входно/изходен сигнал или специални сигнали. Например, в случай като dd if=/dev/sda | gzip -9И gzip компресира по-бавно, dd той е принуден да чака.
Този механизъм за обратно налягане прави тръбопроводите доста стабилни, дори когато има дисбаланс в производителността между етапите, нещо, което след това се отразява и в проектирането на CI/CD тръбопроводи , където бавните етапи се превръщат в пречка, която трябва да бъде измерена и оптимизирана.
Практическо използване на тръби в Linux терминала
В ежедневната употреба, каналите се използват за верижно свързване на команди на един ред и трансформиране на данни стъпка по стъпка. Вместо да изпълнявате команда, да гледате резултата, да го копирате и да го поставяте в друга команда, можете да изградите малки, много гъвкави „фабрики за данни“ в обикновен текст.
Типичен пример в Unix среди е комбинирането на командата fortune, който показва произволни цитати, с cowsayкоето отпечатва „говореща“ крава. Когато се използва тръбна черта, Заминаването на Форчън се превръща в посланието на Коузивсичко в една команда. Това е игрив пример, но перфектно илюстрира идеята за свързване на прости инструменти за по-сложни задачи.
Друга класика е да изпратите резултата от ls a wc да брои редове, думи и знаци. Нещо подобно ls | wc Позволява ви бързо да видите колко артикула са в списъка. Хубавото е, че не ви е необходима една единствена програма, за да направите всичко, а по-скоро... Вие създавате решения с малки, добре проектирани комунални услуги..
Също така е много често срещано да се свързват верижно cat, sort y more (или друг пейджър), за да сортирате текстов файл и след това да го разглеждате страница по страница. С помощта на канал (pipe) съдържанието преминава от една команда към следващата, без да се запазва в изрични временни файлове, което значително опростява скриптирането и административните задачи.
В практически случаи, като например обработка на списъци със студенти и оценки в отделни файлове, можете да използвате paste за обединяване на колони, cut за да изберете само полетата, които ви интересуват, и верижни канали за филтриране, сортиране или трансформиране на всичко в един ред от shell скрипта. Този модел на разделете голям проблем на прости команди, комбинирани с канали Това е същността на философията на Unix.
Разширени команди за извличане на максимума от каналите: tee, xargs и cpio
Когато започнете наистина да автоматизирате нещата в Linux, pipe-овете стават още по-мощни благодарение на някои ключови инструменти. Сред тях са: tee, xargs y cpioкоито допълват много добре стандартния поток от данни.
Командата tee Действа като „Т“ във водопроводна тръба: чете от stdin, записва в stdout и копира същия изход в един или повече файлове. Идеален е, когато искате преглед на резултата на екрана и едновременно с това запазване на резултата да го прегледате по-късно или да го обработите на друг етап. С опцията -a Добавя данни в края на файла, вместо да ги презаписва.
Например, можете да сортирате списък с sortизпратете резултата до tee да го съхрани в лог и едновременно с това да го предаде на more да го номерирате. По този начин, в един конвейер, имате сортиране, запазване на диск и удобно преглеждане, без да повтаряте процеса на сортиране.
Командата xargs Това е друга фундаментална част, когато става въпрос за канали. Неговата функция е да приема това, което пристига през stdin (обикновено списък с елементи) и да го преобразува в аргументи за друга команда. Това е особено полезно, когато програма се срине, защото получава твърде много параметри едновременно или когато искате разделете работата на партиди с опция -n, което ограничава броя на аргументите, които се предават при едно изпълнение.
Например с ls | xargs -n 4 Разделяте списъка с файлове на групи от по четири, изпълнявайки командата target (по подразбиране echo(или този, който посочите) няколко пъти. По този начин можете да изградите конвейери като „преглед на това, което ще изтрия“, като комбинирате ls, xargs y echo rm преди да стартирате действителното избърсване.
Бъдете внимателни със сложни входни данни: пътища с интервали или специални символи може да наруши поведението по подразбиране xargsВ тези случаи обикновено се използва в комбинация с find и опцията -print0, който разделя елементите с нулев символ, заедно с xargs -0 така че и двата края да използват един и същ устойчив разделител.
На последно място, cpio Това е по-малко известна команда от tarНо е изключително гъвкав за работа с файлови потоци през канали. За разлика от tar, той е проектиран от самото начало да работи с пренасочвания и канали: получава списък с файлове чрез stdin (обикновено генериран с find) и създава или консумира файлове от тип „пакет“ без собствена компресия, които след това можете да компресирате с gzip или подобен.
Основните режими на cpio позволява създаването на файлове (-o), копиране на дървета на директории (-p) или извличане на съдържание (-i(често наричано „копиране“). Опции като -u да презапиша, -m за запазване на времеви отпечатъци или -d пресъздаването на структурата на директориите прави възможно да контролира подробно какво се копира и как, особено полезно в сложни скриптове, където tar не достига.
Проектиране и оптимизация на CI/CD конвейери на Linux сървъри
Отвъд традиционния команден ред, концепцията за конвейер се е превърнала в фундаментална в света на непрекъснатата интеграция и непрекъснатата доставка (CI/CD) . На Linux сървър, CI/CD конвейерът е автоматизирана поредица от стъпки: извличане на код, инсталиране на зависимости, компилиране, изпълнение на тестове, пакетиране на артефакти и внедряване.
Linux е особено подходящ за това, защото се откроява със своята скорост, стабилност и екосистема от инструменти за автоматизация . Платформи като Jenkins, GitHub Actions и GitLab CI разчитат на Linux изпълнители (физически машини, виртуални машини или контейнери), за да изпълняват континуирано пайплайните.
Оптимизирането на тези пайплайни означава не само да ги накарате да „работят“, но и да работят с възможно най-малко триене. Това означава намаляване на времето за проверка, минимизиране на повтарящите се инсталации на зависимости, оптимизиране на Docker образи , за да се избегнат ненужни преустройства, повторно използване на вече генерирани артефакти и поддържане на средата сигурна и наблюдаема.
Основна добра практика е конвейерът да се структурира в добре дефинирани етапи: изграждане, тестване и внедряване . В идеалния случай трябва да компилирате само веднъж, да генерирате артефакт (двоичен файл, пакет, Docker образ), който се тества паралелно в различни варианти (например, различни езикови версии), и след това да внедрите същия артефакт в тестова и производствена среда без повторно компилиране.
Работата с непроменяеми артефакти, съхранявани в хранилища (S3, Nexus, Artifactory, контейнерни регистри или пакети, вградени в GitLab/GitHub), опростява одита, позволява бързо връщане към предишни версии и намалява вероятността „работи на моята машина, но не и в продукция“.
Предварителни изисквания: дистрибуция, потребителска CI и защита на сървъра
Преди да се задълбочите в милисекундна оптимизация тук-там, е важно да се установи стабилна основа на Linux сървъра , който ще действа като изпълнител на CI/CD. Това започва с избора на дистрибуцията и минималната конфигурация за сигурност.
Най-разумният подход обикновено е да се стандартизира върху LTS или стабилна дистрибуция , с която екипът е запознат: Ubuntu LTS, Debian Stable или корпоративни алтернативи като AlmaLinux или Rocky Linux. Наличието на една и съща версия на всички операционни системи предотвратява неочаквано поведение, причинено от различни библиотеки или ядра между задачите.
Друга препоръка е да конфигурирате специален потребител за CI, без root права, като sudo е силно ограничено само до основните команди (например, systemctl o docker (ако наистина е необходимо). Този потребител трябва да се удостовери, използвайки SSH ключове, както за достъп до сървъра, така и за взаимодействие с Git хранилища или други отдалечени машини.
На системно ниво е препоръчително да се поддържа сървърът актуализиран и минимално подсиленТова включва прилагане на актуализации за сигурност, конфигуриране на рестриктивна защитна стена (например с UFW: отказване на целия входящ трафик, освен необходимия, и разрешаване на изходящия трафик) и активиране на инструменти като fail2ban за да се спрат атаки с груба сила срещу SSH и да се коригират някои мрежови и ядрени параметри чрез sysctl за подобряване на надеждността и производителността.
Например, обичайно е да се повиши лимитът на обезверявам за да се предотврати изчерпването на ресурсите на системи за изграждане, които наблюдават много файлове, и да се коригира параметърът vm.swappiness за да направи ядрото по-консервативно при използване на swap, нещо особено важно, когато CI задачите консумират много памет едновременно.
Кешове, Docker и паралелизация: лостовете за производителност в CI/CD
Ако погледнете къде всъщност отива времето в един средностатистически конвейер, ще видите, че огромна част от него се губи при инсталиране на зависимости и преизграждане на Docker образи . Справянето с това обикновено е по-ефективно от оптимизирането на тестовия код с няколко милисекунди.
Първият лост е кеширането на зависимости . Почти всички мениджъри на зависимости (pip, npm, Maven, Gradle, Go модули и др.) използват локални кеш директории. На постоянен Linux сървър можете да споделяте тези директории между задачи или да ги монтирате на постоянен том. По този начин всяко изпълнение не е необходимо да изтегля половината интернет отново.
За Docker, активирайте BuildKit и структурирайте добре Dockerfile Това бележи повратна точка. Поставянето на инсталацията на зависимостите веднага след копирането на файла с изискванията и преди останалата част от кода гарантира, че слоевете ще се използват повторно, стига версиите на тези зависимости да останат непроменени. Освен това, в самото изграждане могат да се настроят специфични кешове за pip, npm и др.
Вторият основен лост е паралелно изпълнение на тестовеМного рамки поддържат вградено паралелизъм: pytest с -n autoJava инструменти като Surefire, Jest в JavaScript с --maxWorkersи т.н. Разделянето на пакета по модули, папки или дори по очаквано време и балансирането му между няколко служители позволява намаляване от 2 до 5 пъти на продължителността на тестовата фаза, без да се променя нито една бизнес линия.
И накрая, съществува проблемът с артефактите и внедряването . Вместо да се прекомпилира едно и също изображение за подготовка, предпроизводство и производство, ефективният подход е да се компилира веднъж, резултатът да се запише в хранилище и да се маркира според средата за внедряване. Това намалява използването на процесора, избягва несъответствия и значително ускорява дългите конвейери.
Оптимизиране на Jenkins, GitHub Actions и GitLab Runner в Linux
Всяка CI система има свои собствени особености, но всички те се възползват от едни и същи основни идеи, когато работят на Linux. Ключът обикновено е да се използват ефимерни и чисти изпълнители , да се поддържа подходящ постоянен кеш и да се контролира едновременността.
В Jenkins често срещана практика е да се използват леки, временни агенти (като Docker контейнери или pod-ове в Kubernetes или други решения за оркестрация на контейнери ) за изпълнение на задачи, като същевременно главният възел се поддържа възможно най-прост. Тези агенти могат да бъдат конфигурирани като системни услуги на Linux сървъри, регистрирайки се с контролера и стартирайки автоматично при стартиране на машината.
За GitHub действия със самостоятелно хоствани runners се препоръчва да се разположат в Виртуални машини с Linux с бързи SSD дисковеЗа да създадете голяма кеш директория, предназначена за действия (езикови зависимости, кешове за изграждане и др.), ограничете броя на едновременните задачи, за да избегнете претоварване на процесора и диска. Възползвайте се от официалното действие за кеширане с пътища като ~/.cache/pip, ~/.npm o ~/.m2 Това прави огромна разлика във времето.
В GitLab Runner, изборът между shell executor и Docker зависи от баланса между производителност и изолация, който ви е необходим. Shell executor е по-бърз, защото работи директно на хоста, но Docker executor предлага чисти и репликируеми среди. Можете също така да конфигурирате споделено кеширане (локално или на S3) и да коригирате максималния брой едновременни задачи, за да се възползвате от хардуера, без да го претоварвате.
Във всички тези случаи, наличието на споделени томове за кеширане на зависимости, като същевременно се предотвратява претрупването на работните пространства между компилациите, е от решаващо значение. Ефимерните машини или контейнери, които се създават и унищожават с всеки конвейер или група конвейери, значително намаляват проблемите от типа „вчера работеше, но днес не“, причинени от остатъци от предишни компилации.
Производителност на Linux сървъра: процесор, памет, входно/изходни операции и Docker
Без значение колко оптимизирани са вашите скриптове, ако Linux сървърът, на който работи конвейерът, не е с правилния размер, ще се сблъскате с безкрайни опашки и бавно движещи се задачи. Типична, разумна конфигурация за машина от среден клас е 4-8 vCPU и 8-16 GB RAM , със SSD памет (в идеалния случай NVMe) и известно swap пространство (2-4 GB) за справяне с пикови натоварвания без агресивно спиране на процесите.
Файловата система също има значение. Използвайте ext4 или XFS с опцията noatime В томовете, където компилирате или записвате лог файлове, намалете ненужните входно-изходни операции. Освен това, монтирането на tmpfs за временни файлове или краткотрайни артефакти (например, /mnt/ci-tmp) ускорява интензивните операции и предотвратява запълването на диска с остатъчни файлове между задачите.
Що се отнася до Docker, хигиената на демоните е ключова. Безопасното и редовно премахване на неизползвани изображения и томове, като същевременно се поддържат „горещи“ базови изображения, помага за... контрол на дисковото пространство и времето за зарежданеКоманди като docker system prune С подходящи филтри за време, те позволяват почистване без претоварване на наскоро използвани ресурси.
Ако вашата непрекъсната интелигентност е с интензивно използване на контейнери, можете също да използвате огледални регистри, за да избегнете постоянно изтегляне от интернет, да използвате BuildKit за паралелизъм и кеширане на слоеве и дори да конфигурирате афинитети на процесора (комплекти процесори) или специални възли за най-взискателните изпълнители, предотвратявайки смущения между съседни натоварвания. Освен това, разбирането на микроархитектурата на процесора ви помага да оразмерите по-добре ресурсите за интензивни натоварвания на непрекъснатата интелигентност.
Сигурност в процес на разработка (DevSecOps) и внедрявания в Linux
Бърз, но несигурен конвейер е бомба със закъснител. Интегрирането на сигурността в самия конвейер и сигурността на Docker контейнера вече е стандарт във всяка DevSecOps стратегия, а Linux предлага много инструменти за това.
Първото нещо, което трябва да направите, е да се отнасяте с най-голямо внимание към тайните и идентификационните данни . Те никога не трябва да се намират в кода или във версирани конфигурационни файлове. Вместо това, те се съхраняват в мениджъри на тайни данни (маскирани променливи на GitLab, криптирани тайни на GitHub, HashiCorp Vault и др.) и се инжектират само по време на изпълнението на задачата, която се нуждае от тях, като се използват краткотрайни токени, когато е възможно.
Друг важен слой е генерирането на SBOM (софтуерни спецификации) и подписването на артефакти. Инструменти като Syft или CycloneDX ви позволяват да изброите всички компоненти, които съставят образ или двоичен файл, докато Cosign или други проверими решения за подписване гарантират, че се внедряват само артефакти, които са преминали през процеса на обработка и са били валидирани.
По отношение на мрежата и достъпа е препоръчително да се сегментират мрежите за непрекъсната интеграция (CI) и производствените мрежи , да се внедрят строги защитни стени, да се проверяват лог файловете за изпълнение и редовно да се въртят идентификационните данни. Когато се използва SSH, е по-добре да се използват сертификати или ключове с дати на валидност, а не статични пароли.
При внедряване в Linux, стратегии като Blue/Green, rolling и canary значително намаляват въздействието на грешките при внедряване. Стартирането на приложението като системна услуга, поставянето на Nginx или HAProxy пред него и контролирането на трафика между версиите с проверки за състоянието ви позволява да постигнете практически нулево време на престой по време на актуализации.
Например, при презареждане на Nginx и рестартиране на услуги със systemd, използващи сигнали за меко спиране (като например SIGTERMС разумни времена на изчакване можете да източите активните връзки, преди процесът да спре, запазвайки потребителското изживяване непокътнато, докато превключвате версиите във фонов режим.
Наблюдаемост, показатели и разходи в Linux конвейери
След като вашите тръбопроводи са стартирани и работят, следващата стъпка е да ги измерите и да разберете къде отиват времето и ресурсите . Не е достатъчно да знаете дали даден работен процес е успешен или неуспешен; трябва да наблюдавате продължителността на всеки етап, времето на опашката, процента на успех, честотата на внедряване, процента на попадения в кеша и т.н.
Често срещано е системните показатели да се експортират с помощта на node_exporterЦентрализирайте лог файловете с решения като ELK или Loki и визуализирайте всичко в таблата за управление на Grafana. По този начин можете да откриете например дали фазата на тестване се е увеличила по продължителност с 30% през последната седмица или дали задачите прекарват твърде много време в чакане на свободен изпълнител; наблюдение на мрежовия трафик Инструментите с отворен код допълват тази видимост.
Възможно е също така да се инструментализира самия конвейер, например в GitHub Actions или GitLab CI, за да да се измери програмно колко изпълнения са били успешни, колко време е продължило всяко изпълнение и какво е общото състояниеСкрипт, който извиква API-то на доставчика, изчислява общия брой изпълнения, броя на успешните изпълнения, броя на неуспешните изпълнения, процента на успех и средната продължителност и запазва всичко в JSON файл (като pipeline-metrics.json) ви позволява да интегрирате тези показатели в отчети или табла за управление.
С тази информация можете да вземате решения относно размера и броя на бегачите : понякога е по-добре да имате повече малки бегачи, отколкото няколко много големи, за да намалите времето за изчакване. Автоматичното мащабиране – например, автоматично мащабиране в облака или динамични пулове от Kubernetes възли – помага за абсорбиране на пиковата активност през деня и минимизиране на недоизползваните ресурси през нощта.
Тези практики не само подобряват работата на екипа, но и помагат за коригиране на разходите за инфраструктура чрез контролиране на потреблението на процесор, памет и особено на място за съхранение, което има тенденция да се увеличава рязко с изображения и кешове, ако не се почистват редовно и планирано.
Овладяването както на класическите командни канали, така и на съвременните CI/CD канали в Linux предлага мощна комбинация: можете да автоматизирате всичко - от прости задачи за филтриране на текст до сложни, поддържаеми, сигурни и бързи канали за изграждане, тестване и внедряване. Разбирането на това как информацията тече между процесите, как се кешират зависимостите, как се настройват сървърите и как се интегрират показателите и сигурността, ви позволява да изграждате работни потоци, които се мащабират с вашия екип и проекти, без да се превръщат в постоянно пречка.
