- Pipes in Linux ermöglichen es, Prozesse zu verketten, indem stdout und stdin verbunden werden. Für komplexe Abläufe stehen Kernel-Unterstützung und Tools wie tee, xargs und cpio zur Verfügung.
- Eine effiziente CI/CD-Pipeline unter Linux basiert auf einem guten Stage-Design, der intensiven Nutzung von Caches, unveränderlichen Artefakten und parallelen Tests.
- Die Optimierung des Linux-Servers (CPU, RAM, I/O, Docker) und der Jenkins-, GitHub Actions- oder GitLab Runner-Executors ist der Schlüssel zur Reduzierung der Laufzeiten.
- Die Integration von Sicherheit, Beobachtbarkeit und Kostenkontrolle in die Pipeline gewährleistet zuverlässige, nachvollziehbare und nachhaltige Bereitstellungen in Produktionsumgebungen.
Optimierung von Pipelines in Linux Es geht nicht nur darum, Befehle mit dem Symbol zu verketten. |Dahinter verbirgt sich eine ganze Welt LeistungsoptimierungWorkflow-Design, CI/CD, Sicherheit und Betriebssystemoptimierung sind entscheidend für den Erfolg einer Pipeline: Sie funktioniert schnell, zuverlässig und kostengünstig im Betrieb. Wenn Sie mit Linux-Servern arbeiten, sei es zur Automatisierung von Aufgaben im Terminal oder zum Betrieb von Continuous-Integration-Pipelines, sparen Ihnen diese Kenntnisse viel Zeit und Ärger.
In diesem Artikel werden wir zwei sich ergänzende Perspektiven miteinander verbinden: zum einen die Klassische Verwendung von Pipes in der Linux-Befehlszeile (Pipes, Umleitungen, Befehle wie tee, xargs o cpio); auf der anderen die CI/CD-Pipeline-Optimierung auf Linux-ServernDazu gehören Caching, Testparallelisierung, Docker-Optimierung, Lieferkettensicherheit und fortgeschrittene Workflow-Metriken. Alles wird auf Spanisch (aus Spanien) erklärt, mit anschaulichen Beispielen und einem sehr praxisorientierten Ansatz.
Was ist eine Pipeline und welche Rolle spielen Pipes in Linux?
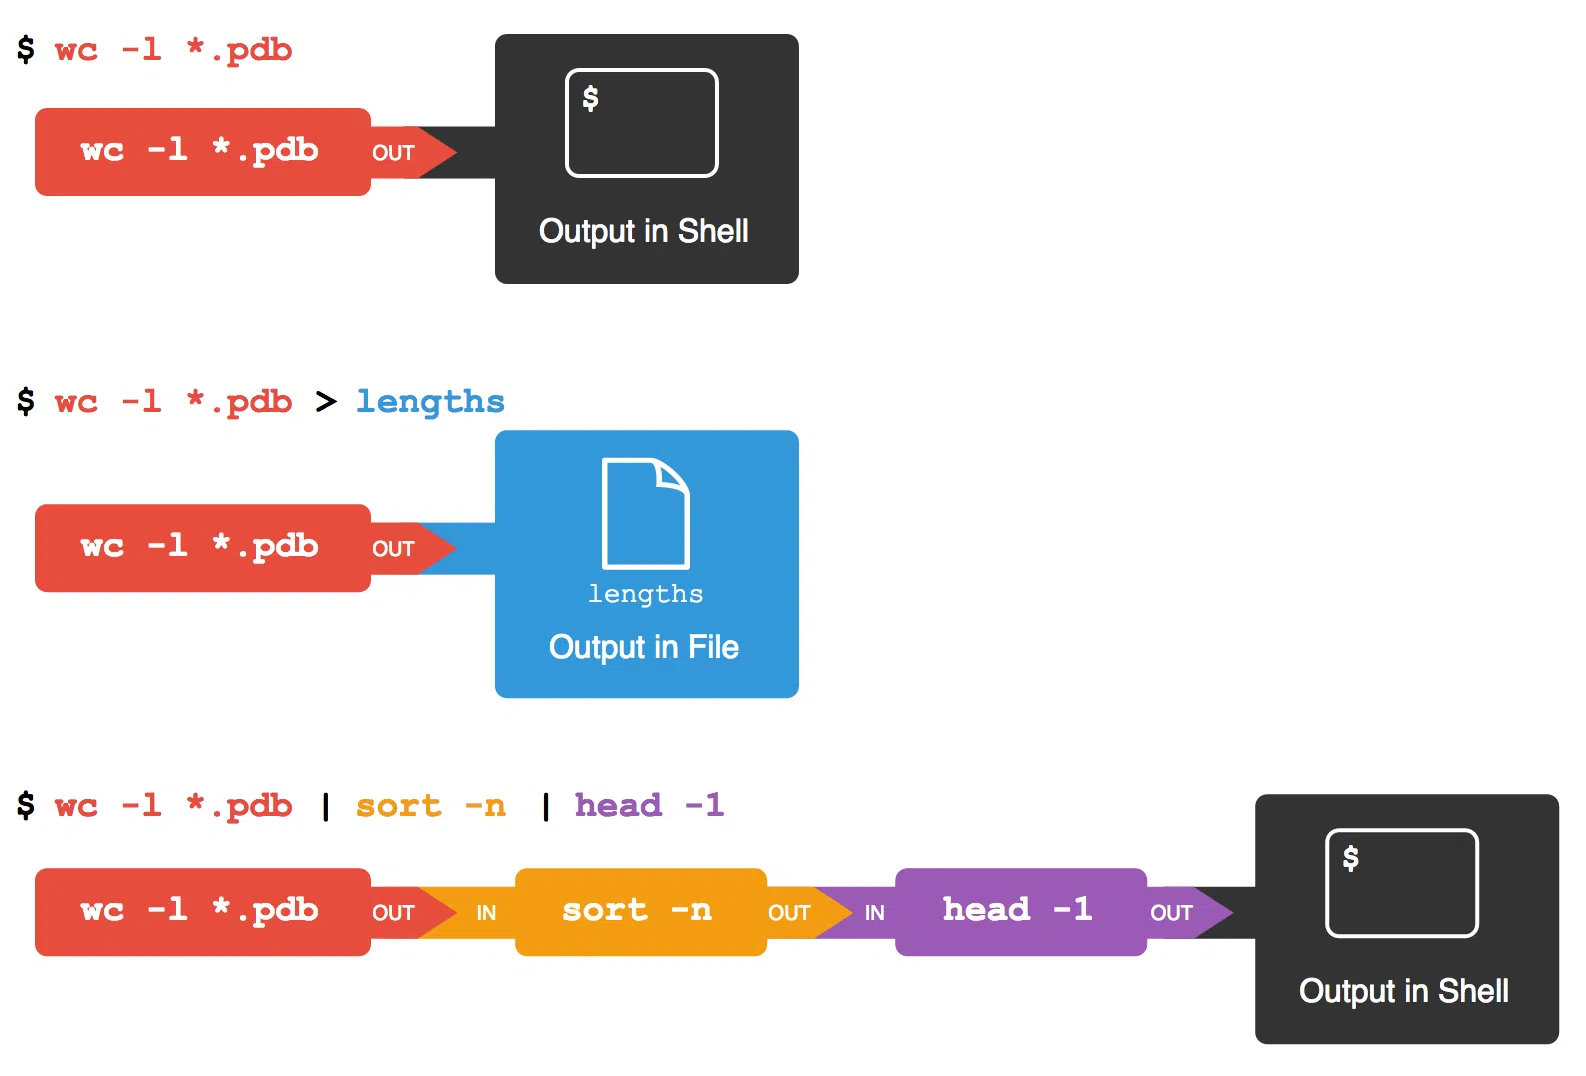
Der Begriff Pipeline leitet sich von der Vorstellung einer Leitung ab : einem Datenfluss von einem Punkt zum anderen. In der Informatik, insbesondere unter Linux, ist eine Pipe ein Mechanismus, der es ermöglicht, die Standardausgabe eines Prozesses als Standardeingabe eines anderen zu verwenden. Anders ausgedrückt: Die Ausgabe eines Befehls wird direkt an den nächsten weitergeleitet, ohne dass Zwischenspeicher benötigt wird.
In Unix-ähnlichen Systemen gibt es zwei Haupttypen von Pipes . Zum einen anonyme oder unbenannte Pipes , die nur zwischen eng verwandten Prozessen (z. B. Eltern- und Kindprozessen) verwendet werden können. Zum anderen gibt es benannte Pipes , auch bekannt als FIFO (First In – First Out), die die Kommunikation zwischen Prozessen ermöglichen, die nicht direkt miteinander verbunden sind und sich sogar auf verschiedenen, mit einem Netzwerk verbundenen Rechnern befinden können.
Anonyme Pipes ermöglichen typischerweise unidirektionale Kommunikation : Ein Prozess schreibt, der andere liest. Benannte Pipes hingegen erlauben bidirektionale Kommunikation , sofern sie entsprechend konzipiert sind, beispielsweise durch beidseitiges Öffnen des FIFO im Lese-/Schreibmodus. Sie werden häufig zur Koordination von Daemon-Prozessen, Skripten oder Diensten eingesetzt, die Daten untereinander austauschen müssen, ohne sich gegenseitig zu blockieren.
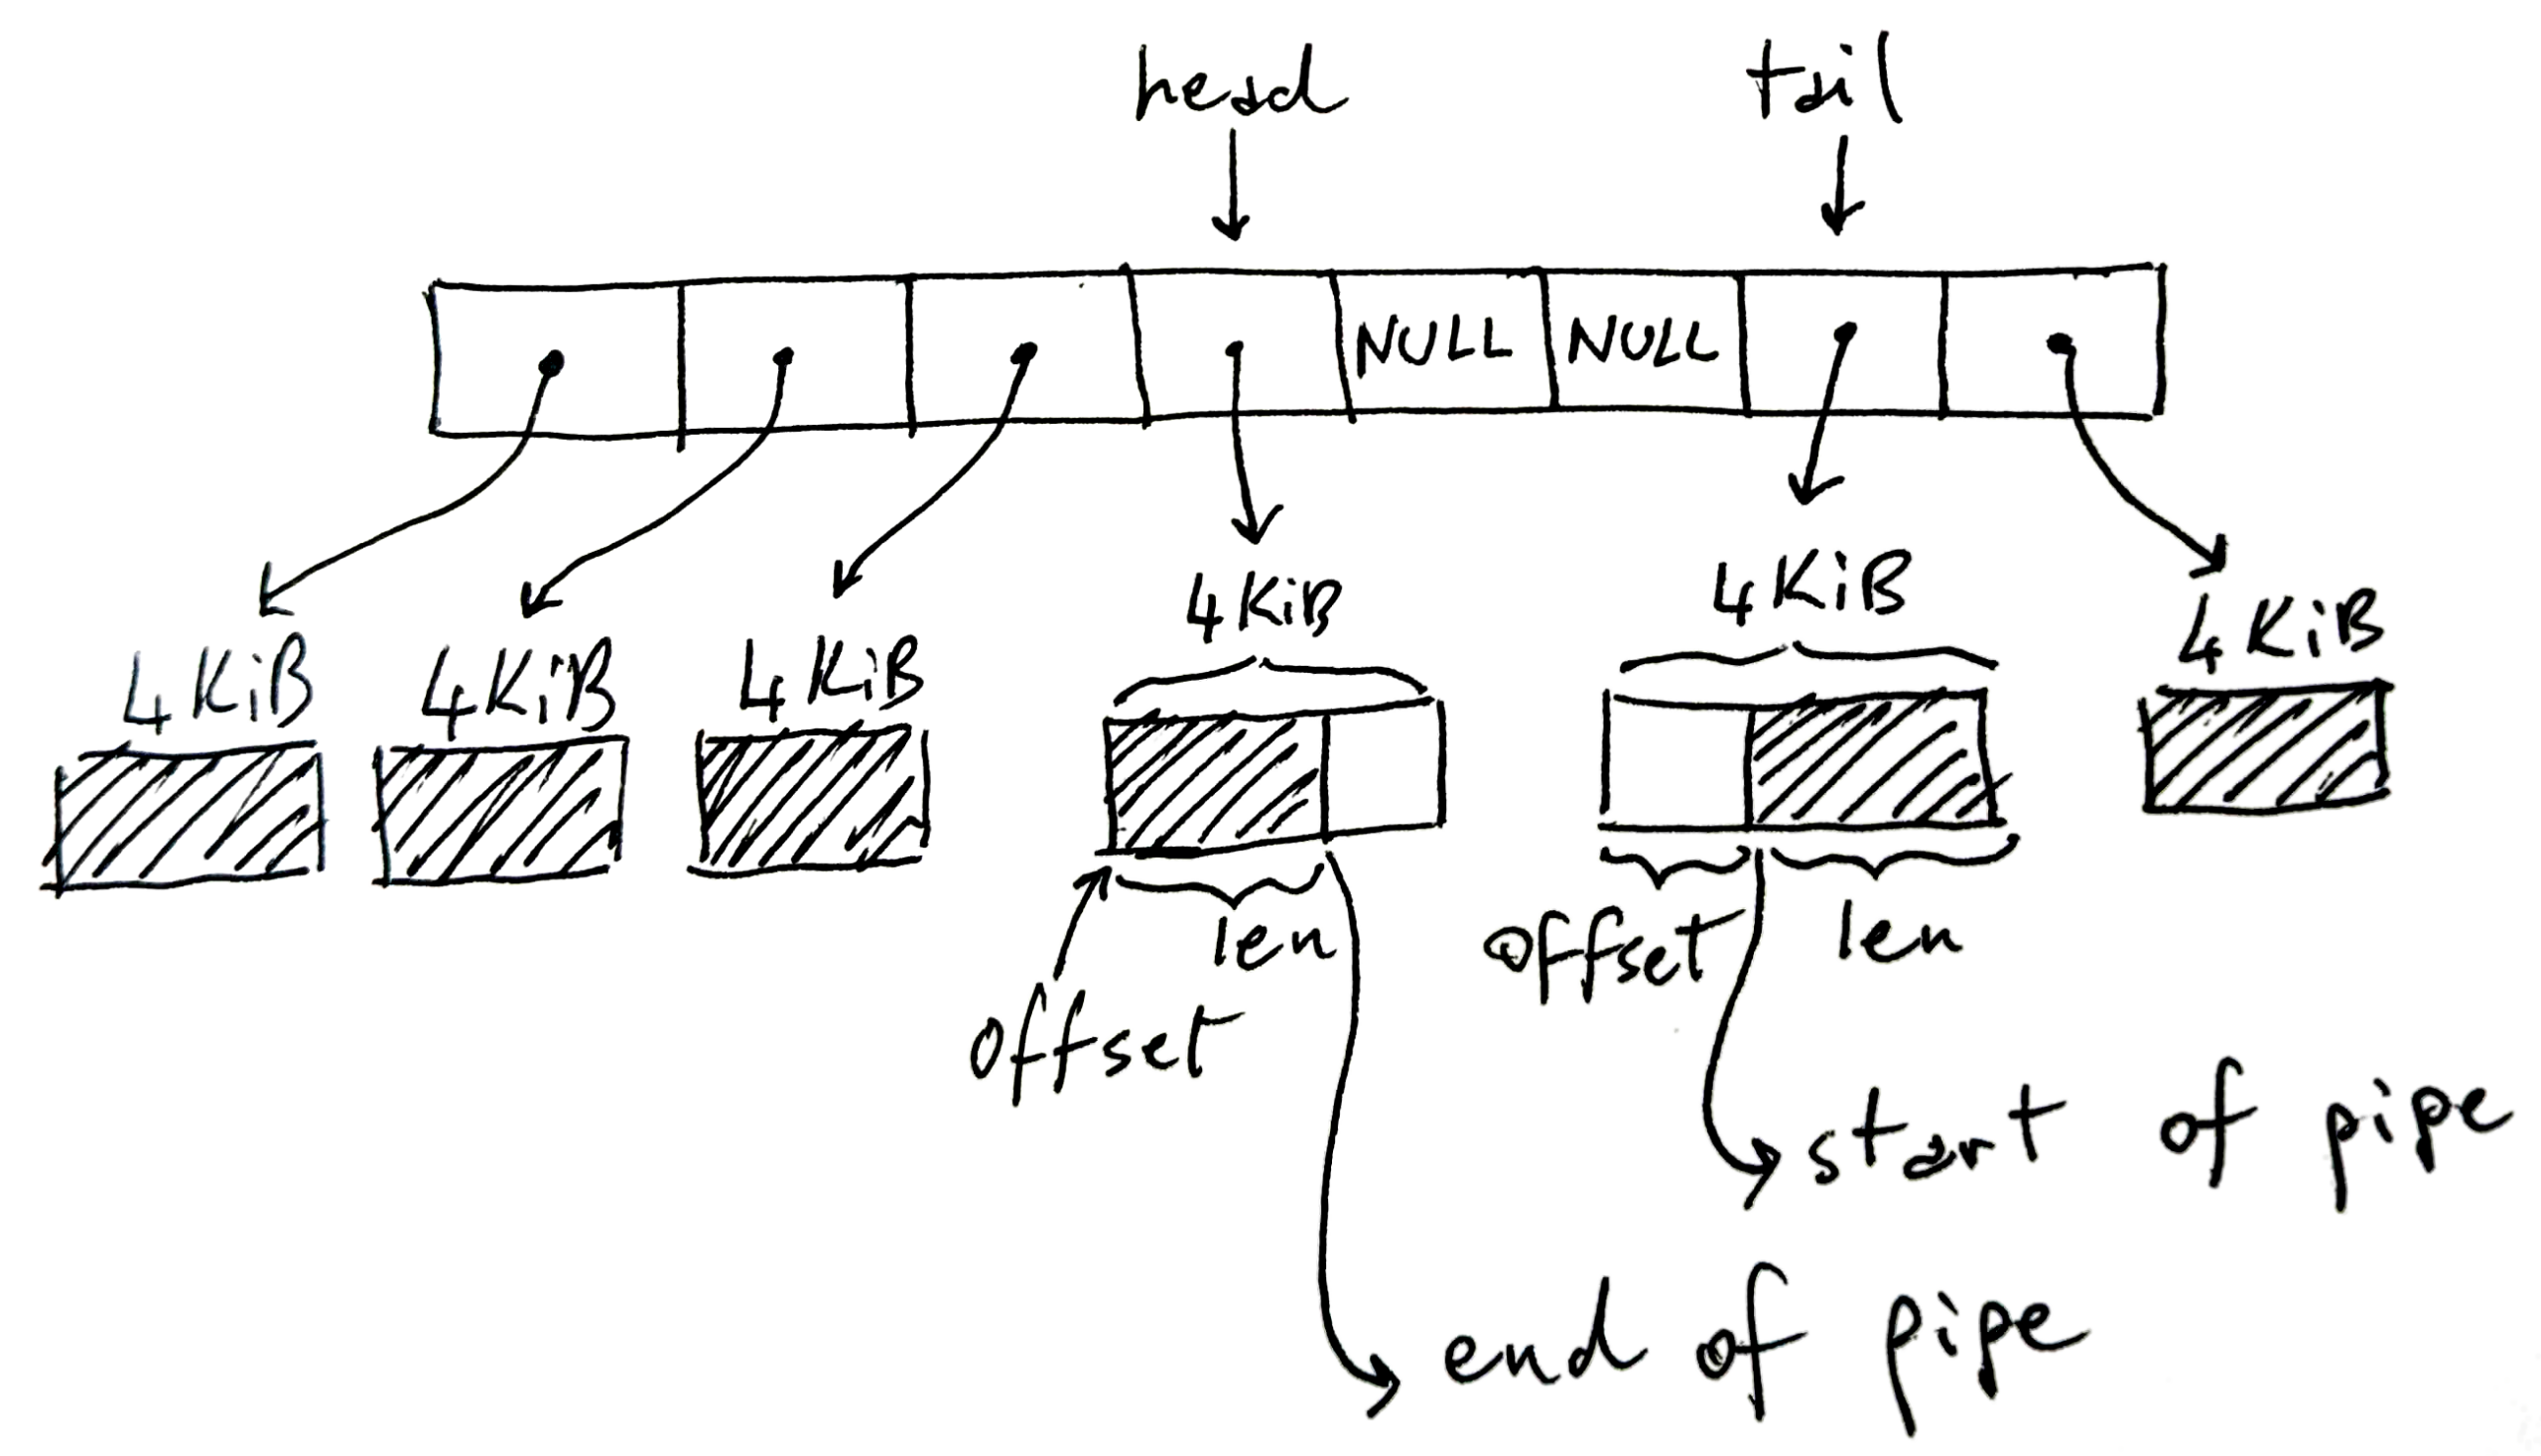
Auf der Implementierungsebene ist die Unterstützung für die Pipelines in der Linux Kernelnicht in der Shell. Der Befehlsinterpreter (bash, zsh usw.) erstellt die Pipeline lediglich durch Systemaufrufe wie z. B. pipe() y fork()Die Dateideskriptoren werden umgeleitet und anschließend die einzelnen Programme gestartet. Die eigentliche Magie, wie Prozesse blockiert werden, wie der Puffer verwaltet wird und wie Daten zwischen Produzent und Konsument weitergegeben werden, wird vom Systemkernel gesteuert.
stdin, stdout und Datenfluss verstehen
Für die effektive Arbeit mit Pipelines ist es unerlässlich zu verstehen, was stdin, stdout und stderr sind . Es handelt sich dabei nicht um abstrakte Konzepte: Jeder Prozess in Linux beginnt mit drei offenen Dateideskriptoren, die auf spezifische, vom Kernel verwaltete Ressourcen verweisen.
stdin (Deskriptor 0) und stdout (Deskriptor 1) können als Byteströme betrachtet werden, die mit etwas verbunden sind: beispielsweise mit einem Terminal, einer Datei, einem Netzwerk-Socket oder einer Pipe. Sie sind nicht einfach nur Puffer, sondern Referenzen auf Kernel-Objekte ( Dateistrukturen ), die wiederum mit Inodes, Sockets oder internen Pipe-Strukturen verknüpft sind.
Jeder Prozess hat seine eigenen Deskriptoren, so dass jeder Befehl in einer Pipeline Es betrachtet stdin und stdout unabhängig voneinander. In einer Zeile wie ls | grep txt | wc -list die ls in eine Pipe schreiben, grep Es liest aus einer Leitung und schreibt in eine andere, wc Lesen Sie von der letzten Zeile. Für den Benutzer erscheint sie als ein einzelner String, intern sind sie jedoch … mehrere verkettete Kernelpufferwobei jeder Prozess je nach verfügbarem Speicherplatz oder Datenvolumen blockiert und fortgesetzt wird.
Wenn der erste Prozess Daten schneller erzeugt, als der zweite sie verarbeitet, füllt sich der Pipe-Puffer. Dann werden nachfolgende Schreibvorgänge zurückgesendet, wodurch der sendende Prozess blockiert wird, bis der verarbeitende Prozess... Lesen Sie ausreichend Informationen und gibt Speicherplatz frei. Dadurch wird verhindert, dass der Speicherverbrauch unkontrolliert ansteigt; Daten häufen sich nicht unbegrenzt an, es sei denn, Sie verwenden nicht-blockierende E/A oder spezielle Signale. Zum Beispiel in einem Fall wie dd if=/dev/sda | gzip -9und gzip wird langsamer komprimiert, dd Er ist gezwungen zu warten.
Dieser Gegendruckmechanismus sorgt für eine hohe Stabilität der Pipelines, selbst wenn Leistungsunterschiede zwischen den einzelnen Stufen bestehen. Dies spiegelt sich auch im Design von CI/CD-Pipelines wider , wo die langsamen Stufen zum Flaschenhals werden, der gemessen und optimiert werden muss.
Praktische Anwendung von Pipes im Linux-Terminal
Im alltäglichen Gebrauch werden Pipes verwendet, um Befehle in einer einzigen Zeile zu verketten und Daten schrittweise zu transformieren. Anstatt einen Befehl auszuführen, die Ausgabe zu betrachten, sie zu kopieren und in einen anderen Befehl einzufügen, lassen sich kleine, hochflexible „Datenfabriken“ in Klartext erstellen.
Ein typisches Beispiel in Unix-Umgebungen ist die Kombination des Befehls fortune, das zufällige Zitate anzeigt, mit cowsaywas eine "sprechende" Kuh ausgibt. Bei Verwendung einer Pipe, Fortunes Abgang wird zu Cowsays BotschaftAlles mit einem einzigen Befehl. Es ist ein spielerisches Beispiel, aber es veranschaulicht perfekt die Idee, einfache Werkzeuge für komplexere Aufgaben zu verbinden.
Ein weiterer Klassiker ist es, das Ergebnis von ls a wc Zeilen, Wörter und Zeichen zählen. Etwa so: ls | wc Es ermöglicht Ihnen, schnell zu sehen, wie viele Artikel gelistet sind. Der Vorteil ist, dass Sie kein einzelnes Programm für alles benötigen, sondern... Sie entwickeln Lösungen mit kleinen, gut konzipierten Hilfsprogrammen..
Es ist auch sehr üblich, Ketten zu bilden cat, sort y more (oder ein anderes Paging-Tool) kann verwendet werden, um eine Textdatei zu sortieren und anschließend seitenweise zu durchsuchen. Mithilfe einer Pipe wird der Inhalt von einem Befehl zum nächsten weitergeleitet, ohne in expliziten temporären Dateien gespeichert zu werden. Dies vereinfacht die Skripterstellung und administrative Aufgaben erheblich.
In praktischen Anwendungsfällen, wie der Verarbeitung von Schülerlisten und Noten in separaten Dateien, können Sie Folgendes verwenden: paste Spalten zusammenführen, cut Sie können nur die Felder auswählen, die Sie interessieren, und mithilfe von verketteten Pipes alles in einer einzigen Zeile Shell-Skript filtern, sortieren oder transformieren. Dieses Muster Ein großes Problem in einfache Befehle zerlegen, die mit Pipes kombiniert werden Das ist die Essenz der Unix-Philosophie.
Erweiterte Befehle zur optimalen Nutzung von Pipes: tee, xargs und cpio
Wenn man in Linux wirklich mit der Automatisierung beginnt, gewinnen Pipes dank einiger wichtiger Tools noch mehr an Leistungsfähigkeit. Dazu gehören: tee, xargs y cpiodie den Standarddatenfluss sehr gut ergänzen.
Der Befehl tee Es verhält sich wie ein „T“ in einer Wasserleitung: Es liest von stdin, schreibt nach stdout und kopiert diese Ausgabe zusätzlich in eine oder mehrere Dateien. Es ist ideal, wenn Sie möchten Die Ausgabe auf dem Bildschirm anzeigen und gleichzeitig speichern. um es später zu prüfen oder in einem anderen Schritt zu bearbeiten. Mit der Option -a Es fügt Daten am Ende der Datei hinzu, anstatt sie zu überschreiben.
Zum Beispiel können Sie eine Liste sortieren mit sortSende das Ergebnis an tee um es in einem Protokoll zu speichern und gleichzeitig an more um es zu paginieren. Auf diese Weise erhalten Sie in einem einzigen Arbeitsgang Sortierung, Speicherung auf der Festplatte und bequeme Anzeige, ohne den Sortiervorgang wiederholen zu müssen.
Der Befehl xargs Es ist ein weiterer grundlegender Bestandteil von Pipes. Seine Funktion besteht darin, die über stdin eingehenden Daten (üblicherweise eine Liste von Elementen) in Argumente für einen anderen Befehl umzuwandeln. Es ist besonders nützlich, wenn ein Programm abstürzt, weil es zu viele Parameter auf einmal empfängt, oder wenn man … Die Arbeit in Abschnitte unterteilen mit der Option -n, wodurch die Anzahl der Argumente, die pro Ausführung übergeben werden, begrenzt wird.
Zum Beispiel mit ls | xargs -n 4 Sie teilen die Dateiliste in Vierergruppen auf und führen den Zielbefehl aus (standardmäßig echo(oder die von Ihnen angegebene) mehrmals. Auf diese Weise können Sie Pipelines wie „Vorschau der zu löschenden Elemente“ durch Kombination erstellen. ls, xargs y echo rm vor dem eigentlichen Wipe.
Vorsicht bei komplexen Eingaben: Pfade mit Leerzeichen oder Sonderzeichen kann das Standardverhalten von xargsIn diesen Fällen wird es üblicherweise in Kombination mit find und die Option -print0, das Elemente durch ein Nullzeichen trennt, zusammen mit xargs -0 sodass an beiden Enden dasselbe robuste Trennzeichen verwendet wird.
Schließlich cpio Es ist ein weniger bekannter Befehl als tarEs ist aber unglaublich flexibel für die Arbeit mit Dateiströmen über Pipes. Im Gegensatz zu tar ist es von Grund auf für den Betrieb mit Pipes konzipiert. Umleitungen und Pipes: empfängt eine Liste von Dateien über stdin (normalerweise generiert mit find) und erzeugt oder verbraucht Dateien vom Typ „Paket“ ohne eigene Komprimierung, die Sie dann mit komprimieren können gzip oder ähnliches.
Die Hauptmodi von cpio Dateien erstellen erlauben (-o), Verzeichnisstrukturen kopieren (-p) oder Inhalte extrahieren (-i(oft auch als „Copy-in“ bezeichnet). Optionen wie z. B. -u zum Überschreiben -m um Zeitstempel zu erhalten oder -d Die Wiederherstellung der Verzeichnisstruktur ermöglicht Folgendes: im Detail kontrollieren, was kopiert wird und wie, besonders nützlich in komplexen Skripten, wo tar greift zu kurz.
Entwurf und Optimierung von CI/CD-Pipelines auf Linux-Servern
Über die traditionelle Kommandozeile hinaus ist das Pipeline-Konzept in der Welt der kontinuierlichen Integration und kontinuierlichen Bereitstellung (CI/CD) grundlegend geworden . Auf einem Linux-Server ist eine CI/CD-Pipeline eine automatisierte Abfolge von Schritten: Code abrufen, Abhängigkeiten installieren, kompilieren, Tests ausführen, Artefakte verpacken und bereitstellen.
Linux eignet sich hierfür besonders gut, da es sich durch seine Geschwindigkeit, Stabilität und sein umfangreiches Ökosystem an Automatisierungstools auszeichnet . Plattformen wie Jenkins, GitHub Actions und GitLab CI nutzen Linux-Executors (physische Maschinen, virtuelle Maschinen oder Container), um Pipelines konsistent auszuführen.
Die Optimierung dieser Pipelines bedeutet nicht nur, dass sie funktionieren, sondern dass sie möglichst reibungslos funktionieren. Das heißt: Checkout-Zeiten verkürzen, wiederholte Installationen von Abhängigkeiten minimieren, Docker-Images optimieren, um unnötige Neuinstallationen zu vermeiden, bereits generierte Artefakte wiederverwenden und die Umgebung sicher und transparent gestalten.
Eine bewährte Vorgehensweise ist die Strukturierung der Pipeline in klar definierte Phasen: Build, Test und Deployment . Idealerweise sollte man nur einmal kompilieren, ein Artefakt (Binärdatei, Paket, Docker-Image) generieren, das parallel in verschiedenen Varianten (z. B. verschiedenen Sprachversionen) getestet wird, und anschließend dasselbe Artefakt ohne erneute Kompilierung in Staging- und Produktionsumgebungen bereitstellen.
Die Arbeit mit unveränderlichen Artefakten, die in Repositories (S3, Nexus, Artifactory, Container-Registries oder in GitLab/GitHub eingebettete Pakete) gespeichert sind, vereinfacht die Überprüfung, ermöglicht schnelle Versions-Rollbacks und verringert die Wahrscheinlichkeit von „Es funktioniert auf meinem Rechner, aber nicht in der Produktion“.
Voraussetzungen: Distribution, CI-Benutzer und Serverhärtung
Bevor man sich in Details der Millisekundenoptimierung verliert, ist es wichtig, eine stabile Grundlage auf dem Linux-Server zu schaffen , der als CI/CD-Executor fungieren soll. Dies beginnt mit der Wahl der Distribution und der minimalen Sicherheitskonfiguration.
Am sinnvollsten ist es in der Regel, sich auf eine LTS- oder stabile Distribution festzulegen , mit der das Team vertraut ist: Ubuntu LTS, Debian Stable oder Enterprise-Alternativen wie AlmaLinux oder Rocky Linux. Wenn alle Systeme dieselbe Version verwenden, werden unerwartete Verhaltensweisen vermieden, die durch unterschiedliche Bibliotheken oder Kernel zwischen den Jobs verursacht werden könnten.
Eine weitere Empfehlung ist die Konfiguration eines dedizierter Benutzer für CI, ohne Root-Rechte, mit sudo stark eingeschränkt auf nur die wichtigsten Befehle (zum Beispiel, systemctl o docker (Falls dies unbedingt erforderlich ist). Dieser Benutzer muss sich mittels SSH-Schlüsseln authentifizieren, sowohl für den Zugriff auf den Server als auch für die Interaktion mit Git-Repositories oder anderen entfernten Rechnern.
Auf Systemebene ist es ratsam, den Server zu warten. aktualisiert und minimal verstärktDies umfasst das Einspielen von Sicherheitsupdates, das Konfigurieren einer restriktiven Firewall (z. B. mit UFW: Blockieren des gesamten eingehenden Datenverkehrs außer dem notwendigen und Zulassen des ausgehenden Datenverkehrs) und das Aktivieren von Tools wie fail2ban um Brute-Force-Angriffe auf SSH zu stoppen und einige Netzwerk- und Kernelparameter anzupassen über sysctl zur Verbesserung von Zuverlässigkeit und Leistung.
Beispielsweise ist es üblich, das Limit von annotieren um zu verhindern, dass Build-Systeme, die viele Dateien überwachen, nicht mehr genügend Ressourcen haben, und passen Sie den Parameter an vm.swappiness um den Kernel beim Auslagern von Speicher sparsamer zu machen, was insbesondere dann relevant ist, wenn CI-Jobs viel Speicher auf einmal verbrauchen.
Caches, Docker und Parallelisierung: Die Leistungshebel in CI/CD
Betrachtet man den tatsächlichen Zeitablauf in einer durchschnittlichen Pipeline, stellt man fest, dass ein Großteil für die Installation von Abhängigkeiten und das Neuerstellen von Docker-Images verloren geht . Die Behebung dieses Problems ist in der Regel effektiver als die Optimierung des Testcodes um wenige Millisekunden.
Der erste Hebel ist das Caching von Abhängigkeiten . Fast alle Abhängigkeitsmanager (pip, npm, Maven, Gradle, Go-Module usw.) verwenden lokale Cache-Verzeichnisse. Auf einem persistenten Linux-Server können diese Verzeichnisse zwischen Jobs geteilt oder auf einem persistenten Volume eingebunden werden. Dadurch muss nicht bei jeder Ausführung die halbe Internetmenge erneut heruntergeladen werden.
Für Docker aktivieren BuildKit und gut strukturieren Dockerfile Dies markiert einen Wendepunkt. Indem die Installation der Abhängigkeiten direkt nach dem Kopieren der requirements.txt-Datei und vor dem restlichen Code erfolgt, wird sichergestellt, dass Ebenen wiederverwendet werden, solange die Versionen der Abhängigkeiten unverändert bleiben. Darüber hinaus können spezifische Caches für pip, npm usw. direkt im Build-Prozess eingerichtet werden.
Der zweite wichtige Hebel ist der parallele TestausführungViele Frameworks unterstützen Parallelverarbeitung nativ: pytest mit -n autoJava-Tools wie Surefire, Jest in JavaScript mit --maxWorkersusw. Durch die Aufteilung der Testsuite nach Modulen, Ordnern oder sogar nach geschätzter Zeit und die Verteilung auf mehrere Mitarbeiter kann die Dauer der Testphase um das Zwei- bis Fünffache reduziert werden, ohne dass sich ein einziger Geschäftsbereich ändert.
Schließlich stellt sich die Frage nach Artefakten und Deployment . Anstatt für Staging, Vorproduktion und Produktion dasselbe Image neu zu kompilieren, ist es effizienter, es einmal zu erstellen, das Ergebnis in einem Repository zu speichern und es entsprechend der Deployment-Umgebung zu taggen. Dies reduziert die CPU-Auslastung, vermeidet Inkonsistenzen und beschleunigt lange Pipelines erheblich.
Optimierung von Jenkins, GitHub Actions und GitLab Runner unter Linux
Jedes CI-System hat seine Eigenheiten, aber alle profitieren unter Linux von denselben Grundprinzipien. Der Schlüssel liegt in der Regel in der Verwendung kurzlebiger und sauberer Executors , der Aufrechterhaltung eines ausreichend großen persistenten Caches und der Kontrolle der Parallelität.
In Jenkins ist es üblich, schlanke, temporäre Agenten (wie Docker-Container oder Pods in Kubernetes oder anderen Container- Orchestrierungslösungen ) zum Ausführen von Jobs zu verwenden und den Master-Knoten so einfach wie möglich zu halten. Diese Agenten können als systemd-Dienste auf Linux-Servern konfiguriert werden, registrieren sich beim Controller und starten automatisch beim Systemstart.
Für GitHub Actions mit selbstgehosteten Runnern wird empfohlen, diese in folgendem Verzeichnis bereitzustellen: Linux-VMs mit schnellen SSDsUm ein großes Cache-Verzeichnis für Aktionen (Sprachabhängigkeiten, Build-Caches usw.) zu erstellen, begrenzen Sie die Anzahl gleichzeitiger Jobs, um eine Überlastung von CPU und Festplatte zu vermeiden. Nutzen Sie die offizielle Caching-Funktion mit Pfaden wie beispielsweise ~/.cache/pip, ~/.npm o ~/.m2 Das macht einen enormen Zeitunterschied.
In GitLab Runner hängt die Wahl zwischen Shell-Executor und Docker vom gewünschten Verhältnis zwischen Leistung und Isolation ab. Der Shell-Executor ist schneller, da er direkt auf dem Host ausgeführt wird, während der Docker-Executor saubere und reproduzierbare Umgebungen bietet. Sie können außerdem gemeinsames Caching (lokal oder auf S3) konfigurieren und die maximale Anzahl gleichzeitiger Jobs anpassen, um die Hardware optimal zu nutzen, ohne sie zu überlasten.
In all diesen Fällen ist die Verwendung gemeinsam genutzter Volumes für das Caching von Abhängigkeiten und die Vermeidung überfüllter Arbeitsbereiche zwischen den Builds entscheidend. Kurzlebige Maschinen oder Container, die mit jeder Pipeline oder Pipeline-Gruppe erstellt und wieder gelöscht werden, reduzieren das Problem „Gestern funktionierte es noch, heute nicht mehr“, das durch Überreste vorheriger Builds verursacht wird, erheblich.
Linux-Serverleistung: CPU, Speicher, E/A und Docker
Egal wie optimiert Ihre Skripte sind, wenn der Linux-Server, auf dem die Pipeline läuft, nicht ausreichend dimensioniert ist, werden Sie mit endlosen Warteschlangen und langsam ablaufenden Prozessen konfrontiert. Eine typische, sinnvolle Konfiguration für einen Rechner der Mittelklasse umfasst 4–8 vCPUs und 8–16 GB RAM , dazu SSD-Speicher (idealerweise NVMe) und etwas Swap-Speicher (2–4 GB), um Lastspitzen abzufangen, ohne Prozesse aggressiv zu beenden.
Das Dateisystem ist ebenfalls wichtig. Verwenden Sie ext4 oder XFS mit der Option noatime Reduzieren Sie in den Volumes, in denen Sie kompilieren oder Protokolle schreiben, unnötige E/A-Operationen. Zusätzlich sollte das Mounten eines tmpfs für temporäre Dateien oder kurzlebige Artefakte (zum Beispiel, /mnt/ci-tmp) beschleunigt rechenintensive Vorgänge und verhindert, dass sich die Festplatte zwischen den Aufträgen mit Restdateien füllt.
Bei Docker ist die Hygiene des Daemons entscheidend. Das sichere und regelmäßige Entfernen ungenutzter Images und Volumes bei gleichzeitiger Beibehaltung der häufig genutzten Basis-Images trägt dazu bei, Festplattenspeicher und Bootzeiten kontrollieren. Befehle wie docker system prune Mit geeigneten Zeitfiltern ermöglichen sie eine Reinigung, ohne die kürzlich genutzten Ressourcen zu überlasten.
Bei containerintensiven CI-Prozessen können Sie gespiegelte Register verwenden , um ständige Downloads aus dem Internet zu vermeiden, BuildKit für Parallelverarbeitung und Layer-Caching nutzen und sogar CPU-Affinitäten (CPU-Sets) oder dedizierte Knoten für die anspruchsvollsten Executors konfigurieren, um Interferenzen zwischen benachbarten Workloads zu verhindern. Darüber hinaus hilft Ihnen das Verständnis der CPU-Mikroarchitektur, die Ressourcen für intensive CI-Workloads besser zu dimensionieren.
Sicherheit in der Entwicklungspipeline (DevSecOps) und Bereitstellungen auf Linux
Eine schnelle, aber unsichere Pipeline ist eine tickende Zeitbombe. Die Integration von Sicherheit in die Pipeline selbst und die Sicherheit von Docker-Containern gehören heute zum Standard jeder DevSecOps-Strategie, und Linux bietet hierfür zahlreiche Tools.
Das Wichtigste ist, Geheimnisse und Zugangsdaten mit größter Sorgfalt zu behandeln . Sie dürfen niemals im Code oder in versionierten Konfigurationsdateien gespeichert werden. Stattdessen werden sie in Geheimnismanagern (z. B. GitLab-Maskierungsvariablen, GitHub-Verschlüsselung, HashiCorp Vault) verwaltet und nur während der Ausführung des jeweiligen Jobs, der sie benötigt, mithilfe kurzlebiger Tokens injiziert.
Ein weiterer wichtiger Aspekt ist die Generierung von SBOMs (Software Bill of Materials) und die Signierung der Artefakte. Tools wie Syft oder CycloneDX ermöglichen die Auflistung aller Komponenten eines Images oder einer Binärdatei, während Cosign oder andere verifizierbare Signaturlösungen sicherstellen, dass nur validierte Artefakte bereitgestellt werden.
Im Hinblick auf Netzwerk und Zugriff empfiehlt es sich, CI- und Produktionsnetzwerke zu trennen , strenge Firewalls zu implementieren, Ausführungsprotokolle zu überwachen und Zugangsdaten regelmäßig zu ändern. Bei Verwendung von SSH sollten Zertifikate oder Schlüssel mit Ablaufdatum anstelle statischer Passwörter eingesetzt werden.
Bei der Bereitstellung unter Linux reduzieren Strategien wie Blue/Green, Rolling Release und Canary Release die Auswirkungen von Bereitstellungsfehlern erheblich. Durch den Betrieb der Anwendung als systemd-Dienst, die Vorschaltung eines Nginx- oder HAProxy-Servers und die Steuerung des Datenverkehrs zwischen den Versionen mittels Integritätsprüfungen lässt sich eine nahezu vollständige Ausfallzeit während Updates erreichen.
Beispielsweise beim Neuladen von Nginx und Neustarten von Diensten mit systemd unter Verwendung von Soft-Stop-Signalen (wie z. B. SIGTERMBei angemessenen Wartezeiten können Sie aktive Verbindungen abbauen, bevor der Prozess beendet wird, sodass die Benutzerfreundlichkeit erhalten bleibt, während Sie im Hintergrund die Versionen wechseln.
Beobachtbarkeit, Metriken und Kosten in Linux-Pipelines
Sobald Ihre Pipelines eingerichtet und betriebsbereit sind, gilt es, sie zu messen und zu verstehen, wohin Zeit und Ressourcen fließen . Es genügt nicht zu wissen, ob ein Workflow erfolgreich ist oder fehlschlägt; Sie müssen die Dauer jeder Phase, die Wartezeit in der Warteschlange, die Erfolgsrate, die Bereitstellungshäufigkeit, die Cache-Trefferrate usw. überwachen.
Es ist üblich, Systemmetriken zu exportieren. node_exporterZentralisieren Sie Protokolle mit Lösungen wie ELK oder Loki und visualisieren Sie alles in Grafana-Dashboards. So können Sie beispielsweise erkennen, ob sich die Testphase in der letzten Woche um 30 % verlängert hat oder ob Jobs zu viel Zeit mit Warten auf einen verfügbaren Executor verbringen; Netzwerkverkehrsüberwachung Open-Source-Tools ergänzen diese Transparenz.
Es ist auch möglich, die Pipeline selbst zu instrumentieren, beispielsweise in GitHub Actions oder GitLab CI, um programmatisch zu messen, wie viele Ausführungen erfolgreich waren, wie lange jeder Durchlauf gedauert hat und wie der Gesamtstatus istEin Skript, das die API des Anbieters aufruft, die Gesamtzahl der Durchläufe, die Anzahl der erfolgreichen Durchläufe, die Anzahl der fehlgeschlagenen Durchläufe, die Erfolgsquote und die durchschnittliche Dauer berechnet und alles in einer JSON-Datei speichert (wie z. B. pipeline-metrics.json) ermöglicht es Ihnen, diese Kennzahlen in Berichte oder Dashboards zu integrieren.
Anhand dieser Informationen können Sie Entscheidungen über die Größe und Anzahl der Runner treffen : Manchmal ist es besser, viele kleine Runner anstelle weniger sehr großer zu verwenden, um Wartezeiten zu reduzieren. Automatische Skalierbarkeit – beispielsweise Cloud-Autoscaling oder dynamische Pools von Kubernetes-Knoten – hilft, Lastspitzen tagsüber abzufangen und ungenutzte Ressourcen nachts zu minimieren.
Diese Vorgehensweisen verbessern nicht nur die Arbeitserfahrung des Teams, sondern tragen auch zur Senkung der Infrastrukturkosten bei, indem sie die Nutzung von CPU, Arbeitsspeicher und insbesondere Speicherplatz kontrollieren, der bei Bildern und Caches oft sprunghaft ansteigt, wenn diese nicht regelmäßig und planmäßig bereinigt werden.
Die Beherrschung sowohl klassischer Kommandozeilen-Pipes als auch moderner CI/CD-Pipelines unter Linux bietet eine leistungsstarke Kombination: Sie können alles automatisieren – von einfachen Textfilteraufgaben bis hin zu komplexen, wartungsfreundlichen, sicheren und schnellen Build-, Test- und Deployment-Pipelines. Das Verständnis des Informationsflusses zwischen Prozessen, der Zwischenspeicherung von Abhängigkeiten, der Serveroptimierung und der Integration von Metriken und Sicherheit ermöglicht es Ihnen, Workflows zu entwickeln, die mit Ihrem Team und Ihren Projekten skalieren, ohne zu einem ständigen Flaschenhals zu werden.
