- La microarchitettura definisce il modo in cui una CPU implementa un'architettura ISA e ne determina l'IPC, il parallelismo interno e l'efficienza effettiva, al di là della frequenza o della dimensione della cache.
- Architetture come AMD Zen e Zen 2 combinano cache ottimizzate, esecuzione fuori ordine, SMT e unità vettoriali di grandi dimensioni per incrementare le prestazioni per ciclo e per watt.
- La strategia basata su chiplet e Infinity Fabric consente di aumentare il numero di core nei processori EPYC e Ryzen, mantenendo al contempo costi contenuti e prestazioni altamente competitive.
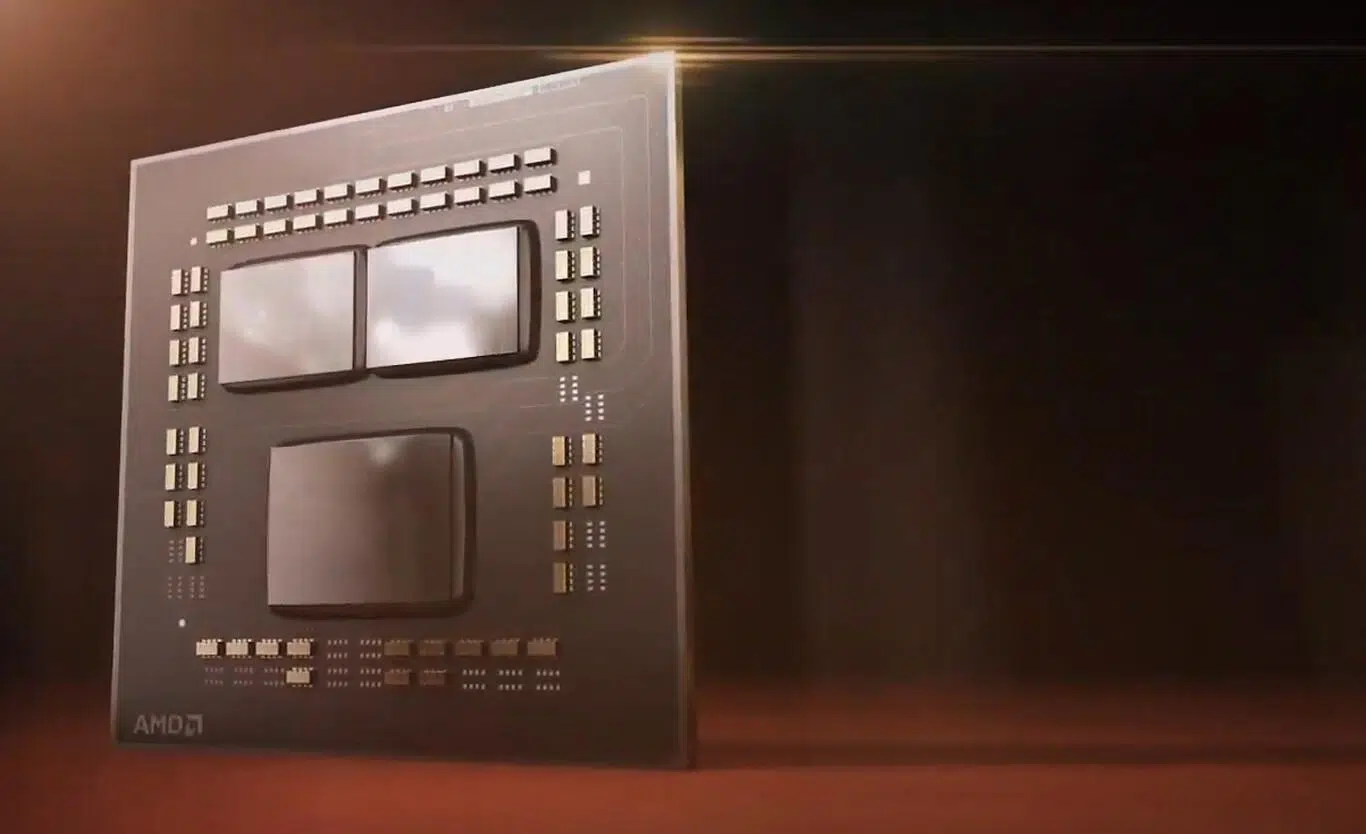
Spesso la microarchitettura di una CPU passa in secondo piano rispetto a cifre più appariscenti come GHz o MB di cache, ma è proprio lì, nella progettazione interna del processore, che si determinano la maggior parte delle sue prestazioni reali, la sua efficienza e persino il tipo di software che può sfruttarla al meglio.
Quando si leggono le specifiche tecniche che menzionano core, thread, cache L3 o AVX2 , si stanno in realtà osservando le conseguenze concrete di una particolare microarchitettura. Comprendere come questi componenti sono organizzati internamente, cosa distingue uno Zen 3 da uno Zen 2, o un processore ibrido Intel da un classico Ryzen, è fondamentale per scegliere con cognizione di causa la propria prossima CPU e capire perché alcune eccellono nel gaming, altre nel rendering e altre ancora nelle attività server.
ISA, macroarchitettura e microarchitettura: mettere ordine ai concetti
Prima di addentrarci nelle complessità delle pipeline e dei predittori, è utile distinguere tra tre livelli spesso confusi: macroarchitettura di sistema, ISA e microarchitettura . Ciascuno descrive un diverso strato del computer.
Da un lato, c'è la macroarchitettura, ovvero la progettazione complessiva del sistema , che comprende tutto ciò che si vede sulla scheda madre: CPU, controller di memoria, bus, memoria principale, chip di input/output, controller di archiviazione, eventuali acceleratori esterni e logica DMA. Si tratta di una rappresentazione di alto livello di come i principali componenti hardware si connettono e di come i dati fluiscono tra di essi.
Al di sopra di questo si trova l' ISA (Instruction Set Architecture) , ovvero il set di istruzioni che il processore comprende: i tipi di dati che gestisce, la dimensione della parola, il numero e il tipo di registri, le modalità di indirizzamento, i formati delle istruzioni, ecc. Quando si programma in linguaggio assembly utilizzando mnemonici come ADD, SUB, MUL o invocando estensioni come SSE, AVX o NEON, si comunica direttamente con l'ISA.
Infine, abbiamo il microcodice, o μISA , che definisce le micro-operazioni interne utilizzate da alcune architetture complesse (come x86) per implementare le istruzioni CISC. Questo microcodice può essere aggiornato tramite firmware per correggere bug o aggiungere il supporto per nuove istruzioni.
Che cos'è esattamente la microarchitettura di una CPU?
La microarchitettura della CPU è essenzialmente il progetto interno che determina come vengono eseguite le istruzioni ISA e come i dati si muovono all'interno del chip. Due processori possono condividere la stessa ISA (ad esempio, AMD64 in Intel e AMD) eppure presentare comportamenti e prestazioni radicalmente diversi a causa, o forse proprio per via, della loro microarchitettura.
Questo progetto include elementi quali il tipo di unità di controllo , se viene utilizzato un microcodice programmabile o una logica cablata; la gerarchia della memoria; la profondità della pipeline; quante unità funzionali lavorano in parallelo; e se il processore è in grado di eseguire le istruzioni fuori ordine e in modo speculativo.
Inoltre, il progettista deve scegliere la profondità della pipeline : dalle CPU semplici senza pipeline, in cui ogni istruzione viene elaborata dall'inizio alla fine prima di iniziare la successiva, ai progetti moderni con molte fasi (fetch, decode, rename, dispatch, execute, write-back, retire…) che consentono a decine di istruzioni di essere in esecuzione contemporaneamente.
A questo si collegano il numero e il tipo di unità di esecuzione : ALU per numeri interi, unità di moltiplicazione, divisori, FPU per numeri in virgola mobile scalari e vettoriali, AGU (unità di generazione indirizzi) per il calcolo degli indirizzi di memoria, unità di salto, ecc. Se sono presenti diverse unità dello stesso tipo, si parla di processori superscalari, capaci di eseguire più istruzioni per ciclo.
Questa è la base per tecniche avanzate come l'esecuzione speculativa , in cui la CPU anticipa la risoluzione di un ramo ed esegue in anticipo le istruzioni di uno dei rami. Se la previsione è corretta, si risparmia tempo; in caso contrario, il lavoro svolto viene scartato e la pipeline viene svuotata, con la relativa penalità.
La maggior parte delle moderne CPU ad alte prestazioni utilizza anche l'esecuzione fuori ordine (OoO) . Invece di attenersi rigorosamente all'ordine del programma, il processore riordina internamente le istruzioni ed esegue prima quelle i cui dati sono pronti, evitando cicli di inattività mentre altre istruzioni attendono la memoria o il risultato di operazioni precedenti.
Per far funzionare tutto ciò senza violare la semantica del programma, si utilizza la ridenominazione dei registri . Il compilatore vede un insieme limitato di registri logici, ma la microarchitettura li traduce in un banco più ampio di registri fisici, assegnando dinamicamente nuove destinazioni per eliminare le false dipendenze e consentire un maggiore parallelismo.
Infine, la progettazione può concentrarsi sull'aggiunta del parallelismo a livello di core e thread . Ciò include tutto, dalle CPU single-core ai chip con decine o centinaia di core (many-core), sistemi multiprocessore con più socket interconnessi da reti mesh ad alta velocità (Infinity Fabric, Intel Mesh, NVLink, ecc.) e supporto per il multithreading simultaneo (SMT) in modo che ogni core fisico possa gestire due o più thread logici.
Compatibilità, ISA e famiglie di microarchitetture
Poiché una microarchitettura è solo una specifica implementazione di un ISA , un singolo ISA può avere decine di microarchitetture diverse nel corso degli anni e presso diversi produttori. Questo è precisamente ciò che accade con x86-64/AMD64 o ARM.
Considerando esclusivamente i processori AMD all'interno dell'architettura AMD64, troviamo famiglie diverse come K8/Hammer, K10, Bulldozer e l'intera serie Zen (Zen, Zen+, Zen 2, Zen 3, Zen 4...). Tutti eseguono lo stesso set di istruzioni di base, ma la loro organizzazione interna, le cache, le pipeline e gli approcci all'esecuzione parallela sono completamente diversi.
Quando si passa da un'architettura ISA all'altra, il salto in termini di compatibilità è assoluto. Un processore basato su ARM A64 (come Apple Silicon) non può eseguire binari compilati per x86-64, e viceversa, a meno che non si utilizzi un livello di traduzione o emulazione come Rosetta 2, QEMU o simili, con il conseguente costo in termini di prestazioni.
Anche tra processori che condividono la stessa architettura ISA, non vi è alcuna garanzia che supportino tutti lo stesso set di istruzioni o le stesse estensioni. Un chip più vecchio potrebbe non supportare AVX2 o AVX-512, oppure un SoC ARM potrebbe implementare solo un sottoinsieme di estensioni opzionali. Pertanto, un eseguibile che fa un uso intensivo di AVX-512 potrebbe non avviarsi su una CPU che offre solo SSE4.
Durante la compilazione del software, è prassi comune generare binari generici per una specifica architettura (ad esempio, x86-64 con almeno SSE2) senza sfruttare appieno alcuna microarchitettura particolare, in modo che l'eseguibile funzioni sul maggior numero possibile di CPU. Tuttavia, se si compila con flag di ottimizzazione per una specifica microarchitettura (-march=znver3, -mtune=skylake, ecc.), è possibile migliorare significativamente le prestazioni su quella particolare famiglia di processori, a costo di perdere la compatibilità con le altre.
Licenze ISA e proprietà intellettuale del design
Non solo il codice sorgente dei programmi è protetto da licenze: anche le architetture ISA e le microarchitetture sono proprietà intellettuale. Nessuno può legalmente clonare un'architettura ISA x86 o AMD64 senza una licenza, così come non è possibile copiare il design proprietario di una CPU senza autorizzazione.
Nell'ambito delle ISA (Instruction Set Architecture), esistono tre approcci principali. Da un lato, ci sono le ISA chiuse , in cui il proprietario controlla rigorosamente chi può implementare core compatibili. L'esempio classico è IA-32 (x86-32), storicamente di proprietà di Intel, che ha concesso licenze ad AMD, VIA e altri, non senza battaglie legali.
Una situazione simile si verifica con AMD64/x86-64 , inizialmente progettato da AMD e successivamente concesso in licenza a Intel (che lo ha chiamato EM64T) tramite accordi di licenza incrociata. Anche altri produttori, come Hygon in Cina, hanno ottenuto licenze per versioni specifiche (ad esempio, Zen 1 per il mercato cinese).
Abbiamo poi le ISA con licenze flessibili , in cui il proprietario offre sia licenze ISA che core IP pronti per l'integrazione. ARM, SPARC o OpenPOWER rientrano in questa categoria: è possibile pagare per utilizzare Cortex A/M/R o Neoverse così come sono, oppure per una licenza che consente di progettare le proprie microarchitetture sopra l'ISA, come fa Apple con i suoi M1/M2/M3 o Qualcomm con il suo Kryo.
Infine, esistono le ISA open-source , in cui chiunque può creare microarchitetture compatibili senza pagare royalty per l'ISA (anche se è possibile brevettare o rendere privata la propria implementazione). RISC-V ne è l'esempio migliore: l'ISA è rilasciata sotto una licenza BSD permissiva e offre opzioni che vanno da kernel completamente open source in Verilog o Chisel a progetti commerciali chiusi.
Oltre all'ISA, ogni specifica microarchitettura (un core Zen 4, un Cortex X4, un progetto GPU, ecc.) rappresenta un blocco di proprietà intellettuale brevettata o registrata. Sono presenti anche progetti open source, pubblicati come soft core in HDL per la sintesi in FPGA o l'integrazione in SoC personalizzati.
Un'analisi più approfondita delle microarchitetture moderne: il caso AMD Zen
Per capire come tutto ciò si traduca in prestazioni reali, non c'è niente di meglio che analizzare una specifica famiglia di prodotti. AMD ha trasformato radicalmente il suo business grazie a Zen e alle sue successive iterazioni , passando dalla difficile era Bulldozer e dai vecchi processori FX a competere direttamente (e talvolta persino superare) Intel nei mercati dei desktop, dei server e dei laptop.
Dopo il fallimento della strategia AMD Fusion , l'azienda si è ristrutturata e ha optato per un design ad alte prestazioni guidato, tra gli altri, da Jim Keller. Il piano Zen mirava ad aumentare drasticamente l'IPC (istruzioni per ciclo) rispetto a Bulldozer, migliorare le prestazioni per watt e recuperare terreno nelle prestazioni single-core, settore in cui Intel aveva detenuto un primato per anni.
Uno dei cambiamenti chiave è stato il rafforzamento del front-end , la parte responsabile del recupero e della preparazione delle istruzioni. Zen ha introdotto una cache di micro-operazioni che memorizza le micro-operazioni già decodificate, in modo simile a quanto fatto da alcune microarchitetture Intel come Conroe. Bulldozer non disponeva di questa funzionalità e si affidava maggiormente alla classica gerarchia della cache delle istruzioni, il che ha influito negativamente sulla sua velocità di elaborazione.
Il decodificatore di Zen può tradurre fino a quattro istruzioni CISC x86-64 per ciclo in micro-operazioni di tipo RISC. Queste micro-operazioni vengono quindi inserite in una coda alimentata dal buffer delle micro-operazioni, che a sua volta può inviare fino a sei micro-operazioni per ciclo agli scheduler di back-end. È qui che inizia l'esecuzione fuori ordine.
AMD ha separato nettamente i percorsi per le operazioni con numeri interi e a virgola mobile . Per quanto riguarda le operazioni con numeri interi, le ALU, le AGU e la logica di caricamento/memorizzazione vengono alimentate dalla coda delle micro-operazioni. Questa logica è in grado di eseguire due caricamenti da 16 byte e una memorizzazione da 16 byte per ciclo da una L1D a 8 vie da 32 KB, con una politica di scrittura inversa.
La parte a virgola mobile e vettoriale alimenta le unità FMAC e AVX. Grazie a due porte di moltiplicazione e due porte di addizione, Zen può eseguire simultaneamente due operazioni FMA a 128 bit o un'operazione AVX a 256 bit per ciclo di clock. Questo parallelismo a livello di istruzioni è uno dei fattori chiave delle sue elevate prestazioni in presenza di carichi di lavoro computazionalmente intensivi.
Gerarchia della cache, TLB e organizzazione della memoria in Zen
La gerarchia di memoria in Zen è organizzata in tre livelli di cache: L1 separata per istruzioni e dati, L2 privata per core e L3 condivisa . Sebbene erediti la struttura di base delle microarchitetture precedenti, le dimensioni, l'associatività e le politiche sono state perfezionate.
La cache L1I (cache istruzioni) offre 64 KB per core, con 4 percorsi associativi, raddoppiando il numero di percorsi per modulo rispetto a Bulldozer e riducendo i conflitti. La cache L1D (cache dati) è stata aumentata a 32 KB, con 8 percorsi e una politica di scrittura inversa (write-back), rispetto ai 16 KB, 4 percorsi e scrittura diretta (write-through) di Bulldozer, migliorando significativamente sia il tasso di successo (hit rate) che l'efficienza di scrittura.
La cache L2 è implementata con 512 KB per core e 8 vie, anziché i 2 MB condivisi a 16 vie per modulo della generazione precedente. La cache L3 , invece, offre diversi MB per core con associatività a 16 vie, fungendo da ultimo livello condiviso prima di passare alla DRAM.
Parallelamente, Zen separa le TLB in ITLB (per le istruzioni) e DTLB (per i dati) , ciascuna con diversi livelli e centinaia di voci, tutte con protezione di parità. Ciò riduce significativamente la latenza di traduzione degli indirizzi virtuali in indirizzi fisici, che diventa sempre più critica con l'aumentare delle dimensioni della memoria.
Quando parliamo di una cache a 2, 4 o 8 vie , ci riferiamo alla sua associatività, strettamente correlata al concetto di interleaving in memoria. Una maggiore associatività implica un maggior numero di modi diversi per memorizzare un blocco di memoria in quella cache, riducendo i conflitti, ma a costo di una logica leggermente più complessa e di un lieve aumento della latenza.
È inoltre importante comprendere la differenza tra write-through e write-back . Nel write-through, ogni operazione di scrittura aggiorna simultaneamente sia la cache che la memoria principale, semplificando la coerenza dei dati ma aumentando il traffico. Nel write-back, viene scritta solo la cache e la riga viene contrassegnata con un bit di modifica (dirty bit); la DRAM viene aggiornata solo quando quella riga viene rimossa, risparmiando larghezza di banda e migliorando le prestazioni a costo di una logica leggermente più complessa.
Zen e Zen+: un salto di qualità in termini di costi per investimento ed efficienza.
Rispetto a Bulldozer , Zen ha rappresentato per AMD un salto IPC molto significativo , grazie alla combinazione di un front-end migliore, un predittore di diramazioni più efficiente, un maggior numero di unità di esecuzione, SMT al posto di CMT (ogni core completo gestisce due thread, invece di condividere parte dell'FPU tra due core logici) e una gerarchia di cache molto più razionale.
Oltre al design, AMD ha beneficiato di processi produttivi più avanzati con FinFET e nodi più piccoli , che consentono una maggiore densità di transistor, un consumo energetico ridotto a parità di prestazioni e frequenze più elevate, mantenendo al contempo valori di TDP (tensione-frequenza ) ragionevoli. Questo equilibrio tra prestazioni e watt è stato cruciale per riconquistare competitività nel settore dei laptop e dei server.
Il passaggio da Bulldozer a Zen ha portato anche code di istruzioni più lunghe, gestori di istruzioni più grandi, maggiore larghezza di banda interna, predizione dei salti con tecniche basate anche su semplici reti neurali e un SMT in grado di sfruttare al meglio le unità di esecuzione disponibili.
In questo contesto, emerge Zen+ , che potremmo considerare l'equivalente di un "tick" nella vecchia strategia Tick-Tock di Intel: lo stesso design di base di Zen, ma realizzato con un nodo più raffinato, con miglioramenti della frequenza, lievi riduzioni della latenza e regolazioni interne dei timing. Non si tratta di una rivoluzione architetturale, ma piuttosto di un perfezionamento che si traduce in qualche punto percentuale di prestazioni in più.
Zen 2: chiplet, AVX2 completo e perfezionamento avanzato
Con Zen 2 , AMD non si limita più a perfezionare il processo produttivo: sta introducendo sostanziali modifiche alla microarchitettura e lanciando su larga scala la sua strategia a chiplet . Invece di un singolo die monolitico di grandi dimensioni, sta dividendo il progetto in diversi die di calcolo (CCD) più piccoli a 7 nm e un die I/O separato a 12 nm che gestisce la memoria, il PCIe e le interconnessioni.
Questo approccio a chiplet migliora la resa per wafer (è più facile produrre chip piccoli e privi di difetti), riduce i costi e semplifica la scalabilità del numero di core: basta aggiungere altri CCD per raggiungere 16, 32 o più core in EPYC e Threadripper. Il compromesso è una comunicazione interna leggermente più complessa, dipendente dall'interconnessione Infinity Fabric, che AMD ha perfezionato generazione dopo generazione.
In termini di prestazioni pure, AMD parla di un IPC (istruzioni per ciclo di clock) di circa il +15% per Zen 2 rispetto a Zen+ alla stessa frequenza e di un miglioramento complessivo delle prestazioni per watt che può arrivare a circa il +75% rispetto al primo Zen, considerando sia i miglioramenti di progettazione che quelli di processo.
Nel back-end vettoriale, Zen 2 colma la lacuna: offre il supporto completo a 256 bit per AVX2 in una singola micro-operazione , senza suddividere le istruzioni in due operazioni a 128 bit come accadeva in Zen/Zen+. Ciò significa che le unità di esecuzione vettoriale sono ora effettivamente a 256 bit e possono elaborare carichi di lavoro AVX2 a piena velocità con una penalizzazione di frequenza molto inferiore rispetto ad altre architetture.
Anche la cache delle micro-operazioni viene potenziata, aumentando a 4K voci (il doppio della sua dimensione), sfruttando parte dell'area liberata dal dimezzamento della cache L1I ma raddoppiandone l'associatività da 4 a 8 vie. Simulazioni interne hanno portato AMD a concludere che, per la maggior parte dei carichi di lavoro reali, una cache delle micro-operazioni più grande è più vantaggiosa di una cache L1I più grande.
La capacità della cache L3 per blocco core è raddoppiata , il che contribuisce a ridurre i guasti di ultimo livello, sebbene la latenza di accesso aumenti da circa 35 a 40 cicli. Per mitigare questo effetto, Zen 2 migliora la larghezza di banda di caricamento e memorizzazione e perfeziona la politica di precaricamento.
Un altro aspetto importante è il predittore di diramazione. Zen 2 utilizza un predittore TAGE (TAgged GEometric) con oltre 7 voci, in grado di sfruttare cronologie a lunghezza variabile ed voci etichettate. Ciò riduce l'aliasing tra le diverse diramazioni e, secondo AMD, riduce il numero di predizioni errate di circa il 30% rispetto al sistema precedente, il che si traduce direttamente in un minor numero di svuotamenti della pipeline e in un IPC (istruzioni per ciclo di clock) più elevato.
Back-end di Zen 2: AGU, buffer e latenze regolate
Nell'intero back-end, Zen 2 continua a eseguire fino a sei micro-operazioni per ciclo dal buffer di riordino, che è stato ampliato a circa 224 voci (rispetto alle 192 di Zen). Le unità di scheduling sono suddivise in quattro code per ALU da 16 voci ciascuna e una coda per AGU da 28 voci.
Il numero di unità di generazione indirizzi (AGU) aumenta da due a tre, sebbene non siano tutte identiche: due di esse possono gestire sia le operazioni di caricamento che di scrittura, mentre la terza è specializzata nelle operazioni di memorizzazione. Questa distribuzione è pensata per i profili software tipici, dove le operazioni di caricamento sono generalmente più frequenti e critiche rispetto alle operazioni di memorizzazione.
Nel piano a virgola mobile, il back-end può accettare quattro micro-operazioni per ciclo nelle sue unità vettoriali FMA a 256 bit, supportate da un registro fisico a 160 voci. I percorsi di caricamento/memorizzazione a 256 bit sono stati ottimizzati per alimentare queste unità a una velocità costante anche in presenza di carichi di lavoro vettoriali intensi.
Zen 2 regola anche le latenze di alcune operazioni : ad esempio, la moltiplicazione in virgola mobile riduce la sua latenza da 4 a 3 cicli, il che è utile per cicli di calcolo numerico molto stretti. Inoltre, in generale, sono presenti una serie di piccole ottimizzazioni distribuite lungo tutta la pipeline che, sommate, contribuiscono a quel miglioramento dell'IPC (istruzioni per ciclo di clock) riscontrato nei benchmark sintetici e nelle applicazioni reali.
Per quanto riguarda la gerarchia interna per gruppi di core, AMD utilizza il concetto di CCX (Core Complex) : un blocco di 4 core che condividono la stessa cache L3 (16 MB in Zen 2). Questa dimensione aggiuntiva implica una latenza leggermente superiore, ma in cambio riduce il tasso di errore, soprattutto nelle applicazioni con grandi quantità di dati in elaborazione.
A titolo di riferimento, possiamo ricordare valori approssimativi di latenza interna: circa 4 cicli per L1 , circa 12 per L2 e circa 40 cicli per L3. La chiave è mantenere la maggior quantità possibile di dati in L1/L2 e ridurre il traffico verso L3 e DRAM , un obiettivo per il quale lavorano insieme la microarchitettura e i compilatori.
Infinity Fabric: la colla utilizzata nei chiplet e il suo impatto sulle prestazioni.
Un componente non sempre associato alla microarchitettura, ma fondamentale in Zen 2 e nelle architetture successive, è Infinity Fabric . Questo bus proprietario funge da "autostrada" di comunicazione tra i CCX, i CCD, il die di I/O, la memoria e, in generale, tra tutti i blocchi del SoC.
Infinity Fabric è un'evoluzione di HyperTransport , il bus ad alta velocità che AMD ha introdotto anni fa e che è stato utilizzato anche da terze parti come NVIDIA, Cisco, Sun e altri membri del consorzio. IF eredita la filosofia dei collegamenti punto-punto scalabili, ma adattandola alle esigenze dei moderni SoC e dell'interconnessione CPU-GPU.
In Zen 2, AMD introduce IF2 , con supporto per PCIe 4.0 e un bus interno a 512 bit tra i CCX, il doppio rispetto alla prima versione. Ciò si traduce in una maggiore larghezza di banda effettiva e in un miglioramento dell'efficienza che AMD stima intorno al 27% rispetto a IF1, contribuendo a mitigare la perdita di prestazioni dovuta al passaggio tra i chiplet.
Inoltre, la frequenza di clock dell'Infinity Fabric è parzialmente disaccoppiata da quella della DRAM , consentendo alla memoria principale di raggiungere frequenze più elevate in determinati scenari senza necessariamente costringere l'IF a tenere il passo, offrendo così maggiore margine di regolazione per appassionati e progettisti di sistemi.
Nei processori per server come EPYC , con quattro o più chiplet di calcolo, Infinity Fabric è ciò che permette di connettere tutti i chip con topologie pressoché complete (rotazioni di 180°, collegamenti diretti, ecc.), raggiungendo larghezze di banda tra i chip che possono facilmente superare i 150 GB/s bidirezionali a seconda della velocità della memoria DDR utilizzata.
La combinazione di una microarchitettura robusta in ogni core , un design scalabile tramite chiplet e interconnessioni sufficientemente veloci consente ad AMD di assemblare CPU con 32, 64 o più core con prestazioni eccezionali in carichi di lavoro altamente paralleli, mantenendo al contempo un IPC per thread competitivo.
In definitiva, quando si confrontano i processori nei benchmark di gioco, nel rendering 3D, nella compilazione di grandi quantità di dati o nelle simulazioni scientifiche, i valori in GHz e il numero di core raccontano solo una parte della storia. Ciò che fa davvero la differenza è il modo in cui la microarchitettura orchestra l'esecuzione interna , come utilizza o spreca ogni ciclo di clock e quali compromessi il produttore ha operato tra latenza, larghezza di banda, consumo energetico e complessità.

Indice
- 1 ISA, macroarchitettura e microarchitettura: mettere ordine ai concetti
- 2 Che cos'è esattamente la microarchitettura di una CPU?
- 3 Compatibilità, ISA e famiglie di microarchitetture
- 4 Licenze ISA e proprietà intellettuale del design
- 5 Un'analisi più approfondita delle microarchitetture moderne: il caso AMD Zen
- 6 Gerarchia della cache, TLB e organizzazione della memoria in Zen
- 7 Zen e Zen+: un salto di qualità in termini di costi per investimento ed efficienza.
- 8 Zen 2: chiplet, AVX2 completo e perfezionamento avanzato
- 9 Back-end di Zen 2: AGU, buffer e latenze regolate
- 10 Infinity Fabric: la colla utilizzata nei chiplet e il suo impatto sulle prestazioni.