- RAIDシステムはパフォーマンスと可用性を向上させますが、バックアップに取って代わるものではなく、物理的、論理的、または人的障害の影響を受けないわけではありません。
- 異音、劣化状態、異常な動作速度低下、パリティエラーや読み書きエラーなどは、RAIDに問題が発生しつつある明確な兆候です。
- 強制的に再構築を実行したり、ドキュメントなしでディスクを再配置したり、汎用的な修復ツールを使用したりすると、対処可能な障害が完全なデータ損失につながる可能性があります。
- 慎重かつ早期に行動し、RAID復旧専門家のサポートを受けることで、情報を救出できる可能性が大幅に高まります。
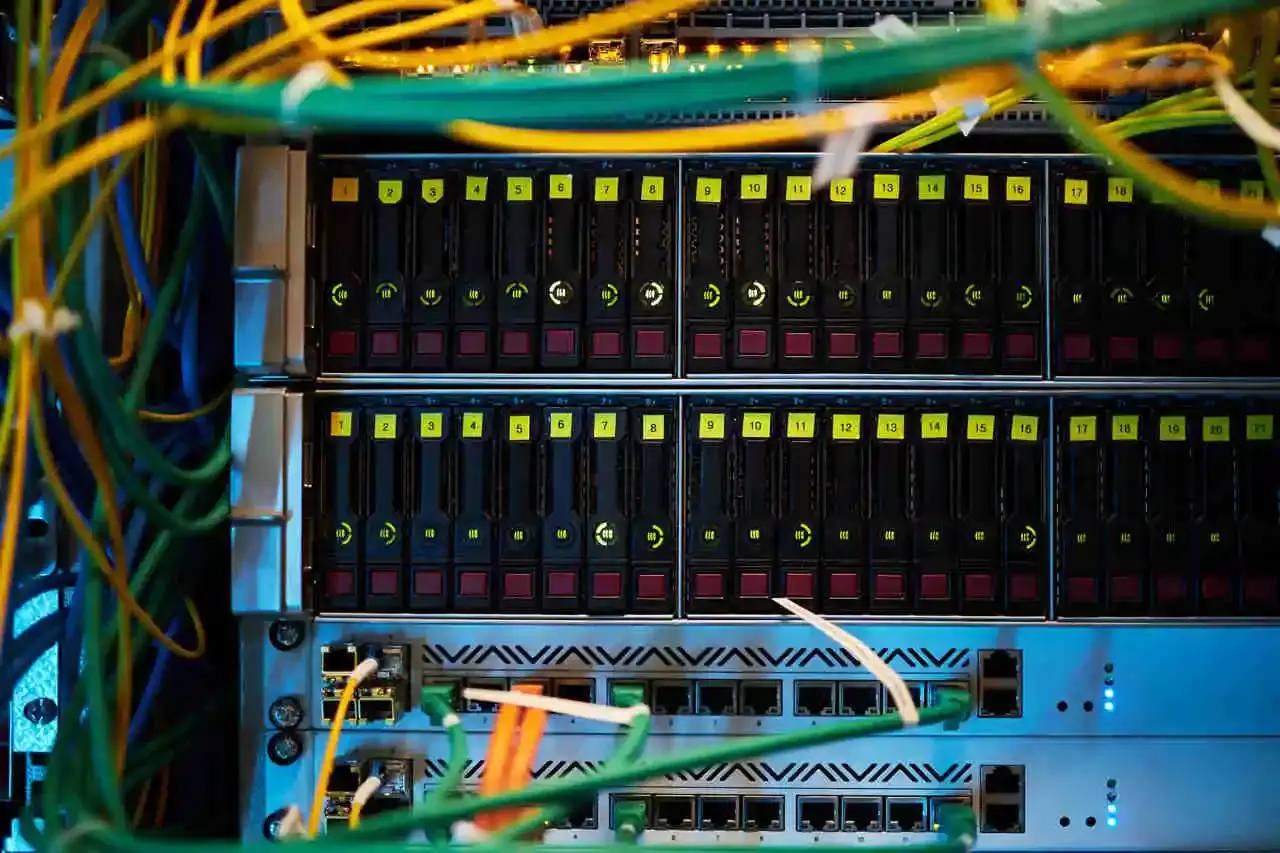
RAIDシステムは、パフォーマンスの向上と耐障害性の向上を約束するため、サーバー、NASデバイス、ストレージアレイで広く普及しています。しかし、安心感を与えてくれる一方で、万能薬ではありません。管理が不十分な障害は、数分でデータを失うという大惨事につながる可能性があります。
RAIDシステムに異常な症状が現れた場合、重要なのは素早く対処することではなく、むしろ慎重に対応することです。故障の兆候を察知し、何をしてはいけないかを把握しているかどうかが、たとえプロのラボであっても、単純なディスク交換で済むか、それともデータが完全に失われ、復旧不可能になるかの分かれ目となります。
RAID障害とは何ですか?また、なぜバックアップとは異なるのですか?
RAID(Redundant Array of Independent Disks)は、複数のディスクをグループ化することで、使用するレベルに応じて、可用性、パフォーマンス、冗長性を向上させます。古典的なミラーリング構成のRAID 1から、RAID 5、RAID 6、RAID 10といったより複雑な構成まで、その基本的な考え方は、1つ(または複数)の物理ディスクが故障してもシステムが動作し続けるようにすることです。
問題は、多くの人が「RAIDがあればバックアップは確保されている」と思い込んでいることですが、これは根本的な間違いです。RAIDはバックアップに取って代わるものではありません。RAIDは(RAIDレベルに応じて)1つまたは複数のディスクの障害から保護するものの、論理的な破損、人為的なミス、ランサムウェア、誤削除、コントローラーやサーバーの障害を防ぐものではありません。
さらに、コントローラ(コントローラのファームウェアを含む)がデータ(ディスクの順序、ストライプサイズ、パリティアルゴリズム、メタデータなど)を分配する方法は、アレイの操作を誤ると、ディスクが「正常に見える」場合でも、構造が破壊され、復旧が非常に複雑になる可能性があることを意味します。
主なRAIDレベルとリカバリへの影響
RAIDレベルごとに障害発生時の動作が異なり、これはデータ復旧方法に大きな影響を与えます。これらの違いを理解しておくことで、問題発生時にリスクの高い判断を下すことを避けることができます。
RAID 0アレイでは、データはパリティやミラーリングなしで複数のディスクにストライピングされます。冗長性は一切ありません。単一のディスクが故障したり、劣化したりすると、各ファイルの重要な部分が失われるため、論理的な損失は完全に発生します。「再構築」についてここで議論してもあまり意味がありません。優先すべきは、物理的に損傷したディスクから可能な限りデータを復旧することです。
RAID 1アレイでは、ディスクはミラーリングされます。つまり、各ドライブにはデータの完全なコピーが格納されます。この構成は、処理エラー(例えば、ディスクの1つを別のシステムで初期化したり、互換性のないコントローラでディスクを混在させたりすること)が発生しない限り、データ復旧において非常に信頼性が高いと言えます。
RAID 5は、データを複数のドライブに分散し、分散パリティを計算することで、1台のドライブの故障に耐えることができます。問題は、再構築中に2台目のドライブが誤動作し始めた場合に発生します。ワークロードが急激に増加し、読み取りエラーが発生し、アレイが警告なしにクラッシュする可能性があります。
RAID 6はRAID 5と同様の仕組みですが、2つ目のパリティを追加することで、最大2台のディスクの障害に対応できます。その代わりに、アーキテクチャはより複雑になり、再構築に時間がかかり、論理エラーや構成エラーが発生すると復旧作業がさらに困難になります。
RAID 10はミラーリングとストライプリングを組み合わせたもので、ミラーリングされたディスクペアは「スクラッチ」されます。復旧の際には、ディスクの順序とミラーリングとストライプリングの関係が非常に重要です。位置を混同したり、無計画に再構築したりすると、すべてのディスクが物理的に正常であってもアレイが破損する可能性があります。
RAIDが故障し始めている明確な兆候
システムが完全に故障する前には、通常、一連の兆候が残ります。これらの兆候を認識する方法を学ぶことで、早期に停止し、さらなる被害を防ぐことができます。
最も分かりやすい兆候の一つは、ディスクから異音がすることです。例えば、繰り返し鳴るカチカチ音、ギシギシ音、断続的なブザー音、あるいは以前はなかった金属音などです。これらの異音は通常、読み書きヘッドやプラッタの機械的な故障、またはモーターの不具合を示しています。これらの異音を無視して無理に読み込みを続けると、ドライブの状態は急速に悪化する傾向があります。
もう一つの典型的な兆候は、NASまたはRAIDコントローラーの管理コンソールに「劣化」「障害」「重大」といったメッセージが表示されることです。このメッセージは、1つ以上のディスクに問題があると判断され、アレイが本来の冗長性なしで動作していることを意味します。特にRAID 5の場合、この段階で2つ目の障害が発生すると、致命的な問題となる可能性があります。
パフォーマンスの急激かつ原因不明な低下など、目立たないながらも同様に危険な症状にも注意してください。特に特定のボリュームやフォルダにアクセスする際に、読み取り時間と書き込み時間が急激に増加する場合は、コントローラが読み取りにくいセクターの処理に苦戦しているか、システムに過負荷をかける連続的な再試行が発生している可能性があります。
システムログやコントローラログには、I/Oエラー、パリティエラーメッセージ、「回復不能な読み取りエラー」、「パリティチェック失敗」、「不良ストライプ検出」などが表示されることがよくあります。システムが正常に動作している場合でも、読み書きエラーが継続的に増加している場合は、無視できない危険信号です。
もう一つの危険信号は、ディスクが完全に故障していないにもかかわらず、ボリュームが劣化しているように見える場合です。これは通常、RAIDメタデータまたは分散ブロックに論理的な破損があることを示しており、この状態で自動再構築を強制すると、破損がアレイ全体に伝播する可能性があります。
RAIDにおける論理破損の兆候と潜在的な問題
RAID障害のすべてが、ディスクの即時使用不能につながるわけではありません。多くの場合、問題は徐々に進行するデータ破損であり、状況が元に戻すのが非常に困難になるまで、静かに進行していきます。
典型的な例としては、ファイルが存在し、サイズや名前も正しいように見えるにもかかわらず、開かない、書式エラーが発生する、またはファイルが途中で切れて表示されるといったケースが挙げられます。マウントできないデータベース、起動しない仮想マシン、ビューアが拒否する画像などは、通常、ディスク全体に分散されたブロックの不整合を示しています。
CPUやRAMに特に負荷がかかっていないように見えても、特定のRAIDボリューム上でオペレーティングシステムやアプリケーションの動作が局所的に遅くなることはよくあります。もし動作の遅さが同じボリューム上の読み書き操作に集中している場合は、セクタの破損や不安定性が発生している可能性が非常に高いです。
もう一つの危険な兆候は、ディスク交換後に開始される再構築処理が常に同じ箇所で停止したり、奇妙なエラーが発生したり、あるいは単に処理が失敗とマークされたりすることです。これは通常、ソースブロックが既に破損しており、コントローラが新しいディスク上に整合性のあるコピーを生成できないことを示しています。
ディスクによっては、SMARTアラート(再割り当てセクタ、アクセス時間の増加など)が1台のみに表示される場合でも、異常な動作がRAIDアレイ全体に影響を及ぼすことがあります。このような場合、不良セクタのあるディスクが1台あるだけで、特にパリティチェックや再構築が開始された際に、アレイ全体の整合性が損なわれる可能性があります。
これらの警告を無視して通常どおり運用を続けたり、さらに悪いことに、検証、一括バックアップ、自動再構築などの負荷の高いタスクを強制的に実行したりすると、データの破損が広がり、有効なブロックが破損したデータで上書きされてしまう可能性があります。そうなると、専門的なツールを使っても完全な復旧を保証することはできません。
コントローラー、サーバー、マザーボードにおける典型的な故障
問題はディスクだけではありません。RAIDコントローラー、マザーボード、あるいはサーバー全体がチェーンの弱点となり、ディスクが正常であってもアレイ障害を引き起こす可能性があります。
RAIDコントローラは、専用ハードウェアであれマザーボードに統合されたものであれ、各ブロックの書き込み場所、パリティの計算方法、ボリュームの組み立て方法を決定する役割を担っています。障害、ファームウェアの破損、または電源サージが発生すると、RAIDコントローラが機能しなくなり、アレイが消失したり、「外部」、「オフライン」などと表示されたりすることがあります。
専用ハードウェアコントローラの場合、さらに問題が生じます。それは、モデル間およびメーカー間の互換性がほぼ皆無であることです。例えば、特定のSupermicroコントローラが故障した場合、「類似品」に交換するだけでは不十分です。多くの場合、RAIDメタデータを正しく読み取るためには、ファームウェアのバージョンが類似した、まったく同じモデルが必要となります。
一部のAMDやIntelチップセットのソフトウェアRAIDなど、統合型RAIDソリューション(いわゆる「擬似RAID」)では、マザーボードの交換、BIOSのリセット、またはCMOS構成の消失によってアレイが動作不能になるリスクがあります。多くのデスクトップコンピュータやワークステーションでは、マザーボードやCMOSバッテリーの故障によってRAID構成が消去され、ドライブが独立したユニットとして扱われるようになります。
さらに、サーバー本体(電源、メモリ、マザーボード、バックプレーンなど)は、電気的な問題、過熱、またはハードウェアの欠陥により故障する可能性があります。多くの場合、実際にはRAIDにアクセスできなくなりますが、適切な戦略を用いて別のシステムに接続すれば、ディスクからデータを復旧できる可能性があります。
さらに悪いことに、システムは再起動または起動するたびにRAIDアレイを「再構築」する必要があります。このプロセス中に停電、電圧スパイク、または構成ファイル(Linuxのmdadm.confなど)のエラーが発生すると、システムはアレイを正しく構築できなかったり、不完全なままにしたり、あるいは単に認識できなかったりして、ボリュームが使用できなくなる可能性があります。
RAIDアレイにおけるデータ損失の一般的な原因
上記すべてを考慮すると、RAIDアレイは非常に有用であるものの、依然として相当なリスクにさらされていることは明らかです。このような環境におけるデータ損失の主な原因は、通常、物理的要因、論理的要因、および人的要因の組み合わせです。
最も明白な原因は、摩耗、製造上の欠陥、振動、温度変化、衝撃などによる1つまたは複数のディスクの故障です。RAIDはこれらの状況の一部に耐えられるように設計されていますが、必ずしも副次的な損傷なしに成功するとは限りません。破損したセクタを返し始めたディスクは、特に検証や再構築処理中に、隣接するディスクの動作を遅くする可能性があります。
もう一つのよくある問題の原因は、アセンブリエラーや再構築エラーです。システムが誤ったパラメータ、間違ったディスク順序、元のRAIDレベルと異なるRAIDレベルでアレイをマウントした場合、または移行が失敗した後にマウントした場合、データは容易に位置ずれを起こす可能性があります。実際には、ボリュームがRAW形式で表示されたり、フォーマットが必要になったり、ファイル構造に矛盾が生じたりする可能性があります。
サーバーの障害(マザーボード、ファームウェア、バックプレーン、SAS/SATAコントローラーなど)も大きな要因となります。非常に高い割合で、サーバーが突然故障すると、RAIDアレイにアクセスできなくなり、データは物理的にはディスク上に存在しているにもかかわらず、システムから見えなくなってしまいます。
これらすべてに加えて、人的要因も考慮する必要があります。例えば、ドキュメントなしでの構成変更、テスト目的でのディスクの再配置、構成のバックアップなしでのBIOSアップデート、誤ってボリュームを削除すること、アレイの一部であったディスクへのオペレーティングシステムの再インストール、破損または不完全なバックアップを同じ損傷したRAIDに復元することなどが挙げられます。
最後に、ランサムウェアなどの外部からの脅威があります。ランサムウェアは、 RAIDアレイ上にホストされているボリュームのデータと構造の両方を暗号化する可能性があります。このような場合、復旧プロセスは二重に複雑になります。まず暗号化に対処する必要があり、次にRAID自体の内部破損の可能性に対処する必要があるからです。
RAIDが故障し始めたときにやってはいけないこと
週末にサーバーがダウンして皆が不安になると、誰かがその場で復旧を試みるのがよくある反応です。それは理解できますが、こうした善意からの試みの多くは、最終的にデータの状況を悪化させる原因となるのです。
最も危険な誘惑は、ディスクの実際の状態を分析せずに自動再構築を強制することです。ディスクのいずれかに破損したデータや読み取り不能なセクターがある場合、再構築によってジャンクデータと正常なデータが混ざり合い、ボリュームの構造が完全に破壊されてしまいます。
よくある間違いとしては、どのドライブが実際に損傷しているかを確認せずに、あるいは各ドライブの元の位置を記録しずに、無計画にドライブを交換することが挙げられます。ドライブをベイ間で移動したり、異なるコントローラ間で混在させたり、計画なしに複数のドライブを一度に交換したりすると、コントローラが混乱し、RAIDアレイが構成を認識できなくなる可能性があります。
WindowsのCHKDSKやLinuxのfsckといったツールを、破損の兆候が見られるRAIDボリュームに直接実行することも非常に危険です。これらのユーティリティは、破損している可能性のあるテーブルに基づいてファイル構造を「修復」しようとしますが、その修復にはエントリの削除、ブロックの再配置、メタデータの書き換えなどが含まれることがよくあります。既にデータが破損している環境では、これにより数千ものファイルが永久に失われる可能性があります。
同様に危険なのは、 「あらゆるRAIDを自動的にセットアップする」と謳う汎用RAID復旧ソフトウェアに頼ることです。これらのツールの多くは表面的な動作しかせず、標準的なストライプ、オフセット、パリティパターンを前提としていますが、必ずしもそれらが満たされるとは限りません。誤った使い方をすると、重要なセクターが上書きされたり、ディスクが最初にインストールされた時よりも悪い状態になったりする可能性があります。
最後に、サーバーを繰り返し再起動したり、NASの電源を入れ直したり、劣化したRAIDアレイやパリティエラーのあるRAIDアレイで通常通り動作を続けたりすると、ディスクへのダメージがさらに悪化し、セクターの再割り当てが増え、破損が拡大するだけです。最初の深刻な問題が発生した後に書き込み回数が増えるほど、専門家が対処できる余地は少なくなります。
RAID障害の可能性を検出した場合に取るべき慎重な手順
ノイズ、ステータスの低下、パリティエラー、極端な動作の遅さ、再構築の失敗など、深刻な症状が現れた場合は、ペースを落として計画的に作業を進めるのが賢明です。今書き込まなかったり変更しなかったりした内容は、後で修復できる可能性があります。
まず最初にすべきことは、アレイへの書き込み操作を直ちに停止することです。データのコピー、新しい仮想マシンの作成、一括更新などは一切行わないでください。ボリュームにまだアクセスできる場合は、システムが許可する限り、読み取り専用としてマウントするのが最善です。
次に、BIOSやNASインターフェースのスクリーンショット、ディスクのリスト(物理的な場所、シリアル番号、接続されているポート、ログに表示される正確なエラーメッセージなど)など、現在の状態をできる限り詳細に記録しておくことをお勧めします。これらの情報は、復旧ラボが元の状況を再現する際に非常に役立ちます。
RAIDのマウントに失敗したり、サーバーが起動しない場合、技術的な解決策の一つとして、ディスクを取り外して別のコンピューターに接続し、各ドライブのセクター単位のフォレンジックコピーを作成する方法があります。読み取り専用モードで作成されたこれらのコピーを使用することで、元のディスクにさらなる損傷を与えることなく、クローン上で作業を行うことができます。
高度な知識、専用ツール、そして管理された環境があれば、これらのクローンからアレイの論理的な再構築を試み、ディスクの順序、ストライプサイズ、パリティパターン、オフセット、メタデータを推測することができます。しかし、これは繊細なリバースエンジニアリング作業であり、ランダムなパラメータ変更を伴う試行錯誤は、データの誤解釈につながる可能性があります。
ほとんどの企業や重要な環境においては、できるだけ早く専門のRAID復旧サービスに連絡し、指示に従うことが最も安全な方法です。復旧の成功率は、通常、ラボに到着するまでに失敗した試行回数に大きく左右されます。
プロのRAID復旧ラボの仕組み
RAID環境に特化したプロのデータ復旧サービスは、ハードウェアとファイルシステムに関する深い知識と、独自のツールおよび厳格な手順を組み合わせています。大まかに言えば、RAID障害の依頼を受けた際に、彼らは通常このような作業を行います。
最初のステップは、各ハードドライブに対して個別の診断を行うことです。ドライブの機械的、電子的、論理的な状態をチェックし、不良セクタを特定し、SMARTテーブルを確認し、短期的な故障リスクを評価します。物理的な損傷があるドライブは、クリーンルームでの処理が優先されます。
次に、関係するすべてのディスクのフォレンジッククローンを作成します。オリジナルディスクを直接操作するのではなく、深刻な損傷を受けたセクターをスキップしたり、安全なパターンで再試行したりできるツールを使用して、セクターごとのコピーを作成します。これは、処理の前の段階に戻る必要が生じた場合に備えて、元の状態を保持することを目的としています。
クローンが準備できたら、RAIDの論理的な再構築を手動で行います。レベル(0、1、5、6、10など)、ディスクの順序、ストライプサイズ、オフセット、パリティアルゴリズム、および元のコントローラのその他の特性を特定します。多くの場合、ボリュームを作成したコントローラやNASがなくても、ボリュームを再構築できます。
再構築された仮想ボリュームが整合性を保っていると判断されたら、必要に応じてファイルシステム(NTFS、ReFS、ext4、XFS、Btrfs、ZFS、VMFSなど)を修復します。この作業は外科医の手術に似ており、構造を修正し、inodeテーブル、MFT、スーパーブロック、ジャーナルなどを再構築しますが、常に最小限の変更にとどめるよう努めます。
最後に、データが抽出され、体系的に検証されます。主要なデータベース、仮想マシン、および重要なフォルダの一貫性がチェックされ、ファイルが正しく開くことが検証され、データは外付けハードドライブや新しいNASなどの新しい隔離されたストレージメディアに配信されるため、クライアントは受け入れる前に復旧内容を確認できます。
ランサムウェアの影響を受けたRAID、以前の再構築の失敗、または既に損傷したアレイ内の仮想ボリュームなど、特に複雑なシナリオでは、復号化技術、フォレンジック分析、およびRAID再構築が組み合わされますが、常に同じルールが適用されます。それは、オリジナルに必要以上に手を加えないことです。
結局のところ、RAIDシステムはデータ可用性を向上させる強力なツールですが、物理的、論理的、そして人的ミスに対して脆弱なままです。その弱点を理解し、早期の警告サインを察知し、そして何よりも、障害発生時に衝動的な判断を避けることが、軽微なトラブルで済むか、データ大惨事になるかの真の分かれ目となります。
