- RAID-systemer forbedrer ytelse og tilgjengelighet, men de erstatter ikke sikkerhetskopier og er ikke immune mot fysiske, logiske eller menneskelige feil.
- Merkelige lyder, degradert tilstand, unormal treghet og paritets- eller lese-/skrivefeil er klare tegn på forestående problemer i RAID-en.
- Å tvinge frem gjenoppbygginger, omorganisere disker uten dokumentasjon eller bruke generiske reparasjonsverktøy kan gjøre en håndterbar feil til et totalt datatap.
- Å handle klokt og tidlig, sammen med støtte fra RAID-gjenopprettingsspesialister, øker sjansene for å redde informasjonen betraktelig.
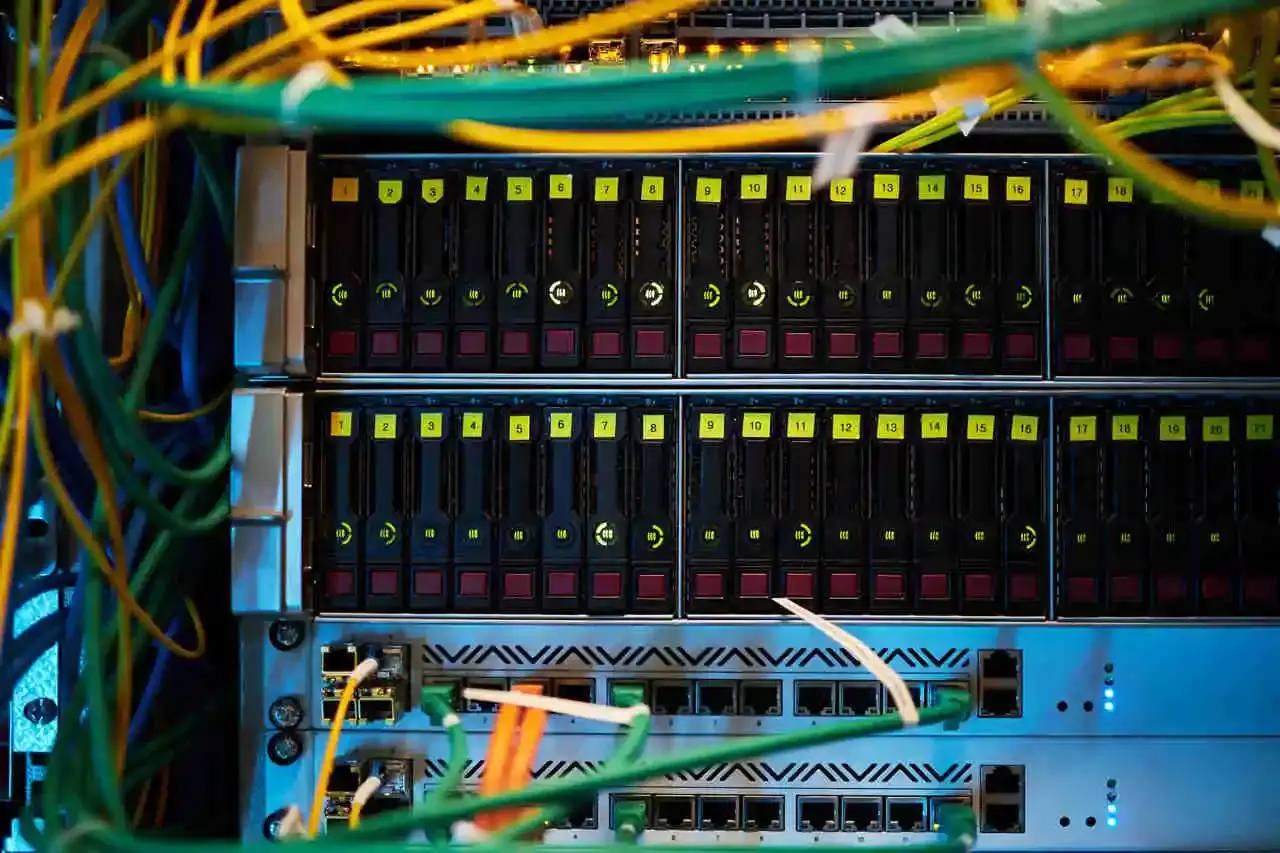
RAID-systemer har blitt vanlige i servere, NAS-enheter og lagringsarrayer fordi de lover økt ytelse og feiltoleranse . Selv om de gir trygghet, er de ikke en magisk løsning: en dårlig håndtert feil kan føre til katastrofe og gjøre deg uten data i løpet av minutter.
Når et RAID-system begynner å vise uvanlige symptomer, er ikke nøkkelen å være den raskeste til å fikse, men snarere å være mest forsiktig. Å oppdage tegn på feil og vite hva man IKKE skal gjøre utgjør forskjellen mellom en enkel diskutskifting og et totalt og uopprettelig tap av data, selv for et profesjonelt laboratorium.
Hva er en RAID-feil, og hvorfor er det ikke det samme som en sikkerhetskopi?
En RAID (Redundant Array of Independent Disks) grupperer flere disker for å tilby bedre tilgjengelighet, ytelse og/eller redundans , avhengig av hvilket nivå som brukes. Fra den klassiske speilede RAID 1 til mer komplekse konfigurasjoner som RAID 5, RAID 6 eller RAID 10, er ideen at systemet fortsetter å fungere selv om én (eller flere) fysiske disker svikter.
Problemet er at mange antar at «jeg har RAID, så jeg har en sikkerhetskopi», og det er en fundamental feil. RAID erstatter ikke sikkerhetskopier : det beskytter mot feil på én eller flere disker (avhengig av RAID-nivået), men det forhindrer ikke logisk korrupsjon, menneskelige feil, ransomware, utilsiktet sletting eller kontroller- eller serverfeil.
Videre betyr måten kontrolleren – inkludert kontrollerens fastvare – distribuerer data på (diskrekkefølge, stripestørrelse, paritetsalgoritmer, metadata osv.) at enhver feil manipulering av arrayet kan ødelegge strukturen og gjøre gjenoppretting ekstremt komplisert, selv når diskene «ser ut» til å være i orden.
De viktigste RAID-nivåene og deres innvirkning på gjenoppretting
Hvert RAID-nivå oppfører seg forskjellig ved feil, og dette påvirker alternativene for datagjenoppretting betydelig. Å forstå disse forskjellene bidrar til å unngå å ta risikable avgjørelser når noe går galt.
I en RAID 0-array stripes data over flere disker uten paritet eller speiling. Det er ingen redundans av noe slag : hvis en enkelt disk svikter eller degraderes tilstrekkelig, er det logiske tapet totalt fordi en viktig del av hver fil mangler. Å snakke om "rekonstruksjon" her gir liten mening; prioriteten er å prøve å gjenopprette det som kan gjenopprettes fra de fysisk skadede diskene.
I en RAID 1-matrise er diskene speilet: hver disk inneholder en komplett kopi av dataene . Denne konfigurasjonen er vanligvis ganske pålitelig for datagjenoppretting, forutsatt at det ikke oppstår håndteringsfeil (for eksempel initialisering av en av diskene på et annet system eller blanding av dem på inkompatible kontrollere).
RAID 5 distribuerer data på tvers av flere disker og beregner distribuert paritet, slik at den kan motstå feil på én disk . Problemet oppstår når en annen disk begynner å fungere feil under gjenoppbygging: arbeidsmengden øker i været, lesefeil oppstår, og arrayet kan krasje uten forvarsel.
RAID 6 fungerer på samme måte som RAID 5, men legger til en andre paritet, slik at den kan tolerere feil på opptil to disker . Til gjengjeld er arkitekturen mer kompleks, gjenoppbygging tar lengre tid, og eventuelle logiske feil eller konfigurasjonsfeil kompliserer gjenopprettingsarbeidet ytterligere.
RAID 10 kombinerer speil og striper: par av disker som er speilet blir «ripede». For gjenopprettingsformål er rekkefølgen på diskene og forholdet mellom speil og striper kritisk; å blande posisjoner eller blind gjenoppbygging kan ødelegge arrayet selv om alle diskene er fysisk sunne.
Tydelige tegn på at RAID-en din begynner å mislykkes
Før et system svikter fullstendig, etterlater det seg vanligvis en rekke ledetråder. Å lære å gjenkjenne dem lar deg stoppe i tide og forhindre ytterligere skade.
Et av de mest åpenbare tegnene er merkelige lyder fra diskene: gjentatte klikk, knirking, periodisk summing eller metalliske lyder som ikke var der før. Disse lydene indikerer vanligvis mekaniske feil i lese-/skrivehodene eller platene , eller problemer med motoren. Hvis du ignorerer dem og fortsetter å tvinge frem lesinger, vil diskens tilstand vanligvis forringes veldig raskt.
Et annet typisk tegn er at meldingene «Degraded», «Failed» eller «Critical» vises i NAS- eller RAID-kontrollerens administrasjonskonsoll. Denne meldingen betyr at én eller flere disker er merket som problematiske , og at arrayet fungerer uten den tiltenkte redundansen. På dette tidspunktet, spesielt med RAID 5, kan en ny feil være den siste dråpen.
Vær oppmerksom på mindre merkbare, men like farlige symptomer, som for eksempel en plutselig og uforklarlig ytelsesnedgang . Hvis lese- og skrivetiden skyter i været, spesielt når du åpner bestemte volumer eller mapper, kan det hende at kontrolleren sliter med sektorer som er vanskelige å lese, eller opplever kontinuerlige nye forsøk som overbelaster systemet.
System- eller kontrollerlogger viser ofte I/O-feil, feil paritetsmeldinger, «Uopprettelig lesefeil», «Paritetskontroll mislyktes» eller «Dårlig stripe oppdaget». En vedvarende økning i lese-/skrivefeil , selv om systemet fortsatt fungerer, er et rødt flagg som ikke bør ignoreres.
Et annet rødt flagg er at volumet ser ut til å være degradert selv om ingen disker tilsynelatende har sviktet fullstendig . Dette indikerer vanligvis logisk korrupsjon i RAID-metadataene eller distribuerte blokker, og å tvinge frem en automatisk gjenoppbygging i denne tilstanden kan spre korrupsjonen gjennom hele arrayet.
Symptomer på logisk korrupsjon og stille problemer i RAID
Ikke alle RAID-feil resulterer i en umiddelbart "død" disk. Ofte er problemet en gradvis datakorrupsjon som stille sniker seg inn helt til situasjonen blir svært vanskelig å reversere.
Et typisk eksempel er filer som ser ut til å være der, har riktig størrelse og navn, men som ikke åpnes, har formateringsfeil eller ser avkortede ut . Databaser som ikke monteres, virtuelle maskiner som ikke starter, eller bilder som brukeren avviser, er vanligvis indikatorer på inkonsekvenser i blokkene som er fordelt på disker.
Det er også vanlig at operativsystemet eller applikasjonene viser lokalisert treghet på visse RAID-volumer, selv om CPU og RAM ikke virker spesielt belastet. Hvis tregheten er konsentrert rundt lese-/skriveoperasjoner på samme volum, har du sannsynligvis å gjøre med korrupsjon eller ustabile sektorer.
Et annet farlig symptom er at gjenoppbygginger som starter etter et diskbytte alltid stopper på samme punkt , kaster merkelige feil, eller rett og slett markerer prosessen som mislykket. Dette indikerer vanligvis at kildeblokkene allerede er ødelagt, og at kontrolleren ikke klarer å generere en sammenhengende kopi på den nye disken.
Noen ganger viser bare én disk SMART-varsler (omfordelte sektorer, høy tilgangstid osv.), men den uvanlige oppførselen er merkbar på tvers av hele RAID-arrayet. I slike tilfeller kan en enkelt disk med dårlige sektorer kompromittere konsistensen til hele arrayet, spesielt når en paritetskontroll eller gjenoppbygging startes.
Å ignorere disse advarslene og fortsette å operere som normalt, eller enda verre, å tvinge frem intensive oppgaver som verifiseringer, massesikkerhetskopier eller automatiske gjenoppbygginger, kan spre korrupsjon og overskrive gyldige blokker med skadede data . Fra det tidspunktet kan ikke engang profesjonelle verktøy garantere en fullstendig gjenoppretting.
Typiske feil i kontrollere, servere og hovedkort
Det handler ikke bare om diskene. RAID-kontrolleren, hovedkortet eller til og med hele serveren kan bli det svake leddet i kjeden og forårsake array-feil selv om diskene er i god stand.
RAID-kontrolleren, enten dedikert maskinvare eller integrert på hovedkortet, er ansvarlig for å bestemme hvor hver blokk skrives, hvordan paritet beregnes og hvordan volumene settes sammen . En feil, ødelagt fastvare eller en strømstøt kan deaktivere den, noe som fører til at arrayet forsvinner eller vises som "Foreign", "Offline" eller lignende.
Når det gjelder dedikerte maskinvarekontrollere, er det et ekstra problem: den nesten fullstendige mangelen på kompatibilitet mellom modeller og produsenter . Hvis en spesifikk Supermicro-kontroller for eksempel går i stykker, er det ikke nok å bare erstatte den med "en lignende": ofte kreves nøyaktig samme modell, med en lignende firmwareversjon, for at den skal lese RAID-metadataene riktig.
Med integrerte RAID-løsninger (såkalt «falsk RAID»), som for eksempel noen programvare-RAID-er for AMD- eller Intel-brikkesett, er risikoen at en hovedkortutskiftning, en BIOS-tilbakestilling eller tap av CMOS-konfigurasjonen kan gjøre arrayet ubrukelig. I mange stasjonære datamaskiner og arbeidsstasjoner kan en hovedkort- eller CMOS-batterifeil utslette RAID-konfigurasjonen, slik at diskene blir isolerte enheter.
Videre kan selve serveren ( strømforsyning , minne, hovedkort, bakplan osv.) svikte på grunn av elektriske problemer, overoppheting eller maskinvarefeil. I mange av disse tilfellene er det praktiske resultatet at RAID-en blir utilgjengelig , selv om diskene, som er koblet til et annet system med riktig strategi, i realiteten kan gjenopprette dataene sine.
For å gjøre vondt verre, må systemet «sette sammen» RAID-arrayet på nytt hver gang det starter på nytt eller starter opp. Hvis det oppstår strømbrudd, spenningstopper eller feil i konfigurasjonsfilene (som mdadm.conf i Linux) under denne prosessen, kan systemet sette sammen arrayet feil, la det være ufullstendig, eller rett og slett ikke gjenkjenne det, noe som gjør volumet ubrukelig.
Vanlige årsaker til datatap i RAID-arrayer
Når man tar alt det ovennevnte i betraktning, er det tydelig at RAID-arrayer, selv om de er svært nyttige, fortsatt er utsatt for betydelige risikoer. De viktigste virkelige årsakene til datatap i disse miljøene er vanligvis en kombinasjon av fysiske, logiske og menneskelige faktorer.
Den mest åpenbare årsaken er at én eller flere disker svikter på grunn av slitasje, produksjonsfeil, vibrasjoner, temperatur eller støt. Selv om RAID er designet for å tåle noen av disse situasjonene, lykkes det ikke alltid uten følgeskader : en disk som begynner å returnere ødelagte sektorer kan dra ned naboen, spesielt under verifisering eller gjenoppbyggingsprosesser.
En annen vanlig kilde til problemer er monterings- eller rekonstruksjonsfeil . Hvis systemet monterer arrayet med feil parametere, disker i feil rekkefølge, RAID-nivåer som er forskjellige fra originalene, eller etter en mislykket migrering, kan dataene lett bli feiljustert. I praksis kan volumet vises som RAW, kreve formatering eller vise inkonsekvente filstrukturer.
Serverfeil (hovedkort, fastvare, bakplan, SAS/SATA-kontroller osv.) spiller også en betydelig rolle. I en svært høy andel av tilfeller, når serveren plutselig svikter, blir RAID-arrayet utilgjengelig, og dataene er ikke synlige for systemet, selv om de fortsatt fysisk finnes på diskene.
Til alt dette må vi legge til menneskelige faktorer: konfigurasjonsendringer uten dokumentasjon, omorganisering av disker «for testing», BIOS-oppdateringer uten en tidligere sikkerhetskopi av konfigurasjonen, utilsiktet sletting av volumer, reinstallering av operativsystemet på disker som var en del av arrayet, eller gjenoppretting av korrupte eller ufullstendige sikkerhetskopier på det samme skadede RAID-et.
Til slutt finnes det eksterne trusler som ransomware, som kan kryptere både dataene og strukturene til volumene som ligger på RAID-arrayer. I disse scenariene blir gjenopprettingsprosessen dobbelt komplisert: først må krypteringen håndteres, og deretter den potensielle interne korrupsjonen av selve RAID-en.
Hva du IKKE skal gjøre når RAID-en din begynner å feile
Når en server går ned i helgen og alle er på nervene, er den vanligste reaksjonen at noen prøver å fikse det på sparket. Det er forståelig, men mange av disse velmenende forsøkene er nettopp det som til syvende og sist gjør dataene verre.
Den farligste fristelsen er å tvinge frem en automatisk gjenoppbygging uten først å analysere diskenes faktiske tilstand . Hvis en av diskene har ødelagte data eller uleselige sektorer, vil gjenoppbyggingen kopiere og blande søppeldata med gode data til volumets struktur er fullstendig ødelagt.
En annen vanlig feil er å bytte ut disker på måfå uten å vite hvilken som faktisk er skadet eller dokumentere den opprinnelige plasseringen til hver disk . Å flytte disker mellom brønner, blande dem mellom forskjellige kontrollere eller bytte ut flere samtidig uten en plan kan forvirre kontrolleren og føre til at RAID-arrayet mister oversikten over konfigurasjonen.
Det er også svært risikabelt å kjøre verktøy som CHKDSK på Windows eller fsck på Linux direkte på et RAID-volum som viser tegn til korrupsjon. Disse verktøyene prøver å "fikse" filstrukturen basert på tabeller som kan være skadet , og rettelsene deres innebærer ofte å slette oppføringer, flytte blokker og skrive om metadata. I et allerede kompromittert miljø kan dette føre til permanent tap av tusenvis av filer.
Like ille er det å stole på generisk RAID-gjenopprettingsprogramvare som lover å «automatisk sette opp alle RAID-er ». Mange av disse verktøyene fungerer overfladisk, og antar standard stripe-, offset- og paritetsmønstre som ikke alltid oppfylles. Misbruk kan overskrive viktige sektorer eller etterlate disker i dårligere stand enn da de først ble installert.
Til slutt vil gjentatte ganger omstart av serveren, av- og påslåing av NAS-en eller fortsatt normal drift på en degradert RAID-matrise eller en med paritetsfeil bare forårsake ytterligere skade på diskene, omfordele flere sektorer og spre korrupsjonen . Jo flere skrivinger som utføres etter det første alvorlige problemet, desto mindre handlingsrom vil spesialistene ha.
Forsiktige tiltak du bør ta når du oppdager en mulig RAID-feil
Ved alvorlige symptomer (støy, degradert status, paritetsfeil, ekstrem treghet, mislykkede gjenoppbygginger osv.), er det klokeste å senke farten og gå metodisk frem . Det du ikke skriver eller endrer nå, kan kanskje reddes senere.
Det første du må gjøre er å stoppe alle skriveoperasjoner på arrayet umiddelbart : ingen kopiering av data over det, ingen nye virtuelle maskiner, ingen masseoppdateringer. Hvis volumet fortsatt er tilgjengelig, er det best å montere det som skrivebeskyttet hvis systemet tillater det.
Deretter anbefales det å dokumentere gjeldende tilstand så detaljert som mulig: skjermbilder av BIOS- eller NAS-grensesnittet, en liste over disker med fysisk plassering, serienummer, portene de er koblet til, nøyaktige feilmeldinger som vises i logger, osv. Denne informasjonen er uvurderlig for ethvert gjenopprettingslaboratorium når det skal rekonstrueres det opprinnelige scenarioet.
I tilfeller der RAID-en ikke monteres eller serveren ikke starter opp, er et teknisk alternativ å fjerne diskene og koble dem til en annen datamaskin for å lage sektor-for-sektor rettsmedisinske kopier av hver disk . Disse kopiene, som er laget i skrivebeskyttet modus, lar deg jobbe med kloner etterpå uten å skade de originale diskene ytterligere.
Med avansert kunnskap, spesialiserte verktøy og et kontrollert miljø kan man forsøke en logisk rekonstruksjon av arrayet fra disse klonene, og utlede diskrekkefølge, stripestørrelse, paritetsmønstre, forskyvninger og metadata . Dette er imidlertid en delikat reverse engineering-oppgave: all prøving og feiling som involverer tilfeldige parameterendringer kan føre til feiltolkning av dataene.
For de fleste bedrifter og kritiske miljøer er det tryggeste å kontakte en profesjonell RAID-gjenopprettingstjeneste så snart som mulig og følge deres første instruksjoner. Suksessraten er vanligvis nært knyttet til antall mislykkede forsøk som gjøres før den når laboratoriet.
Hvordan profesjonelle RAID-gjenopprettingslaboratorier fungerer
Profesjonelle datagjenopprettingstjenester som spesialiserer seg på RAID-miljøer kombinerer inngående kunnskap om maskinvare og filsystemer med proprietære verktøy og strenge prosedyrer. Dette er vanligvis hva de gjør når de mottar en sak om en mislykket RAID.
Det første trinnet er å utføre en individuell diagnostikk på hver harddisk : den mekaniske, elektroniske og logiske tilstanden til diskene kontrolleres, skadede sektorer identifiseres, SMART-tabeller gjennomgås, og risikoen for kortsiktig feil vurderes. Hvis noen disker har fysisk skade, prioriteres behandlingen av dem i et renrom.
Deretter opprettes rettsmedisinske kloner av alle involverte disker . I stedet for å jobbe med originalene, lages en sektor-for-sektor-kopi ved hjelp av verktøy som tillater å hoppe over alvorlig skadede sektorer eller prøve på nytt med sikre mønstre. Målet er å bevare den opprinnelige tilstanden i tilfelle det blir nødvendig å gå tilbake til et tidligere trinn i prosessen.
Når klonene er klare, utføres en manuell logisk rekonstruksjon av RAID-en : nivået (0, 1, 5, 6, 10 osv.), diskrekkefølgen, stripestørrelsen, offsets, paritetsalgoritmer og andre egenskaper ved den opprinnelige kontrolleren identifiseres. Volumet kan ofte rekonstrueres selv uten den samme kontrolleren eller NAS-en som opprettet det.
Når det rekonstruerte virtuelle volumet virker koherent, repareres filsystemet om nødvendig: NTFS, ReFS, ext4, XFS, Btrfs, ZFS, VMFS og andre. Dette arbeidet ligner på en kirurgs arbeid: strukturer korrigeres, inodetabeller, MFT-er, superblokker eller journaler gjenoppbygges, og man prøver alltid å endre det absolutte minimum.
Til slutt blir dataene hentet ut og systematisk validert. Konsistensen til hoveddatabasene, virtuelle maskiner og kritiske mapper kontrolleres, filer verifiseres for å åpnes riktig, og dataene leveres på nye, isolerte lagringsmedier , for eksempel eksterne harddisker eller en ny NAS, slik at klienten kan gjennomgå gjenopprettingen før den godtas.
I spesielt komplekse scenarier, som RAID-er påvirket av ransomware, mislykkede tidligere gjenoppbygginger eller virtuelle volumer i allerede skadede arrayer, kombineres dekrypteringsteknikker, rettsmedisinsk analyse og RAID-rekonstruksjon, men alltid under samme regel: ikke berør originalene mer enn strengt nødvendig.
Til syvende og sist er RAID-systemer et kraftig verktøy for å forbedre datatilgjengeligheten, men de er fortsatt sårbare for fysiske, logiske og menneskelige feil. Å forstå svakhetene deres, identifisere tidlige varseltegn og fremfor alt å unngå impulsive beslutninger når en feil oppstår, er det som virkelig utgjør forskjellen mellom en mindre skrekk og en datakatastrofe.

Indeks
- 1 Hva er en RAID-feil, og hvorfor er det ikke det samme som en sikkerhetskopi?
- 2 De viktigste RAID-nivåene og deres innvirkning på gjenoppretting
- 3 Tydelige tegn på at RAID-en din begynner å mislykkes
- 4 Symptomer på logisk korrupsjon og stille problemer i RAID
- 5 Typiske feil i kontrollere, servere og hovedkort
- 6 Vanlige årsaker til datatap i RAID-arrayer
- 7 Hva du IKKE skal gjøre når RAID-en din begynner å feile
- 8 Forsiktige tiltak du bør ta når du oppdager en mulig RAID-feil
- 9 Hvordan profesjonelle RAID-gjenopprettingslaboratorier fungerer