- Pipe-urile în Linux vă permit să înlănțuiți procese prin conectarea stdout și stdin, cu suport pentru kernel și instrumente precum tee, xargs și cpio pentru fluxuri complexe.
- O conductă CI/CD eficientă în Linux se bazează pe un design bun al scenei, utilizarea intensivă a cache-urilor, artefacte imuabile și testare paralelă.
- Optimizarea serverului Linux (CPU, RAM, I/O, Docker) și a executorilor Jenkins, GitHub Actions sau GitLab Runner este esențială pentru reducerea timpilor.
- Integrarea securității, observabilității și controlului costurilor în fluxul de lucru asigură implementări fiabile, trasabile și sustenabile în mediile de producție.
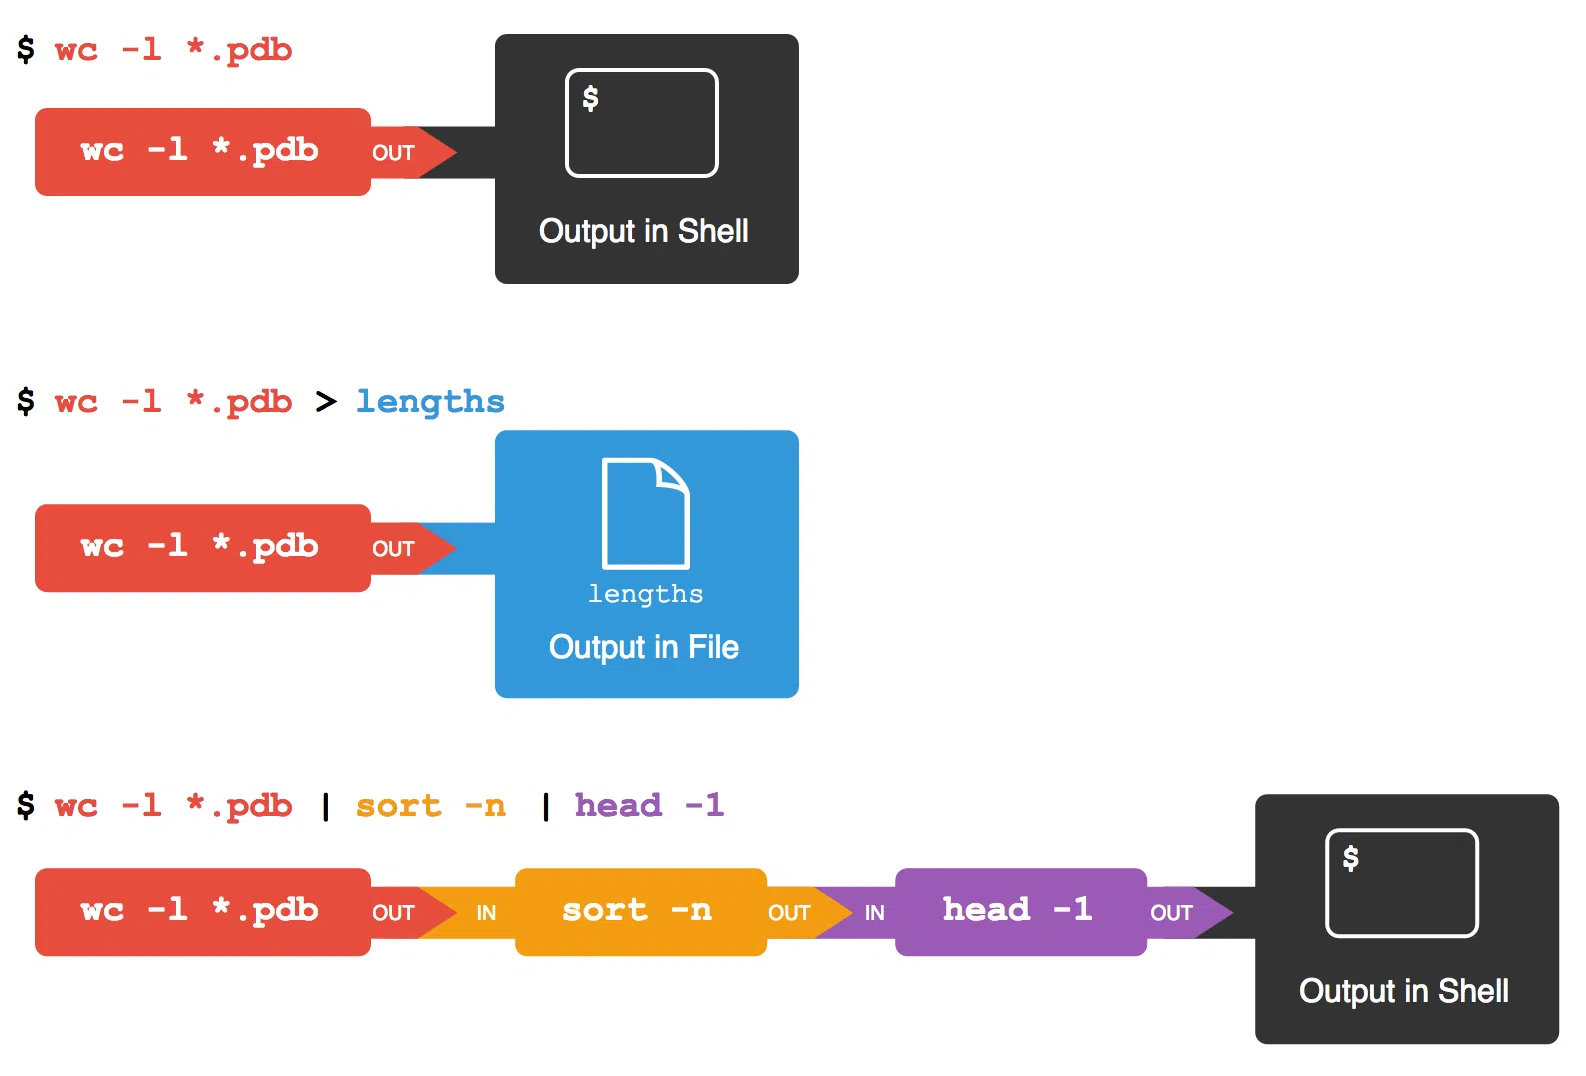
Optimizarea conductelor în Linux Nu este vorba doar de înlănțuirea comenzilor cu simbolul |În spatele tuturor acestora se află o lume întreagă de optimizarea performanțeiProiectarea fluxului de lucru, CI/CD, securitatea și optimizarea sistemului de operare fac toată diferența dintre o rețea de dezvoltare lentă și instabilă și una funcțională, fiabilă și ieftină de întreținut. Dacă lucrați cu servere Linux, fie că automatizați sarcini în terminal, fie că rulați rețele de integrare continuă, înțelegerea acestor detalii vă economisește mult timp și dureri de cap.
În acest articol vom combina două perspective complementare: pe de o parte, Utilizarea clasică a pipe-urilor în linia de comandă Linux (pipe-uri, redirecționări, comenzi precum tee, xargs o cpio); pe de alta, cel Optimizarea canalului CI/CD pe serverele LinuxAceasta include caching, paralelizarea testelor, optimizarea Docker, securitatea lanțului de aprovizionare și metrici avansate ale fluxului de lucru. Toate explicate în spaniolă (din Spania), cu exemple clare și o abordare foarte practică.
Ce este o pipeline și cum se încadrează pipe-urile în Linux?
Termenul „pipeline” provine din ideea de „pipe” (sau „țeavă”) : un flux de date care călătorește dintr-un punct în altul. În informatică, și în special în Linux, o „pipe” (sau „țeavă”) este un mecanism care permite ieșirii standard a unui proces să devină intrarea standard a altuia. Cu alte cuvinte, ieșirea unei comenzi este introdusă automat în următoarea, fără a trece prin fișiere intermediare.
În sistemele de tip Unix, există două tipuri principale de pipe-uri . Pe de o parte, există pipe-uri anonime sau fără nume , care pot fi utilizate doar între procese strâns legate (de exemplu, părinte și copil). Pe de altă parte, există pipe-uri denumite , cunoscute și sub numele de FIFO (First In – First Out - Primul intrat - Primul ieșit), care permit comunicarea între procese care nu sunt direct legate și pot fi chiar pe mașini diferite conectate la o rețea.
Conductele anonime oferă de obicei comunicare unidirecțională : un proces scrie, iar celălalt citește. În schimb, conductele denumite permit comunicarea bidirecțională dacă sunt proiectate în acest fel, de exemplu, prin deschiderea FIFO în modul citire/scriere de la ambele capete. Acestea sunt utilizate pe scară largă pentru a coordona procesele daemon, scripturile sau serviciile care trebuie să transmită date reciproc fără blocare.
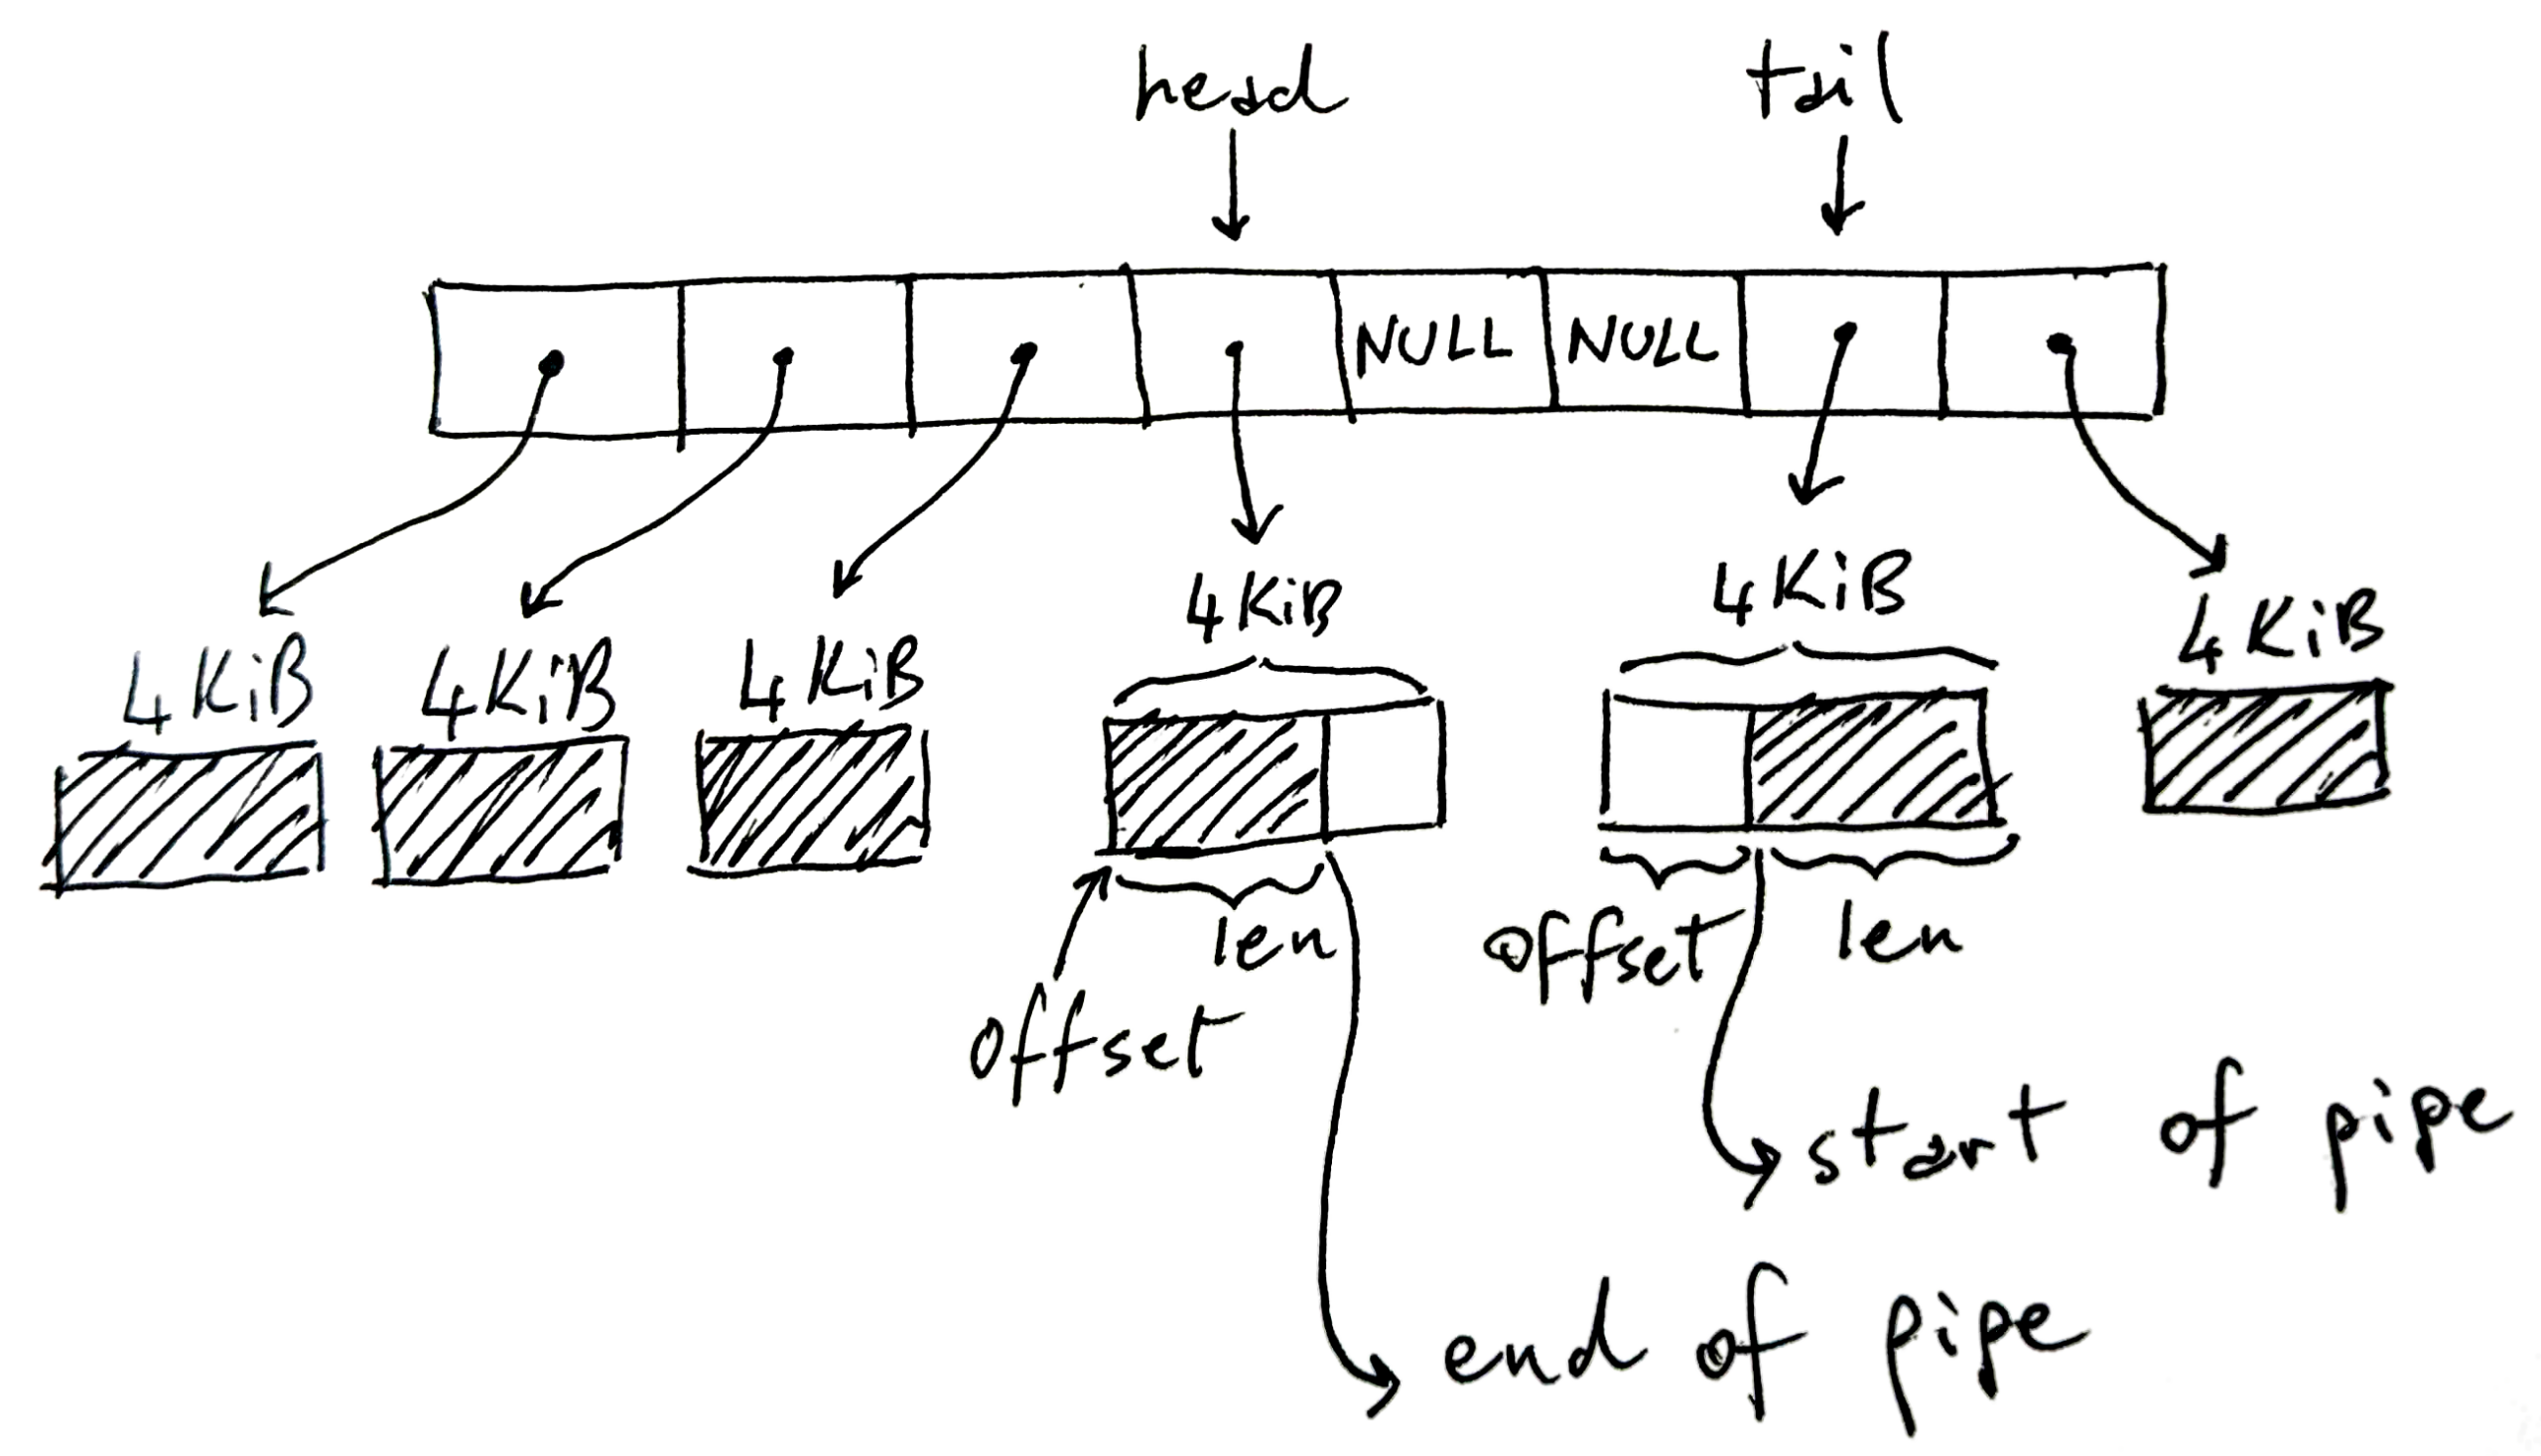
La nivel de implementare, suportul pentru conducte se află în kernel linuxnu în shell. Interpretorul de comenzi (bash, zsh etc.) creează pur și simplu conducta prin apeluri de sistem, cum ar fi pipe() y fork()redirecționează descriptorii de fișiere și apoi lansează fiecare program. Adevărata magie a modului în care procesele sunt blocate, cum este gestionat buffer-ul și cum sunt propagate datele între producător și consumator este gestionată de kernelul sistemului.
Înțelegerea stdin, stdout și a fluxului de date
Pentru a lucra eficient cu pipeline-uri, este crucial să înțelegem ce sunt stdin, stdout și stderr . Acestea nu sunt concepte abstracte: fiecare proces din Linux începe cu trei descriptori de fișiere deschiși, care indică resurse specifice gestionate de kernel.
stdin (descriptor 0) și stdout (descriptor 1) pot fi văzute ca fluxuri de octeți conectate la ceva: ar putea fi un terminal, un fișier, un socket de rețea sau un pipe. Nu sunt simple buffere; sunt referințe la obiecte de kernel ( structuri de tip fișier ) care sunt la rândul lor asociate cu inode-uri, socket-uri sau structuri interne de pipe.
Fiecare proces are propriii descriptori, astfel încât fiecare comandă dintr-o conductă Își vizualizează stdin-ul și stdout-ul independent. Pe o linie ca ls | grep txt | wc -l, ls scrie într-o țeavă, grep Citește dintr-un pipe și scrie în altul și wc Citește de la ultimul. Pentru utilizator apare ca un singur șir de caractere, dar intern sunt mai multe buffere de kernel concatenatecu fiecare proces blocându-se și reluându-se în funcție de spațiul sau datele disponibile.
Când primul proces produce date mai repede decât al doilea le consumă, buffer-ul pipe se umple. În acel moment, scrierile ulterioare revin, blocând procesul de trimitere până când procesul consumator... citește suficiente informații și eliberează spațiu. Acest lucru previne pierderea controlului memoriei; datele nu se acumulează la nesfârșit decât dacă utilizați semnale I/O neblocante sau semnale speciale. De exemplu, într-un caz precum dd if=/dev/sda | gzip -9, Da gzip se comprimă mai lent, dd este obligat să aștepte.
Acest mecanism de contrapresiune face ca conductele de procesare să fie destul de stabile chiar și atunci când există dezechilibre de performanță între etape, lucru care se reflectă apoi și în proiectarea conductelor CI/CD , unde etapele lente devin blocajul care trebuie măsurat și optimizat.
Utilizarea practică a pipe-urilor în terminalul Linux
În utilizarea de zi cu zi, pipe-urile sunt folosite pentru a înlănțui comenzi pe o singură linie și a transforma datele pas cu pas. În loc să rulați o comandă, să priviți rezultatul, să îl copiați și să îl lipiți într-o altă comandă, puteți construi „fabrici de date” mici și extrem de flexibile, în text simplu.
Un exemplu tipic în mediile Unix este combinarea comenzii fortune, care afișează citate aleatorii, cu cowsaycare imprimă o vacă „vorbitoare”. Când se folosește o țeavă, Plecarea lui Fortune devine mesajul lui Cowsaytotul într-o singură comandă. Este un exemplu jucăuș, dar ilustrează perfect ideea de a conecta instrumente simple pentru sarcini mai complexe.
Un alt clasic este trimiterea rezultatului ls a wc să numere rânduri, cuvinte și caractere. Ceva de genul ls | wc Îți permite să vezi rapid câte elemente sunt listate. Frumusețea este că nu ai nevoie de un singur program pentru a face totul, ci mai degrabă... Creați soluții cu utilități mici, bine concepute..
De asemenea, este foarte obișnuit să se înlănțuiască împreună cat, sort y more (sau un alt pager) pentru a sorta un fișier text și apoi a-l răsfoi pagină cu pagină. Cu un pipe, conținutul trece de la o comandă la alta fără a fi salvat în fișiere temporare explicite, ceea ce simplifică foarte mult sarcinile de scriptare și administrative.
În cazuri practice, cum ar fi procesarea listelor de studenți și a notelor în fișiere separate, puteți utiliza paste pentru a îmbina coloanele, cut pentru a selecta doar câmpurile care vă interesează și bare verticale înlănțuite pentru a filtra, sorta sau transforma totul într-o singură linie de script shell. Acest model de descompune o problemă mare în comenzi simple combinate cu pipe-uri Este esența filozofiei Unix.
Comenzi avansate pentru a profita la maximum de țevi: tee, xargs și cpio
Când începi să automatizezi cu adevărat lucrurile în Linux, țevile devin și mai puternice datorită unor instrumente cheie. Printre acestea se numără: tee, xargs y cpiocare completează foarte bine fluxul standard de date.
Comanda tee Se comportă ca un „T” într-o conductă de apă: citește din stdin, scrie în stdout și copiază aceeași ieșire într-unul sau mai multe fișiere. Este ideal atunci când doriți vizualizați rezultatul pe ecran și, în același timp, salvați-l să o revizuiască ulterior sau să o proceseze într-o altă etapă. Cu opțiunea -a Adaugă date la sfârșitul fișierului în loc să le suprascrie.
De exemplu, puteți sorta o listă cu sorttrimite rezultatul către tee să îl stocheze într-un jurnal și, în același timp, să îl transmită către more pentru a-l pagina. În acest fel, într-o singură rețea, aveți sortare, salvare pe disc și vizualizare convenabilă fără a repeta procesul de sortare.
Comanda xargs Este o altă piesă fundamentală când vine vorba de pipe-uri. Funcția sa este de a prelua ceea ce sosește prin stdin (de obicei o listă de elemente) și de a-l converti în argumente pentru o altă comandă. Este utilă în special atunci când un program se blochează deoarece primește prea mulți parametri simultan sau când vrei să... împărțiți lucrarea în loturi cu opțiune -n, ceea ce limitează numărul de argumente transmise per execuție.
De exemplu, cu ls | xargs -n 4 Împărțiți lista de fișiere în grupuri de câte patru, executând comanda țintă (implicit echo(sau pe cea specificată) de mai multe ori. În acest fel, puteți construi canale de lucru precum „previzualizați ce voi șterge” prin combinarea ls, xargs y echo rm înainte de a lansa ștergerea propriu-zisă.
Atenție la intrările complexe: căi cu spații sau caractere speciale poate încălca comportamentul implicit al xargsÎn aceste cazuri, se folosește de obicei în combinație cu find și opțiunea -print0, care separă elementele cu un caracter nul, împreună cu xargs -0 astfel încât ambele capete să utilizeze același delimitator robust.
În cele din urmă, cpio Este o comandă mai puțin cunoscută decât tarDar este incredibil de flexibil pentru lucrul cu fluxuri de fișiere prin pipe-uri. Spre deosebire de tar, este conceput de la zero pentru a funcționa cu redirecționări și conducteprimește o listă de fișiere prin stdin (de obicei generată cu find) și produce sau consumă fișiere de tip „pachet” fără propria lor compresie, pe care le puteți comprima apoi cu gzip sau asemănător.
Principalele moduri de cpio permite crearea de fișiere (-o), copiază arbori de directoare (-p) sau extrage conținut (-i(adesea denumită „copiere”). Opțiuni precum -u a suprascrie, -m pentru a păstra marcajele temporale sau -d recrearea structurii directoarelor face posibilă pentru a controla în detaliu ce se copiază și cum, util în special în scripturi complexe în care tar se dovedește insuficient.
Proiectarea și optimizarea conductelor CI/CD pe servere Linux
Dincolo de linia de comandă tradițională, conceptul de pipeline a devenit fundamental în lumea integrării continue și a livrării continue (CI/CD) . Pe un server Linux, un pipeline CI/CD este o secvență automatizată de pași: preluarea codului, instalarea dependențelor, compilarea, rularea testelor, împachetarea artefactelor și implementarea.
Linux este deosebit de potrivit pentru acest lucru, deoarece se remarcă prin viteza, stabilitatea și ecosistemul său de instrumente de automatizare . Platforme precum Jenkins, GitHub Actions și GitLab CI se bazează pe executori Linux (mașini fizice, mașini virtuale sau containere) pentru a rula consecvent conducte.
Optimizarea acestor conducte nu înseamnă doar să le faci să „funcționeze”, ci și să le faci să funcționeze cu cât mai puține dificultăți posibil. Aceasta înseamnă reducerea timpilor de verificare, minimizarea instalărilor repetitive de dependențe, optimizarea imaginilor Docker pentru a evita reconstrucțiile inutile, reutilizarea artefactelor deja generate și menținerea mediului sigur și observabil.
O bună practică de bază este structurarea conductei în etape bine definite: construire, testare și implementare . În mod ideal, ar trebui să compilați o singură dată, să generați un artefact (binar, pachet, imagine Docker) care este testat în paralel în diferite variante (de exemplu, diverse versiuni lingvistice) și apoi să implementați același artefact în medii de staging și producție fără recompilare.
Lucrul cu artefacte imuabile stocate în repozitorii (S3, Nexus, Artifactory, registre de containere sau pachete încorporate în GitLab/GitHub) simplifică auditarea, permite reveniri rapide la versiuni anterioare și reduce probabilitatea ca „să funcționeze pe mașina mea, dar nu și în producție”.
Cerințe preliminare: distribuție, utilizator CI și consolidare server
Înainte de a te agăța ici și colo de optimizări de milisecunde, este important să stabilești o fundație stabilă pe serverul Linux care va acționa ca executor CI/CD. Aceasta începe cu alegerea distribuției și a configurației minime de securitate.
Cea mai sensibilă abordare este de obicei standardizarea pe o distribuție LTS sau stabilă cu care echipa este familiarizată: Ubuntu LTS, Debian Stable sau alternative enterprise precum AlmaLinux sau Rocky Linux. Faptul că toți rulerii sunt pe aceeași versiune previne comportamentele neașteptate cauzate de biblioteci sau kerneluri diferite între joburi.
O altă recomandare este configurarea unui utilizator dedicat pentru CI, fără privilegii de root, cu sudo foarte limitat doar la comenzile esențiale (de exemplu, systemctl o docker (dacă este cu adevărat necesar). Acest utilizator trebuie să se autentifice folosind chei SSH, atât pentru a accesa serverul, cât și pentru a interacționa cu depozitele Git sau alte mașini la distanță.
La nivel de sistem, este recomandabil să se întrețină serverul actualizat și minimal consolidatAceasta include aplicarea actualizărilor de securitate, configurarea unui firewall restrictiv (de exemplu, cu UFW: respingerea întregului trafic de intrare, cu excepția a ceea ce este necesar, și permiterea traficului de ieșire) și activarea instrumentelor precum fail2ban pentru a opri atacurile brute-force pe SSH și a ajusta anumiți parametri de rețea și kernel prin sysctl pentru a îmbunătăți fiabilitatea și performanța.
De exemplu, este obișnuit să se ridice limita de inotifica pentru a preveni epuizarea resurselor sistemelor de construire care monitorizează multe fișiere și pentru a ajusta parametrii vm.swappiness pentru a face kernelul mai conservativ atunci când se utilizează swap, lucru relevant în special atunci când joburile CI consumă multă memorie simultan.
Cache-uri, Docker și paralelizare: pârghiile de performanță în CI/CD
Dacă te uiți la cum se pierde timpul într-o conductă medie de lucru, vei vedea că o mare parte se pierde cu instalarea dependențelor și reconstruirea imaginilor Docker . Abordarea acestei probleme este de obicei mai eficientă decât optimizarea codului de test cu câteva milisecunde.
Prima pârghie este memorarea în cache a dependențelor . Aproape toți managerii de dependențe (pip, npm, Maven, Gradle, modulele Go etc.) utilizează directoare locale în cache. Pe un server Linux persistent, puteți partaja aceste directoare între joburi sau le puteți monta pe un volum persistent. În acest fel, fiecare execuție nu trebuie să descarce din nou jumătate din internet.
Pentru Docker, activați BuildKit și structurați bine Dockerfile Aceasta marchează un punct de cotitură. Plasarea instalării dependențelor imediat după copierea fișierului de cerințe și înainte de restul codului asigură reutilizarea straturilor atâta timp cât versiunile acelor dependențe rămân neschimbate. În plus, în cadrul procesului de compilare se pot configura cache-uri specifice pentru pip, npm etc.
A doua pârghie majoră este execuție paralelă a testelorMulte framework-uri suportă nativ concurența: pytest cu -n autoInstrumente Java precum Surefire, Jest în JavaScript cu --maxWorkersetc. Împărțirea suitei pe module, foldere sau chiar pe timpul estimat și echilibrarea acesteia între mai mulți lucrători permite reduceri de 2 până la 5 ori a duratei fazei de testare fără a schimba nicio linie de business.
În cele din urmă, există problema artefactelor și a implementării . În loc să recompilezi aceeași imagine pentru staging, pre-producție și producție, abordarea eficientă este de a construi o singură dată, de a salva rezultatul într-un depozit și de a-l eticheta în funcție de mediul de implementare. Acest lucru reduce utilizarea CPU, evită inconsecvențele și accelerează semnificativ pipeline-urile lungi.
Optimizarea Jenkins, GitHub Actions și GitLab Runner pe Linux
Fiecare sistem de integrare continuă (CI) are propriile particularități, dar toate beneficiază de aceleași idei de bază atunci când rulează pe Linux. Cheia este de obicei utilizarea executorilor efemeri și curați , menținerea unei memorie cache persistente de dimensiuni adecvate și controlul concurenței.
În Jenkins, o practică obișnuită este utilizarea unor agenți temporari ușori (cum ar fi containerele Docker sau pod-urile din Kubernetes sau alte soluții de orchestrare a containerelor ) pentru a rula joburi, păstrând în același timp nodul principal cât mai simplu posibil. Acești agenți pot fi configurați ca servicii systemd pe serverele Linux, înregistrându-se la controler și pornind automat la pornirea mașinii.
Pentru acțiunile GitHub cu rulouri auto-găzduite, se recomandă implementarea lor în Mașini virtuale Linux cu SSD-uri rapidePentru a crea un director cache mare dedicat acțiunilor (dependențe de limbă, cache-uri de compilare etc.), limitați numărul de joburi concurente pentru a evita supraîncărcarea procesorului și a discului. Profitați de acțiunea oficială de caching cu căi precum ~/.cache/pip, ~/.npm o ~/.m2 Face o diferență uriașă în timp.
În GitLab Runner, alegerea între executorul shell și Docker depinde de echilibrul dintre performanță și izolare de care aveți nevoie. Executorul shell este mai rapid deoarece rulează direct pe gazdă, dar executorul Docker oferă medii curate și replicabile. De asemenea, puteți configura cache-ul partajat (local sau pe S3) și puteți ajusta numărul maxim de joburi concurente pentru a profita de hardware fără a-l supraîncărca.
În toate aceste cazuri, este crucial să existe volume partajate pentru memorarea în cache a dependențelor, prevenind în același timp aglomerarea spațiilor de lucru între versiuni. Mașinile sau containerele efemere, care sunt create și distruse odată cu fiecare pipeline sau grup de pipeline, reduc considerabil problemele de genul „a funcționat ieri, dar nu mai funcționează azi” cauzate de rămășițele versiunilor anterioare.
Performanța serverului Linux: CPU, memorie, I/O și Docker
Indiferent cât de optimizate sunt scripturile tale, dacă serverul Linux care rulează canalul nu este dimensionat corespunzător, vei întâlni cozi nesfârșite și joburi lente. O configurație tipică și rezonabilă pentru o mașină de gamă medie este de 4-8 vCPU-uri și 8-16 GB de RAM , cu stocare SSD (în mod ideal NVMe) și spațiu swap (2-4 GB) pentru a gestiona sarcinile de vârf fără a ucide agresiv procesele.
Sistemul de fișiere contează și el. Utilizați ext4 sau XFS cu opțiunea noatime În volumele în care compilați sau scrieți jurnale, reduceți intrările/ieșirile inutile. În plus, montarea unui tmpfs pentru fișiere temporare sau artefacte de scurtă durată (de exemplu, /mnt/ci-tmp) accelerează operațiunile intensive și previne umplerea discului cu fișiere reziduale între sarcini.
În ceea ce privește Docker, igiena daemonului este esențială. Eliminarea în siguranță și regulată a imaginilor și volumelor neutilizate, menținând în același timp imaginile de bază fierbinți, ajută la controlează spațiul pe disc și timpii de pornireComenzi precum docker system prune Cu filtre de timp adecvate, acestea permit curățarea fără a supraîncărca resursele utilizate recent.
Dacă CI-ul dvs. utilizează multe containere, puteți utiliza și registre în oglindă pentru a evita descărcarea constantă de pe internet, puteți utiliza BuildKit pentru concurență și cache pe niveluri și chiar puteți configura afinități CPU (seturi CPU) sau noduri dedicate pentru cei mai solicitanți executori, prevenind interferențele dintre sarcinile de lucru vecine. În plus, înțelegerea microarhitecturii CPU vă ajută să dimensionați mai bine resursele pentru sarcinile de lucru CI intensive.
Securitate în curs de dezvoltare (DevSecOps) și implementări pe Linux
O conductă rapidă, dar nesigură, este o bombă cu ceas. Integrarea securității în conducta în sine și în securitatea containerelor Docker este acum standard în orice strategie DevSecOps, iar Linux oferă numeroase instrumente pentru acest lucru.
Primul lucru de făcut este să tratați secretele și acreditările cu cea mai mare grijă . Acestea nu ar trebui să se afle niciodată în cod sau în fișierele de configurare versionate. În schimb, sunt stocate în manageri de secrete (variabile mascate GitLab, secrete criptate GitHub, HashiCorp Vault etc.) și injectate doar în timpul execuției jobului care le are nevoie, folosind token-uri de scurtă durată ori de câte ori este posibil.
Un alt nivel important este generarea de SBOM-uri (Software Bill of Materials - Lista de Materiale Software) și semnarea artefactelor. Instrumente precum Syft sau CycloneDX vă permit să enumerați toate componentele care alcătuiesc o imagine sau un fișier binar, în timp ce Cosign sau alte soluții de semnare verificabile asigură că sunt implementate doar artefactele care au trecut prin procesul de procesare și au fost validate.
În ceea ce privește rețeaua și accesul, este recomandabil să segmentați rețelele de CI și de producție , să implementați firewall-uri stricte, să auditați jurnalele de execuție și să rotiți periodic acreditările. Acolo unde se utilizează SSH, este mai bine să utilizați certificate sau chei cu date de expirare, decât parole statice.
La implementarea pe Linux, strategii precum Blue/Green, rolling și canary reduc considerabil impactul erorilor de implementare. Rularea aplicației ca serviciu systemd, plasarea unui Nginx sau HAProxy în fața acesteia și controlul traficului între versiuni cu verificări de sănătate vă permit să obțineți practic zero timpi de nefuncționare în timpul actualizărilor.
De exemplu, la reîncărcarea Nginx și la repornirea serviciilor cu systemd folosind semnale de oprire soft (cum ar fi SIGTERMCu timpi de așteptare rezonabili, puteți goli conexiunile active înainte ca procesul să se oprească, păstrând intactă experiența utilizatorului în timp ce schimbați versiunile în fundal.
Observabilitate, metrici și costuri în conductele Linux
Odată ce pipeline-urile tale sunt funcționale, următorul pas este să le măsori și să înțelegi unde se duc timpul și resursele . Nu este suficient să știi dacă un flux de lucru are succes sau eșuează; trebuie să monitorizezi durata fiecărei etape, timpul de așteptare, rata de succes, frecvența implementării, rata de accesare a memoriei cache și așa mai departe.
Este obișnuit să se exporte metrici de sistem folosind node_exporterCentralizează jurnalele cu soluții precum ELK sau Loki și vizualizează totul în tablourile de bord Grafana. În acest fel, poți detecta, de exemplu, dacă faza de testare a crescut în durată cu 30% în ultima săptămână sau dacă joburile petrec prea mult timp așteptând un executor disponibil; monitorizarea traficului de rețea Instrumentele open source completează această vizibilitate.
De asemenea, este posibil să se instrumenteze pipeline-ul în sine, de exemplu în GitHub Actions sau GitLab CI, pentru a pentru a măsura programatic câte execuții au avut succes, cât a durat fiecare rulare și care este starea generalăUn script care apelează API-ul furnizorului, calculează numărul total de rulări, numărul de rulări reușite, numărul de rulări eșuate, rata de succes și durata medie și salvează totul într-un fișier JSON (cum ar fi pipeline-metrics.json) vă permite să integrați aceste valori în rapoarte sau tablouri de bord.
Cu aceste informații, puteți lua decizii cu privire la dimensiunea și numărul de runneri : uneori este mai bine să aveți mai mulți runneri mici decât câțiva foarte mari pentru a reduce timpii de așteptare. Autoscalabilitatea - de exemplu, scalarea automată în cloud sau pool-urile dinamice de noduri Kubernetes - ajută la absorbția activității de vârf în timpul zilei și la minimizarea resurselor subutilizate noaptea.
Aceste practici nu numai că îmbunătățesc experiența echipei, dar ajută și la ajustarea costurilor de infrastructură prin controlul consumului de CPU, memorie și, în special, stocare, care tinde să crească vertiginos odată cu imaginile și memoria cache dacă nu este curățată în mod regulat și planificat.
Stăpânirea atât a schemelor clasice de linie de comandă, cât și a schemelor moderne de CI/CD în Linux oferă o combinație puternică: puteți automatiza totul, de la sarcini simple de filtrare a textului până la scheme complexe, ușor de întreținut, sigure și rapide de construire, testare și implementare. Înțelegerea modului în care informațiile circulă între procese, cum sunt memorate în cache dependențele, cum sunt optimizate serverele și cum sunt integrate metricile și securitatea vă permite să construiți fluxuri de lucru care se adaptează echipei și proiectelor dvs., fără a deveni un blocaj constant.
